Qu'est-ce que h2oGPT ?
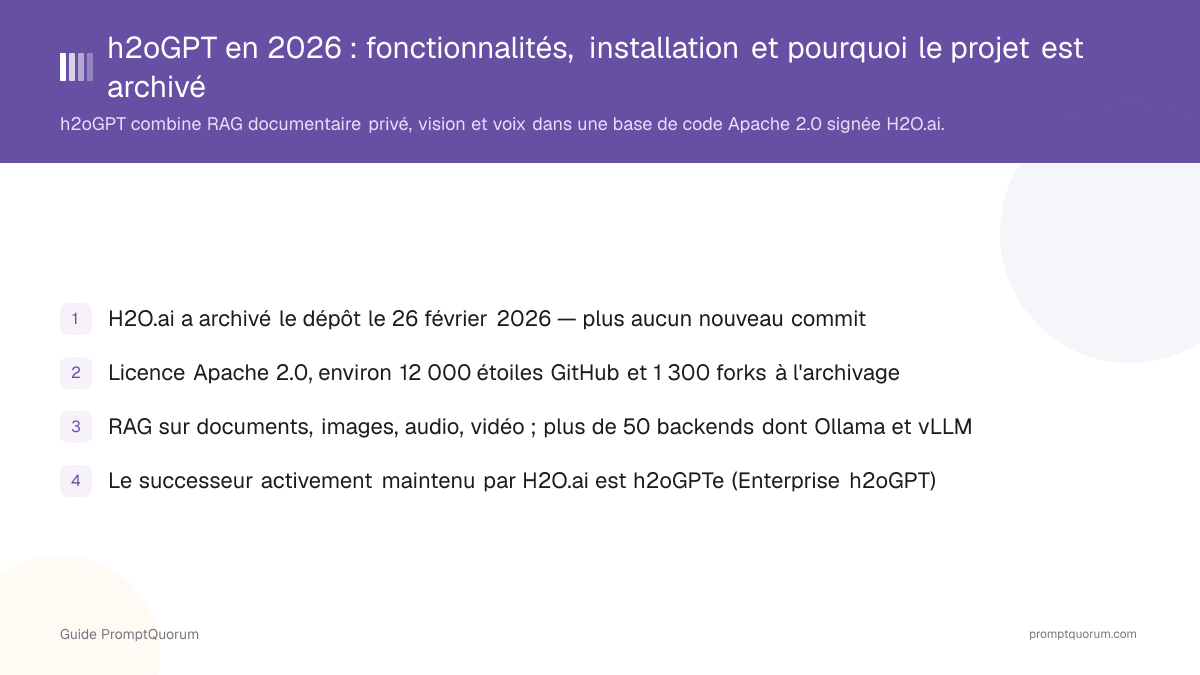
h2oGPT est une application open source de H2O.ai pour le chat privé et les questions-réponses documentaires : vous la connectez à un LLM local ou via API, importez des fichiers, et posez des questions ancrées dans ce contenu plutôt que dans les connaissances générales du modèle. Le projet est hébergé sur github.com/h2oai/h2ogpt et a atteint environ 12 000 étoiles GitHub avant que H2O.ai ne l'archive.
- RAG documentaire : ingère PDF, Word, Excel, images, images vidéo, liens YouTube, audio, code et markdown dans une base de connaissances consultable
- Bases vectorielles : Chroma, Weaviate, ou un index FAISS en mémoire, avec chunking sémantique et HYDE (Hypothetical Document Embeddings) pour améliorer la qualité de récupération
- Backends de modèles : connexion en local via Hugging Face transformers, llama.cpp/GGML, GPT4All, Ollama, vLLM, Hugging Face TGI et ExLLaMa, ou vers des API hébergées (OpenAI, Azure OpenAI, Anthropic, Google, MistralAI, Groq, Replicate, Together.ai)
- Fonctionnalités multimodales : modèles de vision (LLaVa plus modèles de vision via API comme GPT-4-Vision, Claude et Gemini-Pro-Vision), génération d'images (variantes Stable Diffusion, PlaygroundAI, Flux) et voix (reconnaissance vocale en streaming via Whisper, synthèse vocale avec clonage de voix)
- API et intégration : un serveur proxy compatible OpenAI avec complétions de chat et de texte, appels de fonctions/outils, mode JSON et intégration de recherche web
- Support multi-utilisateurs : authentification native nom d'utilisateur/mot de passe plus Google OAuth, avec contrôle d'accès basé sur les rôles
h2oGPT est-il encore maintenu ?
Non. H2O.ai a archivé le dépôt github.com/h2oai/h2ogpt le 26 février 2026. GitHub le marque comme « archived by the owner » et en lecture seule : aucun nouveau commit n'arrive sur la branche principale, et les issues et pull requests ne sont plus activement triées ni fusionnées.
L'état archivé ne supprime pas le code. Apache 2.0 permet à quiconque de le forker, l'exécuter, le modifier et le redistribuer indéfiniment — vous pouvez encore cloner le dépôt aujourd'hui et l'exécuter exactement comme documenté. Ce qui change, c'est que H2O.ai ne corrige plus les bugs, ne met plus à jour les dépendances et n'ajoute plus de fonctionnalités à cette base de code précise.
- Ce qui fonctionne toujours : cloner, exécuter et modifier le code existant sous Apache 2.0 — rien n'a expiré côté licence ou code lui-même
- Ce qui s'arrête : nouveaux commits officiels, mises à jour de dépendances, correctifs de sécurité et traitement des issues par l'équipe H2O.ai sur ce dépôt
- Vers quoi H2O.ai oriente à la place : h2oGPTe (Enterprise h2oGPT), un produit commercial qui a continué de publier des versions tout au long de 2026
- Ce que cela signifie pour vous : traitez le code open source de h2oGPT comme une implémentation de référence figée, pas comme un outil sur lequel compter pour des correctifs continus de H2O.ai
⚠️Attention: Si vos critères d'évaluation incluent « activement maintenu par l'éditeur », h2oGPT (le dépôt open source) ne répond pas à ce critère à l'heure actuelle. h2oGPTe, si.
Fonctionnalités : RAG, backends et multimodalité
Ce qui distinguait h2oGPT pendant sa phase de développement actif, c'était l'étendue de ce qui était regroupé dans une seule base de code : RAG documentaire, un large éventail de backends d'inférence et le multimodal, plutôt que des outils séparés pour chaque couche.
- Pipeline RAG : import de fichiers ou connexion à des sources de données, extraction et nettoyage de texte, OCR via DocTR pour les documents scannés, chunking sémantique, embedding et indexation dans Chroma, Weaviate ou FAISS
- Flexibilité des backends : la même interface peut appeler un modèle entièrement local (llama.cpp GGUF, un modèle Hugging Face, ou un modèle servi via Ollama) ou une API hébergée, permettant d'arbitrer confidentialité contre vitesse et choix de modèle au cas par cas
- Vision et génération d'images : les images de documents et les photos peuvent être interprétées avec LLaVa ou des modèles de vision via API, et l'outil peut générer des images via des variantes Stable Diffusion ou Flux
- Voix : reconnaissance vocale en streaming via Whisper, plus synthèse vocale (y compris clonage de voix) utilisant Microsoft SpeechT5 et d'autres modèles sous licence MPL2
- Fine-tuning : support documenté pour l'entraînement fin sur vos propres données ; H2O.ai maintient également un projet compagnon distinct, H2O LLM Studio, spécifiquement pour des workflows de fine-tuning sans code
- Tests et fiabilité à l'époque du développement actif : le projet était livré avec plus de 1 000 tests unitaires et d'intégration
Comment auto-héberger h2oGPT ?
Les étapes ci-dessous suivent les parcours d'installation Docker et pip documentés par le projet lui-même. Le dépôt étant archivé, vous travaillez à partir d'un instantané figé — il n'y aura plus de correctifs officiels si une dépendance casse la compatibilité avec le temps.
- 1Cloner le dépôt : git clone https://github.com/h2oai/h2ogpt.git, puis cd h2ogpt. Vous clonez un instantané archivé en lecture seule, pas un projet activement mis à jour.
- 2Installer les dépendances depuis requirements.txt dans un environnement virtuel Python, ou utiliser la configuration Docker Compose documentée par le projet pour un environnement plus complet et préconfiguré.
- 3Choisir un backend de modèle : orienter h2oGPT vers un moteur d'inférence local (Ollama, ou des modèles GGUF via llama.cpp) pour un usage entièrement hors ligne, ou configurer des clés API pour un fournisseur hébergé si le fonctionnement hors ligne n'est pas requis.
- 4Lancer l'application via le point d'entrée generate.py du projet, ou démarrer la pile Docker Compose, qui fait apparaître l'interface web locale.
- 5Importer des documents via l'interface web pour constituer une base de connaissances privée, ou connecter une base vectorielle persistante (Chroma ou Weaviate) pour des collections de documents plus volumineuses.
- 6Le projet ne recevant plus de correctifs de sécurité, fixez les versions de vos dépendances et relisez le code vous-même avant d'en dépendre au-delà d'une évaluation personnelle.
h2oGPT nécessite-t-il un GPU ?
Pas pour l'application h2oGPT elle-même. Un GPU compte uniquement pour le backend choisi — l'inférence accélérée par GPU (Hugging Face transformers, modèles GGML sur GPU) est bien plus rapide, mais des backends purement CPU comme les builds CPU de llama.cpp et GPT4All sont aussi pris en charge.
h2oGPT peut-il fonctionner entièrement hors ligne ?
Oui. h2oGPT peut être configuré pour n'utiliser que des backends d'inférence locaux (llama.cpp, un modèle Hugging Face exécuté localement, ou Ollama), sans appel à des fournisseurs d'API externes — conformément à l'objectif de conception initial du projet, centré sur la confidentialité.
h2oGPT vs. h2oGPTe (Enterprise)
H2O.ai vend un produit commercial, h2oGPTe (Enterprise h2oGPT), aux côtés du h2oGPT open source désormais archivé. Les deux partagent un nom et une origine mais ne sont pas la même base de code à évaluer aujourd'hui.
h2oGPT (open source)
- Statut:
- Archivé le 26/02/2026 (lecture seule)
- Hébergement:
- Auto-hébergement uniquement
- Coût:
- Gratuit (Apache 2.0)
- Idéal pour:
- Forker ou étudier une base de code RAG figée
h2oGPTe (Enterprise)
- Statut:
- Développé activement, versions publiées tout au long de 2026
- Hébergement:
- Auto-hébergé, VPC ou géré par H2O.ai
- Coût:
- Sur devis — contacter H2O.ai
- Idéal pour:
- Déploiements en production nécessitant mises à jour continues et support éditeur
Si vous avez besoin d'un produit supporté avec une feuille de route, évaluez h2oGPTe directement sur h2ogpte.genai.h2o.ai plutôt que de supposer que le dépôt open source h2oGPT recevra la même attention.
À qui s'adresse h2oGPT ?
Le dépôt open source h2oGPT conserve des usages légitimes — ils sont simplement plus restreints que « le déployer en production et attendre que l'éditeur le maintienne à jour ».
Utilisez h2oGPT (le dépôt open source) si
- Vous voulez étudier ou forker une implémentation de référence large et fonctionnelle du RAG combiné à une orchestration multi-backend sous licence Apache 2.0 permissive
- Vous exploitez un setup personnel de chat documentaire hors ligne et êtes à l'aise pour maintenir le code vous-même à l'avenir
- Vous devez comparer la couverture fonctionnelle (vision, voix, génération d'images, RAG) face à un outil plus étroit avant de décider quoi construire
- Vous avez déjà les compétences pour corriger vous-même les dépendances et failles de sécurité, puisque les mainteneurs d'origine ne le feront plus
Évitez h2oGPT (le dépôt open source) si
- Vous avez besoin d'un logiciel maintenu par l'éditeur pour un déploiement en production — évaluez plutôt h2oGPTe (Enterprise h2oGPT)
- Vous voulez des correctifs de sécurité continus sans faire le travail vous-même
- Vous choisissez entre des outils auto-hébergés activement maintenus (Open WebUI, AnythingLLM, PrivateGPT, LibreChat, Dify) pour un nouveau projet, sans raison particulière de choisir une base de code figée
- Votre équipe n'a pas la capacité d'auditer et de mettre à jour un arbre de dépendances que plus personne en amont ne patche
h2oGPT vs. Open WebUI, LibreChat, AnythingLLM, PrivateGPT, Dify
h2oGPT recoupait chacun de ces outils sur certaines fonctionnalités, mais son facteur distinctif aujourd'hui est le statut de maintenance — la plupart des alternatives sont activement développées, contrairement à h2oGPT.
Outil | Interface | Licence | Maintenance | Idéal pour |
|---|---|---|---|---|
| h2oGPT | Chat web + UI RAG | Apache 2.0 | Archivé fév. 2026 | Forker une base de code RAG figée |
| Open WebUI | UI de chat web | BSD-3 | Active | Frontend de chat basé sur Ollama |
| LibreChat | UI de chat web | MIT | Active | Alternative ChatGPT multi-modèles |
| AnythingLLM | Bureau + web RAG | MIT | Active | Espaces RAG pour équipes |
| PrivateGPT | API + UI web | Apache 2.0 | Active | RAG hors ligne air-gapped |
| Dify | Visuel + RAG + agents | Apache 2.0 modifiée | Active | Plateforme LLMOps tout-en-un |
La licence et le statut de maintenance peuvent évoluer — revérifiez-les sur le dépôt de chaque projet avant de vous engager.
Histoire et fondateurs
H2O.ai a été fondée en 2012 par Sri Ambati (PDG) et Cliff Click, en s'appuyant sur la précédente cofondation par Ambati de Platfora, une entreprise d'analyse big data plus tard rachetée par Workday.
H2O.ai a lancé h2oGPT et le framework de fine-tuning associé H2O LLM Studio le 11 mai 2023, présentant les deux comme des outils pour les organisations souhaitant contrôler leur propre LLM plutôt que d'envoyer des données à une API tierce. Sri Ambati a déclaré au lancement : « Every company needs its own GPT. H2OGPT and H2O LLM Studio will empower all our customers and communities to make their own GPT. » Il a aussi décrit la philosophie du projet ainsi : « Open source is about freedom, not just free. LLMs are far too important to be owned by a few large tech giants. »
H2O.ai a documenté la conception et l'évaluation du projet dans un article académique, « h2oGPT: Democratizing Large Language Models » (arXiv:2306.08161). Le dépôt a atteint environ 12 000 étoiles GitHub et 1 300 forks avant que H2O.ai ne l'archive le 26 février 2026, moment où l'effort de développement de l'entreprise s'était visiblement déplacé vers h2oGPTe (Enterprise h2oGPT).
Erreurs courantes lors de l'évaluation de h2oGPT
Ces erreurs viennent du fait de traiter h2oGPT comme s'il était encore en développement actif, ou de le confondre avec le produit commercial de H2O.ai.
Erreur 1 : supposer que h2oGPT est activement maintenu
Le dépôt est archivé et en lecture seule depuis le 26 février 2026. Aucun nouveau commit, correctif de sécurité ou réponse aux issues ne provient plus de H2O.ai sur cette base de code — planifiez en fonction de ce fait plutôt que de la seule liste de fonctionnalités.
Erreur 2 : confondre h2oGPT et h2oGPTe
h2oGPT est le projet communautaire open source archivé. h2oGPTe (Enterprise h2oGPT) est le produit commercial distinct et activement développé de H2O.ai, avec des versions continues et un support éditeur. Évaluer l'un en supposant bénéficier des garanties de maintenance de l'autre est une erreur fréquente.
Erreur 3 : attendre des performances sans GPU par défaut
h2oGPT orchestre le backend configuré — il n'exécute pas l'inférence lui-même. Vitesse et exigences matérielles dépendent entièrement du backend choisi (llama.cpp CPU contre Hugging Face transformers accéléré GPU), pas de la couche h2oGPT.
Questions fréquemment posées
h2oGPT est-il encore maintenu ?
Non. H2O.ai a archivé le dépôt github.com/h2oai/h2ogpt (mis en lecture seule) le 26 février 2026. Le code fonctionne toujours et reste forkable sous Apache 2.0, mais il ne reçoit plus de commits, correctifs ou traitement d'issues officiels.
h2oGPT est-il gratuit ?
Oui. h2oGPT est sous licence Apache 2.0, donc gratuit à utiliser, modifier et redistribuer, y compris à des fins commerciales, même si le dépôt est désormais archivé.
Quelle licence utilise h2oGPT ?
La licence Apache 2.0, non modifiée — l'une des licences open source les plus permissives, autorisant usage commercial, modification et redistribution.
h2oGPT prend-il en charge le RAG ?
Oui. h2oGPT ingère PDF, Word, Excel, images, images vidéo, audio et code dans une base de connaissances consultable, avec Chroma, Weaviate ou un index FAISS en mémoire, chunking sémantique et HYDE pour améliorer la récupération.
h2oGPT nécessite-t-il un GPU ?
Pas nécessairement. L'accélération GPU accélère l'inférence sur les backends GPU, mais des options purement CPU comme les builds CPU de llama.cpp et GPT4All sont aussi prises en charge.
h2oGPT peut-il fonctionner entièrement hors ligne ?
Oui, lorsqu'il est configuré pour n'utiliser que des backends d'inférence locaux (llama.cpp, un modèle Hugging Face exécuté localement, ou Ollama) plutôt que des API hébergées — cette conception hors-ligne-d'abord était l'objectif initial du projet.
Qu'est-ce que h2oGPTe et en quoi diffère-t-il de h2oGPT ?
h2oGPTe (Enterprise h2oGPT) est le produit commercial de H2O.ai, vendu et supporté séparément du h2oGPT open source archivé. h2oGPTe a continué de publier des versions tout au long de 2026, tandis que le dépôt open source n'a reçu aucune mise à jour depuis son archivage.
h2oGPT prend-il en charge la vision et le multimodal ?
Oui. h2oGPT documentait la prise en charge de modèles de vision comme LLaVa et de modèles de vision via API (GPT-4-Vision, Claude, Gemini-Pro-Vision), plus la génération d'images via des variantes Stable Diffusion et Flux, et la voix via reconnaissance vocale Whisper et synthèse vocale.
Combien d'étoiles GitHub h2oGPT a-t-il ?
Environ 12 000 étoiles et 1 300 forks sur github.com/h2oai/h2ogpt au moment de son archivage en février 2026. Vérifiez le nombre actuel directement sur le dépôt, car le compteur d'étoiles peut encore évoluer sur un dépôt archivé via de nouveaux stargazers.
En quoi h2oGPT diffère-t-il d'Open WebUI, AnythingLLM ou PrivateGPT ?
Sur le plan fonctionnel, h2oGPT couvrait un terrain RAG et multi-backend similaire, plus des fonctionnalités multimodales supplémentaires (vision, voix, génération d'images) que certaines alternatives n'incluent pas. La différence pratique aujourd'hui est la maintenance : Open WebUI, AnythingLLM et PrivateGPT sont tous activement développés, tandis que h2oGPT est archivé.