Stanford発の研究からプロダクションフレームワークへ
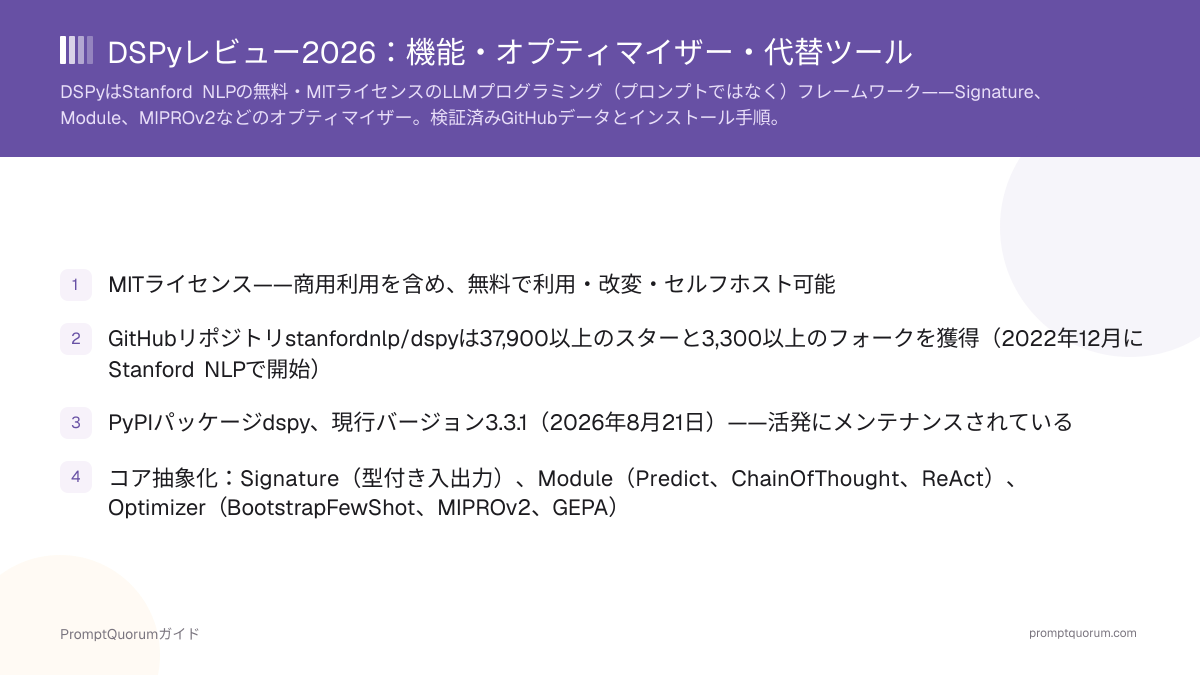
Stanford NLPは2022年12月にDSPyの開発を開始し、stanfordnlp/dspy GitHubリポジトリはこれを「言語モデルをプロンプトするのではなくプログラムするためのフレームワーク」と説明しています。 このプロジェクトは、プロンプト文字列を手で書く代わりに、宣言的なLLMパイプラインをコンパイルするという学術研究から生まれました。
フレームワークは早い段階でSignatureとModuleをコアの抽象化として導入し、その後、最適化アルゴリズムを拡張していきました。Few-Shot例を高速に選択するBootstrapFewShotに続き、ベイズ最適化により指示文とFew-Shot例を同時に探索するMIPROv2が登場し、最近ではドキュメントによれば、例とスコアリング関数から「品質が収束するまで」プロンプトを自動調整するGEPAが加わりました。
本レビュー執筆時点で、DSPyは活発に開発されています。PyPI上のdspyパッケージはバージョン3.3.1(2026年8月21日リリース)でした。プロジェクトのサイトは454人を超えるコントリビューターを報告し、Shopify、Databricks、AWSなどの企業での本番利用を記載しています。
このシリーズの他の複数のフレームワークとは異なり、DSPyはアーカイブされておらず、メンテナンスのみのモードに入ったとも表明されておらず、後継プロジェクトの発表もありません——DSPyは自らが導入したアイデアの、活発に開発が続く正典的な実装です。
Stanford NLPで開発開始
- Date:
- 2022-12
- What it means:
- stanfordnlp/dspyリポジトリと、コアとなるSignature/Module抽象化が誕生
BootstrapFewShotオプティマイザー
- Date:
- 初期リリース
- What it means:
- 高速なベースラインオプティマイザーがトレーニングセットからFew-Shot例をブートストラップ
MIPROv2オプティマイザー
- Date:
- 後期リリース
- What it means:
- ベイズ最適化による指示文とFew-Shot例の同時探索が登場
GEPAオプティマイザー
- Date:
- 最近のリリース
- What it means:
- スコアリング関数に対して自動的にプロンプトを調整する新しいオプティマイザー
PyPIでdspy 3.3.1
- Date:
- 2026-08-21
- What it means:
- 本レビュー時点で検証済みの最新リリース——活発な開発が継続中
📌補足: DSPyのPyPIパッケージ名には知っておく価値のある経緯があります。dspyという名前はもともとPyPIで既に使われていたため、プロジェクトは初期リリースをdspy-aiとして配布していました。現在の正式なパッケージ名はdspyです——現行のインストールにはpip install dspyを使ってください。
DSPyとは何か?
DSPyはStanford NLPが構築したオープンソースのPythonフレームワーク(MITライセンス、活発にメンテナンスされている、github.com/stanfordnlp/dspy)で、言語モデルのタスクを宣言的にプログラムし、その宣言を最適化されたプロンプト——オプションで最適化された重み——にコンパイルするものです。人がプロンプト文をずっと手動で反復調整する代わりに、この仕組みが用いられます。
- Signature:タスクの入力と出力を型付きで定義したもの。短いクラスまたは文字列(例:
"question -> answer")として記述され、異なるLLMやプロンプト戦略の間で移植可能 - Module:Signatureを取り巻く実行戦略を実装するコンポーネント——直接的な補完のための
Predict、段階的推論のためのChainOfThought、ツールを使った推論ループのためのReActなど - Optimizer(以前はteleprompterと呼ばれた):DSPyプログラム内のプロンプトとFew-Shot例を、手動ではなくメトリクスに対して自動的に調整するアルゴリズム——名前付きOptimizerには
BootstrapFewShot、MIPROv2、GEPAがある - プログラムのコンパイル:トレーニングセットとスコアリング関数に対してOptimizerを実行すると、調整済みの指示文と例が組み込まれたコンパイル済みプログラムが生成され、以降は他のDSPyプログラムと同様に実行できる
- モデル非依存:DSPyは組み込みモデルを持たず、設定したLLMプロバイダーに接続する。同じSignature/Moduleのコードを、異なる基盤モデル向けに再最適化することも可能
- マルチエージェント・オーケストレーターではない:DSPyには、CrewAIやAutoGenのような複数のエージェントが通信し合うという組み込みの概念はない。DSPyプログラムは通常、単一のModuleパイプラインであり、
ReActモジュールは推論ループ内でツールを呼び出すことはできる
「プロンプトではなくプログラム」——実践での意味
DSPyでは、プロンプト文字列を書いてその文言を手で反復調整することはありません。Signatureでタスクの形を記述し、推論戦略を定めるModuleを選ぶと、LLMに実際に送られるプロンプトテキストが生成され、Optimizerでコンパイルする際に自動的に調整されます。これは、プロンプト文字列自体を著者が書く単位として扱うプロンプトライブラリやオーケストレーションフレームワークと比べた、このフレームワークの中核的なポジショニングの違いです。
pip install dspy

# 最小限の例:Signature + Module + Optimizer
import dspy

class AnswerQuestion(dspy.Signature):
    """Answer a question factually."""
    question: str = dspy.InputField()
    answer: str = dspy.OutputField()

qa = dspy.ChainOfThought(AnswerQuestion)
result = qa(question="What is the capital of France?")
print(result.answer)
DSPyの料金はいくらか?
DSPy自体はMITライセンスの下で無料です——サブスクリプションも、有料プランも、Stanfordがホストするサービスもありません。 支払うのは自分自身のコンピュート費用と、設定したLLMプロバイダーのAPI料金だけです。
- DSPy(オープンソースフレームワーク):MITライセンスの下で永久に無料、セルフホスト、利用上限なし、実行にアカウント不要
- ホスト型製品やサブスクリプションはない:DSPyは自分でインポートして実行するライブラリであり、マネージドサービスではない——サブスクライブするものは何もない
- オプションのコスト:クラウドモデルをローカルモデルの代わりに接続する場合、設定したLLMプロバイダーのAPI料金(例:クラウドプロバイダーのトークン単価)がかかる
- オプティマイザーのコストに関する注意:MIPROv2のようなオプティマイザーを実行すると、最良のプロンプト構成を探索するために複数のLLM呼び出しが発生するため、プログラムのコンパイル自体にAPI呼び出しコストがかかり、後でコンパイル済みプログラムを実行するコストに加算される
DSPyのインストールと始め方は?
pip install dspyでPyPIからDSPyをインストールします。 クローンもDockerも別途のCLIバイナリも不要です——DSPyは通常のPythonインポートとして使用します。
- 1パッケージをインストール:
pip install dspy。 - 2LLMプロバイダーを設定する——例えば、ホスト型モデルには
dspy.configure(lm=dspy.LM('openai/gpt-4o-mini', api_key='your-key'))を使うか、ローカルで提供されているOpenAI互換エンドポイントを指す。 - 3タスクの入力と出力を記述するSignatureを定義する。短い文字列(
"question -> answer")として、またはdspy.InputField()/dspy.OutputField()を使った型付きクラスとして。 - 4Signatureをモジュールでラップする——直接呼び出しには
dspy.Predict(...)、段階的推論にはdspy.ChainOfThought(...)を使い、関数のように呼び出す。 - 5オプション:小さなトレーニングセットとスコアリング関数を用意し、
dspy.BootstrapFewShotやdspy.MIPROv2などのオプティマイザーを実行して、調整済みバージョンのプログラムをコンパイルする。 - 6RAGパイプライン、
ReActによるエージェントループ、オプティマイザーの設定を含む完全なチュートリアル一式はDSPyドキュメントを参照。
旧パッケージ名について
古いチュートリアルや既存のコードベースの一部はpip install dspy-aiを参照しています——これは、プロジェクトが短い名前dspyを取り戻す前の、元のPyPI名でした。新規インストールではpip install dspyを使用してください。
DSPyの実行にDockerやGPUは必要か?
いいえ。DSPyは設定したLLMプロバイダーを呼び出すPythonライブラリであり、別途ローカルモデルサーバーを実行していない限り、DockerやローカルGPUハードウェアは不要です。
DSPyはローカルモデルで動作するか?
はい。DSPyのLM設定で指す先が、OpenAI互換または他にサポートされているエンドポイント経由で提供されているローカルモデルであれば動作します——DSPy自体は組み込みモデルを持ちません。
DSPyを使うべき人は?
DSPyは、すでにPythonでLLMパイプラインを書いていて、その中のプロンプトを手動の試行錯誤ではなく測定可能な結果に基づいて調整したい開発者に向いています。 マルチエージェントの調整やノーコードのインターフェースを主に必要とするチームには、あまり合いません。
こんな場合にDSPyを使う
- PythonのLLMパイプラインがあり、その出力をスコアリングする方法がある——DSPyのオプティマイザーは探索対象のメトリクスとトレーニングセットを必要とする
- プロンプトとFew-Shot例をプログラム的に、再現可能な形で生成・調整し、基盤モデルを切り替えた際に再最適化できるようにしたい
- タスクを型付きのSignatureとして定義し、コードでModuleを組み合わせることに抵抗がなく、ノーコードのビジュアルビルダーでの作業を求めていない
- タスクが
ChainOfThoughtのような構造化された推論戦略やReActのようなツール利用ループの恩恵を受け、それらの戦略を手動プロンプトではなく調整したい
こんな場合はDSPyを避ける
- 複数のLLMエージェントが通信・委任・タスク調整を行うマルチエージェント・オーケストレーションが必要——それはCrewAI、AutoGen、LangGraphの主要な仕事であり、DSPyのものではない
- ノーコードまたはローコードのインターフェースが必要——DSPyはLangflowやFlowiseのようなツールとは異なり、ビジュアルビルダーのないPythonライブラリである
- タスクにラベル付きの例やスコアリング関数がない——DSPyのオプティマイザーは何かに対して測定する必要があるため、それがなければ結局は手動でプロンプトを書くことになる
- ドキュメントローダー、ベクトルストアのコネクタ、エージェントツールなど、可能な限り幅広い既成の統合エコシステムが必要——その用途にはLangChainの方が統合範囲が広い
DSPyを使うべきでないのはどんな時か?
タスクの本質が、単一パイプライン内のプロンプト最適化ではなく、複数エージェントの調整やサードパーティ製ツール統合の配線である場合は、DSPyを避けましょう。
- ビジュアルなノーコードのワークフロービルダーが必要なチーム——DSPyはコードファーストで、ドラッグアンドドロップのインターフェースはない
- 本質的にマルチエージェント調整(エージェントが互いにサブタスクを委任し合う)であるプロジェクト——CrewAIやAutoGenのような、そのパターン専用に作られたフレームワークの方が構造的に適している
- 手書きの単一プロンプトですでに十分な性能が出ている単発のスクリプト——SignatureやModule、最適化ループの導入は、測定可能で再現性のあるプロンプト改善が必要な場合にのみ見合うエンジニアリングの手間を追加する
- 正しさをスコアリングする方法がないタスク——DSPyのオプティマイザーはメトリクス関数を必要とするため、ラベル付き例のない純粋に主観的なタスクでは、最適化ステップの恩恵がほとんどない
- パイプライン、メトリクス、トレーニングセットがあり、プロンプトエンジニアリングのステップを自動化・再現可能にしたい場合にこそDSPyを使う
DSPy vs. 代替ツール
DSPyは、ほとんどのエージェント・オーケストレーション・フレームワークとは異なるカテゴリに位置します。複数のエージェントを調整するのではなく、パイプライン内のプロンプトとFew-Shot例を最適化します。最も近い比較対象は、DSPyとは中心的な仕事が異なるものの、LLMパイプラインを構築するための他のPythonフレームワークです。
ツール | 中心的な役割 | ライセンス | ステータス | 最適な用途 |
|---|---|---|---|---|
| DSPy | プロンプト/重みの最適化 | MIT | 活発 | メトリクスに基づくプロンプト調整 |
| LangChain | 汎用LLMパイプライン構築 | MIT | 活発 | 最も広い統合エコシステム |
| LlamaIndex | RAG特化のデータフレームワーク | MIT | 活発 | 検索拡張パイプライン |
| Semantic Kernel | 構造化されたプロンプト/スキル構成 | MIT | 活発(MAFへ収束中) | エンタープライズ.NET/Python/Java SDK |
この表は、マルチエージェント・オーケストレーターではなく、概念的に最も近いPythonパイプラインフレームワークとDSPyを比較しています——DSPyは、エージェント調整を解決するCrewAIやAutoGen(プロンプト最適化ではない)と直接競合するものではありません。
DSPy評価時によくある間違い
これらの間違いは、DSPyをマルチエージェントフレームワークのように扱ったり、フレームワークの本来の目的である最適化ステップを省略したりすることから生じます。
間違い1:DSPyが複数エージェントをオーケストレーションすると期待する
DSPyのModuleは、通信し合うエージェントのチームではなく、単一のパイプラインに組み合わされます。互いにサブタスクを委任し合うエージェントを必要とするチームは、代わりにCrewAI、AutoGen、LangGraphを評価すべきです——DSPyはそれらのパイプラインの一部のステップ内のプロンプトを最適化できますが、オーケストレーション層そのものの代替にはなりません。
間違い2:オプティマイザーを一度も実行しない
SignatureとModuleを書いても、BootstrapFewShotやMIPROv2のようなオプティマイザーでプログラムをコンパイルしなければ、手書きのプロンプトを実際に上回るというDSPyの本質的な部分を省いていることになります——デフォルトの最適化されていないプロンプティングで実行されたModuleは、従来のワークフローで慎重に手動調整されたプロンプトより性能が劣ることがあります。
間違い3:PyPI上のdspy-aiとdspyを混同する
古いチュートリアルはpip install dspy-aiを参照していますが、これはプロジェクトが短い名前dspyを取り戻す前の元のPyPIパッケージ名です。現在のインストールでは、メンテナンスされている最新のパッケージを得るためにpip install dspyを使用してください。
よくある質問
DSPyはまだメンテナンスされているか?
はい。stanfordnlp/dspyリポジトリは活発に開発されています。本レビュー時点で、PyPI上のdspyパッケージはバージョン3.3.1(2026年8月21日リリース)でした。
DSPyは無料で使えるか?
はい。DSPyはMITライセンスであり、商用利用、改変、セルフホストが無料です。サブスクリプションやホスト型製品への支払いはありません。
DSPyとLangChainの違いは?
LangChainは幅広い統合エコシステムを持つLLMパイプライン構築のための汎用フレームワークです。DSPyは、型付きのSignatureとModuleでタスクをプログラムし、その後メトリクスに基づいてプロンプトとFew-Shot例を自動的に最適化することに特化しています。両者は異なる、互いに補完し合う問題を解決します。
DSPyのSignatureとModuleとは何か?
Signatureはタスクの入力と出力の型付き定義(例:"question -> answer")です。Moduleは、Signatureを取り巻く実行戦略を実装します——直接補完のためのPredict、段階的推論のためのChainOfThought、ツールを使う推論ループのためのReAct。
DSPyのオプティマイザーとは何か?
以前はteleprompterと呼ばれたオプティマイザーは、DSPyプログラム内のプロンプトとFew-Shot例を、メトリクスとトレーニングセットに対して自動的に調整するアルゴリズムです——名前付きオプティマイザーにはBootstrapFewShot、MIPROv2、GEPAがあります。
DSPyのインストール方法は?
pip install dspyを実行します。これが現行の正式なPyPIパッケージ名で、古いdspy-aiパッケージがこれに先行していました。
DSPyはCrewAIやAutoGenのようなマルチエージェントフレームワークを置き換えるか?
いいえ。DSPyはパイプライン内のプロンプトを最適化しますが、CrewAIやAutoGenのように複数のエージェントが通信し合うことをオーケストレーションするものではありません。両カテゴリは競合するのではなく、互いに補完し合います。
DSPyはどのライセンスで提供されているか?
商用利用の無料化、改変、セルフホストを許可するMITライセンスです。
DSPyを開発したのは誰か?
DSPyはStanford NLPで開発され、開発は2022年12月に始まりました。プロジェクトは454人を超えるコントリビューターを報告しており、Shopify、Databricks、AWSなどの企業での本番利用が記載されています。
DSPyのGitHubスター数は?
stanfordnlp/dspyリポジトリは、2026年9月時点で37,900を超えるGitHubスターと3,300を超えるフォークを獲得しています。