2026년 클라우드 GPU 시간당 비용은 얼마입니까?
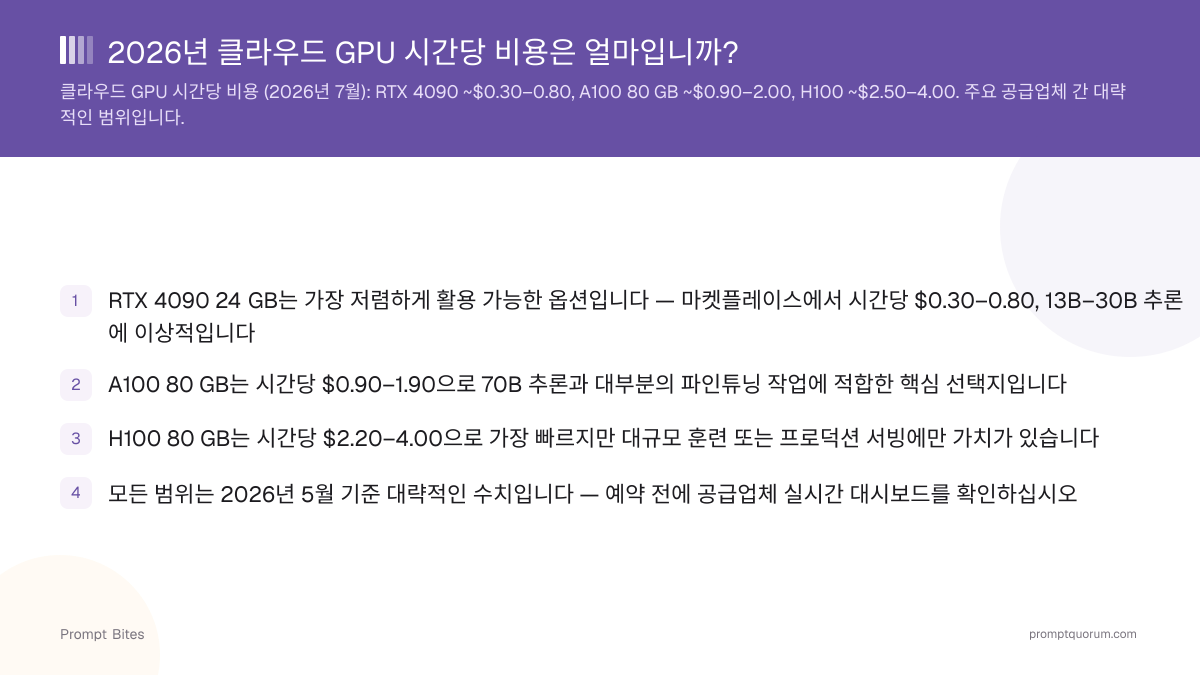
RunPod와 Lambda에서 클라우드 GPU 시간당 비용은 RTX 4090 24 GB가 $0.34–0.89, A100 80 GB가 $1.19–2.79, H100 80 GB가 $1.99–4.29입니다. 시간당 가장 저렴한 선택지는 구형 24 GB 카드로, RunPod는 Community Cloud에서 RTX A5000를 $0.16/시간부터, RTX 3090을 $0.22/시간부터 게시합니다. Vast.ai 마켓플레이스 가격은 수급에 따라 변하므로 예약 전에 실시간 목록을 확인하세요.
이 페이지에는 타사 제품에 대한 참조 링크가 포함되어 있습니다. PromptQuorum은 어떤 제휴 프로그램에도 등록되어 있지 않습니다 — 이는 수수료가 발생하지 않는 일반 링크입니다. 링크 클릭 및 이후 단계는 전적으로 귀하의 책임입니다. 이 링크는 PromptQuorum의 어떠한 보증이나 검증을 나타내지 않습니다.
빠른 답변
RTX 4090: $0.34–0.89/시간. A100 80 GB: $1.19–2.79/시간. H100 80 GB: $1.99–4.29/시간. 시간당 최저가: RTX A5000 $0.16/시간부터.
- ▸RunPod는 RTX 4090을 Community Cloud에서 $0.34/시간, Secure Cloud에서 $0.89/시간으로 게시합니다.
- ▸Lambda는 H100 PCIe를 $3.29/시간, H100 SXM을 $3.99–4.29/시간에 제공하며, RunPod의 H100 PCIe는 $1.99/시간부터입니다.
- ▸Vast.ai는 마켓플레이스로, 가격은 호스트마다 다르고 중단 가능한 대여는 더 저렴합니다. 실시간 목록을 확인하세요.
핵심 요점
- ✓RTX 4090 24 GB는 RunPod에서 $0.34–0.89/시간 — 13B–30B 추론을 위한 저비용 선택지
- ✓A100 80 GB는 RunPod와 Lambda에서 $1.19–2.79/시간으로, 70B 추론과 대부분의 파인튜닝의 주력
- ✓H100 80 GB는 $1.99–4.29/시간이며, 대규모 학습이나 지연 시간이 중요한 서빙에서만 가치가 있음
- ✓시간당 가장 저렴한 클라우드 GPU는 $0.16/시간부터 시작하는 구형 24 GB 카드 — 요금은 자주 바뀌므로 예약 전 제공업체 페이지를 확인
최적 선택: 워크로드에 맞는 카드를 고르십시오
가장 저렴하게 쓸 수 있는 클라우드 GPU는 모델이 들어가는 가장 작은 VRAM의 GPU입니다. 13B 모델을 돌리려고 최대 $4.29/시간의 H100을 빌리면 비용을 내는 VRAM 60 GB 이상이 낭비됩니다.
7B–13B 추론: RunPod의 $0.34–0.89/시간 RTX 4090 24 GB 또는 Vast.ai 마켓플레이스 호스트. 24 GB VRAM이면 충분하고, 소비자용 카드 풀은 관리형 클라우드보다 저렴합니다.
70B 추론이나 중간 규모 파인튜닝: $1.19–2.79/시간의 A100 80 GB. 80 GB VRAM이면 70B 모델을 Q4로 컨텍스트 여유를 두고 올릴 수 있습니다. 최첨단 모델 학습이나 엄격한 지연 시간 목표의 프로덕션 서빙: $1.99–4.29/시간의 H100 80 GB — 지속 처리량이 제약일 때만 가치가 있습니다.
GPU 카드별 클라우드 시간당 요금
아래 범위는 RunPod(Community Cloud와 Secure Cloud)와 Lambda의 온디맨드 정가를 합친 것입니다. 하한은 RunPod Community Cloud, 상한은 두 업체 중 가장 높은 온디맨드 정가입니다. Vast.ai 마켓플레이스 가격은 호스트마다 달라 포함하지 않았습니다.
| GPU | VRAM | 시간당 가격 | 적합한 용도 |
|---|---|---|---|
| RTX 4090 | 24 GB | $0.34–0.89/시간 | 7B–30B 추론, 가벼운 파인튜닝 |
| RTX 5090 | 32 GB | $0.69–1.19/시간 | 30B급 추론, 빠른 파인튜닝 |
| A100 80 GB | 80 GB | $1.19–2.79/시간 | 70B 추론, 대부분의 파인튜닝 |
| H100 80 GB | 80 GB | $1.99–4.29/시간 | 대규모 학습, 저지연 서빙 |
시간당 가장 저렴한 클라우드 GPU
확인한 RunPod와 Lambda 목록 중 시간당 가장 저렴한 클라우드 GPU는 $0.16/시간부터 시작하는 구형 24 GB 및 48 GB 카드입니다. RunPod가 Community Cloud와 Secure Cloud 요금을 게시하며, 소형 모델 추론과 테스트에 적합하고 대규모 학습에는 맞지 않습니다.
| GPU | VRAM | 시간당 가격 | 적합한 용도 |
|---|---|---|---|
| RTX A5000 | 24 GB | $0.16–0.27/시간 | 7B–13B 추론, 테스트 |
| RTX 3090 | 24 GB | $0.22–0.50/시간 | 13B–30B 추론 |
| RTX A6000 | 48 GB | $0.33–0.59/시간 | 48 GB가 필요한 모델 |
| L4 | 24 GB | $0.44–0.59/시간 | 저전력 추론 |
요약 정보
📍 한 문장으로
클라우드 GPU 비용은 RTX 4090이 시간당 약 $0.34–0.89, A100 80 GB가 $1.19–2.79, H100 80 GB가 $1.99–4.29입니다.
💬 쉽게 설명하면
클라우드에서 GPU를 빌리는 비용은 시간 단위로 청구되며, 카드 종류, 제공업체, 대여 중단 가능 여부에 따라 달라집니다. 24 GB급 소형 카드가 가장 저렴하고 소형·중형 모델에 적합하며, A100과 H100은 더 비싸고 대형 모델과 학습에 쓰입니다.
관련 읽을거리
- ▸RunPod vs Vast.ai 가격 비교 — 관리형 대 마켓플레이스 장단점
- ▸로컬 LLM용 $600 이하 최적 GPU — 구매 대 임대 결정을 위한 맥락
- ▸로컬 LLM용 GPU 구매 완전 가이드 2026 — 하드웨어 구매 전체 개요
클라우드 GPU 가격에 대한 자주 묻는 질문
GPU를 시간 단위로 빌리면 얼마입니까?▾
시간 단위로 빌릴 수 있는 가장 저렴한 GPU는 무엇입니까?▾
클라우드 GPU를 빌리는 것이 구매보다 저렴한 때는 언제입니까?▾
같은 GPU인데 제공업체마다 가격이 크게 다른 이유는 무엇입니까?▾
표시된 요금에 스토리지와 대역폭이 포함됩니까?▾
지금 내 작업에 가장 저렴한 GPU를 찾으려면 어떻게 합니까?▾
전체 설명이 필요하십니까?
전체 가이드 읽기 →