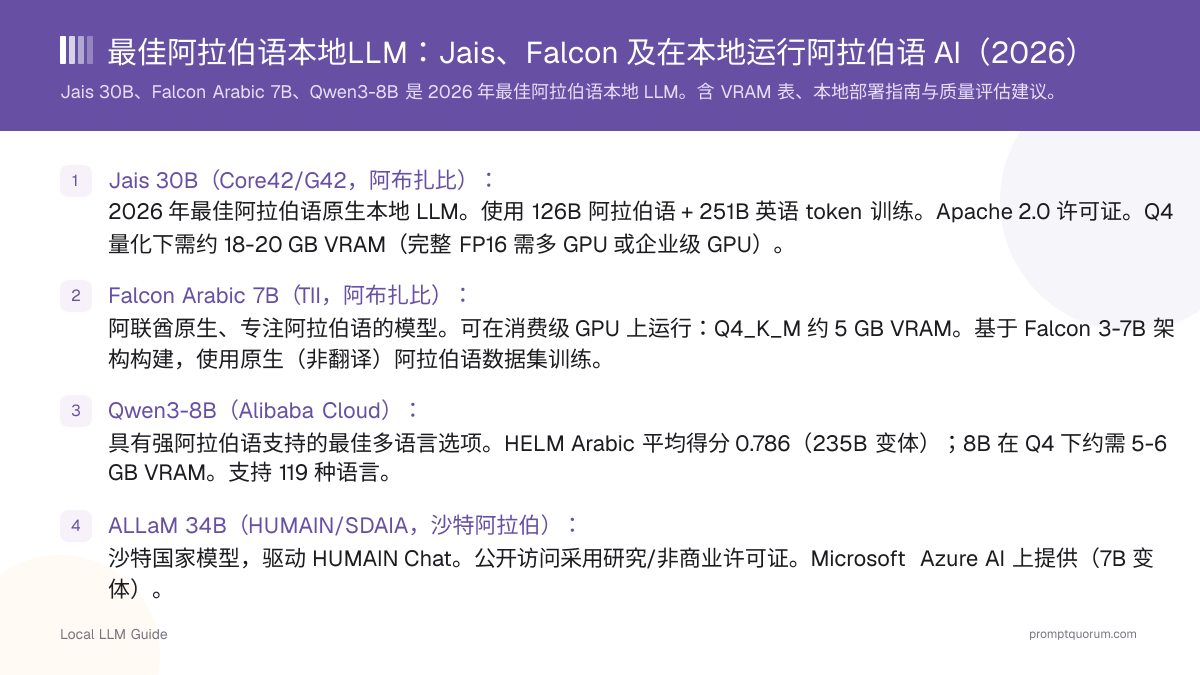
关键要点
- Jais 30B(Core42/G42,阿布扎比): 2026 年最佳阿拉伯语原生本地 LLM。使用 126B 阿拉伯语 + 251B 英语 token 训练。Apache 2.0 许可证。Q4 量化下需约 18-20 GB VRAM(完整 FP16 需多 GPU 或企业级 GPU)。
- Falcon-H1-Arabic 7B(TII,阿布扎比): 阿联酋原生、专注阿拉伯语的模型。可在消费级 GPU 上运行:Q4_K_M 约 5 GB VRAM。基于 Falcon-H1 混合架构构建,使用原生(非翻译)阿拉伯语数据集训练。
- Qwen3-8B(Alibaba Cloud): 具有强阿拉伯语支持的最佳多语言选项。HELM Arabic 平均得分 0.786(235B 变体);8B 在 Q4 下约需 5-6 GB VRAM。支持 119 种语言。
- ALLaM 34B(HUMAIN/SDAIA,沙特阿拉伯): 沙特国家模型,驱动 HUMAIN Chat。公开访问采用研究/非商业许可证。Microsoft Azure AI 上提供(7B 变体)。
- Fanar-2-27B-Instruct(QCRI/HBKU,卡塔尔): 卡塔尔主权阿拉伯语模型,约于 2026 年 3 月以 Apache 2.0 许可证发布。以 Gemma-3-27B-pt 为骨干、在经过整理的 120B token 语料库上持续预训练;上下文长度 32,768 token。OALL-v2 得分 69.40,ArabicMMLU 得分 74.67。Q4_K_M 估算约 16-17 GB VRAM。
- MSA 与方言: 所有模型都能很好地处理现代标准阿拉伯语(MSA)。方言覆盖程度各不相同——请用目标方言的真实示例测试你的具体用例。
- 部署: Ollama 原生支持 Falcon-H1-Arabic(ollama run hf.co/tiiuae/Falcon-H1-Arabic-7B-Instruct-GGUF)。Jais 和 ALLaM 需要从 Hugging Face 转换为 GGUF 才能用于 llama.cpp/Ollama。
- 数据主权: 在本地运行阿拉伯语 NLP 可将个人数据保留在国境之内——符合 UAE PDPL、Saudi NDMO 以及海湾地区数据主权目标。
📍 简单一句话
Jais 30B(Apache 2.0,阿布扎比)和 Falcon-H1-Arabic 7B(TII,阿布扎比)是 2026 年最顶尖的阿拉伯语原生本地 LLM,而 Qwen3-8B 在消费级硬件的多语言阿拉伯语基准上领先。
💬 简单来说
你可以在自己服务器上运行的最佳阿拉伯语 AI:Jais 30B 提供最佳阿拉伯语质量(需要高端 GPU),Falcon-H1-Arabic 7B 适用于普通电脑,如果你还需要其他语言则选 Qwen3-8B。
为什么阿拉伯语能力本地 LLM 很重要
阿拉伯语是海湾、黎凡特和北非地区超过 3 亿人的母语。 对于阿联酋、沙特阿拉伯、卡塔尔、埃及及更广泛地区的企业 AI 而言,阿拉伯语质量是一项实际需求——而非事后考虑。
MSA 与方言阿拉伯语。 现代标准阿拉伯语(الفصحى / MSA)是媒体、政府和教育中使用的正式书面标准。各地区方言(海湾、埃及、黎凡特、摩洛哥)差异很大——仅用 MSA 训练的模型可能会误读海湾方言输入。企业用例应同时测试两者。
数据主权是第二大驱动因素。 海湾监管机构(UAE PDPL、Saudi Arabia NDMO)限制跨境个人数据传输。将阿拉伯语客户或患者数据发送到美国托管的云 API 会带来传输风险。在本地运行阿拉伯语 NLP 可消除该风险。参见我们的 UAE PDPL 数据主权指南。
“翻译式英语”质量差距。 许多通用 LLM 声称支持阿拉伯语,但主要在翻译的英语数据上微调。阿拉伯语的 tokenization 可能效率低下(阿拉伯文需要正确的从右到左 tokenization)。像 Jais 和 Falcon-H1-Arabic 这样真正的双语模型是在阿拉伯语语料上原生训练的。
最佳阿拉伯语本地 LLM:本地部署排名
按阿拉伯语能力和本地/本地部署适用性排名。
- 1. Jais 30B — 最佳阿拉伯语质量(Apache 2.0,可本地部署)。 开发者:Core42 / Inception AI(G42 集团,阿布扎比)+ MBZUAI 研究 + Cerebras 训练。训练:126B 阿拉伯语 token + 251B 英语 token + 50B 代码 token。人工评估显示 Jais 30B 在 96% 的阿拉伯语评估中优于 Jais 13B。许可证:Apache 2.0(完全开放,允许商业使用)。Hugging Face:inceptionai/jais-30b-v3。VRAM:Q4 估计约 18-20 GB(FP16 需企业级 GPU 或多 GPU)。最适合:以阿拉伯语为主的企业文档处理、客户支持和政府部署中追求最高阿拉伯语质量的场景。
- 2. Falcon-H1-Arabic 7B — 最适合消费级硬件(TII 阿布扎比)。 开发者:Technology Innovation Institute(TII),阿布扎比(隶属 Advanced Technology Research Council)。基础:Falcon-H1 混合架构(发布于 2026年1月5日)。训练:原生(非翻译)阿拉伯语数据集,含 MSA 和地区方言。许可证:Falcon LLM License——宽松,允许商业使用。VRAM:Q4_K_M 约 5 GB——可在 RTX 4060 8GB、RTX 3060 12GB 及同等硬件上运行。基准:在 Open Arabic LLM Leaderboard(OALL)上取得 71.47% 的成绩——在约 10B 级阿拉伯语模型中排名第一,超过 ALLaM-7B、Fanar-9B 和 Qwen3-8B,并取代了基于 Falcon 3 的旧版 Falcon Arabic 检查点。最适合:消费级和专业消费级硬件部署;来自阿布扎比机构的阿联酋原生模型。
- 3. Qwen3-8B — 具有强阿拉伯语支持的最佳多语言选项(Alibaba Cloud)。 开发者:Alibaba Cloud。语言:119 种语言和方言。基准:Qwen3-235B-A22B 在 HELM Arabic 上取得 0.786 平均分;推荐 8B 变体用于本地硬件。许可证:Apache 2.0。VRAM:Q4_K_M 约 5-6 GB。最适合:需要在单一模型中同时使用阿拉伯语 + 英语 + 其他语言的团队;在 Ollama 中广泛支持(ollama pull qwen3:8b)。
- 4. ALLaM 34B / 7B — 沙特国家模型(HUMAIN/SDAIA)。 开发者:SDAIA(Saudi Data and AI Authority)/ HUMAIN(沙特国家 AI 公司)。版本:7B(Hugging Face,研究访问)和 34B(驱动 HUMAIN Chat)。Azure:ALLaM-2-7B-Instruct 自 2024 年 9 月起在 Microsoft Azure AI 上提供。许可证:公开访问采用研究/非商业许可证;企业许可通过 HUMAIN。最适合:沙特政府和企业部署;符合 Vision 2030 的主权模型。
- 5. Fanar-2-27B-Instruct — 卡塔尔主权阿拉伯语模型(Apache 2.0)。 开发者:Qatar Computing Research Institute(QCRI)、Hamad Bin Khalifa University(HBKU),卡塔尔。发布:约 2026 年 3 月(技术报告《Fanar 2.0: Arabic Generative AI Stack》)。基础:以 Gemma-3-27B-pt 为骨干持续预训练,使用经过整理的 120B token 语料库,在 256 块 NVIDIA H100 GPU 上训练。上下文长度:32,768 token。许可证:Apache 2.0——完全开放,允许商业使用。覆盖范围:现代标准阿拉伯语(MSA)以及海湾、黎凡特和埃及方言。功能:原生阿拉伯语推理轨迹、可选 thinking 模式、tool calling;更广泛的 Fanar 2.0 系列为多模态(图像、speech-to-text、text-to-speech、音频理解、阿拉伯语诗歌生成)。基准:OALL-v2 69.40、ArabicMMLU 74.67、Belebele 86.81、ACVA 82.70。VRAM:Q4_K_M 估算约 16-17 GB,FP16 估算约 54 GB;提供 GGUF 量化版本,可在 llama.cpp、Ollama 和 LM Studio 中运行。最适合:需要完全宽松商业许可的主权阿拉伯语模型的卡塔尔及海湾地区公共部门和企业部署。
- 6. Llama 3.1-8B-Instruct — 最佳通用多语言基线(Meta)。 开发者:Meta。语言:20+ 种,包括阿拉伯语。许可证:Meta Llama 3.1 License——宽松,广泛商业使用。VRAM:Q4_K_M 约 5-6 GB。最适合:同时需要广泛多语言支持的阿拉伯语工作负载;广泛部署且社区支持丰富。如果阿拉伯语质量是首要考虑,请使用 Qwen3-8B 或 Jais。
- 7. Gemma 3(4B/12B)— 包含阿拉伯语的强多语言模型(Google)。 开发者:Google。语言:140+ 种,包括阿拉伯语(MSA 和古典阿拉伯语)。许可证:Gemma Terms of Use(对大多数商业用途宽松)。VRAM:4B 在 Q4 下约 3 GB;12B 在 Q4 下约 8 GB。最适合:已身处 Google 生态系统的团队;多语言翻译和摘要;阿拉伯文文档处理。

阿拉伯语本地 LLM 的 VRAM 需求
按模型和量化方式列出所需 VRAM。标注 * 的行为参数缩放估算(未找到官方基准)。部署前请务必用你的具体硬件验证。
模型 | 参数量 | Q4_K_M VRAM | FP16 VRAM | 最低硬件 |
|---|---|---|---|---|
| Falcon-H1-Arabic | 7B | ~5 GB | ~16.7 GB | RTX 4060 8 GB / RTX 3060 12 GB |
| Jais 13B | 13B | ~8-10 GB* | ~26 GB* | RTX 3090 24 GB (Q4) |
| Jais 30B | 30B | ~18-20 GB* | ~60 GB* | RTX 4090 24 GB(Q4 吃紧), A100 40 GB (FP16) |
| ALLaM | 7B | ~5 GB* | ~16 GB* | RTX 4060 8 GB / RTX 3060 12 GB |
| Fanar-2 | 27B | ~16-17 GB* | ~54 GB* | RTX 4090 24 GB (Q4) |
| Qwen3 | 8B | ~5-6 GB | ~16 GB | RTX 4060 8 GB / RTX 3060 12 GB |
| Llama 3.1 | 8B | ~5-6 GB | ~16 GB | RTX 4060 8 GB / RTX 3060 12 GB |
| Gemma 3 | 4B | ~3 GB | ~8 GB | RTX 3060 8 GB |

如何用 Ollama 在本地运行阿拉伯语模型
在 GPU 服务器或工作站上本地部署阿拉伯语模型的分步指南。
- 1安装 Ollama:curl -fsSL https://ollama.com/install.sh | sh(Linux)或从 ollama.com 下载(Windows/Mac)。原生支持 Falcon-H1-Arabic。
- 2拉取并运行 Falcon-H1-Arabic 7B:ollama run hf.co/tiiuae/Falcon-H1-Arabic-7B-Instruct-GGUF——约 5 GB 下载,下载后自动运行。用类似 "اكتب قصيدة عن أبوظبي"(写一首关于阿布扎比的诗)的提示词测试阿拉伯语。
- 3拉取 Qwen3-8B 用于多语言:ollama pull qwen3:8b——约 5 GB 下载。在 MSA 和方言场景下都有强阿拉伯语能力。
- 4对于 Jais 30B:从 Hugging Face 下载(inceptionai/jais-30b-v3),用 llama.cpp 转换工具转为 GGUF,量化为 Q4_K_M,然后用 Ollama 加载(ollama create jais-30b -f Modelfile)或 llama.cpp 服务器加载。
- 5生产推理:使用 vLLM 进行高吞吐量阿拉伯语 API 服务。vLLM 原生支持 Falcon-H1-Arabic 和 Qwen3。通过 localhost:8000 上的 OpenAI 兼容端点暴露。
- 6阿拉伯语提示词技巧:始终指定语言——"أجب باللغة العربية الفصحى"(用现代标准阿拉伯语回答)。对于方言,请在系统提示词中包含目标方言的示例句子。
如何为你的用例评估阿拉伯语 LLM 质量
基准只是一个起点。真实世界的阿拉伯语质量必须在你的具体领域和方言上评估。
- HELM Arabic(Stanford CRFM): 整体多语言评估。Qwen3-235B 平均分 0.786。将其作为模型之间的相对比较点——而非针对你领域的绝对质量分数。
- ALUE(Arabic Language Understanding Evaluation): 8 项 NLU 任务,包括情感分析、立场检测和方言识别。以 Twitter 数据为主——适合社交媒体和客户反馈用例。
- ArabicMMLU: MSA 中的学术和专业知识任务。最适合企业知识库和文档问答质量的基准。
- AraBench: 方言特定的翻译质量(埃及、叙利亚、海湾)。如果你的用例专门涉及海湾阿拉伯语,请在此测试。
- 你自己的评估(推荐): 用你实际的领域和目标方言编写 20-30 条测试提示词。从以下方面评分输出:(1) 事实准确性,(2) 自然的阿拉伯语语法,(3) 适当的语域(正式 vs. 方言),(4) 推理中正确的从右到左结构。
- 警示信号: 如果模型在回答中途无提示地切换到英语,或产生“翻译式”措辞(从英语模式逐字翻译),则其质量不足以用于生产环境的阿拉伯语。
关于阿拉伯语本地 LLM 的常见问题
我能在普通游戏笔记本上运行阿拉伯语 LLM 吗?
可以,对于 Q4 量化的 7B 级模型。Falcon-H1-Arabic 7B 和 Qwen3-8B 需要约 5-6 GB VRAM——大多数配备 RTX 4060(8 GB)或 RTX 3060(12 GB)的游戏笔记本都能运行。Jais 30B 在 Q4 量化下需要高端桌面 GPU(RTX 4090 24 GB)或企业级 GPU。
Jais 和 Falcon-H1-Arabic 有什么区别?
两者都源自阿布扎比,都具备阿拉伯语能力。Jais(Core42/G42)更大(最高 30B),专门作为阿拉伯语-英语双语模型训练,含 126B 阿拉伯语 token——针对企业级阿拉伯语质量优化。Falcon-H1-Arabic 是来自 TII(另一家阿布扎比机构)的 7B 模型,基于更广泛的 Falcon-H1 混合架构构建——对消费级 GPU 友好,属于阿联酋 AI 生态系统的一部分。追求最佳阿拉伯语质量:Jais 30B。消费级硬件:Falcon-H1-Arabic 7B。
Qwen3 对阿拉伯语的支持和专用阿拉伯语模型一样好吗?
Qwen3 拥有非常强的通用阿拉伯语支持(119 种语言,领先的 HELM Arabic 分数)。对于需要绝对最佳阿拉伯语质量的纯阿拉伯语企业部署,通常更倾向于 Jais 30B。对于阿拉伯语只是多种所需语言之一的混合多语言工作负载,Qwen3-8B 凭借其广度和易部署性往往是更好的选择。
ALLaM 是什么,我能用于商业用途吗?
ALLaM 是来自 SDAIA(现归于 HUMAIN 品牌)的沙特国家阿拉伯语为中心的 LLM 系列。公开版本(Hugging Face 上的 7B、Azure AI 上的 7B)采用研究/非商业许可证。对于沙特阿拉伯的商业用途或企业部署,请直接联系 HUMAIN/SDAIA。ALLaM 34B 驱动国家级 HUMAIN Chat 应用,但公开访问受限。
阿拉伯语 tokenization 如何影响模型质量?
阿拉伯文需要正确的 tokenization 以避免字符级错误。在阿拉伯语上原生训练的模型(Jais、Falcon-H1-Arabic)使用针对阿拉伯语形态优化的 tokenizer。通用多语言模型可能对阿拉伯语进行低效 tokenization(拆分词根-词型形态),导致复杂阿拉伯文本质量下降。生产部署前请用你的实际输入数据测试。
阿拉伯语本地 LLM 能处理从右到左(RTL)文档吗?
这些模型按正确的从右到左方向生成阿拉伯文本——阿拉伯语在 Unicode 中是双向的,模型会产生正确的 RTL 阿拉伯文。你的应用界面必须处理 RTL 渲染(HTML dir="rtl"、CSS direction:rtl)。llama.cpp、Ollama 和 vLLM 会正确返回 Unicode 阿拉伯文本;方向由 UI 层处理。
哪款阿拉伯语 LLM 最适合阿联酋政府部署?
Falcon-H1-Arabic 7B(来自 TII,阿布扎比)和 Jais 30B(来自 Core42/G42,阿布扎比)都是阿联酋原生模型,出自与阿联酋政府有关联的研究机构。从主权和可审计性来看,这是最契合的选择。两者都可本地部署,无需任何数据离开阿联酋基础设施。参见我们的 UAE PDPL 数据主权指南。
在提示词中如何处理海湾阿拉伯语方言与 MSA?
默认系统提示词:"أجب باللغة العربية الفصحى"(用现代标准阿拉伯语回答)。对于海湾阿拉伯语(阿联酋、沙特、科威特),在系统提示词中添加示例方言短语,或在领域数据上微调。所有列出的模型都能很好地处理 MSA;方言质量各异。在假定可用于生产之前,请专门用 5-10 条示例方言查询测试。
我能用自己的阿拉伯语数据微调 Jais 或 Falcon-H1-Arabic 吗?
可以——两者都使用允许微调的开放许可证(Jais 为 Apache 2.0,Falcon-H1-Arabic 为 Falcon LLM License)。使用 LoRA 或 QLoRA 微调,配合 Unsloth 或 PEFT 库等工具。在领域特定阿拉伯语数据(法律、医疗、金融)上微调能显著提升专业用例的质量。为符合 PDPL 合规,请将微调数据保留在本地。
在本地运行 Jais 30B 需要什么硬件?
在 Q4_K_M 量化下,Jais 30B 估计需要 18-20 GB VRAM(估算——无官方基准)。NVIDIA RTX 4090(24 GB)可在 Q4 下以中等上下文运行;A100 40 GB 可在 FP16 下轻松处理。对于生产吞吐量,推荐两块 RTX 4090 多 GPU 模式或单块 A100/H100。参见我们的 VRAM 计算器指南。
来源
- Technology Innovation Institute (TII) — Falcon-H1-Arabic 公告,January 5, 2026 — tii.ae
- Falcon-H1-Arabic Hugging Face 模型页面 — huggingface.co/blog/tiiuae/falcon-h1-arabic
- Core42 / Cerebras — Jais 30B 新闻稿 — cerebras.ai and g42.ai
- Jais 30B on Hugging Face — huggingface.co/inceptionai/jais-30b-v3
- SDAIA / HUMAIN — ALLaM 34B 公告,May 2025 — humain.ai
- ALLaM-2-7B on Microsoft Azure AI — techcommunity.microsoft.com (September 2024)
- QCRI / HBKU — 技术报告《Fanar 2.0: Arabic Generative AI Stack》与 Fanar-2-27B-Instruct 模型卡 — arxiv.org/abs/2603.16397
- HELM Arabic — Stanford CRFM, December 2025 — crfm.stanford.edu/2025/12/18/helm-arabic.html
- Qwen3 Technical Report — arxiv.org/abs/2505.09388
- ALUE Benchmark — aclanthology.org/2021.wanlp-1.18
- TII Arabic LLM Benchmarks — github.com/tiiuae/Arabic-LLM-Benchmarks