关键要点
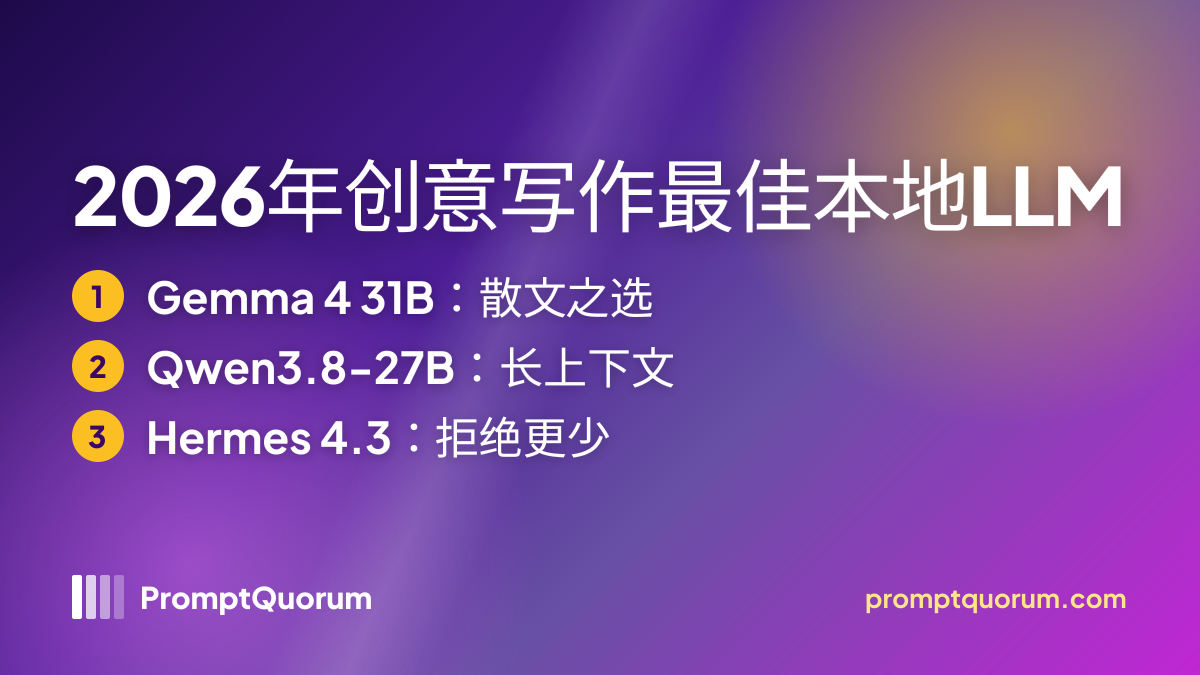
- Gemma 4 31B是24GB显卡的散文之选。 权重约19–20GB,256K上下文,Apache 2.0,是本组中唯一拥有自己公开的EQ-Bench Creative Writing v3分数的模型(评分标准16.01,Elo 1407.6)。
- Qwen3.8-27B是长上下文和指令遵循之选。 Ollama上约18GB,256K上下文,Apache 2.0。目前尚无公开的创意写作分数,散文质量未经验证,请用自己的场景测试。
- 按显存而不是排行榜选模型。 12GB:Gemma 4 12B。16GB:Mistral Small 3 24B。24GB:Gemma 4 31B或Qwen3.8-27B。48GB及以上:Llama 3.3 70B。
- Hermes 4.3 36B是低拒绝率之选。 Apache 2.0,基于字节跳动Seed-OSS-36B;Nous Research称其拒绝大幅减少。Dolphin 3.0是较老的替代。
- 采样比换模型更重要。 散文用温度0.9–1.1、top-p 0.92–0.95;写小说时关闭thinking模式。编程式设置(0.2–0.4)会让文字平淡。
- 闭源云端模型仍领跑创意写作基准。 EQ-Bench Creative Writing v3榜首是Claude Opus 4.7,2,206 Elo;榜上最好的开放权重条目是Kimi K2.6,1,782,远超消费级硬件。本地胜在隐私、成本和可控性。
速览
- 24GB显卡或32GB Mac: Gemma 4 31B(
gemma4:31b,19–20GB)或Qwen3.8-27B(qwen3.8:27b,18GB)。两者均为Apache 2.0,均为256K上下文。 - 12GB显卡: Gemma 4 12B(
gemma4:12b,7.7–8.0GB),256K上下文。 - 16GB显卡: Mistral Small 3 24B(
mistral-small:24b,14GB),32K上下文,Apache 2.0。2025年发布。 - 48GB及以上: Llama 3.3 70B(
llama3.3:70b,Q4_K_M约42GB)。2024年12月发布;Meta社区许可证。 - 低拒绝率微调: Hermes 4.3 36B(Apache 2.0)和Dolphin 3.0(Mistral 24B版本,2025年2月)。
- 散文采样基线: 温度1.0,top-p 0.95,min-p 0.05;场景出现循环时加重复惩罚或DRY。
- 内存规则: Ollama列出的大小只是权重。为长场景扩大上下文窗口后,还要加2–6GB的KV缓存。
推荐是如何得出的
本排名是对已发布资料的编辑性综合,不是PromptQuorum的新一轮测试。 我们对比了官方模型卡、Ollama库(大小、上下文、标签)和公开的创意写作排行榜,再把每个模型对应到一个硬件档位。
- 大小与上下文: 取自Gemma 4、Qwen3.8、Mistral Small的Ollama页面以及Hugging Face模型卡。仅含权重,上下文内存另算。
- 创意写作分数: EQ-Bench Creative Writing v3和Open Writing Leaderboard,经第三方追踪站转载。Gemma 4 31B有自己的分数,Qwen3.8-27B暂时没有。若分数属于同系列的其他模型,我们会注明。
- 发布时间: Qwen3.8-27B(2026年8月)、Gemma 4(2026年7月)、Mistral Small 3(2025年)、Llama 3.3 70B(2024年12月)、Hermes 4.3 36B(2025年12月)、Dolphin 3.0(2025年2月)。
- 我们没有做的事: 我们没有在这些模型上重新跑一套打分的提示词。下面的各模型评价依据所引用的来源和模型卡;“最适合”是推荐,不是实测结果。
- 关于能在任何模型上提升创意输出的提示技巧,请参阅温度与top-p控制和角色提示。
📌注: 创意写作基准具有主观性,各排行榜之间也会互相矛盾。请把这里的每个推荐当作起始假设:用同样的三个场景测试两个候选,保留声音更合你心意的那个。
按显存档位选模型
先按内存选:模型必须放得下,并为上下文留出余量。 大小为Ollama默认4位量化下的下载大小;长场景请再加2–6GB的KV缓存。
你的内存 | 模型 | 权重 | 上下文 |
|---|---|---|---|
| 8GB显卡 | Qwen3.5 9B(qwen3.5:9b) | 6.6–7.6GB | 256K |
| 12GB显卡 | Gemma 4 12B(gemma4:12b) | 7.7–8.0GB | 256K |
| 16GB显卡 | Mistral Small 3 24B(mistral-small:24b) | 14GB | 32K |
| 24GB显卡 / 32GB Mac | Gemma 4 31B(gemma4:31b) | 19–20GB | 256K |
| 24GB显卡 / 32GB Mac | Qwen3.8-27B(qwen3.8:27b) | 18GB | 256K |
| 24GB显卡,更快输出 | Gemma 4 26B-A4B(gemma4:26b) | 16–19GB | 256K |
| 48GB及以上 | Llama 3.3 70B(llama3.3:70b) | 约42GB | 128K |
💡提示: 32GB的Mac上,统一内存与macOS共享。模型加上下文大约可用24GB,这样Gemma 4 31B和Qwen3.8-27B都能从容运行。
横向对比:创意写作的本地模型
没有哪个模型能赢下所有任务;请按硬件档位和你工作中最关键的需求来选。 表中列出本指南的模型及其大小、权重和发布时间。
📍 简单一句话
Gemma 4 31B和Qwen3.8-27B是24GB显卡上创意写作最佳的本地选择;Gemma 4 12B、Mistral Small 3 24B和Llama 3.3 70B分别覆盖12GB、16GB和48GB档位;Hermes 4.3 36B是低拒绝率选项。
💬 简单来说
选你的内存放得下、且留有上下文余量的最大模型。24GB显卡上,散文选Gemma 4 31B,长篇项目选Qwen3.8-27B。只有当instruct模型拒绝你必须写的场景时,才加一个低拒绝率微调模型。
模型 | 规模 | 权重(Ollama) | 发布 | 最适合 |
|---|---|---|---|---|
| Gemma 4 31B | 31B稠密 | 19–20GB | 2026年7月 | 24GB散文;有自己的EQ-Bench分数 |
| Qwen3.8-27B | 27B稠密 | 18GB | 2026年8月 | 长篇项目,指令遵循 |
| Gemma 4 26B-A4B | 26B MoE,4B激活 | 16–19GB | 2026年7月 | 24GB上更快生成 |
| Gemma 4 12B | 12B | 7.7–8.0GB | 2026年7月 | 12GB显卡,长上下文 |
| Mistral Small 3 24B | 24B稠密 | 14GB | 2025年 | 16GB显卡;较老但可靠 |
| Llama 3.3 70B | 70B稠密 | 约42GB | 2024年12月 | 48GB及以上;较老的基准 |
| Hermes 4.3 36B | 36B稠密 | 约21–23GB(估) | 2025年12月 | 拒绝更少,Apache 2.0 |
| Dolphin 3.0 | 24B(Mistral版) | 约14GB | 2025年2月 | 较老的低拒绝率选项 |
💡提示: 常见做法是双模型搭配:一个instruct模型作日常主力,再配Hermes 4.3 36B处理instruct模型拒绝的场景。两者可同时出现在ollama list中。
各模型评价
- Gemma 4 31B — 24GB的散文之选。它是本组中唯一拥有自己的EQ-Bench Creative Writing v3结果的模型(评分标准16.01,Elo 1407.6,来自第三方追踪站)。256K上下文,Apache 2.0。Google给出的默认值是温度1.0、top-p 0.95、top-k 64。
- Qwen3.8-27B — 长篇项目之选。原生262,144 token上下文(用YaRN可扩展到1M),Apache 2.0,Ollama上约18GB。阿里巴巴将其定位于编程、智能体和研究;模型卡未提及创意写作,也没有公开的创意分数,所以请用自己的场景验证声音。thinking模式默认开启,写散文时请关闭。
- Gemma 4 26B-A4B与12B — 同一系列,取舍不同。26B混合专家模型每个token约激活4B参数,因此在相近内存下比31B生成更快。12B可放进12GB显卡,并仍提供256K上下文。
- Mistral Small 3 24B — 16GB之选。Apache 2.0,约14GB,32K上下文。它是2025年的模型,是除Llama外这里最老的推荐;保留它是因为能放进16GB的较新模型很少。其后继者Mistral Small 4(2026年3月,Apache 2.0)是激活参数约6B的119B混合专家模型,远超16GB。
- Llama 3.3 70B — 48GB的基准。2024年12月的模型,Meta社区许可证。对48GB及以上的机器,它仍是强大且支持广泛的选择;低于这个档位则不实用。
- Hermes 4.3 36B — 低拒绝率之选。基于字节跳动Seed-OSS-36B,Apache 2.0,Hugging Face上有GGUF量化。Nous Research称拒绝大幅减少;在其自有RefusalBench上,Hermes 4.3回答了72–75%的提示。模型卡建议温度0.6、top-p 0.95、top-k 20;写散文时请调高温度。
- Dolphin 3.0 — 较老的低拒绝率选项。我们能确认的最新Dolphin版本是Dolphin 3.0(2025年2月,含Mistral 24B版本)。想要Mistral系的无审查模型时可用;更新的选择是Hermes 4.3。
📌注: 声音一致性是写作者最容易低估的指标。一个模型某一段写得精彩,但到第五段就丢了角色的说话方式,不如一个稳定的模型。请测试长会话中的连贯性,而不只是单次输出的质量。
创意写作最佳Ollama模型
五条ollama pull命令覆盖本指南的所有硬件档位。 之后运行ollama list确认模型已安装。
- 24GB,散文:
ollama pull gemma4:31b— 然后ollama run gemma4:31b。 - 24GB,长篇项目:
ollama pull qwen3.8:27b— 用ollama run qwen3.8:27b --think=false运行,以便写散文时关闭thinking。 - 12GB:
ollama pull gemma4:12b。 - 16GB:
ollama pull mistral-small:24b。 - 48GB及以上:
ollama pull llama3.3:70b。 - 低拒绝率微调:
ollama run hf.co/NousResearch/Hermes-4.3-36B-GGUF会从Hugging Face拉取Hermes 4.3的GGUF;24GB显卡请选4位量化。 - 长场景请扩大上下文窗口。 Ollama的默认上下文较小。在交互会话中输入
/set parameter num_ctx 16384,或在Modelfile中设置num_ctx。数值越大,占用的显存越多。
写作用本地模型与云端模型
闭源云端模型在创意写作基准上得分更高;本地模型胜在隐私、成本和可控性。 如果有人搜索“最适合写作的LLM”而没有加“本地”,排行榜给出的答案会与本指南不同。
- 闭源模型领先。 在evals.report转载的EQ-Bench Creative Writing v3上,Claude Opus 4.7以2,206 Elo排第一,领先GPT-5.5的2,035。
- 最好的开放权重条目需要数据中心。 Kimi K2.6(1,782 Elo)是该榜单上最高的开放权重条目。Featherless列出GLM-5.3为753B参数、DeepSeek-V4.1-Flash为763B,没有任何消费级机器能运行。
- 单张显卡能跑的。 Gemma 4 31B在同一基准上得到1407.6 Elo和16.01的评分标准分。不同追踪站的分数不在同一刻度上;请只在同一份榜单内比较。
- 什么时候选本地。 未发表的手稿、受保密协议约束的客户工作、云服务商会拒绝的内容、离线工作,以及受每月API账单限制的项目。
- 混合工作流。 在本地起草和头脑风暴;如果想要额外的质量,只把非敏感内容的最终润色交给云端模型。
创意写作的温度与Top-P
创意写作需要比编程更高的采样温度。 多数聊天界面的默认值是为问答调的;对创意提示词用温度0.7,会得到平淡、可预测的文字。
- 厂商默认值是下限,不是目标。 Google给Gemma 4的是温度1.0、top-p 0.95、top-k 64;阿里巴巴给Qwen3.8的thinking模式是1.0 / 0.95 / top-k 20,非thinking模式是0.7 / 0.8;Nous给Hermes 4.3的是0.6 / 0.95 / top-k 20。从这里出发,再针对散文调整。
- 散文基线: 温度0.95–1.0,top-p 0.92–0.95,重复惩罚1.05–1.1。再按任务调整。
- 紧凑对话: 温度0.7–0.85,top-p 0.9。较低的温度能让角色声音在来回对话中保持一致。
- 抒情散文与诗歌: 温度1.0–1.2,top-p 0.95。较高的温度会带来意想不到的用词。
- 超现实或类型小说: 温度1.1–1.3,top-p 0.95–0.98。
- 情节驱动的场景(动作、悬疑、反转): 温度0.85–0.95,top-p 0.9。这类场景更需要指令遵循而非新奇。
- 写小说时关闭thinking模式。 推理token会增加延迟,并常常产生计划好的、过于工整的文字。Qwen3.8接受
enable_thinking: false;在Ollama中用--think=false。 - min_p(0.05–0.1): top-p的替代方案,按最高概率token来缩放截断阈值。在创意提示词上更宽容,又不会像极高的top-p那样语无伦次。后端提供该设置时就用它。
- DRY重复惩罚(multiplier 0.8、base 1.75、allowed length 2): 能捕捉标准重复惩罚漏掉的短语级重复,对长会话有帮助。基于llama.cpp的后端(如KoboldCpp)提供该功能;请确认你的前端是否支持。
- 关于这些参数为何重要及其相互作用的更完整说明,请参阅温度与top-p控制。
💡提示: 为每个模型用一个短场景测试采样:每个设置跑三次,然后选模型听起来最生动、又没偏离提示词的温度。设置在模型之间无法完全迁移。
Uncensored模型:它们是什么,何时重要
Uncensored不等于不道德。 它指的是模型的拒绝行为经微调被降低,从而遵循提示词而不是推辞。作者仍然是你。
- 技术上。 Hermes 4.3和Dolphin 3.0这类模型是微调版本,其后训练减少了对成熟、暴力或道德复杂提示词的拒绝。Nous Research称拒绝大幅减少,并报告Hermes 4.3在其自有RefusalBench上回答了72–75%的提示。Ollama上也有较新模型的社区“abliterated”或“heretic”变体;其质量未经审核。
- 何时对创意工作重要。 成熟题材小说、含露骨暴力的犯罪小说、恐怖小说、有关战争或暴行的史实性写作,以及instruct模型不愿令人信服地演绎的道德复杂反派。
- 不足之处。 它们会遵循提示词,包括写得很差的提示词。instruct模型常把含糊的提示词软化成可出版的内容;低拒绝率模型则严格给你所要求的。
- 伦理与法律边界。 模型愿意写,并不等于可以写针对真实人物的内容、涉及可识别个人的非自愿情节,或在你所在地属违法的内容。本地部署不会改变法律,只改变谁能看到草稿。各国法律不同,这不是法律建议。
- 更深入的讨论 关于伦理、合法性和最佳实践,请参阅创意写作的Uncensored本地LLM:伦理、合法性与最佳实践。
📌注: Uncensored是工作流选择,不是身份标签。许多作者用instruct模型起草,只在特定场景切换到低拒绝率微调模型。同时安装两个模型是常见做法。
创意写作前端
你写作用的聊天界面和模型一样重要。 四个选项覆盖大多数工作流;按工作流形态选择。
- Open WebUI — 通用之选。类ChatGPT界面,一键切换模型,用系统提示词写角色笔记,可上传文档作为上下文。最适合以散文为主的起草。
- SillyTavern — 角色扮演与对话之选。角色卡、人设管理、用于世界观构建的lorebook,以及多角色场景的群聊。最适合以对话为主的工作和长期世界观项目。
- Agnai和RisuAI — 更轻量的SillyTavern替代品,上手更简单,可定制性较少。
- 纯Ollama命令行加文本编辑器 — 极简之选。
ollama run gemma4:31b,再把场景粘贴到草稿里。失去持续的角色上下文,但更能专注。 - 角色扮演类前端的横向对比,请参阅SillyTavern vs Agnai vs RisuAI:最佳本地角色扮演前端。
💡提示: 起草和修改需要不同的工具。在聊天前端生成,然后导出到纯文本编辑器修改。在聊天窗口里编辑,会让你养成让模型来修文字、而不是自己修改的习惯。
决策:哪个模型适合你的工作
先看内存,再看任务。
📍 简单一句话
24GB显卡选Gemma 4 31B或Qwen3.8-27B,12GB选Gemma 4 12B,16GB选Mistral Small 3 24B,48GB及以上选Llama 3.3 70B,instruct模型拒绝的场景用Hermes 4.3 36B。
💬 简单来说
从你的内存放得下、且留有上下文余量的最大模型开始。只有当某项任务(如长篇连贯性或成熟场景)成为瓶颈时,再换专门的模型。安装两个模型只多占磁盘空间。
你的情况 | 推荐 |
|---|---|
| 24GB显卡或32GB Mac,散文优先 | Gemma 4 31B |
| 24GB显卡,长篇小说项目 | Qwen3.8-27B(256K上下文) |
| 24GB显卡,想要更快输出 | Gemma 4 26B-A4B |
| 12GB显卡 | Gemma 4 12B |
| 16GB显卡 | Mistral Small 3 24B |
| 48GB及以上,一个模型包办 | Llama 3.3 70B + Hermes 4.3 36B |
| instruct模型拒绝我需要的场景 | Hermes 4.3 36B(同时保留instruct模型) |
| 先用一个,之后再调整 | Gemma 4 31B或Qwen3.8-27B,放得下哪个用哪个 |
💡提示: 多数作者对模型想得太多,对提示词想得太少。带角色笔记、声音样本和明确视角的系统提示词,比换模型更有用。请参阅角色提示。
为创意写作选择和使用本地模型的常见错误
- 错误1:按通用基准排名选择。 编程和推理排行榜与散文质量相关性很差。请看EQ-Bench这类创意写作榜单,再用自己的场景测试。
- 错误2:使用编程式采样。 温度0.2–0.4会让文字平淡。创意工作需要大约0.9–1.1。
- 错误3:一直开着thinking模式。 推理优先的模型会先规划再写作,可能让小说显得拼凑。写散文时关闭thinking。
- 错误4:忽略上下文内存。 19–20GB的31B模型,在扩大上下文窗口后几乎不给24GB显卡留空间。请为KV缓存预留2–6GB。
- 错误5:系统提示词太单薄。 “你是一个乐于助人的助手”是创意工作最糟糕的提示词。把角色笔记、视角和时态,与反向提示结合,排除陈词滥调。
- 错误6:在聊天窗口里编辑。 在聊天里生成,在编辑器里修改。让模型来修改的作者,很快就会失去自己的声音。
⚠️警告: 创意写作AI最大的能力风险,是把修改环节外包出去。生成是模型能帮上忙的机械工作;修改才让文字真正属于你。
来源
- Ollama库:Gemma 4 — 标签、下载大小和上下文窗口。
- Ollama库:Qwen3.8 — 标签、大小和能力。
- Hugging Face:Qwen3.8-27B模型卡 — 许可证、上下文长度、推荐采样。
- Hugging Face:Gemma 4 31B模型卡 — 许可证、上下文长度、采样默认值。
- Hugging Face:Hermes 4.3 36B — 基础模型、许可证、拒绝基准、GGUF量化。
- Ollama库:Mistral Small — Mistral Small 3 24B的大小、上下文和许可证。
- EQ-Bench Creative Writing和evals.report的EQ-Bench分数 — 上文引用的排行榜数据。
- Featherless:适合创意写作的最佳开放模型 — 开放权重模型的规模及Gemma 4 31B的EQ-Bench数据。
- SillyTavern文档 — 角色卡、人设、群聊。
常见问题
创意写作最好的本地LLM是哪个?
2026年最佳的本地起点是Gemma 4 31B和Qwen3.8-27B,两者都能放进24GB显卡(权重约18–20GB)。Gemma 4 31B是拥有自己公开EQ-Bench分数的散文之选;Qwen3.8-27B是长上下文之选。显卡更小时,用Gemma 4 12B(12GB)或Mistral Small 3 24B(16GB)。
创意写作最好的Ollama模型是哪个?
24GB显卡上,散文用ollama pull gemma4:31b,长篇项目用ollama pull qwen3.8:27b。12GB用gemma4:12b,16GB用mistral-small:24b,48GB及以上用llama3.3:70b。长场景请调高num_ctx,写小说时关闭thinking。
写小说和故事最好的本地LLM是哪个?
选你的内存放得下、且留有上下文余量的最大模型。24GB上散文选Gemma 4 31B,长篇规模的项目选256K上下文的Qwen3.8-27B,48GB及以上以Llama 3.3 70B为基准。温度用0.9–1.1,系统提示词中写明视角、时态和声音样本。
哪个本地模型最适合世界观构建?
最重要的是长上下文:Qwen3.8-27B和Gemma 4都提供256K token,足以在提示词里容纳设定集和章节摘要。把其中之一与SillyTavern的lorebook或固定的世界文档搭配,并把势力、规则和名称放进同一个参考块。
写长篇小说用哪个LLM最好?
本地方案:24GB显卡上用Qwen3.8-27B(256K上下文)或Gemma 4 31B(256K上下文)。瓶颈在结构而不是模型大小:大纲、角色设定集和章节摘要能保持连贯。闭源云端模型在创意基准上得分更高,但会把你的手稿发给第三方。
32GB显存或统一内存下最好的本地模型是哪个?
Gemma 4 31B(19–20GB)或Qwen3.8-27B(18GB),配合更大的上下文窗口;比24GB多出来的内存用于KV缓存。Gemma 4 26B-A4B是更快的替代。70B模型在48GB以下放不舒服。
什么是uncensored本地LLM,什么时候该用?
它是经微调的模型,后训练减少了对成熟或道德复杂提示词的拒绝,所以模型会遵循提示词而不是推辞。Hermes 4.3 36B是我们能确认的最新选项;Dolphin 3.0较老。用于成熟题材小说或史实性写作,其余情况保留instruct模型。
创意写作应该用什么温度?
散文用温度0.9–1.1,搭配top-p 0.92–0.95。紧凑对话用0.7–0.85,诗歌用1.0–1.2,超现实或类型作品用1.1–1.3。厂商默认值(如Gemma 4的1.0 / 0.95 / top-k 64)是不错的起点。写小说时关闭thinking模式。
本地创意写作模型和ChatGPT或Claude一样好吗?
在基准上不是。在EQ-Bench Creative Writing v3上,Claude Opus 4.7(2,206 Elo)等闭源模型领先,最好的开放权重条目需要数据中心级硬件。不过24GB的本地模型用来起草可能已经够好,而且手稿保持私密。校准后的采样和强力的系统提示词能弥补实际使用中的大部分差距。
本地模型能写完整本小说吗?
它可以帮助起草。像Qwen3.8-27B或Gemma 4这样256K上下文的模型,可以在内存中保留长大纲和多个章节,但KV缓存会随上下文增长,请检查显存。配合角色设定集和lorebook,按节起草;没有这些,任何模型都会跑偏。
uncensored模型会生成违法内容吗?
它们生成提示词所要求的文本;法律责任在作者和出版方,而不在模型。欧盟《AI法案》、德国《刑法典》第184条/第184c条以及各国淫秽法规,不论文本如何生成都适用。本地部署改变的是谁能看到草稿,而不是什么合法。这不是法律建议。
如何避免“shiver down their spine”这类陈词滥调?
在系统提示词中列出8–12个禁用短语(“do not write 'shiver,' 'tapestry,' 'delve,' or 'she felt'”)。把温度保持在0.85–1.0而不是1.2以上,并在后端支持时加DRY惩罚;普通的重复惩罚抓不到短语级的陈词滥调。人工修改是最后一道过滤。请参阅反向提示。