Conclusiones clave
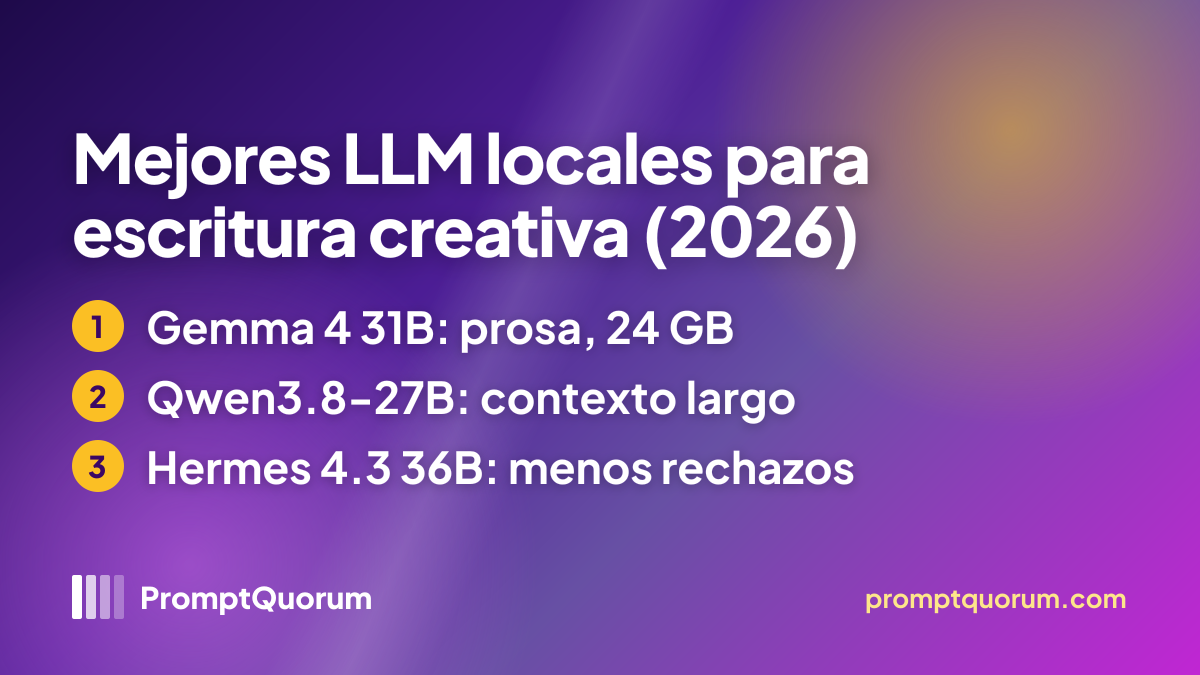
- Gemma 4 31B es la opción de prosa para una GPU de 24 GB. Unos 19–20 GB de pesos, contexto de 256K, Apache 2.0 y el único modelo de este conjunto con su propia puntuación publicada en EQ-Bench Creative Writing v3 (rúbrica 16,01, Elo 1407,6).
- Qwen3.8-27B es la opción para contexto largo y seguimiento de instrucciones. Unos 18 GB en Ollama, contexto de 256K, Apache 2.0. Aún no hay una puntuación creativa publicada, así que su calidad de prosa está sin verificar: pruébalo con tus propias escenas.
- Elige según tu VRAM, no según una clasificación. 12 GB: Gemma 4 12B. 16 GB: Mistral Small 3 24B. 24 GB: Gemma 4 31B o Qwen3.8-27B. 48 GB o más: Llama 3.3 70B.
- Hermes 4.3 36B es la opción con pocos rechazos. Apache 2.0, basado en ByteDance Seed-OSS-36B; Nous Research describe rechazos muy reducidos. Dolphin 3.0 es la alternativa más antigua.
- El muestreo importa más que cambiar de modelo. Temperatura 0,9–1,1 y top-p 0,92–0,95 para prosa; desactiva el modo thinking en ficción. Los ajustes de programación (0,2–0,4) producen prosa plana.
- Los modelos cloud cerrados siguen liderando los benchmarks creativos. El primero en EQ-Bench Creative Writing v3 es Claude Opus 4.7 con 2.206 Elo; la mejor entrada de pesos abiertos listada es Kimi K2.6 con 1.782, muy fuera del alcance del hardware doméstico. Lo local gana en privacidad, coste y control.
Datos rápidos
- GPU de 24 GB o Mac de 32 GB: Gemma 4 31B (
gemma4:31b, 19–20 GB) o Qwen3.8-27B (qwen3.8:27b, 18 GB). Ambos Apache 2.0, ambos con contexto de 256K. - GPU de 12 GB: Gemma 4 12B (
gemma4:12b, 7,7–8,0 GB), contexto de 256K. - GPU de 16 GB: Mistral Small 3 24B (
mistral-small:24b, 14 GB), contexto de 32K, Apache 2.0. Lanzado en 2025. - 48 GB o más: Llama 3.3 70B (
llama3.3:70b, unos 42 GB en Q4_K_M). Lanzado en diciembre de 2024; licencia comunitaria de Meta. - Ajustes con pocos rechazos: Hermes 4.3 36B (Apache 2.0) y Dolphin 3.0 (variante Mistral 24B, febrero de 2025).
- Base de muestreo para prosa: temperatura 1,0, top-p 0,95, min-p 0,05; añade penalización de repetición o DRY si las escenas entran en bucle.
- Regla de memoria: los tamaños de Ollama son solo pesos. Suma 2–6 GB para la caché KV en cuanto amplíes la ventana de contexto para escenas largas.
Cómo se eligieron estos modelos
Esta clasificación es una síntesis editorial de fuentes publicadas, no una nueva ronda de pruebas de PromptQuorum. Comparamos las fichas oficiales de los modelos, la biblioteca de Ollama (tamaños, contexto, etiquetas) y clasificaciones públicas de escritura creativa, y asignamos cada modelo a un nivel de hardware.
- Tamaños y contexto: leídos en las páginas de Ollama de Gemma 4, Qwen3.8, Mistral Small y en las fichas de Hugging Face. Solo pesos; la memoria de contexto es aparte.
- Puntuaciones creativas: EQ-Bench Creative Writing v3 y el Open Writing Leaderboard, tal como los reflejan rastreadores de terceros. Gemma 4 31B tiene puntuación propia; Qwen3.8-27B todavía no. Cuando una puntuación pertenece a un modelo hermano, lo indicamos.
- Fechas de lanzamiento: Qwen3.8-27B (agosto de 2026), Gemma 4 (julio de 2026), Mistral Small 3 (2025), Llama 3.3 70B (diciembre de 2024), Hermes 4.3 36B (diciembre de 2025), Dolphin 3.0 (febrero de 2025).
- Lo que no hicimos: no hemos ejecutado un nuevo conjunto de prompts puntuado con estos modelos. Los veredictos siguientes se basan en las fuentes citadas y las fichas; las etiquetas «ideal para» son recomendaciones, no resultados medidos.
- Para técnicas de prompting que mejoran la salida creativa en cualquier modelo, consulta control de temperatura y top-p y prompting con personas.
📌Nota: Los benchmarks de escritura creativa son subjetivos y las clasificaciones se contradicen entre sí. Trata cada recomendación como una hipótesis de partida: pasa las mismas tres escenas por dos candidatos y quédate con el modelo cuya voz prefieras.
Mejor modelo por nivel de VRAM
Elige primero por memoria: el modelo tiene que caber y dejar espacio para el contexto. Los tamaños son descargas de Ollama con la cuantización de 4 bits por defecto; suma 2–6 GB de caché KV en escenas largas.
Tu memoria | Modelo | Pesos | Contexto |
|---|---|---|---|
| GPU de 8 GB | Qwen3.5 9B (qwen3.5:9b) | 6,6–7,6 GB | 256K |
| GPU de 12 GB | Gemma 4 12B (gemma4:12b) | 7,7–8,0 GB | 256K |
| GPU de 16 GB | Mistral Small 3 24B (mistral-small:24b) | 14 GB | 32K |
| GPU 24 GB / Mac 32 GB | Gemma 4 31B (gemma4:31b) | 19–20 GB | 256K |
| GPU 24 GB / Mac 32 GB | Qwen3.8-27B (qwen3.8:27b) | 18 GB | 256K |
| GPU 24 GB, salida más rápida | Gemma 4 26B-A4B (gemma4:26b) | 16–19 GB | 256K |
| 48 GB o más | Llama 3.3 70B (llama3.3:70b) | ~42 GB | 128K |
💡Consejo: En un Mac de 32 GB, la memoria unificada se comparte con macOS. Cuenta con unos 24 GB utilizables para modelo y contexto, con lo que Gemma 4 31B y Qwen3.8-27B van con holgura.
Comparativa directa: modelos locales para escritura creativa
Ningún modelo gana en todas las tareas; elige según el nivel de hardware y lo que sostenga tu trabajo. La tabla recoge los modelos de esta guía con tamaño, pesos y fecha de lanzamiento.
📍 En una frase
Gemma 4 31B y Qwen3.8-27B son las mejores opciones locales para escritura creativa en una GPU de 24 GB; Gemma 4 12B, Mistral Small 3 24B y Llama 3.3 70B cubren los niveles de 12 GB, 16 GB y 48 GB; Hermes 4.3 36B es la opción con pocos rechazos.
💬 En términos simples
Elige el modelo más grande que quepa en tu memoria con espacio para el contexto. En una tarjeta de 24 GB, es Gemma 4 31B para prosa o Qwen3.8-27B para proyectos largos. Añade un ajuste con pocos rechazos solo si el modelo instruct se niega a escenas que necesitas escribir.
Modelo | Tamaño | Pesos (Ollama) | Lanzado | Ideal para |
|---|---|---|---|---|
| Gemma 4 31B | 31B denso | 19–20 GB | Jul 2026 | Prosa en 24 GB; puntuación EQ-Bench propia |
| Qwen3.8-27B | 27B denso | 18 GB | Ago 2026 | Proyectos largos, seguir instrucciones |
| Gemma 4 26B-A4B | 26B MoE, 4B activos | 16–19 GB | Jul 2026 | Generación más rápida en 24 GB |
| Gemma 4 12B | 12B | 7,7–8,0 GB | Jul 2026 | GPU de 12 GB, contexto largo |
| Mistral Small 3 24B | 24B denso | 14 GB | 2025 | GPU de 16 GB; antiguo pero probado |
| Llama 3.3 70B | 70B denso | ~42 GB | Dic 2024 | 48 GB o más; referencia antigua |
| Hermes 4.3 36B | 36B denso | ~21–23 GB (est.) | Dic 2025 | Menos rechazos, Apache 2.0 |
| Dolphin 3.0 | 24B (variante Mistral) | ~14 GB | Feb 2025 | Opción antigua con pocos rechazos |
💡Consejo: Lo habitual es un montaje de dos modelos: un modelo instruct como herramienta diaria, más Hermes 4.3 36B para las escenas que el instruct rechaza. Ambos conviven en ollama list.
Veredicto por modelo
- Gemma 4 31B — opción de prosa para 24 GB. Es el único modelo de este conjunto con resultado propio en EQ-Bench Creative Writing v3 (rúbrica 16,01, Elo 1407,6, según un rastreador de terceros). Contexto de 256K y Apache 2.0. Google indica temperatura 1,0, top-p 0,95, top-k 64 como valores por defecto.
- Qwen3.8-27B — opción para proyectos largos. 262.144 tokens de contexto nativo (ampliable a 1M con YaRN), Apache 2.0, unos 18 GB en Ollama. Alibaba lo plantea para programación, agentes e investigación; la ficha no dice nada de escritura creativa y no hay puntuación creativa publicada, así que verifica la voz con tus escenas. El modo thinking viene activado por defecto; desactívalo para prosa.
- Gemma 4 26B-A4B y 12B — misma familia, compromisos distintos. El modelo de mezcla de expertos de 26B activa unos 4B de parámetros por token, por lo que genera más rápido que el 31B con memoria similar. El 12B cabe en tarjetas de 12 GB y mantiene el contexto de 256K.
- Mistral Small 3 24B — la opción de 16 GB. Apache 2.0, unos 14 GB, contexto de 32K. Es un modelo de 2025 y, junto con Llama, la recomendación más antigua de aquí; sigue en la lista porque pocos modelos más nuevos caben en 16 GB. Su sucesor, Mistral Small 4 (marzo de 2026, Apache 2.0), es un modelo de mezcla de expertos de 119B con unos 6B de parámetros activos, muy por encima de 16 GB.
- Llama 3.3 70B — la referencia de 48 GB. Un modelo de diciembre de 2024 con la licencia comunitaria de Meta. En equipos de 48 GB o más sigue siendo una opción sólida y ampliamente compatible; por debajo de ese nivel no es práctico.
- Hermes 4.3 36B — opción con pocos rechazos. Basado en ByteDance Seed-OSS-36B con Apache 2.0, con cuantizaciones GGUF en Hugging Face. Nous Research describe rechazos muy reducidos; Hermes 4.3 respondió al 72–75 % de los prompts de su propio RefusalBench. Su ficha sugiere temperatura 0,6, top-p 0,95, top-k 20; sube la temperatura para prosa.
- Dolphin 3.0 — opción antigua con pocos rechazos. La generación más reciente de Dolphin que pudimos confirmar es Dolphin 3.0 (febrero de 2025, con una variante Mistral 24B). Úsalo si quieres un modelo sin censura de la familia Mistral; Hermes 4.3 es la opción más reciente.
📌Nota: La coherencia de voz es la métrica que los escritores más subestiman. Un modelo que escribe un párrafo brillante pero pierde el modo de hablar del personaje en el quinto es peor que uno estable. Prueba la continuidad en sesiones largas, no solo la calidad de una salida aislada.
Mejores modelos de Ollama para escritura creativa
Cinco comandos ollama pull cubren todos los niveles de hardware de esta guía. Después ejecuta ollama list para confirmar que el modelo está instalado.
- 24 GB, prosa:
ollama pull gemma4:31b— luegoollama run gemma4:31b. - 24 GB, proyectos largos:
ollama pull qwen3.8:27b— ejecútalo conollama run qwen3.8:27b --think=falsepara desactivar el thinking en prosa. - 12 GB:
ollama pull gemma4:12b. - 16 GB:
ollama pull mistral-small:24b. - 48 GB o más:
ollama pull llama3.3:70b. - Ajuste con pocos rechazos:
ollama run hf.co/NousResearch/Hermes-4.3-36B-GGUFdescarga el GGUF de Hermes 4.3 desde Hugging Face; en una tarjeta de 24 GB elige una cuantización de 4 bits. - Amplía la ventana de contexto para escenas largas. El contexto por defecto de Ollama es pequeño. En una sesión interactiva escribe
/set parameter num_ctx 16384o definenum_ctxen un Modelfile. Valores mayores usan más VRAM.
Modelos locales frente a modelos cloud para escribir
Los modelos cloud cerrados puntúan más alto en los benchmarks creativos; los modelos locales ganan en privacidad, coste y control. Quien busca «mejor LLM para escribir» sin «local» obtiene de las clasificaciones respuestas distintas a las de esta guía.
- Los modelos cerrados lideran. En EQ-Bench Creative Writing v3, reflejado por evals.report, Claude Opus 4.7 es primero con 2.206 Elo, por delante de GPT-5.5 con 2.035.
- Las mejores entradas de pesos abiertos necesitan un centro de datos. Kimi K2.6 (1.782 Elo) es la entrada de pesos abiertos más alta de esa lista. Featherless indica GLM-5.3 con 753B y DeepSeek-V4.1-Flash con 763B de parámetros, algo que ningún equipo doméstico ejecuta.
- Lo que corre en una GPU. Gemma 4 31B obtuvo 1407,6 Elo y una rúbrica de 16,01 en el mismo benchmark. Las puntuaciones de rastreadores distintos no comparten escala; compara solo dentro de una misma lista.
- Cuándo conviene lo local. Manuscritos inéditos, trabajo para clientes bajo NDA, contenido que un proveedor cloud rechazaría, trabajo sin conexión y proyectos en los que la factura mensual de API es la limitación.
- Flujo híbrido. Borradores y lluvia de ideas en local; un modelo cloud solo para el pulido final de contenido no sensible si quieres la calidad extra.
Temperatura y top-p para trabajo creativo
La escritura creativa pide temperaturas de muestreo más altas que la programación. Los valores por defecto de la mayoría de interfaces de chat están ajustados para preguntas y respuestas; una temperatura de 0,7 produce prosa plana y predecible con prompts creativos.
- Los valores de los fabricantes son un suelo, no un objetivo. Google indica para Gemma 4 temperatura 1,0, top-p 0,95, top-k 64; Alibaba, para Qwen3.8 en modo thinking, 1,0 / 0,95 / top-k 20 y, sin thinking, 0,7 / 0,8; Nous, para Hermes 4.3, 0,6 / 0,95 / top-k 20. Empieza ahí y ajusta para prosa.
- Base para prosa: temperatura 0,95–1,0, top-p 0,92–0,95, penalización de repetición 1,05–1,1. Ajusta por tarea desde aquí.
- Diálogo ajustado: temperatura 0,7–0,85, top-p 0,9. Las temperaturas más bajas mantienen coherentes las voces de los personajes entre intercambios.
- Prosa lírica y poesía: temperatura 1,0–1,2, top-p 0,95. Las temperaturas más altas abren elecciones de palabras inesperadas.
- Ficción surrealista o de género: temperatura 1,1–1,3, top-p 0,95–0,98.
- Escenas guiadas por la trama (acción, misterio, giros): temperatura 0,85–0,95, top-p 0,9. Piden más seguimiento de instrucciones que novedad.
- Desactiva el modo thinking en ficción. Los tokens de razonamiento añaden latencia y suelen producir prosa planificada y pulcra. Qwen3.8 acepta
enable_thinking: false; en Ollama usa--think=false. - min_p (0,05–0,1): una alternativa a top-p que escala el umbral según la probabilidad del token principal. Es más permisivo con prompts creativos sin la incoherencia de un top-p muy alto. Úsalo donde tu backend exponga el ajuste.
- Penalización de repetición DRY (multiplicador 0,8, base 1,75, longitud permitida 2): detecta repeticiones a nivel de frase que una penalización de repetición estándar pasa por alto, lo que ayuda en sesiones largas. Está disponible en backends basados en llama.cpp como KoboldCpp; comprueba si tu interfaz lo ofrece.
- Para una explicación más completa de por qué importan estos parámetros y cómo interactúan, consulta control de temperatura y top-p.
💡Consejo: Prueba el muestreo con una escena corta por modelo: tres ejecuciones por ajuste y elige la temperatura en la que el modelo suena más vivo sin perder el prompt. Los ajustes no se transfieren a la perfección entre modelos.
Modelos uncensored: qué son y cuándo importan
Uncensored no significa poco ético. Significa que el comportamiento de rechazo del modelo se ha reducido mediante ajuste fino, de modo que sigue el prompt en lugar de negarse. El autor sigue siendo el escritor.
- Técnicamente. Modelos como Hermes 4.3 y Dolphin 3.0 son ajustes finos cuyo posentrenamiento reduce los rechazos ante prompts maduros, violentos o moralmente complejos. Nous Research describe rechazos muy reducidos e informa de que Hermes 4.3 respondió al 72–75 % de los prompts de su propio RefusalBench. También existen en Ollama variantes comunitarias «abliterated» o «heretic» de modelos más nuevos; su calidad no está auditada.
- Cuándo importan en el trabajo creativo. Ficción madura, novela negra con violencia explícita, terror, escritura históricamente fiel sobre guerra o atrocidades y antagonistas moralmente complejos que el modelo instruct no interpreta de forma convincente.
- Dónde se quedan cortos. Siguen el prompt, también cuando está mal escrito. Los modelos instruct suelen suavizar un prompt vago hasta algo publicable; los de pocos rechazos te dan exactamente lo que pediste.
- Límites éticos y legales. Que un modelo lo escriba no es una licencia para generar contenido dirigido a personas reales, que represente escenarios sin consentimiento con personas identificables o que sea ilegal donde vives. Alojar en local no cambia la ley; cambia quién puede ver el borrador. Las leyes varían según el país y esto no es asesoramiento jurídico.
- Para profundizar en ética, legalidad y buenas prácticas, consulta LLM locales uncensored para escritura creativa: ética, legalidad y buenas prácticas.
📌Nota: Uncensored es una decisión de flujo de trabajo, no una identidad. Muchos escritores redactan con el modelo instruct y cambian a un ajuste con pocos rechazos solo para ciertas escenas. Tener dos modelos instalados a la vez es lo habitual.
Interfaces para trabajo creativo
La interfaz de chat en la que escribes importa tanto como el modelo. Cuatro opciones cubren la mayoría de los flujos de trabajo; elige según su forma.
- Open WebUI — la opción generalista. Interfaz tipo ChatGPT, cambio de modelo con un clic, notas de personaje en el prompt de sistema y carga de documentos como contexto. Ideal para redactar con mucha prosa.
- SillyTavern — la opción para rol y diálogo. Tarjetas de personaje, gestión de personas, lorebooks para worldbuilding y chat de grupo para escenas con varios personajes. Ideal para trabajo basado en diálogo y proyectos de mundo de larga duración.
- Agnai y RisuAI — alternativas más ligeras a SillyTavern, con un primer uso más sencillo y menos personalización.
- CLI de Ollama más un editor de texto — la opción mínima.
ollama run gemma4:31by pega las escenas en tu borrador. Pierdes el contexto persistente de personajes, pero ganas concentración. - Para la comparativa directa de las interfaces orientadas al rol, consulta SillyTavern vs Agnai vs RisuAI: mejor interfaz local de rol.
💡Consejo: Redactar y editar piden herramientas distintas. Genera en la interfaz de chat y luego exporta a un editor de texto plano para revisar. Editar dentro de la ventana de chat te acostumbra a pedirle al modelo que arregle la prosa en vez de revisarla tú.
Decisión: qué modelo para tu trabajo
Primero tu memoria, luego tu tarea.
📍 En una frase
Elige Gemma 4 31B o Qwen3.8-27B en una GPU de 24 GB, Gemma 4 12B con 12 GB, Mistral Small 3 24B con 16 GB, Llama 3.3 70B con 48 GB o más y Hermes 4.3 36B para las escenas que los modelos instruct rechazan.
💬 En términos simples
Empieza con el modelo más grande que quepa en tu memoria con espacio para el contexto. Cambia a un especialista solo cuando una tarea, como la continuidad de largo aliento o las escenas maduras, se convierta en el cuello de botella. Dos instalaciones solo cuestan espacio en disco.
Tu situación | Elección |
|---|---|
| GPU de 24 GB o Mac de 32 GB, prosa primero | Gemma 4 31B |
| GPU de 24 GB, proyecto de longitud de novela | Qwen3.8-27B (contexto de 256K) |
| GPU de 24 GB, quiero salida más rápida | Gemma 4 26B-A4B |
| GPU de 12 GB | Gemma 4 12B |
| GPU de 16 GB | Mistral Small 3 24B |
| 48 GB o más, un modelo para todo | Llama 3.3 70B + Hermes 4.3 36B |
| El modelo instruct rechaza escenas que necesito | Hermes 4.3 36B (conserva un instruct) |
| Quiero uno para empezar y ajustar después | Gemma 4 31B o Qwen3.8-27B, el que quepa |
💡Consejo: La mayoría de los escritores piensan demasiado en el modelo y muy poco en el prompt. Un prompt de sistema con notas de personaje, muestras de voz y punto de vista explícito rinde más que cambiar de modelo. Consulta prompting con personas.
Errores comunes al elegir y usar modelos locales para escritura creativa
- Error 1: elegir por el ranking general de benchmarks. Las clasificaciones de programación y razonamiento se correlacionan mal con la calidad de la prosa. Mira clasificaciones creativas como EQ-Bench y luego prueba con tus propias escenas.
- Error 2: usar un muestreo de programación. Una temperatura de 0,2–0,4 produce prosa plana. El trabajo creativo pide aproximadamente 0,9–1,1.
- Error 3: dejar el modo thinking activado. Los modelos de razonamiento planifican antes de escribir, y la ficción puede resultar armada. Desactiva el thinking para la prosa.
- Error 4: ignorar la memoria de contexto. Un modelo de 31B con 19–20 GB deja poco margen en una tarjeta de 24 GB cuando amplías la ventana de contexto. Reserva 2–6 GB para la caché KV.
- Error 5: prompts de sistema escasos. «Eres un asistente útil» es el peor prompt para trabajo creativo. Combina notas de personaje, punto de vista y tiempo verbal con prompting negativo para descartar clichés.
- Error 6: editar dentro de la ventana de chat. Genera en el chat; revisa en un editor. Los escritores que dejan que el modelo revise pierden pronto su voz.
⚠️Advertencia: El mayor riesgo para tus habilidades con la IA de escritura creativa es externalizar la revisión. Generar es trabajo mecánico que se beneficia de un modelo; revisar es lo que hace que la prosa sea tuya.
Fuentes
- Biblioteca de Ollama: Gemma 4 — etiquetas, tamaños de descarga y ventanas de contexto.
- Biblioteca de Ollama: Qwen3.8 — etiqueta, tamaño y capacidades.
- Hugging Face: ficha del modelo Qwen3.8-27B — licencia, longitud de contexto, muestreo recomendado.
- Hugging Face: ficha del modelo Gemma 4 31B — licencia, longitud de contexto, valores de muestreo por defecto.
- Hugging Face: Hermes 4.3 36B — modelo base, licencia, benchmark de rechazos, cuantizaciones GGUF.
- Biblioteca de Ollama: Mistral Small — tamaño, contexto y licencia de Mistral Small 3 24B.
- EQ-Bench Creative Writing y puntuaciones EQ-Bench de evals.report — cifras de clasificaciones citadas arriba.
- Featherless: mejores modelos abiertos para escritura creativa — tamaños de pesos abiertos y cifras EQ-Bench de Gemma 4 31B.
- Documentación de SillyTavern — tarjetas de personaje, personas, chat de grupo.
Preguntas frecuentes
¿Cuál es el mejor LLM local para escritura creativa?
Gemma 4 31B y Qwen3.8-27B son los mejores puntos de partida locales en 2026, y ambos caben en una GPU de 24 GB (unos 18–20 GB de pesos). Gemma 4 31B es la opción de prosa con puntuación EQ-Bench propia publicada; Qwen3.8-27B es la opción de contexto largo. En tarjetas más pequeñas usa Gemma 4 12B (12 GB) o Mistral Small 3 24B (16 GB).
¿Cuál es el mejor modelo de Ollama para escritura creativa?
En una GPU de 24 GB, ollama pull gemma4:31b para prosa o ollama pull qwen3.8:27b para proyectos largos. Con 12 GB, gemma4:12b; con 16 GB, mistral-small:24b; con 48 GB o más, llama3.3:70b. Sube num_ctx para escenas largas y desactiva el thinking en ficción.
¿Cuál es el mejor LLM local para escribir ficción e historias?
Elige el modelo más grande que quepa en tu memoria con espacio para el contexto. Gemma 4 31B es la opción de prosa en 24 GB, Qwen3.8-27B encaja con proyectos de longitud de novela gracias a su contexto de 256K y Llama 3.3 70B es la referencia con 48 GB o más. Usa temperatura 0,9–1,1 y un prompt de sistema con punto de vista, tiempo verbal y muestras de voz.
¿Qué modelo local es mejor para worldbuilding?
Lo que más importa es el contexto largo: Qwen3.8-27B y Gemma 4 ofrecen 256K tokens, suficiente para mantener una biblia de lore y resúmenes de capítulos en el prompt. Combina cualquiera con lorebooks de SillyTavern o un documento de mundo fijado, y reúne facciones, reglas y nombres en un único bloque de referencia.
¿Qué LLM es mejor para escribir una novela?
En local: Qwen3.8-27B (contexto de 256K) o Gemma 4 31B (contexto de 256K) en una GPU de 24 GB. El cuello de botella es la estructura, no el tamaño del modelo: un esquema, una biblia de personajes y resúmenes de capítulos mantienen la continuidad. Los modelos cloud cerrados puntúan más alto en benchmarks creativos, pero envían tu manuscrito a un tercero.
¿Cuál es el mejor modelo local con 32 GB de VRAM o memoria unificada?
Gemma 4 31B (19–20 GB) o Qwen3.8-27B (18 GB) con una ventana de contexto mayor; la memoria extra sobre 24 GB paga la caché KV. Gemma 4 26B-A4B es la alternativa más rápida. Un modelo de 70B no cabe con comodidad por debajo de 48 GB.
¿Qué es un LLM local uncensored y cuándo debería usar uno?
Es un ajuste fino cuyo posentrenamiento reduce los rechazos ante prompts maduros o moralmente complejos, de modo que el modelo sigue el prompt en lugar de negarse. Hermes 4.3 36B es la opción más reciente que pudimos confirmar; Dolphin 3.0 es más antiguo. Úsalo para ficción madura o escritura históricamente fiel, y conserva un modelo instruct para el resto.
¿Qué temperatura debo usar para escritura creativa?
Temperatura 0,9–1,1 con top-p 0,92–0,95 para prosa. El diálogo ajustado pide 0,7–0,85; la poesía, 1,0–1,2; el trabajo surrealista o de género, 1,1–1,3. Los valores de los fabricantes, como el 1,0 / 0,95 / top-k 64 de Gemma 4, son un buen punto de partida. Desactiva el modo thinking en ficción.
¿Son los modelos locales de escritura creativa tan buenos como ChatGPT o Claude?
No en los benchmarks. En EQ-Bench Creative Writing v3 lideran modelos cerrados como Claude Opus 4.7 (2.206 Elo), y las mejores entradas de pesos abiertos necesitan hardware de centro de datos. Un modelo local de 24 GB puede ser suficiente para redactar y mantiene los manuscritos privados. Un muestreo calibrado y un buen prompt de sistema cierran buena parte de la brecha práctica.
¿Puede un modelo local escribir una novela completa?
Puede ayudar a redactarla. Un modelo de contexto de 256K como Qwen3.8-27B o Gemma 4 puede mantener en memoria un esquema largo y varios capítulos, pero la caché KV crece con el contexto, así que revisa la VRAM. Redacta sección a sección con una biblia de personajes y un lorebook; sin ellos, cualquier modelo se desvía.
¿Los modelos uncensored producen contenido ilegal?
Producen el texto que pide el prompt; la responsabilidad legal recae en el escritor y la publicación, no en el modelo. Marcos como el AI Act de la UE, el § 184/§ 184c del StGB alemán y la normativa nacional sobre obscenidad se aplican con independencia de cómo se generó el texto. Alojar en local cambia quién ve el borrador, no lo que es legal. Esto no es asesoramiento jurídico.
¿Cómo evito el cliché «shiver down their spine»?
Enumera 8–12 frases prohibidas en el prompt de sistema («do not write 'shiver,' 'tapestry,' 'delve,' or 'she felt'»). Mantén la temperatura en 0,85–1,0 en lugar de 1,2 o más y añade una penalización DRY donde tu backend la admita; una penalización de repetición simple no detecta clichés a nivel de frase. Una revisión manual es el filtro final. Consulta prompting negativo.