¿Qué son la temperatura y el top-p?
📍 In One Sentence
La temperatura controla la nitidez de la distribución de probabilidad del modelo — valores bajos producen salidas deterministas, valores altos aumentan la aleatoriedad — mientras que el top-p limita el muestreo al conjunto más pequeño de tokens cuyas probabilidades suman p.
💬 In Plain Terms
La temperatura es el mando de creatividad. Bájalo a 0 para respuestas consistentes y predecibles; súbelo para respuestas sorprendentes. El top-p es otra palanca sobre la misma idea: en vez de aplanar las probabilidades, simplemente se niega a considerar la cola de palabras improbables.
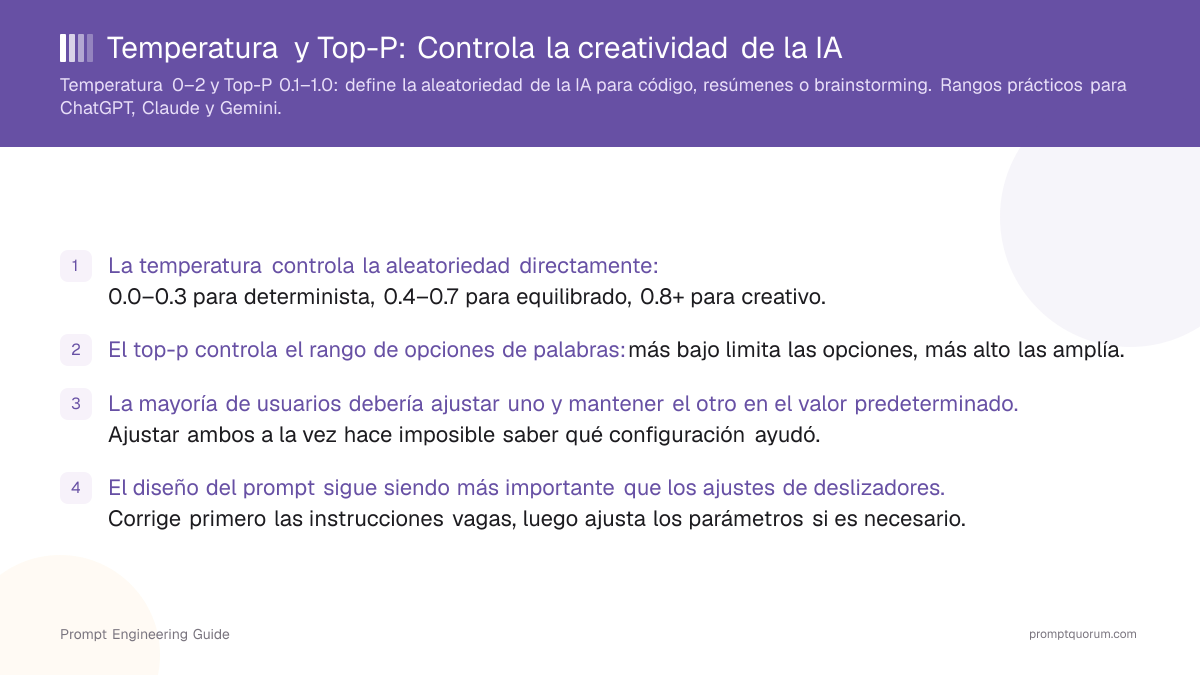
La temperatura es un dial que hace que el output del modelo sea más aleatorio (más alto) o más determinista (más bajo). A temperatura 0.0, el modelo siempre elige la siguiente palabra más probable, por lo que las ejecuciones repetidas son casi idénticas, aunque la variación de coma flotante y de hardware todavía puede cambiar algún token. A temperatura 1.0+, el modelo considera alternativas más arriesgadas, produciendo texto sorprendente y variado.
Top-p (nucleus sampling) controla cuántas opciones de palabras probables considera el modelo en cada paso. En lugar de "qué tan aleatorio", piénsalo como "cuántas opciones plausibles". Con top-p 0.1, el modelo solo considera las opciones más altas hasta que alcanzan el 10% de probabilidad acumulada — estrecho y seguro. Con top-p 0.9, considera un conjunto de palabras posibles mucho más amplio — más libre y variado.
En términos simples: la temperatura controla "qué tan aventurero", y el top-p controla "cuántas opciones a considerar". Ambos afectan la variedad del output, pero de formas diferentes.
🔍 Funciona con modelos locales
Los ajustes de temperatura y top-p están disponibles en todas las herramientas LLM locales. Los mismos parámetros, el mismo efecto.
Estructura del prompt + Configuraciones de temperatura
Prompt malo "Escribe algo creativo sobre el otoño."
Prompt bueno "Escribe una descripción metafórica de 100 palabras del otoño como si fueras un poeta. Temperatura: 0.9, top-p: 0.95."
Notación matemática
Rango de temperatura: T ∈ 0.0, 2.0
Softmax con temperatura: softmax(logit_i / T) = exp(logit_i / T) / Σ(exp(logit_j / T))
Muestreo top-p: Σ P(token_i) hasta ≥ p, luego muestrea de ese conjunto
Cómo cambian el comportamiento de la IA
Efectos de la temperatura:
Rango de temperatura | Comportamiento | Ideal para |
|---|---|---|
| Bajo (0.0–0.3) | Enfocado, repetitivo, muy estable | Tareas que requieren la misma respuesta cada vez; riesgo de bucles |
| Medio (0.4–0.7) | Estabilidad y variación equilibradas | La mayoría de tareas generales; punto de partida recomendado |
| Alto (0.8–1.0+) | Creativo, diverso, sorprendente | Brainstorming y variaciones; riesgo de alucinaciones |
Efectos del top-p: Bajo (0.1–0.3) crea conjuntos de opciones muy estrechos y outputs muy conservadores. Medio (0.5–0.7) equilibra diversidad con estabilidad. Alto (0.8–1.0) amplía el conjunto de opciones y fomenta la creatividad, similar a la temperatura alta. Importante: Muchos proveedores vinculan o limitan estos ajustes. Los modelos GPT de OpenAI a menudo ignoran el top-p si la temperatura está explícitamente establecida. En los modelos actuales de Anthropic, en cambio, ambos parámetros están bloqueados en sus valores predeterminados (ver más abajo). Siempre revisa la documentación de tu proveedor — los mismos números no significan lo mismo en todos los modelos.
No todos los modelos siguen aceptando un valor de temperatura
📍 In One Sentence
Varios modelos de frontera ya rechazan con un error cualquier temperatura o top-p distinto del predeterminado, así que comprueba primero si el parámetro sigue existiendo.
💬 In Plain Terms
En algunos de los modelos más nuevos los deslizadores han desaparecido. Si tu petición falla, el ajuste fue rechazado, no ignorado.
Cada vez más modelos de frontera no aceptan ningún valor de temperatura o top-p: devuelven un error en lugar de una salida ajustada. Los modelos en modo razonamiento construyen su respuesta en varias rondas internas de borrador y verificación, y los proveedores bloquean los parámetros de muestreo para que ese proceso siga calibrado. Comprueba si el control existe en el modelo que vas a llamar antes de dedicar tiempo a ajustarlo.
Anthropic: en Claude Opus 5, Claude Sonnet 5 y Claude Fable 5.1 (y en Claude Opus 4.7 y 4.8), un valor de temperature, top_p o top_k distinto del predeterminado devuelve un error 400 en cada petición, no solo con el razonamiento activado. En los modelos Claude anteriores la restricción se aplica solo mientras el razonamiento está activo, donde top_p se acepta entre 0.95 y 1.0.
OpenAI: la familia GPT-5 en modo razonamiento rechaza los valores no predeterminados con "Unsupported value: temperature does not support 0.2 with this model. Only the default (1) value is supported." Los endpoints sin razonamiento siguen aceptando todo el rango 0–2.
Google: Gemini sigue exponiendo temperature y topP a través de generationConfig, así que los rangos de esta guía se aplican directamente a los modelos Gemini.
Modelos locales: Ollama, LM Studio y llama.cpp exponen ambos parámetros en todos los modelos, sin bloqueo del proveedor. Si quieres notar la diferencia entre 0.2 y 0.9 con el mismo prompt, un modelo local es el sitio más barato para probarlo.
Cuando los parámetros están bloqueados, diriges con el prompt: pide una única respuesta canónica en un formato de salida exacto donde habrías bajado la temperatura, y pide explícitamente varias alternativas claramente distintas donde la habrías subido. Si el proveedor ofrece un control de esfuerzo de razonamiento, ese es el ajuste que ha sustituido a la temperatura.
⚠️ Un rechazo no es un efecto nulo
Es fácil leer una petición rechazada como "el ajuste no hizo nada". Un error 400 significa que el parámetro fue rechazado, así que la ejecución nunca llegó a producirse con tu valor.
Temperatura vs Top-P: ¿Necesitas ambos?
Ambos ajustes controlan la aleatoriedad, pero la mayoría de usuarios debería ajustar solo uno y mantener el otro en un valor predeterminado razonable. Cambiar ambos a la vez hace imposible saber qué ajuste produjo el efecto que quieres. Por experiencia tras ajustar miles de prompts: mantén el top-p en un valor predeterminado (p. ej., 0.9–1.0) y solo ajusta la temperatura, a menos que un modelo específico recomiende otra cosa.
Estrategia | Temperatura | Top-P | Cuándo usar |
|---|---|---|---|
| Modo determinista | 0.0–0.2 | 1.0 (predeterminado) | Código, extracción de datos, output de misión crítica |
| Predeterminado equilibrado | 0.5–0.7 | 0.9–1.0 | La mayoría de tareas generales, resúmenes, explicaciones |
| Creativo/brainstorming | 0.8–1.0 | 0.9–1.0 | Ideación, copy de marketing, variaciones, storytelling |
| Producción de alta estabilidad | 0.0–0.3 | 0.95 | Salud, finanzas, legal, crítico para la seguridad |
Configuraciones recomendadas por caso de uso
- Codificación, refactoring, corrección de errores: Temperatura 0.1–0.3, Top-P 0.95. La sintaxis debe ser correcta, la creatividad distrae. Las configuraciones más bajas evitan nombres de funciones alucinados o defectos lógicos.
- Resúmenes y explicaciones: Temperatura 0.4–0.6, Top-P 0.9. Quieres claridad y consistencia, pero algo de variación en la formulación está bien. La temperatura baja puede hacer los resúmenes mecánicos.
- Brainstorming, copy de marketing, variaciones creativas: Temperatura 0.7–1.0, Top-P 1.0. Las configuraciones más altas fomentan combinaciones inesperadas y formulaciones novedosas. Necesitas filtrar más outputs, pero obtienes ideas más originales.
- Extracción de datos y output estructurado: Temperatura 0.0–0.2, Top-P 0.95. El formato debe ser exacto. La mayor aleatoriedad invita a errores de parsing y campos faltantes.
- Escritura de texto largo (ensayos, posts de blog): Temperatura 0.6–0.8, Top-P 0.9–1.0. Empieza aquí y ajusta según el feedback. Si el output parece genérico, sube la temperatura; si divaga o alucina, bájala.
- Preguntas y respuestas factuales (sin grounding): Temperatura 0.3–0.5, Top-P 0.9. Las configuraciones moderadas reducen las alucinaciones y mantienen las respuestas naturales.
Cómo los prompts y los parámetros trabajan juntos
El diseño del prompt sigue siendo más importante que los ajustes de deslizadores. Una instrucción imprecisa a temperatura 0.2 todavía produce una respuesta deficiente — solo una respuesta deficiente consistente. Un prompt claro y bien estructurado a cualquier temperatura produce mejores resultados que un prompt deficiente con configuraciones perfectas.
El flujo de trabajo correcto es: (1) Crea el prompt con una tarea clara, contexto, restricciones y formato de output. (2) Prueba a tu temperatura/top-p objetivo. (3) Ajusta los diales solo cuando necesites más o menos variación después de tener un prompt sólido.
El mismo prompt a diferentes temperaturas produce estilos muy diferentes. A temperatura 0.2, los outputs son seguros y directos. A temperatura 0.8, los outputs son creativos y poéticos. Ninguno es "mejor" — depende de la voz de tu marca y tu caso de uso.
Prompt de ejemplo
Escribe un eslogan de producto corto y conciso para una app de productividad. Mantenlo por debajo de 10 palabras.
A temperatura 0.2:
"Haz más en menos tiempo."
A temperatura 0.8:
"Del caos a la claridad: donde los momentos se convierten en impulso."
Cuándo la mayor creatividad se vuelve arriesgada
Los valores más altos de temperatura y top-p aumentan las alucinaciones, las tangentes fuera del tema y la deriva de estilo — especialmente en tareas factuales. Sé conservador (temp 0.0–0.5) para: código que va a producción (las APIs alucinadas rompen sistemas), consejos médicos (la información incorrecta daña), finanzas y legal (la precisión es obligatoria) y decisiones críticas para la seguridad (los errores tienen consecuencias).
Para tareas fundamentadas en hechos, considera combinar temperatura baja con RAG o restricciones de fuente explícitas para reducir aún más los errores.
Cómo PromptQuorum te ayuda a ajustar temperatura y top-p
Normalmente, probar configuraciones de temperatura y top-p significa ejecutar el mismo prompt muchas veces en varios modelos, registrando y comparando outputs manualmente — tedioso y difícil de rastrear. PromptQuorum optimiza este flujo de trabajo.
Comparaciones multi-modelo: Envía un prompt con diferentes configuraciones de temperatura/top-p a los más de 25 modelos que los aceptan (Gemini 3.1 Pro, los endpoints sin razonamiento de GPT-5.6, Mistral, modelos Ollama locales) en un solo envío. Ve inmediatamente qué modelo permanece estable a mayor temperatura y cuál produce el mejor output creativo en tu configuración objetivo.
Consenso y puntuación: Visualiza todos los outputs lado a lado con análisis Quorum que evalúa el riesgo de alucinación, la consistencia de estilo y la relevancia. Elige la combinación de modelo + configuración que mejor se adapte al equilibrio creatividad-fiabilidad de tu tarea.
Recetas de inicio rápido
Úsalas como puntos de partida para tu tarea:
- Modo factual seguro: Temperatura 0.2, Top-P 0.95 | Ideal para Q&A, resúmenes, extracción de datos, tareas basadas en hechos | Output: Fiable, consistente, mínima alucinación
- Modo equilibrado predeterminado: Temperatura 0.5, Top-P 0.9 | Ideal para la mayoría de tareas generales, explicaciones, escritura general | Output: Natural, estable, pero con algo de variación
- Modo creativo de brainstorming: Temperatura 0.8, Top-P 1.0 | Ideal para ideación, copy de marketing, storytelling, variaciones | Output: Diverso, sorprendente, muchas opciones para filtrar
- Modo de respuesta breve: Temperatura 0.3, Top-P 0.95 | Ideal para respuestas directas, decisiones rápidas, outputs concisos | Output: Rápido, directo, mínima elaboración
- Modo experimental: Temperatura 1.0, Top-P 1.0 | Ideal para explorar el comportamiento del modelo, entender límites, investigación | Output: Impredecible, máxima variación
Errores comunes con temperatura y top-p
- Girar ambos al máximo y esperar fiabilidad. Temperatura alta + top-p alto = máxima aleatoriedad. Solo haz esto si estás haciendo brainstorming o experimentando.
- Cambiar ambos diales al mismo tiempo. No sabrás qué ajuste ayudó o dañó. Cambia uno, observa, luego cambia el otro si es necesario.
- Intentar arreglar un prompt deficiente con deslizadores. Una instrucción imprecisa a cualquier temperatura todavía produce outputs deficientes. Arregla primero el prompt.
- Dar por hecho que todos los modelos siguen teniendo un control de temperatura. Los modelos Claude actuales de Anthropic y los de razonamiento de OpenAI rechazan de plano los valores no predeterminados, y entre los que sí los aceptan el mismo número significa cosas distintas: temperatura 0.7 en Gemini 3.1 Pro no se siente como 0.7 en una compilación local de Llama. Prueba el modelo exacto que vas a llamar.
- No probar suficientes ejecuciones. Un output a temperatura 0.5 podría ser un valor atípico. Ejecuta al menos 3–5 veces para ver el comportamiento típico.
- Poner temperatura en 0 y esperar precisión perfecta. La temperatura baja reduce la aleatoriedad, pero no elimina las alucinaciones. Las alucinaciones provienen de lagunas en los datos de entrenamiento, no del muestreo aleatorio.
- Ignorar por completo que tu proveedor puede ignorar el top-p. Algunos modelos lo hacen; otros no. Revisa la documentación para evitar desperdiciar tiempo ajustando un dial deshabilitado.
Cómo configurar temperatura y top-p para tu tarea
- 1Empieza por el prompt, no por los parámetros: Escribe y refina tus instrucciones hasta que sean claras. Los parámetros no pueden arreglar un prompt vago — solo afectan la distribución de muestreo, no la comprensión de la tarea por parte del modelo.
- 2Identifica el tipo de tarea: Tareas factuales o analíticas (análisis legal, revisión de código, extracción de datos) → establece temperatura 0.0–0.3. Tareas creativas o generativas (brainstorming, copy publicitario, ideas para historias) → establece temperatura 0.7–1.0.
- 3Deja top-p en su valor predeterminado (0.9–1.0): Ajusta top-p solo si tienes una razón específica. Cambiar temperatura y top-p simultáneamente dificulta diagnosticar qué ajuste modificó el output.
- 4Ejecuta 3–5 prompts de prueba con tu temperatura objetivo: Evalúa la consistencia del output. Si los outputs varían demasiado en una tarea factual, baja la temperatura. Si los outputs se sienten repetitivos en una tarea creativa, sube la temperatura.
- 5Documenta tus ajustes calibrados por caso de uso: Una vez que encuentres la temperatura correcta para un flujo de trabajo específico, regístrala en tu plantilla de prompt de sistema para que se aplique de forma consistente en todas las sesiones.
¿Debo ajustar primero la temperatura o el top-p?
La temperatura. Tiene un efecto más obvio. Mantén el top-p en un valor predeterminado (0.9–1.0) hasta que tengas una idea de lo que la temperatura hace para tu tarea, luego ajusta el top-p solo si es necesario.
¿Por qué un modelo ignora mi configuración de temperatura?
Normalmente no la ignora: la rechaza. Los modelos Claude actuales de Anthropic y los modelos de razonamiento de OpenAI devuelven un error 400 cuando la temperatura o el top-p difieren del valor predeterminado, y algunas configuraciones antiguas limitan en silencio un parámetro cuando el otro se establece de forma explícita. Revisa la documentación de tu proveedor y lee una petición fallida como un rechazo, no como un ajuste sin efecto.
¿Puedo establecer la temperatura en 0 para garantizar la corrección?
No. Temperatura 0.0 significa "elegir siempre la palabra más probable", lo que es casi determinista pero no siempre correcto. Las alucinaciones tratan de lagunas en los datos de entrenamiento y claridad de la tarea, no del muestreo aleatorio. Combina temperatura baja con prompts claros y grounding para mejor fiabilidad.
¿Por qué sigo viendo alucinaciones con temperatura baja?
Las alucinaciones ocurren cuando los datos de entrenamiento del modelo tienen lagunas o la tarea es ambigua — no solo por el muestreo aleatorio. Una configuración de temperatura baja será consistente en sus alucinaciones, pero no las eliminará. Usa RAG o restricciones de fuente explícitas para reducirlas.
¿Difieren las configuraciones recomendadas entre GPT-5.6, Claude Opus 5 y Gemini 3.1 Pro?
Más que ligeramente: uno de ellos ya no admite el ajuste. Claude Opus 5 (igual que Claude Sonnet 5 y Claude Fable 5.1) rechaza de plano cualquier temperatura o top-p distinto del predeterminado. Gemini 3.1 Pro sigue exponiendo ambos mediante generationConfig y se comporta bien entre 0.5 y 0.7. GPT-5.6 acepta todo el rango en sus endpoints sin razonamiento, pero rechaza valores no predeterminados en modo razonamiento. Prueba el modelo y el modo exactos que vas a llamar.
¿Cuántas ejecuciones necesito para comparar configuraciones de forma justa?
Al menos 3–5 por configuración para ver el comportamiento típico. Más si trabajas con temperaturas más altas donde la varianza del output es alta.
¿Qué hago si mi modelo rechaza el parámetro de temperatura?
Dirige con el prompt. Donde habrías bajado la temperatura, pide una única respuesta canónica en un formato de salida exacto; donde la habrías subido, pide explícitamente varias alternativas claramente distintas. Si el proveedor expone un control de esfuerzo de razonamiento, ese es el ajuste que sustituye a la temperatura. Los modelos Claude actuales de Anthropic y los de razonamiento de OpenAI devuelven un error en lugar de ignorar el valor en silencio.
OpenAI. "API reference: Chat Completions" — rangos y valores predeterminados oficiales de temperature y top_p
Holtzman et al., 2020. "The Curious Case of Neural Text Degeneration" — investigación sobre nucleus sampling (top-p) y sus efectos en la calidad del texto
Anthropic. "Thinking" — enumera los modelos Claude que rechazan valores no predeterminados de temperature, top_p y top_k
Google. "Gemini API: Text generation" — configuración de generación de Gemini, incluida temperature