Principais conclusões
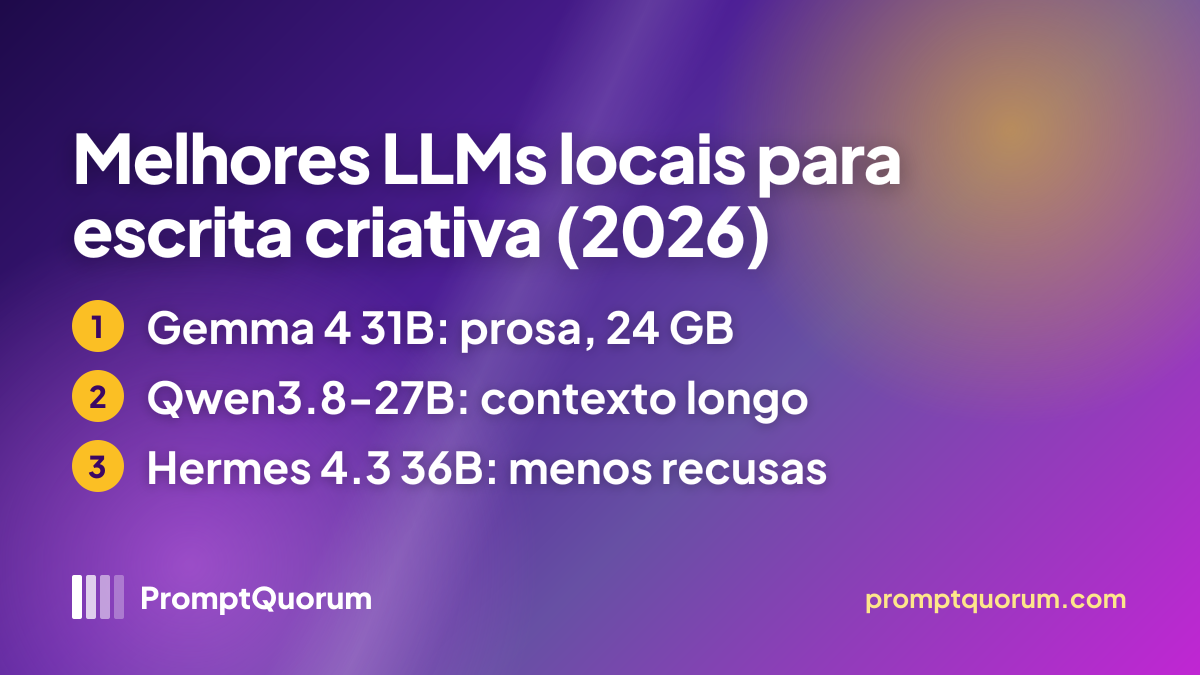
- O Gemma 4 31B é a escolha de prosa para uma GPU de 24 GB. Cerca de 19–20 GB de pesos, contexto de 256K, Apache 2.0 e o único modelo deste conjunto com pontuação própria publicada no EQ-Bench Creative Writing v3 (rubrica 16,01, Elo 1407,6).
- O Qwen3.8-27B é a escolha para contexto longo e seguimento de instruções. Cerca de 18 GB no Ollama, contexto de 256K, Apache 2.0. Ainda não há pontuação criativa publicada, então a qualidade da prosa não está verificada: teste com suas próprias cenas.
- Escolha pela VRAM, não pelo ranking. 12 GB: Gemma 4 12B. 16 GB: Mistral Small 3 24B. 24 GB: Gemma 4 31B ou Qwen3.8-27B. 48 GB ou mais: Llama 3.3 70B.
- O Hermes 4.3 36B é a escolha com poucas recusas. Apache 2.0, baseado no ByteDance Seed-OSS-36B; a Nous Research descreve recusas bastante reduzidas. O Dolphin 3.0 é a alternativa mais antiga.
- A amostragem importa mais que trocar de modelo. Temperatura 0,9–1,1 e top-p 0,92–0,95 para prosa; desligue o modo thinking na ficção. Configurações de programação (0,2–0,4) geram prosa sem vida.
- Modelos de nuvem fechados ainda lideram os benchmarks criativos. O primeiro no EQ-Bench Creative Writing v3 é o Claude Opus 4.7, com 2.206 Elo; a melhor entrada de pesos abertos listada é o Kimi K2.6, com 1.782, muito além do hardware doméstico. O local ganha em privacidade, custo e controle.
Fatos rápidos
- GPU de 24 GB ou Mac de 32 GB: Gemma 4 31B (
gemma4:31b, 19–20 GB) ou Qwen3.8-27B (qwen3.8:27b, 18 GB). Ambos Apache 2.0, ambos com contexto de 256K. - GPU de 12 GB: Gemma 4 12B (
gemma4:12b, 7,7–8,0 GB), contexto de 256K. - GPU de 16 GB: Mistral Small 3 24B (
mistral-small:24b, 14 GB), contexto de 32K, Apache 2.0. Lançado em 2025. - 48 GB ou mais: Llama 3.3 70B (
llama3.3:70b, cerca de 42 GB em Q4_K_M). Lançado em dezembro de 2024; licença comunitária da Meta. - Ajustes com poucas recusas: Hermes 4.3 36B (Apache 2.0) e Dolphin 3.0 (variante Mistral 24B, fevereiro de 2025).
- Base de amostragem para prosa: temperatura 1,0, top-p 0,95, min-p 0,05; acrescente penalidade de repetição ou DRY se as cenas entrarem em loop.
- Regra de memória: os tamanhos do Ollama são só de pesos. Some 2–6 GB para o cache KV assim que ampliar a janela de contexto para cenas longas.
Como estas escolhas foram feitas
Este ranking é uma síntese editorial de fontes publicadas, não uma nova rodada de testes da PromptQuorum. Comparamos as fichas oficiais dos modelos, a biblioteca do Ollama (tamanhos, contexto, tags) e rankings públicos de escrita criativa, e associamos cada modelo a uma faixa de hardware.
- Tamanhos e contexto: lidos nas páginas do Ollama de Gemma 4, Qwen3.8, Mistral Small e nas fichas do Hugging Face. Só pesos; a memória de contexto é à parte.
- Pontuações criativas: EQ-Bench Creative Writing v3 e o Open Writing Leaderboard, como refletidos por rastreadores de terceiros. O Gemma 4 31B tem pontuação própria; o Qwen3.8-27B ainda não. Quando uma pontuação pertence a um modelo irmão, dizemos isso.
- Datas de lançamento: Qwen3.8-27B (agosto de 2026), Gemma 4 (julho de 2026), Mistral Small 3 (2025), Llama 3.3 70B (dezembro de 2024), Hermes 4.3 36B (dezembro de 2025), Dolphin 3.0 (fevereiro de 2025).
- O que não fizemos: não executamos um novo conjunto de prompts pontuado nesses modelos. Os vereditos abaixo seguem as fontes citadas e as fichas; os rótulos «ideal para» são recomendações, não resultados medidos.
- Para técnicas de prompt que melhoram a saída criativa em qualquer modelo, veja controle de temperatura e top-p e prompting por persona.
📌Nota: Benchmarks de escrita criativa são subjetivos e os rankings se contradizem. Trate cada recomendação como hipótese inicial: passe as mesmas três cenas por dois candidatos e fique com o modelo cuja voz você prefere.
Melhor modelo por faixa de VRAM
Escolha primeiro pela memória: o modelo precisa caber e deixar espaço para o contexto. Os tamanhos são downloads do Ollama com a quantização de 4 bits padrão; some 2–6 GB de cache KV em cenas longas.
Sua memória | Modelo | Pesos | Contexto |
|---|---|---|---|
| GPU de 8 GB | Qwen3.5 9B (qwen3.5:9b) | 6,6–7,6 GB | 256K |
| GPU de 12 GB | Gemma 4 12B (gemma4:12b) | 7,7–8,0 GB | 256K |
| GPU de 16 GB | Mistral Small 3 24B (mistral-small:24b) | 14 GB | 32K |
| GPU 24 GB / Mac 32 GB | Gemma 4 31B (gemma4:31b) | 19–20 GB | 256K |
| GPU 24 GB / Mac 32 GB | Qwen3.8-27B (qwen3.8:27b) | 18 GB | 256K |
| GPU 24 GB, saída mais rápida | Gemma 4 26B-A4B (gemma4:26b) | 16–19 GB | 256K |
| 48 GB ou mais | Llama 3.3 70B (llama3.3:70b) | ~42 GB | 128K |
💡Dica: Em um Mac de 32 GB, a memória unificada é compartilhada com o macOS. Conte com cerca de 24 GB utilizáveis para modelo e contexto, o que deixa o Gemma 4 31B e o Qwen3.8-27B confortáveis.
Comparação direta: modelos locais para escrita criativa
Nenhum modelo vence todas as tarefas; escolha pela faixa de hardware e pelo que sustenta o seu trabalho. A tabela lista os modelos deste guia com tamanho, pesos e data de lançamento.
📍 Em uma frase
Gemma 4 31B e Qwen3.8-27B são as melhores opções locais para escrita criativa em uma GPU de 24 GB; Gemma 4 12B, Mistral Small 3 24B e Llama 3.3 70B cobrem as faixas de 12 GB, 16 GB e 48 GB; o Hermes 4.3 36B é a opção com poucas recusas.
💬 Em termos simples
Escolha o maior modelo que caiba na sua memória com espaço para o contexto. Em uma placa de 24 GB, é o Gemma 4 31B para prosa ou o Qwen3.8-27B para projetos longos. Acrescente um ajuste com poucas recusas só se o modelo instruct se recusar a cenas que você precisa escrever.
Modelo | Tamanho | Pesos (Ollama) | Lançado | Ideal para |
|---|---|---|---|---|
| Gemma 4 31B | 31B denso | 19–20 GB | Jul 2026 | Prosa em 24 GB; pontuação EQ-Bench própria |
| Qwen3.8-27B | 27B denso | 18 GB | Ago 2026 | Projetos longos, seguir instruções |
| Gemma 4 26B-A4B | 26B MoE, 4B ativos | 16–19 GB | Jul 2026 | Geração mais rápida em 24 GB |
| Gemma 4 12B | 12B | 7,7–8,0 GB | Jul 2026 | GPUs de 12 GB, contexto longo |
| Mistral Small 3 24B | 24B denso | 14 GB | 2025 | GPUs de 16 GB; antigo, mas testado |
| Llama 3.3 70B | 70B denso | ~42 GB | Dez 2024 | 48 GB ou mais; referência antiga |
| Hermes 4.3 36B | 36B denso | ~21–23 GB (est.) | Dez 2025 | Menos recusas, Apache 2.0 |
| Dolphin 3.0 | 24B (variante Mistral) | ~14 GB | Fev 2025 | Opção antiga com poucas recusas |
💡Dica: O arranjo comum é de dois modelos: um instruct para o dia a dia, mais o Hermes 4.3 36B para as cenas que o instruct recusa. Os dois convivem no ollama list.
Veredito por modelo
- Gemma 4 31B — escolha de prosa para 24 GB. É o único modelo deste conjunto com resultado próprio no EQ-Bench Creative Writing v3 (rubrica 16,01, Elo 1407,6, segundo um rastreador de terceiros). Contexto de 256K e Apache 2.0. O Google indica temperatura 1,0, top-p 0,95, top-k 64 como padrão.
- Qwen3.8-27B — escolha para projetos longos. 262.144 tokens de contexto nativo (extensível a 1M com YaRN), Apache 2.0, cerca de 18 GB no Ollama. A Alibaba o posiciona para programação, agentes e pesquisa; a ficha não menciona escrita criativa e não há pontuação criativa publicada, então verifique a voz com suas cenas. O modo thinking vem ligado por padrão; desligue para prosa.
- Gemma 4 26B-A4B e 12B — mesma família, compromissos diferentes. O modelo de mistura de especialistas de 26B ativa cerca de 4B de parâmetros por token, por isso gera mais rápido que o 31B com memória parecida. O 12B cabe em placas de 12 GB e ainda oferece contexto de 256K.
- Mistral Small 3 24B — a opção de 16 GB. Apache 2.0, cerca de 14 GB, contexto de 32K. É um modelo de 2025 e, junto com o Llama, a recomendação mais antiga aqui; fica na lista porque poucos modelos mais novos cabem em 16 GB. Seu sucessor, o Mistral Small 4 (março de 2026, Apache 2.0), é um modelo de mistura de especialistas de 119B com cerca de 6B de parâmetros ativos, muito além de 16 GB.
- Llama 3.3 70B — a referência de 48 GB. Um modelo de dezembro de 2024 com a licença comunitária da Meta. Em máquinas de 48 GB ou mais, continua sendo uma escolha sólida e amplamente suportada; abaixo dessa faixa, não é prático.
- Hermes 4.3 36B — escolha com poucas recusas. Baseado no ByteDance Seed-OSS-36B com Apache 2.0, com quantizações GGUF no Hugging Face. A Nous Research descreve recusas bastante reduzidas; o Hermes 4.3 respondeu a 72–75 % dos prompts do seu próprio RefusalBench. A ficha sugere temperatura 0,6, top-p 0,95, top-k 20; aumente a temperatura para prosa.
- Dolphin 3.0 — opção antiga com poucas recusas. A geração mais recente do Dolphin que conseguimos confirmar é o Dolphin 3.0 (fevereiro de 2025, incluindo uma variante Mistral 24B). Use-o se quiser um modelo sem censura da família Mistral; o Hermes 4.3 é a escolha mais recente.
📌Nota: A consistência de voz é a métrica que os escritores mais subestimam. Um modelo que escreve um parágrafo brilhante, mas perde o jeito de falar do personagem no quinto, é pior que um modelo estável. Teste a continuidade em sessões longas, não só a qualidade de uma saída isolada.
Melhores modelos do Ollama para escrita criativa
Cinco comandos ollama pull cobrem todas as faixas de hardware deste guia. Depois, rode ollama list para confirmar que o modelo está instalado.
- 24 GB, prosa:
ollama pull gemma4:31b— depoisollama run gemma4:31b. - 24 GB, projetos longos:
ollama pull qwen3.8:27b— execute comollama run qwen3.8:27b --think=falsepara desligar o thinking em prosa. - 12 GB:
ollama pull gemma4:12b. - 16 GB:
ollama pull mistral-small:24b. - 48 GB ou mais:
ollama pull llama3.3:70b. - Ajuste com poucas recusas:
ollama run hf.co/NousResearch/Hermes-4.3-36B-GGUFbaixa o GGUF do Hermes 4.3 do Hugging Face; em uma placa de 24 GB, escolha uma quantização de 4 bits. - Aumente a janela de contexto para cenas longas. O contexto padrão do Ollama é pequeno. Em uma sessão interativa, digite
/set parameter num_ctx 16384ou definanum_ctxem um Modelfile. Valores maiores usam mais VRAM.
Modelos locais ou de nuvem para escrever
Modelos de nuvem fechados pontuam mais alto em benchmarks criativos; modelos locais ganham em privacidade, custo e controle. Quem pesquisa «melhor LLM para escrever» sem «local» recebe dos rankings respostas diferentes das deste guia.
- Os modelos fechados lideram. No EQ-Bench Creative Writing v3, refletido pelo evals.report, o Claude Opus 4.7 está em primeiro com 2.206 Elo, à frente do GPT-5.5 com 2.035.
- As melhores entradas de pesos abertos exigem um data center. O Kimi K2.6 (1.782 Elo) é a entrada de pesos abertos mais alta dessa lista. A Featherless lista o GLM-5.3 com 753B e o DeepSeek-V4.1-Flash com 763B de parâmetros, o que nenhuma máquina doméstica executa.
- O que roda em uma GPU. O Gemma 4 31B obteve 1407,6 Elo e rubrica de 16,01 no mesmo benchmark. Pontuações de rastreadores diferentes não compartilham escala; compare apenas dentro de uma mesma lista.
- Quando o local é a escolha certa. Manuscritos inéditos, trabalho de clientes sob NDA, conteúdo que um provedor de nuvem recusaria, trabalho offline e projetos em que a fatura mensal de API é a restrição.
- Fluxo híbrido. Rascunho e brainstorming em local; um modelo de nuvem apenas para o polimento final de conteúdo não sensível, se você quiser a qualidade extra.
Temperatura e top-p para trabalho criativo
A escrita criativa pede temperaturas de amostragem mais altas que a programação. Os padrões da maioria das interfaces de chat são ajustados para perguntas e respostas; temperatura 0,7 produz prosa sem vida e previsível em prompts criativos.
- Os valores dos fabricantes são um piso, não uma meta. O Google indica para o Gemma 4 temperatura 1,0, top-p 0,95, top-k 64; a Alibaba, para o Qwen3.8 em modo thinking, 1,0 / 0,95 / top-k 20 e, sem thinking, 0,7 / 0,8; a Nous, para o Hermes 4.3, 0,6 / 0,95 / top-k 20. Comece por aí e ajuste para prosa.
- Base para prosa: temperatura 0,95–1,0, top-p 0,92–0,95, penalidade de repetição 1,05–1,1. Ajuste por tarefa a partir daqui.
- Diálogo enxuto: temperatura 0,7–0,85, top-p 0,9. Temperaturas mais baixas mantêm as vozes dos personagens consistentes entre as falas.
- Prosa lírica e poesia: temperatura 1,0–1,2, top-p 0,95. Temperaturas mais altas abrem escolhas de palavras inesperadas.
- Ficção surreal ou de gênero: temperatura 1,1–1,3, top-p 0,95–0,98.
- Cenas guiadas pelo enredo (ação, mistério, reviravoltas): temperatura 0,85–0,95, top-p 0,9. Pedem mais seguimento de instruções que novidade.
- Desligue o modo thinking na ficção. Os tokens de raciocínio aumentam a latência e costumam gerar prosa planejada e arrumada demais. O Qwen3.8 aceita
enable_thinking: false; no Ollama, use--think=false. - min_p (0,05–0,1): uma alternativa ao top-p que ajusta o corte à probabilidade do token principal. É mais permissivo em prompts criativos, sem a incoerência de um top-p muito alto. Use onde seu backend expõe a configuração.
- Penalidade de repetição DRY (multiplicador 0,8, base 1,75, comprimento permitido 2): pega repetições em nível de frase que uma penalidade de repetição comum deixa passar, o que ajuda em sessões longas. Está disponível em backends baseados em llama.cpp, como o KoboldCpp; verifique se sua interface a oferece.
- Para uma explicação mais completa de por que esses parâmetros importam e como interagem, veja controle de temperatura e top-p.
💡Dica: Teste a amostragem em uma cena curta por modelo: três execuções por configuração e escolha a temperatura em que o modelo soa mais vivo sem perder o prompt. As configurações não se transferem perfeitamente entre modelos.
Modelos uncensored: o que são e quando importam
Uncensored não significa antiético. Significa que o comportamento de recusa do modelo foi reduzido por ajuste fino, de modo que ele segue o prompt em vez de recusar. O autor continua sendo o escritor.
- Tecnicamente. Modelos como o Hermes 4.3 e o Dolphin 3.0 são ajustes finos cujo pós-treinamento reduz as recusas diante de prompts maduros, violentos ou moralmente complexos. A Nous Research descreve recusas bastante reduzidas e informa que o Hermes 4.3 respondeu a 72–75 % dos prompts do seu próprio RefusalBench. Há também no Ollama variantes comunitárias «abliterated» ou «heretic» de modelos mais novos; a qualidade delas não é auditada.
- Quando importam no trabalho criativo. Ficção adulta, ficção policial com violência explícita, terror, escrita historicamente fiel sobre guerra ou atrocidades e antagonistas moralmente complexos que o modelo instruct não interpreta de forma convincente.
- Onde ficam a desejar. Eles seguem o prompt, inclusive o mal escrito. Os modelos instruct costumam suavizar um prompt vago até algo publicável; os de poucas recusas entregam exatamente o que você pediu.
- Limites éticos e legais. Que um modelo escreva algo não é licença para produzir conteúdo que mire pessoas reais, retrate cenários sem consentimento envolvendo pessoas identificáveis ou seja ilegal onde você mora. Hospedar localmente não muda a lei; muda quem pode ver o rascunho. As leis variam por país e isto não é aconselhamento jurídico.
- Para um tratamento mais longo de ética, legalidade e boas práticas, veja LLMs locais uncensored para escrita criativa: ética, legalidade e boas práticas.
📌Nota: Uncensored é uma escolha de fluxo de trabalho, não uma identidade. Muitos escritores fazem o rascunho com o modelo instruct e só trocam para um ajuste com poucas recusas em cenas específicas. Ter dois modelos instalados lado a lado é o padrão.
Interfaces para trabalho criativo
A interface de chat em que você escreve importa tanto quanto o modelo. Quatro opções cobrem a maioria dos fluxos de trabalho; escolha pelo formato do seu fluxo.
- Open WebUI — a escolha de uso geral. Interface estilo ChatGPT, troca de modelo com um clique, notas de personagem no prompt de sistema e envio de documentos como contexto. Ideal para rascunhos com muita prosa.
- SillyTavern — a escolha para RPG e diálogo. Cartões de personagem, gerenciamento de personas, lorebooks para worldbuilding e chat em grupo para cenas com vários personagens. Ideal para trabalho baseado em diálogo e projetos de mundo de longa duração.
- Agnai e RisuAI — alternativas mais leves ao SillyTavern, com primeiro uso mais simples e menos personalização.
- CLI do Ollama mais um editor de texto — a escolha mínima.
ollama run gemma4:31be cole as cenas no rascunho. Perde-se o contexto persistente dos personagens, mas ganha-se foco. - Para a comparação direta das interfaces voltadas a RPG, veja SillyTavern vs Agnai vs RisuAI: melhor interface local de RPG.
💡Dica: Rascunhar e editar pedem ferramentas diferentes. Gere na interface de chat e depois exporte para um editor de texto simples para revisar. Editar dentro da janela de chat ensina a pedir ao modelo que conserte a prosa em vez de revisá-la você mesmo.
Decisão: qual modelo para o seu trabalho
Primeiro a memória, depois a tarefa.
📍 Em uma frase
Escolha Gemma 4 31B ou Qwen3.8-27B em uma GPU de 24 GB, Gemma 4 12B com 12 GB, Mistral Small 3 24B com 16 GB, Llama 3.3 70B com 48 GB ou mais e Hermes 4.3 36B para as cenas que os modelos instruct recusam.
💬 Em termos simples
Comece pelo maior modelo que caiba na sua memória com espaço para o contexto. Mude para um especialista só quando uma tarefa, como continuidade de longo fôlego ou cenas maduras, virar o gargalo. Duas instalações custam apenas espaço em disco.
Sua situação | Escolha |
|---|---|
| GPU de 24 GB ou Mac de 32 GB, prosa primeiro | Gemma 4 31B |
| GPU de 24 GB, projeto do tamanho de um romance | Qwen3.8-27B (contexto de 256K) |
| GPU de 24 GB, quero saída mais rápida | Gemma 4 26B-A4B |
| GPU de 12 GB | Gemma 4 12B |
| GPU de 16 GB | Mistral Small 3 24B |
| 48 GB ou mais, um modelo para tudo | Llama 3.3 70B + Hermes 4.3 36B |
| O modelo instruct recusa cenas de que preciso | Hermes 4.3 36B (mantenha um instruct) |
| Quero um para começar e ajustar depois | Gemma 4 31B ou Qwen3.8-27B, o que couber |
💡Dica: A maioria dos escritores pensa demais no modelo e de menos no prompt. Um prompt de sistema com notas de personagem, amostras de voz e ponto de vista explícito rende mais que trocar de modelo. Veja prompting por persona.
Erros comuns ao escolher e usar modelos locais para escrita criativa
- Erro 1: escolher pelo ranking geral de benchmarks. Rankings de programação e raciocínio se correlacionam mal com a qualidade da prosa. Olhe rankings criativos como o EQ-Bench e depois teste com suas próprias cenas.
- Erro 2: usar amostragem de programação. Temperatura 0,2–0,4 produz prosa sem vida. O trabalho criativo pede aproximadamente 0,9–1,1.
- Erro 3: deixar o modo thinking ligado. Modelos de raciocínio planejam antes de escrever, o que pode deixar a ficção com cara de montada. Desligue o thinking para prosa.
- Erro 4: ignorar a memória de contexto. Um modelo de 31B com 19–20 GB deixa pouca folga em uma placa de 24 GB quando você amplia a janela de contexto. Reserve 2–6 GB para o cache KV.
- Erro 5: prompts de sistema magros. «Você é um assistente prestativo» é o pior prompt para trabalho criativo. Combine notas de personagem, ponto de vista e tempo verbal com prompting negativo para descartar clichês.
- Erro 6: editar dentro da janela de chat. Gere no chat; revise em um editor. Escritores que deixam o modelo revisar perdem a voz rapidamente.
⚠️Aviso: O maior risco para as suas habilidades com IA de escrita criativa é terceirizar a revisão. Gerar é trabalho mecânico que se beneficia de um modelo; revisar é o que torna a prosa sua.
Fontes
- Biblioteca do Ollama: Gemma 4 — tags, tamanhos de download e janelas de contexto.
- Biblioteca do Ollama: Qwen3.8 — tag, tamanho e capacidades.
- Hugging Face: ficha do modelo Qwen3.8-27B — licença, comprimento de contexto, amostragem recomendada.
- Hugging Face: ficha do modelo Gemma 4 31B — licença, comprimento de contexto, padrões de amostragem.
- Hugging Face: Hermes 4.3 36B — modelo base, licença, benchmark de recusas, quantizações GGUF.
- Biblioteca do Ollama: Mistral Small — tamanho, contexto e licença do Mistral Small 3 24B.
- EQ-Bench Creative Writing e pontuações EQ-Bench do evals.report — números de rankings citados acima.
- Featherless: melhores modelos abertos para escrita criativa — tamanhos de pesos abertos e números EQ-Bench do Gemma 4 31B.
- Documentação do SillyTavern — cartões de personagem, personas, chat em grupo.
Perguntas frequentes
Qual é o melhor LLM local para escrita criativa?
Gemma 4 31B e Qwen3.8-27B são os melhores pontos de partida locais em 2026, e ambos cabem em uma GPU de 24 GB (cerca de 18–20 GB de pesos). O Gemma 4 31B é a escolha de prosa com pontuação EQ-Bench própria publicada; o Qwen3.8-27B é a escolha de contexto longo. Em placas menores, use Gemma 4 12B (12 GB) ou Mistral Small 3 24B (16 GB).
Qual é o melhor modelo do Ollama para escrita criativa?
Em uma GPU de 24 GB, ollama pull gemma4:31b para prosa ou ollama pull qwen3.8:27b para projetos longos. Com 12 GB, gemma4:12b; com 16 GB, mistral-small:24b; com 48 GB ou mais, llama3.3:70b. Aumente num_ctx para cenas longas e desligue o thinking na ficção.
Qual é o melhor LLM local para escrever ficção e histórias?
Escolha o maior modelo que caiba na sua memória com espaço para o contexto. O Gemma 4 31B é a escolha de prosa em 24 GB, o Qwen3.8-27B atende projetos do tamanho de um romance com seu contexto de 256K e o Llama 3.3 70B é a referência com 48 GB ou mais. Use temperatura 0,9–1,1 e um prompt de sistema com ponto de vista, tempo verbal e amostras de voz.
Qual modelo local é o melhor para worldbuilding?
O que mais importa é o contexto longo: Qwen3.8-27B e Gemma 4 oferecem 256K tokens, o bastante para manter uma bíblia de lore e resumos de capítulos no prompt. Combine qualquer um com lorebooks do SillyTavern ou um documento de mundo fixado e reúna facções, regras e nomes em um único bloco de referência.
Qual LLM é o melhor para escrever um romance?
Em local: Qwen3.8-27B (contexto de 256K) ou Gemma 4 31B (contexto de 256K) em uma GPU de 24 GB. O gargalo é a estrutura, não o tamanho do modelo: um esboço, uma bíblia de personagens e resumos de capítulos garantem a continuidade. Modelos de nuvem fechados pontuam mais alto em benchmarks criativos, mas enviam seu manuscrito a terceiros.
Qual é o melhor modelo local com 32 GB de VRAM ou memória unificada?
Gemma 4 31B (19–20 GB) ou Qwen3.8-27B (18 GB) com uma janela de contexto maior; a memória extra além de 24 GB paga o cache KV. O Gemma 4 26B-A4B é a alternativa mais rápida. Um modelo de 70B não cabe confortavelmente abaixo de 48 GB.
O que é um LLM local uncensored e quando devo usar um?
É um ajuste fino cujo pós-treinamento reduz as recusas diante de prompts maduros ou moralmente complexos, de modo que o modelo segue o prompt em vez de recusar. O Hermes 4.3 36B é a opção mais recente que conseguimos confirmar; o Dolphin 3.0 é mais antigo. Use para ficção adulta ou escrita historicamente fiel e mantenha um modelo instruct para todo o resto.
Qual temperatura devo usar para escrita criativa?
Temperatura 0,9–1,1 com top-p 0,92–0,95 para prosa. Diálogo enxuto pede 0,7–0,85; poesia, 1,0–1,2; trabalho surreal ou de gênero, 1,1–1,3. Valores dos fabricantes, como o 1,0 / 0,95 / top-k 64 do Gemma 4, são um bom ponto de partida. Desligue o modo thinking na ficção.
Os modelos locais de escrita criativa são tão bons quanto o ChatGPT ou o Claude?
Não nos benchmarks. No EQ-Bench Creative Writing v3, modelos fechados como o Claude Opus 4.7 (2.206 Elo) lideram, e as melhores entradas de pesos abertos exigem hardware de data center. Um modelo local de 24 GB pode ser bom o bastante para rascunhar e mantém os manuscritos privados. Amostragem calibrada e um bom prompt de sistema fecham boa parte da diferença prática.
Um modelo local consegue escrever um romance inteiro?
Ele pode ajudar a rascunhar. Um modelo de contexto de 256K, como o Qwen3.8-27B ou o Gemma 4, consegue manter na memória um esboço longo e vários capítulos, mas o cache KV cresce com o contexto, então verifique a VRAM. Rascunhe seção por seção com uma bíblia de personagens e um lorebook; sem eles, qualquer modelo se desvia.
Modelos uncensored produzem conteúdo ilegal?
Eles produzem o texto que o prompt pede; a responsabilidade legal recai sobre o escritor e a publicação, não sobre o modelo. Marcos como o AI Act da UE, o § 184/§ 184c do StGB alemão e as normas nacionais sobre obscenidade valem independentemente de como o texto foi gerado. Hospedar localmente muda quem vê o rascunho, não o que é legal. Isto não é aconselhamento jurídico.
Como evito o clichê «shiver down their spine»?
Liste 8–12 frases proibidas no prompt de sistema («do not write 'shiver,' 'tapestry,' 'delve,' or 'she felt'»). Mantenha a temperatura em 0,85–1,0 em vez de 1,2 ou mais e adicione uma penalidade DRY onde o backend a suportar; uma penalidade de repetição simples não pega clichês em nível de frase. Uma revisão manual é o filtro final. Veja prompting negativo.