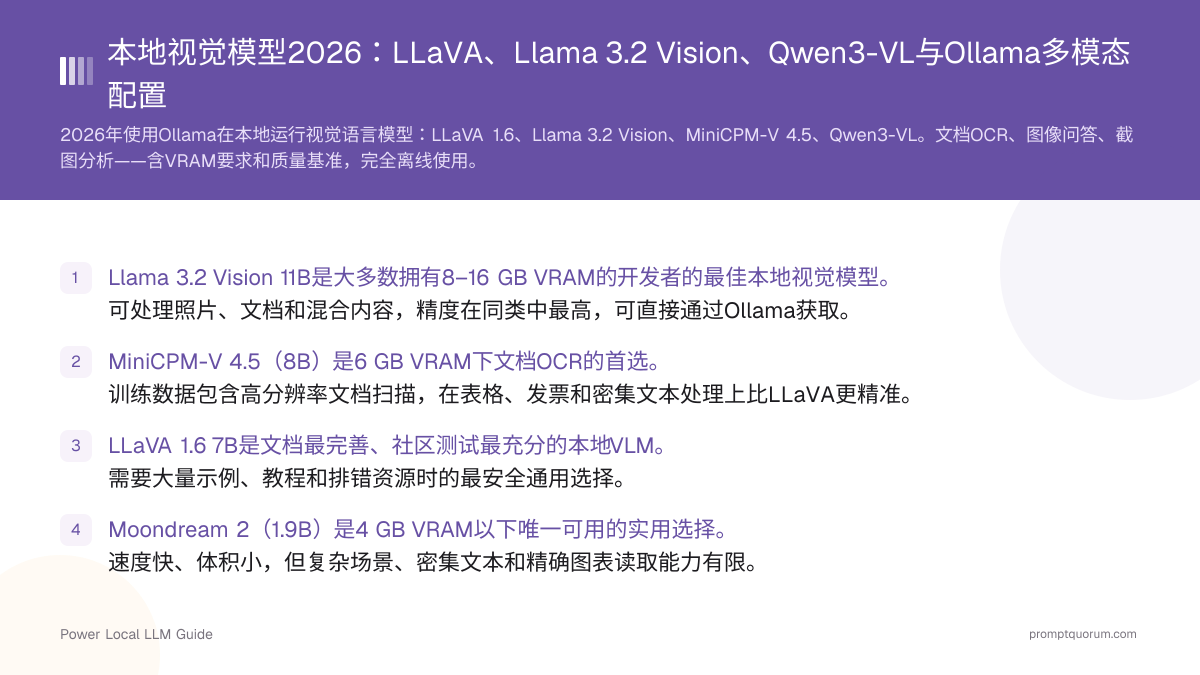
快速概览
- VLM的功能: 图像+文本输入 → 文本输出。不是图像生成器——这些是图像*理解*模型。
- Ollama支持: Gemma 4、Qwen3.8、Qwen3.5、Qwen3-VL、Llama 3.2 Vision、MiniCPM-V、LLaVA和Moondream均在Ollama官方模型库中;InternVL、PaliGemma 2和SmolVLM需使用社区构建版本。
- 最小可用模型: Moondream 2(1.8B,下载1.7 GB)、Qwen3-VL 2B(1.9 GB)和Qwen3.5 0.8B(1.2–1.3 GB)。
- 最大实用本地模型: Qwen3.5 122B(81 GB)需128 GB的Mac,Llama 3.2 Vision 90B(55 GB)需96 GB以上的Mac(Apple M系列)或多GPU;Qwen3-VL 235B需要143 GB。
- 图像输入格式: JPEG、PNG、WebP。最大分辨率因模型而异(通常1024×1024至4096×4096)。
- 音频与视频: Gemma 4 E2B、E4B和12B还支持音频输入;所有Gemma 4规格和Qwen3.8均可将视频按帧处理。
- OCR强度: Qwen3.8 27B ≈ Qwen3-VL 8B ≈ Qwen3.5 9B > Gemma 4 > MiniCPM-V > LLaVA 1.6 13B > LLaVA 1.6 7B > Moondream 2。
- 多模态≠高速: 视觉模型在LLM基础上增加视觉编码器——token生成速度比同参数量纯文本模型慢约30–60%。
什么是视觉语言模型(VLM)?
视觉语言模型(VLM)是同时处理图像和文本输入并生成文本输出的神经网络。标准架构将视觉编码器(通常为CLIP或SigLIP)与语言解码器(LLM)通过投影层连接,将图像特征映射到LLM理解的token空间。
- 与图像生成器的区别: Stable Diffusion、FLUX和DALL-E 3是文本生成图像的生成器。VLM是图像到文本的模型——它们描述、分析并回答关于图像的问题。
- 与纯OCR工具的区别: 传统OCR(Tesseract)通过模式识别提取文本。VLM理解上下文——可解释表格含义、回答图表问题或识别照片中的对象。
- 为何在本地运行: 私密文档(医疗记录、法律扫描件、财务报表)、专有截图,或因合规要求不能将图像发送到云端API的工作流。
- 不能做的事: 生成图像、执行截图中的代码或访问互联网。VLM仅根据图像中可见内容生成文本输出。
可用本地视觉模型——对比表
主要本地视觉模型(可通过Ollama或直接推理使用)的比较,核查日期为2026年10月23日。VRAM列为Ollama下载大小(除非另有说明为4位量化)——请为上下文额外预留1–2 GB。*据报告,Llama 3.2 Vision在较新版本的Ollama上无法加载(见上文Llama 3.2 Vision说明)。
📍 简单一句话
8 GB VRAM选Gemma 4 E4B或Qwen3-VL 8B;24 GB选Gemma 4 26B/31B或Qwen3.8 27B——均可通过Ollama本地运行。
💬 简单来说
Gemma 4整体最优;Qwen3-VL、Qwen3.5和Qwen3.8在文档OCR和多语言文本上领先;Moondream和Qwen3.5 2B是4 GB VRAM以下的轻量选项。
模型 | 参数量 | VRAM (Q4) | 图像类型 | 质量 | 支持Ollama? |
|---|---|---|---|---|---|
| Moondream 2 | 1.8B | 约2 GB | 简单照片 | 基础 | 是 |
| SmolVLM 2.2B | 2.2B | 约2 GB | 简单照片、图注 | 基础+ | 社区支持 |
| Qwen3.5 2B | 2B | 2.7–3.1 GB | 照片、文档、OCR | 良好 | 是 |
| PaliGemma 2 3B | 3B | 约3 GB | 照片、文档 | 良好 | 社区支持 |
| Qwen3-VL 4B | 4B | 3.3 GB | 照片、文档、OCR | 良好 | 是 |
| Gemma 4 E2B | 2.3B有效 | 4.6–7.5 GB | 照片、文档、音频 | 良好 | 是 |
| LLaVA 1.6 7B | 7B | 约6 GB | 照片、文档、图表 | 良好 | 是 |
| MiniCPM-V | 8B | 约6 GB(拉取5.5 GB) | 照片、文档、OCR | 非常好 | 是 |
| Qwen3-VL 8B | 8B | 约6.2 GB | 照片、文档、OCR、多语言 | 优秀 | 是 |
| Qwen3.5 9B | 9B | 6.6–7.6 GB | 照片、文档、OCR、多语言 | 优秀 | 是 |
| Gemma 4 E4B | 4.5B有效 | 6.6–9.5 GB | 照片、文档、音频 | 非常好 | 是 |
| Gemma 4 12B | 12B | 7.7–8.0 GB | 照片、文档、音频 | 优秀 | 是 |
| InternVL 2.5 8B | 8B | 约8 GB | 文档、图表、UI、代码 | 优秀(UI/图表) | 社区支持 |
| Llama 3.2 Vision 11B | 11B | 约8 GB(拉取7.8 GB) | 照片、文档 | 优秀* | 是* |
| LLaVA 1.6 13B | 13B | 约10 GB | 照片、文档、图表 | 非常好 | 是 |
| Gemma 4 26B A4B | 26B(4B活跃) | 16–19 GB | 照片、文档、复杂 | 优秀 | 是 |
| Qwen3.8 27B | 27B | 18 GB | 照片、文档、视频、OCR | 开源最强 | 是 |
| Gemma 4 31B | 31B | 19–20 GB | 照片、文档、复杂 | 优秀 | 是 |
| Qwen3-VL 32B | 32B | 21 GB | 照片、文档、OCR、复杂 | 优秀 | 是 |
| Llama 3.2 Vision 90B | 90B | 55 GB | 照片、文档、复杂 | 非常好* | 是* |
| Qwen3.5 122B | 122B | 81 GB | 照片、文档、复杂 | 本地最强 | 是 |

示例对比:发票提取
本地视觉模型在结构化文档提取任务上的示例性精度对比:从一张样本发票中提取5个字段(供应商名称、日期、总金额、税额、行项目数量)。这不是PromptQuorum的基准测试。设备、运行时版本、模型标签、量化方式、提示词和运行次数均未记录,因此这些标记仅供参考,无法复现。带*的行以模型能在你的Ollama版本上加载为前提。
模型 | 供应商 | 日期 | 总金额 | 税额 | 行项目 | 得分 |
|---|---|---|---|---|---|---|
| Moondream 2 | ✓ | ✓ | ✗ | ✗ | ✗ | 2/5 |
| LLaVA 1.6 7B | ✓ | ✓ | ✓ | ✗ | ✓ | 4/5 |
| MiniCPM-V | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Qwen3-VL 8B | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Llama 3.2 Vision 11B* | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| GPT-5.5 Vision | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
📌注: 结果来自单份测试发票。实际精度因文档质量、字体和布局复杂度而异。始终将提取的数字与原始文档核对。
多图像支持
并非所有本地视觉模型都支持单次请求中的多张图像。多图像支持对多页PDF文档处理和视觉对比任务至关重要。
- MiniCPM-V每次提示最多接受4张图像;Qwen3-VL最多支持8张。LLaVA和Moondream每次请求只接受单张图像。
- 多图像的重要场景: 发送多页PDF的所有页面进行完整文档提取;并排比较两张产品照片;在单个提示中分析前后截图对比。
功能 | Moondream | LLaVA 7B | MiniCPM-V | Qwen3-VL | LLaVA 13B | Llama 3.2 Vision | InternVL |
|---|---|---|---|---|---|---|---|
| 多图像输入 | 不支持 | 不支持 | 支持(最多4张) | 支持(最多8张) | 不支持 | 支持(多页) | 支持 |
Ollama配置——逐步说明
Ollama是运行本地视觉模型最简单的方式。安装后,视觉模型通过单条pull命令即可使用,支持CLI和HTTP API。
- 步骤1——安装Ollama: 从ollama.com下载macOS、Linux或Windows版本。安装时间不超过2分钟。
- 步骤2——拉取视觉模型: 8 GB显卡用
ollama pull gemma4:e4b(下载6.6–9.5 GB),OCR用ollama pull qwen3-vl:8b(6.2 GB),低VRAM时用ollama pull moondream(1.8B,1.7 GB)。 - 步骤3——通过CLI使用:
ollama run gemma4:e4b "What is in this image? /path/to/photo.jpg"——图像路径写在提示内;ollama run没有--image参数。 - 步骤4——使用HTTP API: POST到
http://localhost:11434/api/generate,在images数组中包含Base64编码的图像。在format字段中加入JSON schema可获得结构化输出。 - 步骤5——Python示例: 使用
requests库进行Base64编码——见下方代码块。
import base64
import requests

def ask_vision_model(image_path: str, prompt: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")

    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": prompt,
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

# 示例用法
result = ask_vision_model("invoice.png", "从这张发票中提取所有行项目和总金额。")
print(result)
用例1:文档OCR与提取
VLM在半结构化文档上优于传统OCR ——发票、收据、合同和表格中,布局与文本同样重要。传统OCR(Tesseract)提取字符;VLM理解这些字符在上下文中的含义。
- 效果好的场景: 扫描发票、PDF截图、印刷体手写(非草书)、边框清晰的表格、名片。
- 效果较差的场景: 草书手写、低于150 DPI的扫描件、高压缩JPEG、重叠文本。
- OCR最佳模型: Qwen3-VL 8B和Qwen3.5 9B(6–8 GB级别),Qwen3.8 27B(18 GB,据其模型卡在OmniDocBench 1.5上得分91.1),混合文档类型选Gemma 4。
- OCR提示工程: "请完整提取此文档中的所有文本,保留换行符。"或"请以JSON格式返回此发票内容,字段包括:供应商、日期、行项目[]、总金额。"
- 与传统OCR对比: VLM速度较慢但语义理解更强。干净文档的纯文本提取用Tesseract更快。需要结构化数据提取时使用VLM。
用例2:图像问答与描述
通用场景理解、产品描述和视觉问答推荐使用Gemma 4(8 GB选E4B,24 GB选26B或31B)。 该模型可生成自然、详细的描述,并处理关于照片内容的细微问题。
- 场景描述: "这张照片里有什么?"——物体、人物、活动、环境、氛围。
- 产品目录化: 用提示模板处理产品照片:"描述此产品:颜色、形状、材质、状态。"适用于无需云端API的电商库存管理。
- 无障碍访问: 大规模为图像生成alt文本。对标准产品照片,准确度足以满足无障碍合规要求。
- 最佳模型: Gemma 4 12B或26B A4B(通用照片问答);Qwen3.5 4B或LLaVA 1.6 7B(速度比精度更重要的大批量处理)。
- 速度参考: 速度取决于模型、GPU和描述长度——在处理数千张之前,请先在自己的硬件上用20张图像样本做基准测试。
用例3:截图与UI分析
分析应用截图、错误消息和仪表板,InternVL 2.5是最强的本地模型——其训练数据着重强调软件UI、GitHub截图和代码执行输出。
- 开发者工作流: 将错误消息截图发给模型:"这个截图中哪里有问题,如何修复?"
- Bug报告生成: 用结构化提示从截图自动生成Bug描述。
- 仪表板监控: 分析监控仪表板截图以检测异常——"这个Grafana截图中是否有警告级别的指标?"
- 无障碍测试: 对比UI改动前后的截图以验证视觉无障碍属性。
- 最佳模型: InternVL 2.5 8B(社区构建版,UI能力强),Gemma 4和Qwen3-VL(官方Ollama支持,具备面向智能体工作流的工具调用)。
用例4:图表与图形读取
从条形图、折线图和表格中提取数据是可行的,但需要精心设计提示。 所有本地VLM在图表读取上都弱于照片描述——始终将从图表提取的数字与原始数据核对。
- 效果好的场景: 读取坐标轴标签、识别趋势、比较相对柱高、读取字体清晰的表格值。
- 不可靠的场景: 从连续图表精确提取数值(如"Q3柱子是43.7单位")、无显式标签的饼图百分比。
- 提示策略: "描述折线图中显示的趋势"比"2026年3月的精确值是多少"效果更好。
- 图表最佳模型: InternVL 2.5(图表理解强),Gemma 4和Qwen3-VL(标注清晰的图表表现良好)。
- 限制说明: 2026年任何本地VLM都无法可靠地从视觉复杂的图表中提取精确数字。
用例5:视频帧分析
本地视觉模型可通过处理单帧来分析视频——用ffmpeg提取帧,逐帧发给视觉模型,再用文本LLM跨帧汇总。非实时:根据模型和硬件,每帧需0.5–3秒。
- 帧提取: 使用ffmpeg以1fps提取:
ffmpeg -i video.mp4 -vf fps=1 frames/frame_%04d.jpg - 逐帧分析: 用统一提示将每帧发给视觉模型(例如:"用一句话描述这帧中发生的事情")。
- 跨帧汇总: 收集所有帧描述,配合汇总提示发给文本LLM。
- 应用场景: 安防摄像头审查(标记异常活动帧)、讲座录制分析(生成逐幻灯片笔记)、制造业质量检验(标记出现缺陷的帧)。
- 视频帧最佳模型: Gemma 4或Qwen3.8(质量,两者均原生支持按帧输入视频),Qwen3.5 4B或LLaVA 1.6 7B(速度,帧处理吞吐量更高)。
- 速度现实: 以每秒1帧提取、每帧约1–3秒推理计算,10分钟视频(600帧)完整处理大约需要10–30分钟,取决于模型和GPU。
import base64
import subprocess
import os
import requests

def extract_frames(video_path: str, output_dir: str, fps: int = 1) -> list[str]:
    os.makedirs(output_dir, exist_ok=True)
    subprocess.run([
        "ffmpeg", "-i", video_path,
        "-vf", f"fps={fps}",
        f"{output_dir}/frame_%04d.jpg",
        "-y"
    ], check=True)
    return sorted([
        os.path.join(output_dir, f)
        for f in os.listdir(output_dir)
        if f.endswith(".jpg")
    ])

def analyze_frame(image_path: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")
    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": "Describe what is happening in this frame in one sentence.",
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

frames = extract_frames("lecture.mp4", "frames/", fps=1)
descriptions = [analyze_frame(f) for f in frames]
print("\n".join(f"[{i+1}s] {d}" for i, d in enumerate(descriptions)))
VRAM与性能现实检验
本地视觉模型在基础LLM上增加视觉编码器,与纯文本模型相比,VRAM需求和推理时间均会增加。
模型 | VRAM (Q4) | token/秒 (RTX 4070) | token/秒 (M5 Pro 36GB) | 适合生产? |
|---|---|---|---|---|
| Moondream 2 (1.8B) | 约2 GB | 约25–35 | 约30–40 | 是——适合简单任务 |
| LLaVA 1.6 7B | 约6 GB | 约15–20 | 约18–25 | 是——通用 |
| MiniCPM-V (8B) | 约6 GB | 约12–18 | 约15–20 | 是——OCR和文档 |
| Llama 3.2 Vision 11B | 约8 GB | 约10–14 | 约12–16 | 先查Ollama加载问题 |
| LLaVA 1.6 13B | 约10 GB | 约8–12 | 约10–14 | 是——需12 GB GPU |
| Llama 3.2 Vision 90B | 55 GB | N/A(需多GPU或M-Max) | N/A(需M5 Max 128GB+) | 仅高端Apple Silicon |
📌注: token/秒范围为参考估计值,并非新的实测数据;未针对Gemma 4、Qwen3.5或Qwen3.8重新测试。请在自己的硬件上用 ollama run <model> --verbose 做基准测试,该命令会输出评估速率。
📌注: 视觉模型的token生成速度比同尺寸纯文本模型慢,因为视觉编码器在处理第一个图像token时会产生大量计算开销。后续文本token的生成速度接近正常水平。
📌注: Apple Silicon统一内存可运行更大的模型(128 GB Mac上可运行55 GB的Llama 3.2 Vision 90B或81 GB的Qwen3.5 122B),这些模型无法放入独立GPU的VRAM中。速度略慢于同等NVIDIA GPU,但无VRAM限制。
本地VLM与GPT-5.5 Vision对比
本地VLM在结构化文档上已大幅缩小差距,但在复杂和模糊任务上仍落后于GPT-5.5 Vision。以下对比为编辑部判断,并非PromptQuorum的基准测试。
- 结构化文档(发票、表单): 这是编辑部的判断,并非基准测试结果:优秀的本地模型在干净、格式规范的文档上接近GPT-5.5 Vision——验证输出后即可用于生产。
- 复杂场景、模糊图像: 在上下文异常、光线复杂或内容模糊的图像上,本地模型明显落后于GPT-5.5 Vision(编辑部判断,未经基准测试)。
- 手写识别: 本地模型明显较弱,尤其是草书体。GPT-5.5 Vision在手写处理上大幅领先。
- 图表数据提取: 本地模型和GPT-5.5均不可靠,但GPT-5.5在精确数值方面更准确。
- 成本: GPT-5.5 Vision每张图像$0.01–$0.03,本地为$0。每月10,000张图像节省$100–$300。
- 隐私: 本地模型默认在设备上处理图像——除非启用云功能或联网工具,图像不会发送到云端API。GPT-5.5将图像发送至OpenAI服务器。
- 速度: 本地模型在RTX 4070上根据规模约为8–35 token/秒(参考估计,见上表);云端速度因服务商和负载而异,但本地批处理没有网络延迟。
📌注: 对于输入规范的发票和表单处理,本地VLM(Gemma 4、Qwen3-VL 8B、Qwen3.8 27B)可以零成本替代GPT-5.5 Vision。涉及手写、复杂场景分析或模糊内容时,GPT-5.5仍占优势。
LLaVA深度解析
LLaVA(Large Language and Vision Assistant)是基础性的开源VLM架构。 由威斯康星大学麦迪逊分校和微软研究院于2023年发布,确立了大多数现代本地VLM所遵循的CLIP编码器+LLM解码器模式。
- 架构: CLIP ViT-L/14视觉编码器 + Llama-2或Mistral文本解码器,通过简单线性投影层连接。
- LLaVA 1.5 vs 1.6: 1.6版本(2024年初发布)通过动态分块增加了高分辨率输入支持,显著提升了OCR和图表读取精度。
- 训练: 在LLaVA-Instruct-150K上进行指令微调——从图像描述和目标检测标注生成的视觉对话数据集。
- 优势: 广泛的通用知识、文档完善、社区庞大、Ollama集成丰富。
- 劣势: OCR弱于Qwen3-VL和MiniCPM-V,UI分析弱于InternVL 2.5,整体被Gemma 4和Qwen3系列超越。
- 仍被推荐的原因: 在所有本地VLM中拥有最大社区、最多教程和最多提示示例。遇到问题时更容易找到帮助。
- 完整评测: LLaVA评测(2026) — PromptQuorum的专门评测,包括Apache-2.0与基础模型许可证的细微差别及真实的Ollama命令。
Qwen3-VL、Qwen3.5与Qwen3.8——最强多语言OCR
Qwen系列是2026年文档OCR和多语言文本方面最强的开源选择。 Qwen3-VL(2B至235B)是专门的视觉系列,Qwen3.5(0.8B至122B)将视觉能力并入基础模型,Qwen3.8 27B(2026年8月,Apache 2.0)是最新版本,据报告在OmniDocBench 1.5上得分91.1。
- 架构: 支持高达4096×4096的动态分辨率——远高于LLaVA 1.6(672×672)或Llama 3.2 Vision(1120×1120)。可读取高DPI扫描件而无需下采样。
- 多语言OCR: 中文、日文、韩文和英文OCR达到同类最佳。训练数据包含大规模多语言文档语料库——在非英文文档处理上相对LLaVA和Llama 3.2 Vision具有显著优势。
- 如何选择规格: Qwen3-VL 8B下载6.2 GB,适合8 GB显卡;Qwen3.5 9B为6.6–7.6 GB;Qwen3.8 27B为18 GB,需要24 GB显卡;Qwen3-VL 32B为21 GB。Ollama上的Qwen3-VL没有72B版本。
- Qwen3-VL 4B: 下载3.3 GB(256K上下文),介于2B(1.9 GB)和8B(6.2 GB)之间,适合约4–6 GB VRAM的显卡。
- Ollama安装:
ollama pull qwen3-vl:8b、ollama pull qwen3.5:9b或ollama pull qwen3.8——均在Ollama模型库中。 - 多图像支持: 每次请求最多接受8张图像——本比较中多图像容量最高。
- 模型页面: Ollama上的Qwen3-VL、Hugging Face上的Qwen3.8-27B
如何选择视觉模型
以VRAM为首要标准的本地视觉模型选择决策树:
📍 简单一句话
首先按VRAM选择(2→4→8→24 GB),再按用例细化(OCR、UI、通用问答或最高质量)。
💬 简单来说
4 GB以下:Qwen3.5 2B或Moondream。8 GB:照片选Gemma 4 E4B,文档选Qwen3-VL 8B。24 GB:Gemma 4 26B/31B或Qwen3.8 27B。64 GB以上:Qwen3.5 122B。
- 4 GB以下VRAM: Qwen3.5 2B(2.7–3.1 GB)、Qwen3-VL 2B(1.9 GB)或Moondream 2(1.7 GB)是实用选项。PaliGemma 2(3B)和SmolVLM(2.2B)是社区构建版本的备选方案。均不适合密集文本OCR。
- 6–8 GB VRAM: 通用照片问答选Gemma 4 E4B,文档OCR和多语言文本选Qwen3-VL 8B或Qwen3.5 9B,注重社区支持时选LLaVA 1.6 7B。
- 12–16 GB VRAM: Gemma 4 12B(下载7.7–8.0 GB)是明确推荐——同尺寸下视觉得分出色,支持音频输入和256K上下文窗口。LLaVA 1.6 13B和InternVL 2.5 8B(UI和代码截图)也能放下。
- 24 GB VRAM: Gemma 4 26B A4B(16–19 GB)、Gemma 4 31B(19–20 GB)、Qwen3.8 27B(18 GB)或Qwen3-VL 32B(21 GB)——最接近云端视觉质量的本地选择。
- 96 GB以上统一内存(Apple M-Max/Ultra、多GPU): Qwen3.5 122B(81 GB,需128 GB的Mac)或Llama 3.2 Vision 90B(55 GB)是最大的本地模型;两者都需要大内存硬件,且每token速度比24 GB级模型更慢。
- 始终验证数字: 无论使用何种模型,从图表或表格提取的任何数值都应与源数据交叉核对。本地VLM会对视觉图表中的精确数字产生幻觉。
常见问题
为什么llama3.2-vision会报“unknown model architecture: mllama”?
用户报告在较新版本的Ollama上,llama3.2-vision出现此错误(GitHub issue #16490和#16547,2026年年中提出;后者作为重复项关闭,尚无确认的修复)。在这些报告中,更新Ollama或重新拉取模型均无效。除非必须使用Llama 3.2 Vision,否则请改用Ollama模型库中持续维护的Gemma 4或Qwen3-VL;如必须使用,请固定到仍能加载它的Ollama版本。
3B参数以下最好的小型视觉语言模型是什么?
Qwen3.5 2B(下载2.7–3.1 GB)和Qwen3-VL 2B(1.9 GB)是Ollama上最强的小型选择;Moondream 2(1.8B,1.7 GB)最轻量。Gemma 4 E2B(2.3B有效参数,下载4.6–7.5 GB)增加了音频输入。与8B级别相比,OCR和复杂场景理解能力会较弱。
哪些本地模型可以处理实时摄像头和麦克风输入?
Gemma 4 E2B、E4B和12B同时支持图像和音频,是构建能“看”能“听”的本地助手的天然基础。但仅有模型并不构成实时系统:您还需要采集循环(抓取帧、切分音频)、语音转文字或音频输入通道,以及用于语音回复的文字转语音环节。在此基础上开发之前,请确认您的运行时版本确实会把音频传给模型。
如何从截图和文档中获得可靠的结构化输出?
在Ollama的format字段中传入JSON schema,将temperature设为0,并且只要求提取图像中可见的字段。这会将回复限制为带有您所定义键的有效JSON;但这不能保证值正确,因此请对照源数据校验数字和日期,并记录失败情况。8B及以上的较大模型比2B模型更稳定地遵循schema。
哪些GPT-4V替代方案可以完全在设备本地运行?
在24 GB GPU上,最接近的是Gemma 4 31B(19–20 GB)、Qwen3.8 27B(18 GB)和Qwen3-VL 32B(21 GB);Gemma 4 E4B和Qwen3-VL 8B可覆盖8 GB设备。全部可通过Ollama离线运行。它们在清晰文档和照片上可与云端模型相当,但在手写、模糊场景和复杂信息图表上仍有差距。
可以不使用Ollama直接运行LLaVA或Llama 3.2 Vision吗?
可以。两者都可以通过llama.cpp(支持视觉)、transformers库(使用相应模型卡)或LM Studio(提供视觉模型GUI)直接运行。Ollama推荐是因为其简便性——自动处理模型下载、量化选择和API托管。
Llama 3.2 Vision支持直接输入PDF吗?
没有任何本地VLM直接接受PDF输入。需要先将PDF页面转换为图像(使用pdf2image、pypdfium2等),然后将每页作为独立图像请求发送。10页PDF需发送10个独立图像请求并合并汇总结果。
本地视觉模型与GPT-5.5 Vision相比如何?
GPT-5.5 Vision在模糊场景、手写、复杂信息图表以及需要结合世界知识的视觉理解任务上仍明显更强。Gemma 4和Qwen3-VL在结构化文档(发票、表单、清晰照片)上接近GPT-5.5,但在模糊图像推理上有差距。成本、隐私和速度的详细对比见上文。
本地VLM支持什么图像分辨率?
LLaVA 1.6支持最高672×672有效分辨率(动态分块)。MiniCPM-V支持最高1344×1344 (≈1.8 MP)——这也是其在高DPI文档扫描上优于LLaVA的原因之一。Llama 3.2 Vision支持最高1120×1120。Gemma 4和Qwen3-VL接受可变的宽高比和分辨率。最佳OCR效果请以150+ DPI发送文档图像。
可以用自己的图像对本地视觉模型进行微调吗?
可以,但VLM微调比纯文本LLM微调更消耗资源——图像和文本训练对都需要完整前向传播处理。LLaVA微调使用原始训练代码库,文档完善。MiniCPM-V通过Hugging Face官方训练脚本支持微调。大多数用例仅靠提示工程即可,无需微调。
8 GB VRAM的最佳本地视觉模型是什么?
通用使用选Gemma 4 E4B(下载6.6–9.5 GB);若主要需求是文档OCR或多语言文本,则选Qwen3-VL 8B(6.2 GB)。两者均可通过Ollama单条命令获取。Qwen3.5 9B(6.6–7.6 GB)是第三种选择。
LLaVA与MiniCPM-V——哪个OCR效果更好?
MiniCPM-V在文档OCR上比LLaVA更精准,尤其是密集表格和高DPI扫描件,但Qwen3-VL 8B的OCR表现强于二者。LLaVA 1.6文档更完善,社区支持更好。请注意,Ollama的minicpm-v页面仍描述的是MiniCPM-V 2.6(5.5 GB);更新的MiniCPM-V版本需要Hugging Face或llama.cpp构建版本。
本地视觉模型能识别手写吗?
印刷体手写(块状字母):Gemma 4、Qwen3-VL和MiniCPM-V可以中等精度识别。草书手写:所有本地模型均不可靠。GPT-5.5 Vision在草书方面大幅领先。生产环境中的草书文档手写OCR仍建议使用云端API。
除Ollama外,哪些本地视觉模型可以用llama.cpp或vLLM运行?
有多个。llama.cpp的多模态文档在现成的GGUF构建中列出了Gemma 3、Gemma 4(E2B、E4B、26B A4B、31B)、InternVL 2.5和3、Moondream 2以及SmolVLM等,llama-server可通过兼容OpenAI的API提供服务。vLLM的支持模型页面列出了Gemma 4、Qwen3-VL、Qwen3.5、MiniCPM-V、InternVL和LLaVA-NeXT。支持情况因模型和版本而异,因此在基于某个模型开发之前,请在这两个页面上核对你要用的具体模型(核对日期:2026年10月23日)。Ollama仍是最简单的选择,因为它在一个工具中完成下载、量化和API服务。
量化对视觉模型的VRAM占用和质量影响有多大?
量化主要改变内存占用:在Ollama上,Gemma 4 E4B在q4_K_M下为6.6 GB,q8_0下为9.0 GB,bf16下为16 GB;Gemma 4 31B分别为20 GB、34 GB和63 GB。默认标签通常接近q4_K_M的大小,因此上表的VRAM列给出的是4位数值。Google的QAT版本略小(gemma4:e4b-it-qat为6.1 GB)。更高精度会占用更多内存并降低速度;是否能改善你的结果取决于模型和任务,我们没有测量过,因此请用自己的图片样本对比q4_K_M和q8_0。上下文还需额外预留1–2 GB。
在搭载Apple Silicon的Mac上应该运行哪个本地视觉模型?
Ollama提供面向Apple Silicon的MLX构建:gemma4:e4b-mlx(9.5 GB)、gemma4:12b-mlx(7.7 GB)、gemma4:26b-mlx(18 GB)、gemma4:31b-mlx(19 GB)和qwen3.8:27b-mlx(18 GB)。统一内存需要同时容纳权重、macOS和上下文,经验法则如下(我们的容量参考,并非基准测试):先扣除macOS占用的8 GB:16 GB的Mac(约8 GB可用)可选Qwen3-VL 8B(6.2 GB);24 GB(约16 GB可用)可选Gemma 4 E4B或Gemma 4 12B;32 GB(约24 GB可用)可选18 GB的26B A4B构建、Gemma 4 31B或Qwen3.8 27B,但留给上下文的只有约4–6 GB。
16 GB VRAM、32 GB内存或2 GB显卡,最适合哪个本地视觉模型?
2 GB VRAM:Moondream 2(1.7 GB)或Qwen3-VL 2B(1.9 GB),仅适合简单图像。约4 GB:Qwen3-VL 4B(3.3 GB)。16 GB VRAM:Gemma 4 12B(7.7–8.0 GB),并为长上下文留有余量;Gemma 4 26B A4B的下载(16–19 GB)无法完全放入,Ollama会把部分层卸载到系统内存,速度随之变慢。24–32 GB VRAM(例如RTX 5090):Gemma 4 31B、Qwen3.8 27B或Qwen3-VL 32B。只有32 GB内存而没有GPU时,模型在CPU上运行:请停留在8B级别(Qwen3-VL 8B、Gemma 4 E4B),速度会明显慢于GPU。
有Gemma 5吗?有比Gemma 4和Qwen3.8更新的视觉模型吗?
在我们于2026年10月23日核查的来源中没有。Ollama没有gemma5页面,其gemma4页面列出E2B、E4B、12B、26B和31B构建,Qwen3.8 27B是本指南涵盖的最新Qwen模型。新模型发布频繁,决定前请查看Ollama模型库的视觉模型列表,并将任何关于未发布模型的说法视为未经证实。
参考来源
- Hugging Face上的Gemma 4模型卡 — 谷歌的Apache 2.0许可、各规格支持的模态以及MMMU Pro结果。
- Ollama上的Gemma 4 — 标签、下载大小和上下文窗口。
- Hugging Face上的Qwen3.8-27B — Apache 2.0许可、262K上下文、OmniDocBench 1.5结果。
- Ollama上的Qwen3.5和Ollama上的Qwen3-VL — 规格和下载大小。
- Ollama上的Llama 3.2 Vision和Ollama issue #16547 — 模型页面及所报告的mllama加载错误。
- LLaVA项目页面 — LLaVA 1.5和1.6模型卡、架构详情及训练数据集描述。
- Ollama上的MiniCPM-V和Hugging Face上的OpenBMB — 模型卡和OCR基准。
- Ollama上的Moondream和GitHub上的Moondream — 模型下载和推理脚本。
- Hugging Face上的InternVL 2.5 — OpenGVLab模型卡及文档和UI任务基准得分。
- Ollama文档 — 视觉模型支持、结构化输出、API参考和模型库。
- Hugging Face上的PaliGemma 2 — Google PaliGemma 2 3B模型卡。
- Hugging Face上的SmolVLM — HuggingFace SmolVLM模型卡及推理说明。
- llama.cpp多模态文档 — 支持的视觉模型及llama-server用法。
- vLLM支持的模型 — vLLM可部署的多模态架构。
- Ollama上的Gemma 4标签 — q4_K_M、q8_0、bf16、QAT和MLX构建的大小。