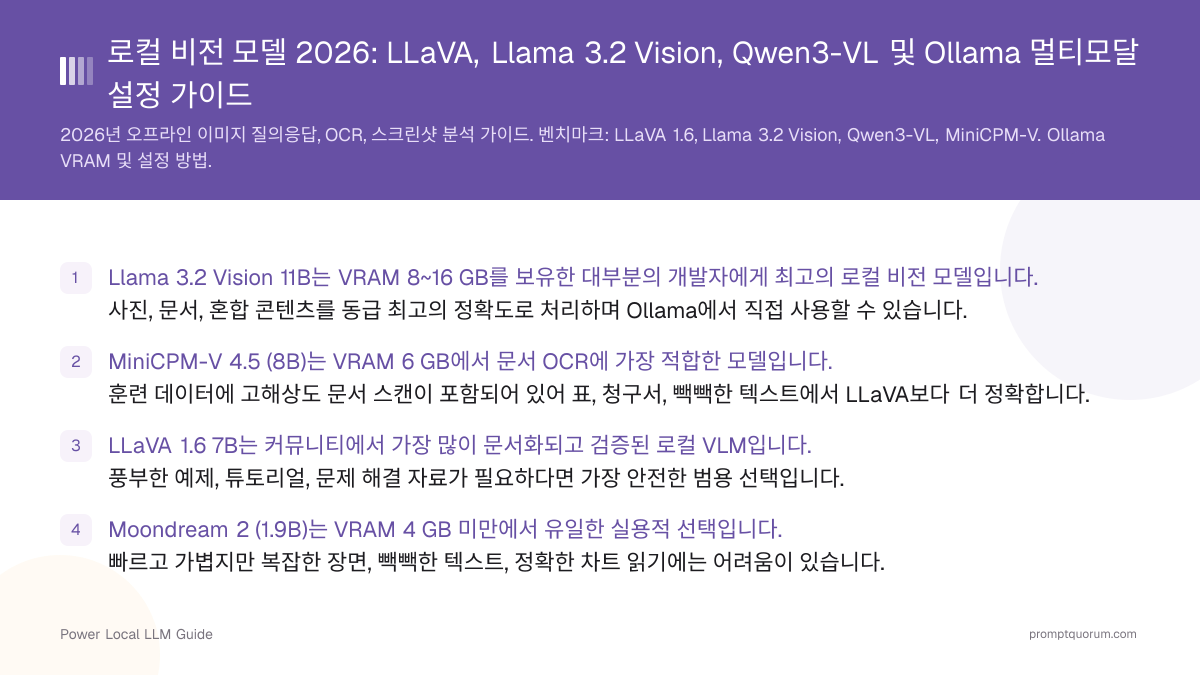
빠른 사실
- VLM의 역할: 이미지 + 텍스트를 입력으로 받아 텍스트를 출력합니다. 이미지 생성 모델이 아니라, 이미지를 *이해*하는 모델입니다.
- Ollama 지원: Gemma 4, Qwen3.8, Qwen3.5, Qwen3-VL, Llama 3.2 Vision, MiniCPM-V, LLaVA, Moondream은 Ollama 공식 라이브러리에 있으며, InternVL, PaliGemma 2, SmolVLM은 커뮤니티 빌드가 필요합니다.
- 가장 작은 사용 가능 모델: Moondream 2 (1.8B, 다운로드 1.7 GB), Qwen3-VL 2B (1.9 GB), Qwen3.5 0.8B (1.2–1.3 GB).
- 가장 큰 실용적 로컬 모델: 64 GB 이상 통합 메모리(Apple M-series 또는 멀티 GPU)에서 Qwen3.5 122B (81 GB)와 Llama 3.2 Vision 90B (55 GB). Qwen3-VL 235B는 143 GB가 필요합니다.
- 이미지 입력 형식: JPEG, PNG, WebP 지원. 최대 해상도는 모델별로 다름 (일반적으로 1024×1024~4096×4096).
- 오디오 및 동영상: Gemma 4 E2B, E4B, 12B는 오디오도 입력받으며, 모든 Gemma 4 크기와 Qwen3.8은 동영상을 프레임으로 처리합니다.
- OCR 정확도: Qwen3.8 27B ≈ Qwen3-VL 8B ≈ Qwen3.5 9B > Gemma 4 > MiniCPM-V > LLaVA 1.6 13B > LLaVA 1.6 7B > Moondream 2.
- 멀티모달 ≠ 빠름: 비전 모델은 LLM에 시각 인코더를 추가하므로, 같은 파라미터 수의 텍스트 전용 모델보다 토큰 생성이 약 30~60% 느립니다.
비전-언어 모델(VLM)이란 무엇입니까?
비전-언어 모델(VLM)은 이미지와 텍스트 입력을 동시에 처리하고 텍스트를 출력하는 신경망입니다. 표준 아키텍처는 시각 인코더(주로 CLIP 또는 SigLIP)와 언어 디코더(LLM)를 결합하며, 이미지 특징을 LLM이 이해하는 토큰 공간에 매핑하는 프로젝션 레이어로 연결됩니다.
- 이미지 생성 모델과의 차이: Stable Diffusion, FLUX, DALL-E 3는 텍스트에서 이미지를 생성하는 모델입니다. VLM은 이미지에서 텍스트를 생성하는 모델로, 이미지를 묘사하고 분석하며 질문에 답변합니다.
- 전통적인 OCR 도구와의 차이: 전통적인 OCR(Tesseract, PaddleOCR)은 패턴 인식으로 구조화된 문서에서 텍스트를 추출합니다. VLM은 문맥을 이해합니다 — 표의 의미를 설명하고, 차트에 대한 질문에 답하며, 사진의 객체를 식별할 수 있습니다.
- 로컬 실행의 이유: 개인 문서(의료 기록, 법적 문서, 재무제표), 독점적 스크린샷(내부 대시보드, 소스 코드), 또는 클라우드 API에 이미지를 전송하는 것이 컴플라이언스나 기밀 문제를 야기하는 모든 워크플로우.
- 할 수 없는 것: 이미지 생성, 스크린샷에 표시된 코드 실행, 인터넷 접속. VLM은 이미지에서 보이는 것을 기반으로 텍스트만 출력합니다.
로컬 비전 모델 비교표
Ollama 또는 직접 추론을 통해 사용 가능한 가장 뛰어난 로컬 비전 모델 비교(2026년 10월 23일 확인). VRAM 열은 Ollama 다운로드 크기(별도 표시가 없는 한 4비트 양자화)이며, 컨텍스트용으로 1–2 GB를 더하십시오. *Llama 3.2 Vision은 최근 Ollama 버전에서 로드에 실패한다고 보고되었습니다(아래 Llama 3.2 Vision 참고 사항 참조).
📍 한 문장으로
VRAM 8 GB: Gemma 4 E4B 또는 Qwen3-VL 8B, 24 GB: Gemma 4 26B/31B 또는 Qwen3.8 27B — 모두 Ollama를 통해 로컬에서 실행 가능합니다.
💬 쉽게 말하면
Gemma 4는 전반적 최고 모델이고, Qwen3-VL, Qwen3.5, Qwen3.8은 문서 OCR과 다국어 텍스트를 선도하며, Moondream과 Qwen3.5 2B는 VRAM 4 GB 미만의 경량 옵션입니다.
모델 | 파라미터 | VRAM (Q4) | 이미지 유형 | 품질 | Ollama 지원? |
|---|---|---|---|---|---|
| Moondream 2 | 1.8B | ~2 GB | 단순 사진 | 기본 | 예 |
| SmolVLM 2.2B | 2.2B | ~2 GB | 단순 사진, 설명 | 기본+ | 커뮤니티 |
| Qwen3.5 2B | 2B | 2.7–3.1 GB | 사진, 문서, OCR | 좋음 | 예 |
| PaliGemma 2 3B | 3B | ~3 GB | 사진, 문서 | 좋음 | 커뮤니티 |
| Qwen3-VL 4B | 4B | 3.3 GB | 사진, 문서, OCR | 좋음 | 예 |
| Gemma 4 E2B | 2.3B 유효 | 4.6–7.5 GB | 사진, 문서, 오디오 | 좋음 | 예 |
| LLaVA 1.6 7B | 7B | ~6 GB | 사진, 문서, 차트 | 좋음 | 예 |
| MiniCPM-V | 8B | ~6 GB (5.5 GB pull) | 사진, 문서, OCR | 매우 좋음 | 예 |
| Qwen3-VL 8B | 8B | ~6.2 GB | 사진, 문서, OCR, 다국어 | 우수 | 예 |
| Qwen3.5 9B | 9B | 6.6–7.6 GB | 사진, 문서, OCR, 다국어 | 우수 | 예 |
| Gemma 4 E4B | 4.5B 유효 | 6.6–9.5 GB | 사진, 문서, 오디오 | 매우 좋음 | 예 |
| Gemma 4 12B | 12B | 7.7–8.0 GB | 사진, 문서, 오디오 | 우수 | 예 |
| InternVL 2.5 8B | 8B | ~8 GB | 문서, 차트, UI, 코드 | 우수 (UI/차트) | 커뮤니티 |
| Llama 3.2 Vision 11B | 11B | ~8 GB (7.8 GB pull) | 사진, 문서 | 우수* | 예* |
| LLaVA 1.6 13B | 13B | ~10 GB | 사진, 문서, 차트 | 매우 좋음 | 예 |
| Gemma 4 26B A4B | 26B (4B 활성) | 16–19 GB | 사진, 문서, 복잡한 콘텐츠 | 우수 | 예 |
| Qwen3.8 27B | 27B | 18 GB | 사진, 문서, 동영상, OCR | 최고 (오픈소스) | 예 |
| Gemma 4 31B | 31B | 19–20 GB | 사진, 문서, 복잡한 콘텐츠 | 우수 | 예 |
| Qwen3-VL 32B | 32B | 21 GB | 사진, 문서, OCR, 복잡한 콘텐츠 | 우수 | 예 |
| Llama 3.2 Vision 90B | 90B | 55 GB | 사진, 문서, 복잡한 콘텐츠 | 매우 좋음* | 예* |
| Qwen3.5 122B | 122B | 81 GB | 사진, 문서, 복잡한 콘텐츠 | 로컬 최고 | 예 |
예시 비교: 청구서 추출
구조화된 문서 추출 작업에서 로컬 비전 모델의 정확도를 보여 주는 예시 비교: 샘플 청구서 한 장에서 5개 필드(공급업체명, 날짜, 합계, 세금 금액, 항목 수)를 추출. 이는 PromptQuorum의 벤치마크가 아닙니다. 기기, 런타임 버전, 모델 태그, 양자화, 프롬프트, 실행 횟수가 기록되지 않았으므로 표시는 참고용이며 재현할 수 없습니다. *가 붙은 행은 사용 중인 Ollama 버전에서 모델이 로드된다는 전제입니다.
모델 | 공급업체 | 날짜 | 합계 | 세금 | 항목 수 | 점수 |
|---|---|---|---|---|---|---|
| Moondream 2 | ✓ | ✓ | ✗ | ✗ | ✗ | 2/5 |
| LLaVA 1.6 7B | ✓ | ✓ | ✓ | ✗ | ✓ | 4/5 |
| MiniCPM-V | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Qwen3-VL 8B | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Llama 3.2 Vision 11B* | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| GPT-5.5 Vision | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
📌참고: 샘플 청구서 한 장이며 기록된 방법론이 없으므로 표시를 근거가 아닌 예시로 읽으십시오. 실제 정확도는 문서 품질, 서체, 디자인 복잡도에 따라 달라집니다. 추출된 숫자는 항상 원본 문서와 대조하여 확인하십시오.
다중 이미지 지원
모든 로컬 비전 모델이 단일 요청에서 여러 이미지를 허용하는 것은 아닙니다. 다중 이미지 지원은 문서 처리(여러 페이지 PDF의 모든 페이지 전송)와 시각적 비교 작업(두 제품 사진 비교)에 중요합니다.
- MiniCPM-V는 프롬프트당 최대 4개 이미지를, Qwen3-VL은 최대 8개 이미지를 허용합니다. LLaVA와 Moondream은 요청당 이미지 1개만 허용합니다.
- 다중 이미지가 중요한 경우: 완전한 문서 추출을 위해 여러 페이지 PDF의 모든 페이지 전송. 두 제품 사진을 나란히 비교. 단일 프롬프트에서 변경 전/후 스크린샷 분석.
기능 | Moondream | LLaVA 7B | MiniCPM-V | Qwen3-VL | LLaVA 13B | Llama 3.2 Vision | InternVL |
|---|---|---|---|---|---|---|---|
| 다중 이미지 입력 | 아니오 | 아니오 | 예 (최대 4) | 예 (최대 8) | 아니오 | 예 (다중 페이지) | 예 |
Ollama 설정 — 단계별 가이드
Ollama는 로컬 비전 모델을 실행하는 가장 간편한 방법입니다. Ollama를 설치하면 비전 모델이 단일 pull 명령어로 동작하며 CLI 플래그나 HTTP API를 통해 이미지를 받을 수 있습니다.
- 1단계 — Ollama 설치: macOS, Linux 또는 Windows용 파일을 ollama.com에서 다운로드하십시오. 설치에 2분 미만이 소요됩니다.
- 2단계 — 비전 모델 다운로드: 8 GB 그래픽카드에는
ollama pull gemma4:e4b(다운로드 6.6–9.5 GB), OCR에는ollama pull qwen3-vl:8b(6.2 GB), VRAM이 적은 환경에는ollama pull moondream(1.8B, 1.7 GB). - 3단계 — CLI에서 사용:
ollama run gemma4:e4b "What is in this image? /path/to/photo.jpg"— 이미지 경로를 프롬프트 안에 넣으십시오.ollama run에는--image플래그가 없습니다. - 4단계 — HTTP API 사용:
http://localhost:11434/api/generate에 POST 요청을 보내고images배열에 Base64 인코딩된 이미지 문자열을 포함시키십시오.format필드에 JSON 스키마를 추가하면 구조화된 출력을 받을 수 있습니다. - 5단계 — Python 예제: Base64 인코딩과 함께
requests라이브러리 사용 — 아래 코드 블록을 참조하십시오.
import base64
import requests

def ask_vision_model(image_path: str, prompt: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")

    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": prompt,
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

# 사용 예시
result = ask_vision_model("청구서.png", "이 청구서에서 모든 항목과 합계를 추출하십시오.")
print(result)
활용 사례 1: OCR 및 문서 추출
VLM은 반구조화된 문서에서 전통적인 OCR보다 우수한 성능을 발휘합니다 — 청구서, 영수증, 계약서, 텍스트 자체만큼 레이아웃이 중요한 표. 전통적인 OCR(Tesseract)은 문자를 추출하지만, VLM은 문맥에서 그 문자들이 의미하는 바를 이해합니다.
- 잘 작동하는 경우: 스캔된 청구서, PDF 스크린샷, 인쇄체 손글씨 메모, 명확한 테두리가 있는 표, 명함.
- 잘 작동하지 않는 경우: 필기체 손글씨, 150 DPI 미만의 스캔, 과도한 압축 JPEG, 겹친 텍스트.
- OCR 최적 모델: Qwen3-VL 8B와 Qwen3.5 9B (6~8 GB 급), Qwen3.8 27B (18 GB, 모델 카드 기준 OmniDocBench 1.5에서 91.1), 혼합 문서 유형에는 Gemma 4.
- OCR 프롬프트 엔지니어링: "줄바꿈을 유지하면서 이 문서의 모든 텍스트를 정확히 추출하십시오." 또는 "이 청구서의 내용을 다음 필드가 있는 JSON으로 반환하십시오: 공급업체, 날짜, 항목[], 합계."
- 전통적인 OCR 대비: VLM은 더 느리지만 더 의미론적입니다. Tesseract는 깨끗한 문서의 순수한 텍스트 추출에 더 빠릅니다. 단순 일반 텍스트가 아닌 구조화된 데이터 추출이 필요할 때 VLM을 사용하십시오.
활용 사례 2: 이미지 질의응답
일반적인 장면 이해, 제품 설명, 시각적 질의응답에는 Gemma 4(8 GB에서는 E4B, 24 GB에서는 26B 또는 31B)가 권장 로컬 모델입니다. 자연스럽고 상세한 설명을 생성하며 사진 내용에 대한 미묘한 질문도 처리합니다.
- 장면 설명: "이 사진에 무엇이 있습니까?" — 객체, 사람, 활동, 환경, 분위기.
- 제품 카탈로그 작성: 프롬프트 템플릿으로 제품 사진 처리: "이 제품을 설명하십시오: 색상, 형태, 소재, 상태." 클라우드 API 없이 전자상거래 재고 관리에 유용.
- 접근성: 이미지에 대한 대체 텍스트를 대규모로 생성합니다. 표준 제품 사진의 접근성 컴플라이언스에 충분한 정확도를 제공합니다.
- 최적 모델: 일반 사진 질의응답에는 Gemma 4 12B 또는 26B A4B. 정확도보다 속도가 중요한 대량 처리에는 Qwen3.5 4B 또는 LLaVA 1.6 7B.
- 속도 고려사항: 속도는 모델, GPU, 설명 길이에 따라 달라집니다 — 수천 건을 일괄 처리하기 전에 사용 중인 하드웨어에서 이미지 20장 샘플로 먼저 벤치마크하십시오.
활용 사례 3: 스크린샷 및 UI 분석
애플리케이션 스크린샷, 오류 메시지, 대시보드 분석에는 InternVL 2.5가 가장 강력한 로컬 모델입니다 — 훈련 데이터에 소프트웨어 UI, GitHub 스크린샷, 코드 실행 결과가 강조되어 있습니다.
- 개발자 워크플로우: 오류 메시지 스크린샷을 모델에 전송: "이 스크린샷에서 무엇이 잘못되었으며 어떻게 수정하겠습니까?"
- 버그 리포트 생성: 구조화된 프롬프트로 스크린샷에서 버그 설명을 자동 생성합니다.
- 대시보드 모니터링: 모니터링 대시보드 스크린샷에서 이상 징후 분석 — "이 Grafana 스크린샷에서 경고 수준에 있는 지표가 있습니까?"
- 접근성 테스트: UI 변경 전/후 스크린샷을 비교하여 시각적 접근성 속성을 확인합니다.
- 최적 모델: InternVL 2.5 8B (커뮤니티 빌드, UI에 강함), Gemma 4와 Qwen3-VL (Ollama 공식 지원, 에이전트 워크플로우용 도구 호출).
활용 사례 4: 차트 및 다이어그램 읽기
막대형, 선형 차트, 표에서 데이터를 추출하는 것은 가능하지만 신중한 프롬프팅이 필요합니다. 모든 로컬 VLM은 사진 설명보다 차트 읽기에서 약합니다 — 항상 차트에서 추출한 숫자를 원본 데이터와 대조하여 확인하십시오.
- 잘 작동하는 경우: 축 레이블 읽기, 추세 파악, 막대의 상대적 높이 비교, 명확한 폰트가 있는 표 값 읽기.
- 신뢰할 수 없는 경우: 연속형 차트에서의 정밀한 수치 추출 (예: "3분기 막대는 43.7 단위"), 명시적 레이블이 없는 파이 차트 백분율.
- 프롬프트 전략: "이 선형 차트에 표시된 추세를 설명하십시오"가 "2026년 3월의 정확한 값은 무엇입니까?"보다 효과적입니다.
- 차트 최적 모델: InternVL 2.5 (강력한 차트 이해), Gemma 4와 Qwen3-VL (명확한 레이블이 있는 차트에 우수).
- 제한 사항 참고: 2026년의 어떤 로컬 VLM도 시각적으로 복잡한 차트에서 정밀한 숫자를 신뢰할 수 있게 추출하지 못합니다. 구조화된 차트 데이터가 필요하다면 가능한 경우 기본 데이터 소스에서 추출하십시오.
활용 사례 5: 동영상 프레임 분석
로컬 비전 모델은 개별 프레임을 처리하여 동영상을 분석할 수 있습니다 — ffmpeg으로 프레임을 추출하고, 비전 모델에 전송하여 분석한 다음, 텍스트 LLM으로 프레임 간 요약을 생성합니다. 실시간이 아님: 모델과 하드웨어에 따라 프레임당 0.5~3초를 예상하십시오.
- 프레임 추출: ffmpeg으로 1fps 추출:
ffmpeg -i video.mp4 -vf fps=1 frames/frame_%04d.jpg - 프레임별 분석: 일관된 프롬프트로 각 프레임을 비전 모델에 실행 (예: "이 프레임에서 무슨 일이 일어나고 있는지 한 문장으로 설명하십시오").
- 프레임 간 요약: 모든 프레임 설명을 수집하여 요약 프롬프트와 함께 텍스트 LLM에 전달합니다.
- 활용 사례: 보안 카메라 검토 (비정상적인 활동이 있는 프레임 표시), 강의 녹화 분석 (슬라이드별 노트 생성), 제조 품질 검사 (결함이 나타나는 프레임 표시).
- 동영상 프레임 최적 모델: 품질에는 Gemma 4 또는 Qwen3.8 (둘 다 동영상을 프레임으로 기본 처리), 속도에는 Qwen3.5 4B 또는 LLaVA 1.6 7B (더 높은 프레임 처리량).
- 속도 현실: 1fps 추출과 프레임당 약 1~3초 추론 기준으로, 10분 동영상(600프레임)의 처리에는 모델과 GPU에 따라 대략 10~30분이 소요됩니다.
import base64
import subprocess
import os
import requests

def extract_frames(video_path: str, output_dir: str, fps: int = 1) -> list[str]:
    os.makedirs(output_dir, exist_ok=True)
    subprocess.run([
        "ffmpeg", "-i", video_path,
        "-vf", f"fps={fps}",
        f"{output_dir}/frame_%04d.jpg",
        "-y"
    ], check=True)
    return sorted([
        os.path.join(output_dir, f)
        for f in os.listdir(output_dir)
        if f.endswith(".jpg")
    ])

def analyze_frame(image_path: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")
    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": "이 프레임에서 무슨 일이 일어나고 있는지 한 문장으로 설명하십시오.",
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

frames = extract_frames("강의.mp4", "frames/", fps=1)
descriptions = [analyze_frame(f) for f in frames]
print("
".join(f"[{i+1}초] {d}" for i, d in enumerate(descriptions)))
VRAM 및 실제 성능 확인
로컬 비전 모델은 기본 LLM에 시각 인코더를 추가하여 텍스트 전용 모델에 비해 VRAM 요구 사항과 추론 시간이 모두 증가합니다.
모델 | VRAM (Q4) | 토큰/초 (RTX 4070) | 토큰/초 (M5 Pro 36GB) | 프로덕션 적합? |
|---|---|---|---|---|
| Moondream 2 (1.8B) | ~2 GB | ~25–35 | ~30–40 | 예 — 단순 작업에 |
| LLaVA 1.6 7B | ~6 GB | ~15–20 | ~18–25 | 예 — 범용 |
| MiniCPM-V (8B) | ~6 GB | ~12–18 | ~15–20 | 예 — OCR 및 문서 |
| Llama 3.2 Vision 11B | ~8 GB | ~10–14 | ~12–16 | Ollama 로드 문제 먼저 확인 |
| LLaVA 1.6 13B | ~10 GB | ~8–12 | ~10–14 | 예 — 12 GB GPU에서 |
| Llama 3.2 Vision 90B | 55 GB | N/A (멀티 GPU 또는 M-Max 필요) | N/A (M5 Max 128GB+ 필요) | 고급 Apple Silicon에서만 |
📌참고: 초당 토큰 범위는 대략적인 추정치이며 새로 측정한 값이 아닙니다. Gemma 4, Qwen3.5, Qwen3.8에 대해서는 다시 측정하지 않았습니다. ollama run <model> --verbose로 사용 중인 하드웨어에서 직접 벤치마크하면 평가 속도(eval rate)가 출력됩니다.
📌참고: 비전 모델의 토큰 생성 속도는 같은 크기의 텍스트 전용 모델보다 느립니다. 시각 인코더가 첫 번째 이미지 토큰에서 상당한 계산 오버헤드를 추가하기 때문입니다. 이후 텍스트 토큰은 거의 정상 속도로 생성됩니다.
📌참고: Apple Silicon의 통합 메모리는 전용 GPU VRAM에 맞지 않는 더 큰 모델(128 GB Mac에서 Llama 3.2 Vision 90B는 55 GB, Qwen3.5 122B는 81 GB)을 실행할 수 있게 합니다. 속도는 동급 NVIDIA GPU보다 약간 낮지만 VRAM 제한이 없습니다.
로컬 비전 모델 vs GPT-5.5 Vision 비교
로컬 VLM은 구조화된 문서에서 격차를 크게 좁혔지만, 복잡하고 모호한 작업에서는 여전히 GPT-5.5 Vision에 뒤처집니다. 아래 비교는 편집부의 판단이며 PromptQuorum의 벤치마크가 아닙니다.
- 구조화된 문서 (청구서, 양식): 측정한 벤치마크가 아닌 편집부의 판단입니다. 우수한 로컬 모델은 깨끗하고 형식이 잘 갖춰진 문서에서 GPT-5.5 Vision에 근접하며, 출력을 검증한다면 프로덕션 사용에 충분합니다.
- 복잡한 장면, 모호한 이미지: 비정상적인 맥락, 어려운 조명 또는 모호한 내용의 이미지에서는 로컬 모델이 GPT-5.5 Vision에 눈에 띄게 뒤처집니다(편집부 판단이며 측정값이 아닙니다).
- 손글씨 인식: 로컬 모델은 특히 필기체에서 크게 약합니다. GPT-5.5 Vision은 손글씨 처리가 실질적으로 더 우수합니다.
- 차트 데이터 추출: 로컬 모델과 GPT-5.5 모두에서 신뢰할 수 없지만, GPT-5.5는 정확한 수치에서 더 정확합니다.
- 비용: GPT-5.5 Vision이 이미지당 $0.01~0.03 vs 로컬에서 $0. 월 10,000개 이미지 = 로컬 모델로 $100~300 절약.
- 개인정보 보호: 로컬 모델은 기본적으로 기기 내에서 이미지를 처리하므로, 클라우드 기능이나 연결형 도구를 켜지 않는 한 이미지가 클라우드 API로 전송되지 않습니다. GPT-5.5는 이미지를 OpenAI 서버로 전송합니다.
- 속도: 로컬 모델은 RTX 4070에서 크기에 따라 대략 8~35 토큰/초를 냅니다(참고용 추정치, 위 표 참조). 클라우드 속도는 제공업체와 부하에 따라 달라지지만, 배치 처리 시 로컬은 네트워크 지연이 없습니다.
📌참고: 깨끗한 입력으로 청구서와 양식을 프로덕션에서 처리하는 경우, 로컬 VLM(Gemma 4, Qwen3-VL 8B, Qwen3.8 27B)은 비용 없이 GPT-5.5 Vision을 대체할 수 있습니다. 손글씨, 복잡한 장면 분석, 모호한 내용이 포함된 모든 것에는 GPT-5.5가 여전히 우수합니다.
LLaVA 심층 분석
LLaVA(Large Language and Vision Assistant)는 기본적인 오픈소스 VLM 아키텍처입니다. 2023년 위스콘신-매디슨 대학교와 Microsoft Research가 출시하여 대부분의 현대 로컬 VLM이 따르는 CLIP 인코더 + LLM 디코더 패턴을 확립했습니다.
- 아키텍처: CLIP ViT-L/14 시각 인코더 + Llama-2 또는 Mistral 텍스트 디코더, 단순한 선형 프로젝션 레이어로 연결.
- LLaVA 1.5 vs 1.6: 버전 1.6(2024년 초 출시)은 동적 패치를 통해 고해상도 입력 지원을 추가하여 OCR 정확도와 차트 읽기가 크게 향상되었습니다.
- 훈련: LLaVA-Instruct-150K에서 지시 튜닝 — 이미지 설명과 객체 감지 주석에서 생성된 시각적 대화 데이터셋.
- 강점: 광범위한 일반 지식, 잘 문서화됨, 대규모 커뮤니티, 광범위한 Ollama 통합.
- 약점: Qwen3-VL 및 MiniCPM-V보다 약한 OCR, InternVL 2.5보다 약한 UI 분석, 전반적으로 Gemma 4와 Qwen3 계열에 뒤처짐.
- 여전히 권장되는 이유: LLaVA 1.6은 모든 로컬 VLM 중에서 가장 큰 커뮤니티, 가장 많은 튜토리얼, 가장 많은 프롬프트 예제를 보유하고 있습니다. 문제가 있을 경우 도움을 찾기가 더 쉽습니다.
- 전체 리뷰: LLaVA 리뷰(2026) — Apache-2.0과 기본 모델 라이선스의 미묘한 차이, 실제 Ollama 명령어를 다루는 PromptQuorum의 전용 리뷰.
Qwen3-VL, Qwen3.5, Qwen3.8 — 최고의 다국어 OCR 및 문서 성능
Qwen 계열은 2026년 문서 OCR과 다국어 텍스트에서 가장 강력한 오픈 옵션입니다. Qwen3-VL(2B~235B)은 전용 비전 라인이고, Qwen3.5(0.8B~122B)는 비전을 기본 모델에 통합했으며, Qwen3.8 27B(2026년 8월, Apache 2.0)는 가장 최신으로 OmniDocBench 1.5에서 91.1을 기록했다고 보고되었습니다.
- 아키텍처: 최대 4096×4096의 동적 해상도 지원 — LLaVA 1.6(672×672)이나 Llama 3.2 Vision(1120×1120)보다 크게 높습니다. 이를 통해 다운샘플링 없이 고DPI 스캔을 읽을 수 있습니다.
- 다국어 OCR: 중국어, 일본어, 한국어, 영어에서 동급 최고 성능. 훈련 데이터에 대규모 다국어 문서 코퍼스가 포함되어 영어 이외의 문서에서 LLaVA 및 Llama 3.2 Vision 대비 상당한 이점을 제공합니다.
- 크기 선택: Qwen3-VL 8B는 6.2 GB 다운로드로 8 GB 그래픽카드에 적합하고, Qwen3.5 9B는 6.6–7.6 GB, Qwen3.8 27B는 18 GB로 24 GB 카드가 필요하며, Qwen3-VL 32B는 21 GB입니다. Ollama에는 Qwen3-VL 72B 변형이 없습니다.
- Qwen3-VL 4B: 다운로드 3.3 GB(256K 컨텍스트)로, VRAM 약 4–6 GB 카드를 위한 2B(1.9 GB)와 8B(6.2 GB) 사이의 중간 선택지입니다.
- Ollama 설치:
ollama pull qwen3-vl:8b,ollama pull qwen3.5:9b또는ollama pull qwen3.8— 모두 Ollama 모델 라이브러리에서 사용 가능. - 다중 이미지 지원: 요청당 최대 8개 이미지 허용 — 이 비교의 모든 모델 중 가장 높은 다중 이미지 용량.
- 모델 페이지: Qwen3-VL on Ollama, Qwen3.8-27B on Hugging Face
비전 모델 선택 방법
적절한 로컬 비전 모델을 선택하기 위한 VRAM 기반 의사결정 트리:
📍 한 문장으로
먼저 VRAM(2→4→8→24 GB)을 기준으로 모델을 선택한 다음 활용 사례(OCR, UI, 일반 질의응답 또는 최고 품질)에 따라 세분화하십시오.
💬 쉽게 말하면
VRAM 4 GB 미만: Qwen3.5 2B 또는 Moondream. 8 GB: 사진에는 Gemma 4 E4B, 문서에는 Qwen3-VL 8B. 24 GB: Gemma 4 26B/31B 또는 Qwen3.8 27B. 64+ GB: Qwen3.5 122B.
- VRAM 4 GB 미만: Qwen3.5 2B (2.7–3.1 GB), Qwen3-VL 2B (1.9 GB) 또는 Moondream 2 (1.7 GB)가 실용적인 옵션입니다. PaliGemma 2 (3B)와 SmolVLM (2.2B)은 커뮤니티 빌드 대안입니다. 빽빽한 텍스트 OCR에는 적합하지 않습니다.
- VRAM 6~8 GB: 일반 사진 질의응답에는 Gemma 4 E4B, 문서 OCR과 다국어 텍스트에는 Qwen3-VL 8B 또는 Qwen3.5 9B, 커뮤니티 지원이 중요하다면 LLaVA 1.6 7B.
- VRAM 12~16 GB: Gemma 4 12B(다운로드 7.7–8.0 GB)가 명확한 권장 사항 — 크기 대비 강력한 비전 점수에 오디오 입력과 256K 컨텍스트 윈도우를 갖췄습니다. LLaVA 1.6 13B와 InternVL 2.5 8B(UI 및 코드 스크린샷)도 사용할 수 있습니다.
- VRAM 24 GB: Gemma 4 26B A4B (16–19 GB), Gemma 4 31B (19–20 GB), Qwen3.8 27B (18 GB) 또는 Qwen3-VL 32B (21 GB) — 클라우드 수준 비전 품질에 가장 가까운 로컬 옵션.
- 통합 메모리 64+ GB (Apple M-Max/Ultra, 멀티 GPU): 가장 큰 로컬 모델인 Qwen3.5 122B (81 GB) 또는 Llama 3.2 Vision 90B (55 GB). 둘 다 대용량 메모리 하드웨어가 필요하며 24 GB 급 모델보다 토큰당 속도가 느립니다.
- 항상 숫자를 확인하십시오: 모델에 관계없이 차트나 표에서 추출한 수치는 원본 데이터와 대조하여 확인하십시오. 로컬 VLM은 시각적 차트에서 정확한 수치를 환각합니다.
자주 묻는 질문
llama3.2-vision이 "unknown model architecture: mllama" 오류로 실패하는 이유는 무엇입니까?
최근 Ollama 버전에서 llama3.2-vision 사용 시 이 오류가 보고되고 있습니다(GitHub 이슈 #16490, #16547, 2026년 중반에 등록되었으며 두 번째 이슈는 중복으로 닫혔고 확인된 해결책은 없습니다). 해당 보고에서는 Ollama를 업데이트하거나 모델을 다시 받아도 해결되지 않았습니다. Llama 3.2 Vision을 꼭 써야 하는 경우가 아니라면 Ollama 라이브러리에서 활발히 관리되는 Gemma 4 또는 Qwen3-VL로 전환하십시오. 꼭 써야 한다면 여전히 로드되는 Ollama 버전으로 고정하십시오.
3B 파라미터 미만에서 가장 좋은 소형 비전-언어 모델은 무엇입니까?
Qwen3.5 2B(다운로드 2.7–3.1 GB)와 Qwen3-VL 2B(1.9 GB)가 Ollama에서 가장 강력한 소형 옵션이며, Moondream 2(1.8B, 1.7 GB)가 가장 가볍습니다. Gemma 4 E2B(유효 파라미터 2.3B, 다운로드 4.6–7.5 GB)는 오디오 입력을 추가로 지원합니다. 8B 급보다는 OCR과 복잡한 장면 이해가 약할 것으로 예상하십시오.
실시간 카메라와 마이크 입력을 처리할 수 있는 로컬 모델은 무엇입니까?
Gemma 4 E2B, E4B, 12B는 이미지와 오디오를 모두 입력받으므로 보고 듣는 로컬 어시스턴트의 자연스러운 기반이 됩니다. 다만 모델 자체가 실시간 시스템은 아닙니다. 캡처 루프(프레임 수집, 오디오 분할), 음성 인식 또는 오디오 입력 경로, 음성 응답을 위한 음성 합성(TTS) 단계가 여전히 필요합니다. 구축하기 전에 사용 중인 런타임 버전이 실제로 모델에 오디오를 전달하는지 확인하십시오.
스크린샷과 문서에서 신뢰할 수 있는 구조화된 출력을 얻으려면 어떻게 해야 합니까?
Ollama의 format 필드에 JSON 스키마를 전달하고, temperature를 0으로 설정하며, 이미지에 보이는 필드만 요청하십시오. 이렇게 하면 응답이 지정한 키를 가진 유효한 JSON으로 제한되지만 값이 정확해지는 것은 아니므로, 숫자와 날짜를 원본과 대조하여 확인하고 실패를 기록하십시오. 8B 이상의 큰 모델이 2B 모델보다 스키마를 더 일관되게 따릅니다.
완전히 기기 내에서 실행되는 최고의 GPT-4V 대안은 무엇입니까?
24 GB GPU에서는 Gemma 4 31B (19–20 GB), Qwen3.8 27B (18 GB), Qwen3-VL 32B (21 GB)가 가장 근접하며, 8 GB 환경에서는 Gemma 4 E4B와 Qwen3-VL 8B가 적합합니다. 모두 Ollama를 통해 오프라인으로 실행됩니다. 깨끗한 문서와 사진에서는 클라우드 모델에 필적하지만 손글씨, 모호한 장면, 복잡한 인포그래픽에서는 뒤처집니다.
Ollama 없이 LLaVA 또는 Llama 3.2 Vision을 사용할 수 있습니까?
예. llama.cpp(비전 지원 포함), transformers 라이브러리(적절한 모델 카드 포함), 또는 LM Studio(비전 모델용 GUI 포함)를 사용하여 LLaVA 및 Llama 3.2 Vision을 직접 실행할 수 있습니다. Ollama는 단순성 때문에 권장됩니다 — 모델 다운로드, 양자화 선택, API 호스팅을 자동으로 관리합니다.
Llama 3.2 Vision은 PDF 직접 입력을 지원합니까?
어떤 로컬 VLM도 PDF를 직접 받지 않습니다. 먼저 PDF 페이지를 이미지로 변환(pdf2image, pypdfium2 등 사용)한 다음 각 페이지를 별도의 이미지 요청으로 전송해야 합니다. 10페이지 PDF의 경우 10개의 별도 이미지 쿼리를 전송하고 결과를 연결하거나 요약합니다.
로컬 비전 모델은 GPT-5.5 Vision과 어떻게 비교됩니까?
GPT-5.5 Vision은 모호한 장면, 손글씨, 복잡한 인포그래픽, 세계 지식이 필요한 작업에서 여전히 크게 우수합니다. Gemma 4와 Qwen3-VL은 구조화된 문서(청구서, 양식, 선명한 사진)에서 GPT-5.5에 근접하지만 미묘하거나 모호한 이미지에서는 뒤처집니다. 비용, 개인정보 보호, 속도 분석은 위의 전체 비교를 참조하십시오.
로컬 VLM은 어떤 이미지 해상도를 지원합니까?
LLaVA 1.6은 최대 672×672의 실효 해상도를 지원합니다(동적 패치 포함). MiniCPM-V는 최대 1344×1344 (≈1.8 MP)를 지원합니다 — 고DPI 문서 스캔에서 LLaVA를 능가하는 이유 중 하나입니다. Llama 3.2 Vision은 최대 1120×1120을 지원합니다. Gemma 4와 Qwen3-VL은 가변 종횡비와 해상도를 허용합니다. 최상의 OCR 결과를 위해 문서 이미지를 150+ DPI로 전송하십시오.
자체 이미지로 로컬 비전 모델을 파인튜닝할 수 있습니까?
예, 하지만 VLM 파인튜닝은 텍스트 전용 LLM 파인튜닝보다 더 많은 리소스가 필요합니다 — 이미지와 훈련 텍스트 모두 전체 포워드 패스를 통해 처리해야 합니다. LLaVA 파인튜닝은 원본 훈련 코드베이스를 사용하여 잘 문서화되어 있습니다. MiniCPM-V는 Hugging Face의 공식 훈련 스크립트를 통해 파인튜닝을 지원합니다. 대부분의 활용 사례에서는 파인튜닝 없이 프롬프트 엔지니어링만으로 충분합니다.
VRAM 8 GB에 최적인 로컬 비전 모델은 무엇입니까?
범용 사용에는 Gemma 4 E4B(다운로드 6.6–9.5 GB), 문서 OCR이나 다국어 텍스트가 주요 요구 사항이라면 Qwen3-VL 8B(6.2 GB). 두 모델 모두 단일 pull 명령어로 Ollama에서 사용 가능합니다. Qwen3.5 9B(6.6–7.6 GB)가 세 번째 옵션입니다.
LLaVA vs MiniCPM-V — OCR에는 어느 것이 더 낫습니까?
MiniCPM-V는 특히 빽빽한 표와 고DPI 스캔에서 LLaVA보다 문서 OCR이 더 정확하지만, Qwen3-VL 8B는 둘 중 어느 쪽보다 강력한 OCR 선택입니다. LLaVA 1.6은 더 잘 문서화되어 있고 더 많은 커뮤니티 지원이 있습니다. 참고로 Ollama의 minicpm-v 페이지는 여전히 MiniCPM-V 2.6(5.5 GB)을 설명하며, 더 최신 MiniCPM-V 릴리스는 Hugging Face 또는 llama.cpp 빌드가 필요합니다.
로컬 비전 모델이 손글씨를 읽을 수 있습니까?
인쇄체 손글씨(블록 문자): 예, Gemma 4, Qwen3-VL, MiniCPM-V에서 중간 수준의 정확도로 읽을 수 있습니다. 필기체: 모든 로컬 모델에서 신뢰할 수 없습니다. GPT-5.5 Vision은 필기체 처리가 크게 우수합니다. 프로덕션에서 필기체 OCR은 클라우드 API를 여전히 권장합니다.
Ollama 외에 llama.cpp나 vLLM에서 실행되는 로컬 비전 모델은 무엇입니까?
여러 모델이 있습니다. llama.cpp의 멀티모달 문서는 바로 사용할 수 있는 GGUF 빌드로 Gemma 3, Gemma 4(E2B, E4B, 26B A4B, 31B), InternVL 2.5와 3, Moondream 2, SmolVLM 등을 나열하며, llama-server는 이를 OpenAI 호환 API로 제공합니다. vLLM의 지원 모델 페이지에는 Gemma 4, Qwen3-VL, Qwen3.5, MiniCPM-V, InternVL, LLaVA-NeXT가 나와 있습니다. 지원 여부는 모델과 버전에 따라 다르므로, 도입 전에 두 페이지에서 실제로 사용할 모델을 확인하십시오(확인일: 2026년 10월 23일). 다운로드, 양자화, API를 하나의 도구로 처리하므로 Ollama가 여전히 가장 간단한 선택입니다.
양자화는 비전 모델의 VRAM 사용량과 품질을 얼마나 바꿉니까?
양자화는 주로 메모리 사용량을 바꿉니다. Ollama에서 Gemma 4 E4B는 q4_K_M에서 6.6 GB, q8_0에서 9.0 GB, bf16에서 16 GB이고, Gemma 4 31B는 각각 20 GB, 34 GB, 63 GB입니다. 기본 태그는 보통 q4_K_M 크기에 가깝기 때문에 위 표의 VRAM 열은 4비트 기준 수치입니다. Google의 QAT 빌드는 약간 더 작습니다(gemma4:e4b-it-qat는 6.1 GB). 정밀도를 높이면 메모리와 속도를 더 소모하며, 결과가 좋아지는지는 모델과 작업에 따라 다릅니다. 저희는 이를 측정하지 않았으므로 직접 가진 이미지 샘플로 q4_K_M과 q8_0을 비교하십시오. 컨텍스트용으로 1–2 GB를 추가하십시오.
Apple Silicon Mac에서는 어떤 로컬 비전 모델을 실행해야 합니까?
Ollama는 Apple Silicon용 MLX 빌드를 제공합니다: gemma4:e4b-mlx(9.5 GB), gemma4:12b-mlx(7.7 GB), gemma4:26b-mlx(18 GB), gemma4:31b-mlx(19 GB), qwen3.8:27b-mlx(18 GB). 통합 메모리에는 가중치뿐 아니라 macOS와 컨텍스트도 들어가야 합니다. 대략적인 기준은 다음과 같습니다(저희의 용량 가이드이며 벤치마크가 아닙니다). 16 GB Mac에서는 Gemma 4 E4B, Gemma 4 12B 또는 Qwen3-VL 8B(6.2 GB), 24 GB에서는 Gemma 4 12B가 여유롭고 18 GB짜리 26B A4B 빌드는 다른 프로그램을 거의 실행하지 않을 때만 들어갑니다. 32 GB 이상이면 Gemma 4 31B 또는 Qwen3.8 27B를 쓸 수 있습니다.
VRAM 16 GB, RAM 32 GB 또는 2 GB GPU에는 어떤 로컬 비전 모델이 가장 좋습니까?
VRAM 2 GB: Moondream 2(1.7 GB) 또는 Qwen3-VL 2B(1.9 GB), 단순한 이미지에만 적합합니다. 약 4 GB: Qwen3-VL 4B(3.3 GB). VRAM 16 GB: Gemma 4 12B(7.7–8.0 GB), 긴 컨텍스트를 위한 여유도 있습니다. Gemma 4 26B A4B 다운로드(16–19 GB)는 완전히 들어가지 않아 Ollama가 일부 레이어를 시스템 RAM으로 옮기며 느려집니다. VRAM 24–32 GB(예: RTX 5090): Gemma 4 31B, Qwen3.8 27B 또는 Qwen3-VL 32B. GPU 없이 RAM 32 GB만 있으면 모델이 CPU에서 실행됩니다. 8B 급(Qwen3-VL 8B, Gemma 4 E4B)에 머무르고 GPU보다 훨씬 느릴 것으로 예상하십시오.
Gemma 5나 Gemma 4, Qwen3.8보다 최신인 비전 모델이 있습니까?
2026년 10월 23일에 확인한 자료에서는 찾지 못했습니다. Ollama에는 gemma5 페이지가 없고, gemma4 페이지에는 E2B, E4B, 12B, 26B, 31B 빌드가 나열되어 있으며, Qwen3.8 27B는 이 가이드가 다루는 가장 최신 Qwen 모델입니다. 새 모델은 자주 출시되므로 결정하기 전에 Ollama 라이브러리의 비전 모델 목록을 확인하고, 아직 출시되지 않은 모델에 관한 주장은 확인되지 않은 것으로 간주하십시오.
출처
- Gemma 4 model card on Hugging Face — Google의 Apache 2.0 라이선스, 크기별 지원 모달리티, MMMU Pro 결과.
- Gemma 4 on Ollama — 태그, 다운로드 크기, 컨텍스트 윈도우.
- Qwen3.8-27B on Hugging Face — Apache 2.0 라이선스, 262K 컨텍스트, OmniDocBench 1.5 결과.
- Qwen3.5 on Ollama 및 Qwen3-VL on Ollama — 크기와 다운로드 크기.
- Llama 3.2 Vision on Ollama 및 Ollama issue #16547 — 라이브러리 목록과 보고된 mllama 로드 오류.
- LLaVA 프로젝트 페이지 — LLaVA 1.5 및 1.6 모델 카드, 아키텍처 세부 사항, 훈련 데이터셋 설명.
- MiniCPM-V on Ollama 및 OpenBMB on Hugging Face — 모델 카드와 OCR 벤치마크.
- Moondream on Ollama 및 Moondream on GitHub — 모델 다운로드와 추론 스크립트.
- InternVL 2.5 on Hugging Face — OpenGVLab 모델 카드, 문서 및 UI 작업 벤치마크 점수.
- Ollama 문서 — 비전 모델 지원, 구조화된 출력, API 참조, 모델 라이브러리.
- PaliGemma 2 on Hugging Face — Google PaliGemma 2 3B 모델 카드.
- SmolVLM on Hugging Face — HuggingFace SmolVLM 모델 카드 및 추론 지침.
- llama.cpp 멀티모달 문서 — 지원되는 비전 모델과 llama-server 사용법.
- vLLM 지원 모델 — vLLM이 제공할 수 있는 멀티모달 아키텍처.
- Ollama의 Gemma 4 태그 — q4_K_M, q8_0, bf16, QAT, MLX 빌드 크기.