Wichtigste Erkenntnisse
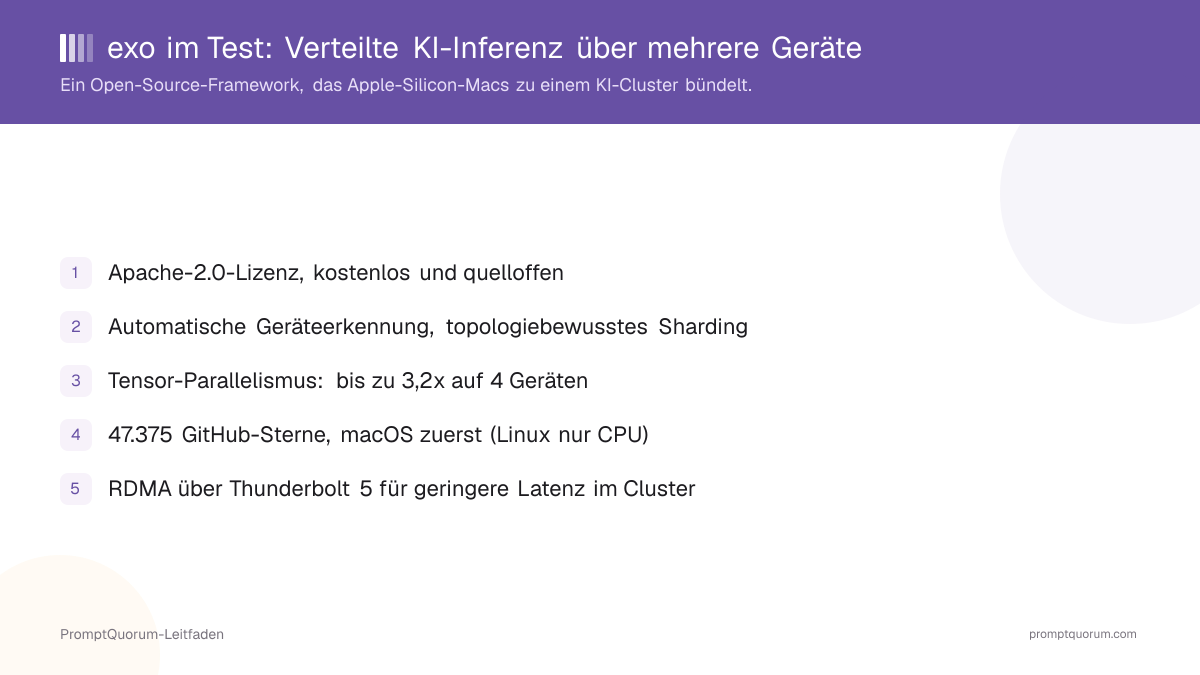
- Kostenlos, quelloffen, Apache-2.0-Lizenz, Copyright Exo Technologies Ltd, laut der eigenen LICENSE-Datei des Repositorys – geprüft am 12.09.2026
- Automatische Geräteerkennung – Geräte, die exo im selben Netzwerk ausführen, finden sich ohne manuelle Konfiguration, laut exos eigenem README
- Topologiebewusster Auto-Parallel-Modus: exo verteilt das Modell auf Basis einer Echtzeitsicht auf die Ressourcen jedes Geräts sowie Latenz/Bandbreite der Netzwerkverbindungen
- Tensor-Parallelismus zusätzlich zum Sharding – bis zu 1,8-facher Speedup auf 2 Geräten und 3,2-facher Speedup auf 4 Geräten, laut exos eigenem README
- RDMA über Thunderbolt 5 (macOS 26.2+), was exo als 99%ige Reduzierung der Latenz zwischen Geräten beschreibt, laut eigener Dokumentation
- Nutzt MLX, Apples Framework für Array-Berechnungen, als Inferenz-Backend und MLX-distributed für die Kommunikation zwischen Geräten
- Kompatibel mit OpenAI-Chat-Completions-, OpenAI-Responses-, Claude-Messages- und Ollama-APIs, sodass bestehende Clients weitgehend unverändert auf einen exo-Cluster zeigen können
- 47.375 GitHub-Sterne, 3.508 Forks, verifiziert über die GitHub-API am 12.09.2026
- macOS (Apple Silicon) ist die primäre, getestete Plattform; Linux läuft aktuell nur mit CPU (GPU-Unterstützung wird laut exos eigener PLATFORMS.md als „in Entwicklung" geführt); Windows wird derzeit nicht unterstützt
📍 In einem Satz
exo ist ein kostenloses, quelloffenes (Apache-2.0) Framework, das mehrere Apple-Silicon-Macs – und, mit reiner CPU-Unterstützung, Linux-Rechner – zu einem verteilten Inferenz-Cluster bündelt und dabei automatische Geräteerkennung sowie topologiebewusstes Model-Sharding nutzt, um Modelle auszuführen, die für ein einzelnes Gerät zu groß sind.
💬 In einfachen Worten
Statt eine sehr teure Maschine mit genug Arbeitsspeicher für ein riesiges Modell zu kaufen oder Cloud-GPU-Zeit zu mieten, lässt exo Sie mehrere bereits vorhandene Macs (oder Linux-Rechner) über das Netzwerk verbinden, sodass sie wie ein größerer Computer agieren und die Layer des Modells automatisch auf alle verteilt werden.
📌Hinweis: Diese Review ist das Begleitstück zu exos Eintrag im lokalen KI-Software-Verzeichnis – dort sehen Sie auf einen Blick, wie exo im Vergleich zu Dutzenden anderer lokaler KI-Tools abschneidet.
Was ist exo?
exo ist ein Framework, das mehrere bereits vorhandene Geräte zu einem KI-Inferenz-Cluster verbindet, sodass Modelle, die zu groß für den Arbeitsspeicher eines einzelnen Geräts sind, trotzdem laufen können, indem das Modell auf die Gruppe aufgeteilt wird. Es wird von exo labs gepflegt; die eigene Repository-Beschreibung lautet schlicht: „Run frontier AI locally."
- Kernfunktion: automatische Geräteerkennung plus topologiebewusstes Model-Sharding – mehrere Geräte auf denselben Cluster ausrichten, exo übernimmt die Aufteilung des Modells
- Inferenz-Backend: MLX, Apples quelloffenes Framework für Array-Berechnungen, sowohl für die Modellausführung als auch für die MLX-distributed-Kommunikationsschicht zwischen Geräten
- Deployment-Modell: aus dem Quellcode (macOS oder Linux), über den Nix-Paketmanager oder – nur macOS – als Hintergrund-App, installierbar via Homebrew oder herunterladbarer
.dmg-Datei - Entwickler: exo-explore / exo labs auf GitHub; die LICENSE-Datei des Repositorys nennt Exo Technologies Ltd als Copyright-Inhaber
- Kanonisches Repository: github.com/exo-explore/exo, erstellt im Juni 2024 laut GitHubs eigenen Repository-Metadaten, mit einem Push zuletzt am 25.08.2026 zum Zeitpunkt dieser Review
exo installieren: Setup-Optionen
Laut exos eigenem README gibt es drei Wege, exo auszuführen: Build aus dem Quellcode unter macOS oder Linux, Ausführung über den Nix-Paketmanager oder – nur macOS – Installation einer vorgefertigten Hintergrund-App. Es gibt kein pip install exo-Paket; Quellcode-Installationen nutzen uv für Python-Abhängigkeiten.
- Dies startet das exo-Dashboard und die OpenAI-kompatible API unter
http://localhost:52415, laut exos eigenem README - Unter Linux nutzen die entsprechenden Befehle
uv sync --extra mlx-cpu(oder--extra mlx-cuda13/--extra mlx-cuda12, sofern zutreffend); exos eigenes README besagt, dass exo unter Linux aktuell nur mit CPU läuft, GPU-Unterstützung ist „in Entwicklung" - Ist Nix bereits installiert, überspringt
nix run .#exodie meisten manuellen Abhängigkeits-Schritte unter macOS - Unter macOS liefert exo zusätzlich eine vorgefertigte Hintergrund-App, die macOS Tahoe 26.2 oder neuer erfordert – Installation via
brew install --cask exooder direkter Download von EXO-latest.dmg, laut exos eigener Dokumentation - Für Quellcode-Installationen existieren laut README zwei Konfigurationsflags:
--no-worker(nur Koordinator-Knoten ohne lokale Inferenz ausführen – nützlich für eine Maschine mit guter Netzwerkanbindung, aber begrenzter GPU/Arbeitsspeicher) und--legacy-daemon(als Hintergrunddienst für ältere Init-Systeme ausführen)
git clone https://github.com/exo-explore/exo
cd exo/dashboard && npm install && npm run build && cd ..
uv sync --extra mlx
uv run exo
Wie exos Clustering tatsächlich funktioniert
exos eigenes README dokumentiert vier Mechanismen, die zusammen dafür sorgen, dass mehrere separate Geräte wie ein Inferenz-Cluster agieren, ohne dass Sie manuell entscheiden müssen, welche Layer wo laufen.
- exos eigene Hinweise zu RDMA: Jedes Gerät im Cluster muss direkt per Thunderbolt-5-zertifiziertem Kabel mit jedem anderen Gerät verbunden sein, und alle Geräte müssen exakt dieselbe macOS-Version, einschließlich Beta-Build-Nummern, ausführen
- Ein
--no-worker-Flag erlaubt einem Gerät, dem Cluster nur als Koordinator beizutreten, ohne lokal Inferenz auszuführen – nützlich für eine Maschine mit starker Netzwerkanbindung, aber schwacher Rechenleistung - Die Umgebungsvariable
EXO_OFFLINElässt einen Cluster ohne Internetverbindung laufen, nur mit bereits lokal zwischengespeicherten Modellen
Unterstützte Modelle und Plattformen
exo lädt Modelle über das MLX-Inferenz-Backend vom Hugging Face Hub, und exos eigenes README dokumentiert keine Unterstützung für Modelle im GGUF-Format – das unterscheidet es von llama.cpp-basierten Tools wie Ollama oder LM Studio, die GGUF-first sind.
Performance: Was die Benchmarks zeigen
exos eigenes README verlinkt auf Benchmarks Dritter, statt für jede Konfiguration eigene Zahlen zu veröffentlichen; PromptQuorum hat diese Tests nicht selbst nachgestellt und gibt sie hier als exos eigene zitierte Quellen wieder, nicht als eigene Messungen von PromptQuorum.
- exos README zeigt einen Dashboard-Screenshot von 4 × 512-GB-M3-Ultra-Mac-Studios, die gleichzeitig DeepSeek V3.1 (8-Bit) und Kimi-K2-Thinking (4-Bit) ausführen, als Illustration der Speicher-Bündelung, die exo ermöglicht
- Ein zitierter Benchmark aus Jeff Geerlings Blog behandelt Qwen3-235B (8-Bit) auf 4 × M3-Ultra-Mac-Studios mit Tensor-Parallel-RDMA
- Dieselbe zitierte Quelle behandelt auch DeepSeek V3.1 671B (8-Bit) und Kimi K2 Thinking (nativ 4-Bit) auf derselben 4-Geräte-Cluster-Konfiguration
- exos eigenes README nennt die allgemeinen Faktoren von bis zu 1,8x (2 Geräte) und 3,2x (4 Geräte) speziell durch Tensor-Parallelismus, getrennt von den oben genannten Drittanbieter-Benchmarks für große Modelle
Anwendungsbeispiele
Dies sind Workflows, die auf exos oben dokumentierten Funktionen basieren, keine hypothetischen Anwendungsfälle.
Für wen ist exo geeignet?
Ob exo passt, hängt stark von der bereits vorhandenen Hardware ab und davon, ob sie auf macOS basiert – exos Clustering ist zuerst um und für Apple Silicon gebaut und getestet.
exo vs. andere verteilte Inferenz-Tools
exo bewegt sich im Segment verteiltes/Cluster-basiertes lokales Inferencing, neben anderen Projekten, die ein Modell auf mehrere Maschinen aufteilen, statt es von einer einzigen auszuliefern. So schneidet es im Vergleich ab – siehe das lokale KI-Software-Verzeichnis für den vollständigen Katalog.
- GPUStack — ein quelloffener GPU-Cluster-Manager (Apache-2.0), der GPUs über Linux, Windows und macOS hinweg bündelt und Modelle über Ollama, vLLM oder llama.cpp als Backends ausliefern kann; ein breiterer, backend-agnostischer Cluster-Manager im Vergleich zu exos MLX-spezifischem, auf Apple Silicon zugeschnittenem Design. GPUStack hat einen eigenen Eintrag in PromptQuorums lokalem KI-Software-Verzeichnis.
- llama.cpps RPC-Backend — llama.cpp liefert einen experimentellen
ggml-rpc-server, der Berechnungen für verteilte Inferenz an entfernte Hosts auslagert; die eigenen Maintainer bezeichnen ihn als „proof-of-concept", der „fragile and insecure" sei, und warnen davor, ihn jemals in einem offenen Netzwerk freizugeben – ein deutlich anderer Reife- und Sicherheitsstatus als exos dokumentiertes Clustering. - Petals — ein Forschungsprojekt der BigScience-Workshop-Initiative, das große Modelle „BitTorrent-artig" über einen öffentlichen, von Freiwilligen betriebenen Schwarm von Consumer-GPUs ausführt, statt über einen privaten Cluster eigener Geräte; ein anderes Vertrauensmodell als exos LAN-basiertes Clustering, ausgerichtet auf kollaborative Inferenz über fremde Hardware statt Ihr eigenes lokales Netzwerk.
Häufige Fehler bei der Bewertung von exo
Die meisten Missverständnisse rund um exo entstehen, weil man es wie eine Single-Device-Chat-App behandelt oder erwartet, dass Linux/Windows denselben Funktionsumfang wie macOS bieten.
Häufig gestellte Fragen
Was ist exo?
exo (exolabs.net, Quellcode unter github.com/exo-explore/exo) ist ein quelloffenes, unter Apache-2.0 lizenziertes Framework, das mehrere Geräte – vor allem Apple-Silicon-Macs – zu einem verteilten KI-Inferenz-Cluster verbindet, sodass Modelle, die für ein einzelnes Gerät zu groß sind, durch Aufteilung auf die Gruppe trotzdem laufen können.
Ist exo kostenlos?
Ja. exo ist quelloffen unter der Apache-2.0-Lizenz, verifiziert anhand der eigenen LICENSE-Datei des Repositorys – es gibt keine separate kostenpflichtige Stufe oder Nutzungsbeschränkung über die Standard-Apache-2.0-Bedingungen hinaus.
Welche Lizenz nutzt exo? Hat sie sich geändert?
exo ist unter der Apache License 2.0 lizenziert, Copyright Exo Technologies Ltd, laut der aktuellen LICENSE-Datei im Repository, direkt geprüft am 12.09.2026. PromptQuorum fand keine zusätzliche Nutzungsbeschränkung über den Standard-Apache-2.0-Text hinaus im aktuellen Repository.
Wie funktioniert exos Clustering tatsächlich?
Laut exos eigenem README erkennen sich Geräte, die exo ausführen, im selben Netzwerk automatisch, exo erstellt eine Echtzeitsicht auf den Arbeitsspeicher jedes Geräts sowie die Netzwerkverbindungen zwischen ihnen und verteilt die Layer eines Modells entsprechend auf den Cluster, ergänzt um Tensor-Parallelismus für zusätzliche Geschwindigkeit. Auf unterstützter macOS-Hardware kann es zusätzlich RDMA über Thunderbolt 5 für latenzärmere Verbindungen zwischen Geräten nutzen.
Welche Modellformate unterstützt exo?
exos eigenes README dokumentiert das Laden von Modellen vom Hugging Face Hub über das MLX-Inferenz-Backend; eine Unterstützung für Modelle im GGUF-Format wird nicht dokumentiert – das unterscheidet es von GGUF-first-Tools wie llama.cpp oder Ollama.
Läuft exo unter Windows?
Aktuell nicht. exos eigene PLATFORMS.md führt Windows-CUDA- und Windows-CPU-Unterstützung nur unter einer Roadmap-Überschrift „Longer term", getrennt von den kurzfristigen Plänen.
Läuft exo unter Linux?
Ja, aber aktuell nur mit CPU. exos eigenes README und PLATFORMS.md stellen klar, dass GPU-Unterstützung für Linux (CUDA und Vulkan) zum Zeitpunkt dieser Review in Entwicklung und noch nicht ausgeliefert ist.
Wie installiere ich exo?
Build aus dem Quellcode mit git clone https://github.com/exo-explore/exo, das Dashboard bauen, uv sync --extra mlx (macOS) oder uv sync --extra mlx-cpu (Linux) ausführen, dann uv run exo. Unter macOS können Sie alternativ eine vorgefertigte Hintergrund-App via brew install --cask exo installieren oder EXO-latest.dmg herunterladen – erfordert macOS Tahoe 26.2 oder neuer.
Wie viele GitHub-Sterne hat exo?
exo hatte 47.375 Sterne und 3.508 Forks auf GitHub, verifiziert über die GitHub-API am 12.09.2026. Prüfen Sie das Live-Repository für die aktuelle Zahl, da sich Stern-Zahlen kontinuierlich ändern.
Wer entwickelt exo?
exo wird von exo-explore / exo labs auf GitHub entwickelt; die LICENSE-Datei des Repositorys nennt Exo Technologies Ltd als Copyright-Inhaber. Das Repository wurde im Juni 2024 erstellt, laut GitHubs eigenen Metadaten.