Conclusiones clave
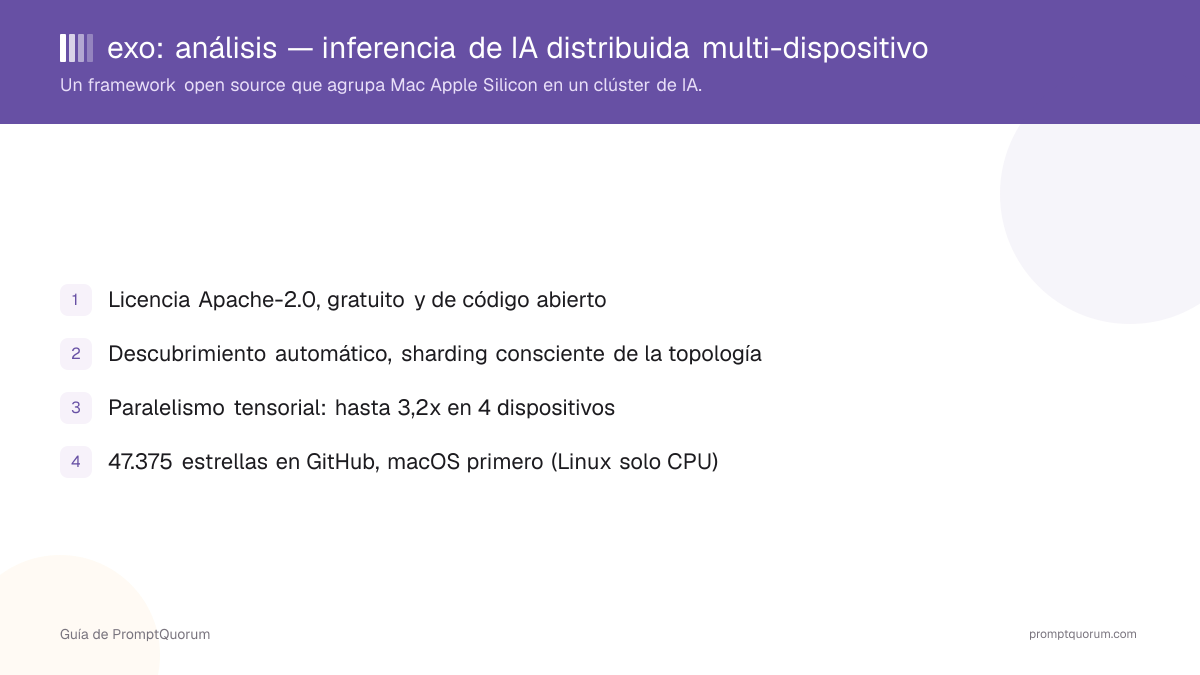
- Gratuito, de código abierto, licencia Apache-2.0, copyright de Exo Technologies Ltd, según el archivo LICENSE propio del repositorio — verificado el 12/09/2026
- Descubrimiento automático de dispositivos — los dispositivos que ejecutan exo en la misma red se encuentran sin configuración manual, según el propio README de exo
- Modo auto-paralelo consciente de la topología: exo reparte el modelo entre los dispositivos según una vista en tiempo real de los recursos de cada uno y la latencia/ancho de banda de los enlaces de red
- Paralelismo tensorial además del sharding — hasta 1,8x de aceleración en 2 dispositivos y 3,2x en 4 dispositivos, según el propio README de exo
- Soporte de RDMA sobre Thunderbolt 5 (macOS 26.2+), que exo describe como una reducción del 99 % en la latencia entre dispositivos, según su propia documentación
- Usa MLX, el framework de computación de arrays de Apple, como backend de inferencia y MLX distributed para la comunicación entre dispositivos
- Compatible con las API de OpenAI Chat Completions, OpenAI Responses, Claude Messages y Ollama, por lo que los clientes existentes pueden apuntar a un clúster exo prácticamente sin cambios
- 47.375 estrellas en GitHub, 3.508 forks, verificado mediante la API de GitHub el 12/09/2026
- macOS (Apple Silicon) es la plataforma principal y probada; Linux hoy solo funciona con CPU (el soporte de GPU figura como "en desarrollo" en el propio PLATFORMS.md de exo); Windows no es compatible actualmente
📍 En una frase
exo es un framework gratuito y de código abierto (Apache-2.0) que agrupa varios Mac Apple Silicon — y, con soporte limitado a CPU, máquinas Linux — en un único clúster de inferencia distribuida, usando descubrimiento automático de dispositivos y sharding consciente de la topología para ejecutar modelos demasiado grandes para un solo dispositivo.
💬 En términos simples
En lugar de comprar un equipo muy caro con suficiente memoria para cargar un modelo enorme, o alquilar tiempo de GPU en la nube, exo permite conectar por red varios Mac (o equipos Linux) que ya posee para que actúen como un ordenador más grande, repartiendo automáticamente las capas del modelo entre todos ellos.
📌Nota: Esta review es el complemento de la entrada de exo en el directorio de software de IA local — consulte esa página para ver de un vistazo cómo se compara exo con docenas de otras herramientas de IA local.
¿Qué es exo?
exo es un framework que conecta varios dispositivos que ya posee en un clúster de inferencia de IA, de modo que modelos demasiado grandes para la memoria de un solo dispositivo puedan ejecutarse igualmente, repartiendo el modelo entre el grupo. Lo mantiene exo labs y la descripción de su propio repositorio se resume en: "Run frontier AI locally".
- Función principal: descubrimiento automático de dispositivos más sharding de modelo consciente de la topología — apunte varios dispositivos al mismo clúster y exo determina cómo repartir el modelo entre ellos
- Backend de inferencia: MLX, el framework de código abierto de Apple para computación de arrays, usado tanto para ejecutar el modelo como para la capa de comunicación MLX distributed entre dispositivos
- Modelo de implementación: desde el código fuente (macOS o Linux), mediante el gestor de paquetes Nix, o — solo macOS — como una app en segundo plano instalable con Homebrew o un archivo
.dmgdescargable - Desarrollador: exo-explore / exo labs en GitHub; el archivo LICENSE del repositorio indica a Exo Technologies Ltd como titular del copyright
- Repositorio canónico: github.com/exo-explore/exo, creado en junio de 2024 según los propios metadatos del repositorio en GitHub, con un push registrado tan reciente como el 25/08/2026 en el momento de esta review
Instalar exo: opciones de configuración
El propio README de exo documenta tres formas de ejecutarlo: compilar desde el código fuente en macOS o Linux, ejecutarlo mediante el gestor de paquetes Nix, o — solo en macOS — instalar una app prediseñada en segundo plano. No existe un paquete pip install exo; las instalaciones desde código fuente usan uv para las dependencias de Python.
- Esto inicia el panel de exo y la API compatible con OpenAI en
http://localhost:52415, según el propio README de exo - En Linux, los comandos equivalentes usan
uv sync --extra mlx-cpu(o--extra mlx-cuda13/--extra mlx-cuda12cuando corresponda); el propio README de exo indica que en Linux, exo actualmente funciona solo con CPU, con soporte de GPU "en desarrollo" - Si Nix ya está instalado,
nix run .#exoevita la mayoría de los pasos manuales de configuración de dependencias en macOS - En macOS, exo también incluye una app prediseñada en segundo plano que requiere macOS Tahoe 26.2 o posterior — instálela con
brew install --cask exoo descargue directamente EXO-latest.dmg, según la propia documentación de exo - Existen dos opciones de configuración para las instalaciones desde código fuente, según el README:
--no-worker(ejecutar solo un nodo coordinador, sin inferencia local — útil para un equipo con buena conectividad de red pero GPU/memoria limitadas) y--legacy-daemon(ejecutar como demonio en segundo plano para sistemas de inicio más antiguos)
Compilar desde el código fuente (macOS)
Requiere Xcode (para la cadena de herramientas Metal), Homebrew, uv, Node.js y una cadena de herramientas Rust nightly, según la propia lista de requisitos de exo. Ejecute lo siguiente en una terminal:
git clone https://github.com/exo-explore/exo
cd exo/dashboard && npm install && npm run build && cd ..
uv sync --extra mlx
uv run exo
Cómo funciona realmente el clustering de exo
El propio README de exo documenta cuatro mecanismos que, juntos, permiten que un grupo de dispositivos independientes se comporte como un único clúster de inferencia, sin que usted tenga que decidir manualmente qué capas se ejecutan dónde.
- Advertencias propias de exo sobre RDMA: cada dispositivo del clúster debe estar conectado directamente a todos los demás con cables certificados Thunderbolt 5, y todos los dispositivos deben ejecutar exactamente la misma versión de macOS, incluidos los números de compilación beta
- Un indicador
--no-workerpermite que un dispositivo se una al clúster solo como coordinador, sin ejecutar inferencia localmente — útil para un equipo con buena conectividad de red pero poca capacidad de cómputo - La variable de entorno
EXO_OFFLINEejecuta un clúster sin conexión a internet, usando solo los modelos ya almacenados en caché localmente
Descubrimiento automático de dispositivos
Los dispositivos que ejecutan exo en la misma red se encuentran sin configuración manual, mediante una capa de descubrimiento entre pares — la propia documentación de configuración de exo hace referencia a una base libp2p, expuesta a través de la variable de entorno EXO_LIBP2P_NAMESPACE para aislar varios clústeres en una misma red.
Modo auto-paralelo consciente de la topología
exo construye una vista en tiempo real de la topología del clúster — memoria disponible de cada dispositivo, más latencia y ancho de banda de los enlaces de red entre ellos — y usa esa vista para decidir cómo repartir un modelo entre los dispositivos, según el propio README de exo.
Paralelismo tensorial
Además de repartir las capas de un modelo entre dispositivos, exo aplica paralelismo tensorial dentro de ese reparto, al que el propio README de exo atribuye una aceleración de hasta 1,8x en 2 dispositivos y 3,2x en 4 dispositivos, en comparación con un reparto simple por capas sin esta técnica.
RDMA sobre Thunderbolt 5
En Mac con Thunderbolt 5 (Mac Mini M4 Pro, Mac Studio/MacBook Pro M4 Max, Mac Studio M3 Ultra) bajo macOS 26.2 o posterior, exo admite Remote Direct Memory Access sobre Thunderbolt, que su propia documentación describe como una reducción del 99 % en la latencia entre dispositivos. Activarlo requiere entrar en el modo de recuperación de macOS y ejecutar rdma_ctl enable desde la terminal de recuperación, según los propios pasos de configuración de exo.
Modelos y plataformas compatibles
exo carga modelos desde Hugging Face Hub a través de su backend de inferencia MLX, y el propio README de exo no documenta soporte para modelos en formato GGUF — lo que lo distingue de herramientas basadas en llama.cpp como Ollama o LM Studio, que priorizan GGUF.
Carga de modelos
El propio README de exo documenta la carga de modelos personalizados directamente desde Hugging Face Hub, además de soporte para fichas de modelo locales personalizadas almacenadas en ~/.local/share/exo/custom_model_cards/ en Linux (o el equivalente en macOS). La propia documentación de configuración de exo cita EXO_ENABLE_IMAGE_MODELS como indicador para activar el soporte de modelos de imagen, desactivado por defecto.
Niveles de plataforma en macOS
El propio PLATFORMS.md de exo clasifica los Mac Apple Silicon como soporte "Tier 1" (probado y mantenido), nombrando específicamente el Mac Studio M3 Ultra, el Mac Mini M4 Pro y el MacBook Pro M5/M4 Max como hardware probado. Apple ha lanzado desde entonces el Mac mini (M6/M5 Pro) y el Mac Studio (M5 Max/M5 Ultra); consulta directamente el PLATFORMS.md de exo para su lista actual de hardware probado.
Soporte de Linux
El propio README y PLATFORMS.md de exo son explícitos en que Linux actualmente funciona solo con CPU; el soporte de GPU (CUDA y Vulkan figuran ambos como planificados, no entregados) se describe como "en desarrollo", con el soporte de Linux CUDA y CPU figurando ambos bajo la sección propia de hoja de ruta "Planificado — Tier 1" de exo en el momento de esta review.
Soporte de Windows
El propio PLATFORMS.md de exo solo lista el soporte de Windows CUDA y Windows CPU bajo un encabezado "Longer term!", separado de los elementos de hoja de ruta de Linux a corto plazo y posterior a ellos — Windows no es compatible actualmente.
Rendimiento: qué muestran los benchmarks
El propio README de exo enlaza a benchmarks de terceros en lugar de publicar cifras propias para cada configuración; PromptQuorum no ha reproducido estas pruebas de forma independiente y las reporta aquí como fuentes citadas por el propio exo, no como mediciones propias de PromptQuorum.
- El README de exo muestra una captura del panel de 4 Mac Studio M3 Ultra de 512 GB ejecutando simultáneamente DeepSeek-V3.1 (8 bits) y Kimi-K2-Thinking (4 bits), como ilustración de la agrupación de memoria que permite exo
- Un benchmark citado del blog de Jeff Geerling cubre Qwen3-235B (8 bits) ejecutado en 4 Mac Studio M3 Ultra con RDMA en paralelismo tensorial
- La misma fuente citada cubre también DeepSeek-V3.1 671B (8 bits) y Kimi K2 Thinking (nativo 4 bits) en la misma configuración de clúster de 4 dispositivos
- El propio README de exo indica los multiplicadores generales de hasta 1,8x (2 dispositivos) y 3,2x (4 dispositivos) específicamente del paralelismo tensorial, por separado de los benchmarks de terceros para modelos grandes mencionados arriba
Ejemplos de uso
Estos son flujos de trabajo construidos a partir de las funciones documentadas de exo mencionadas arriba, no casos de uso hipotéticos.
Ejecutar un modelo demasiado grande para un solo Mac
Instale exo en dos o más Mac Apple Silicon en la misma red, inicie uv run exo (o la app de macOS) en cada uno, y cargue un modelo cuyos pesos completos superen la memoria unificada de un solo dispositivo — el descubrimiento automático y el sharding consciente de la topología de exo lo reparten por el clúster sin asignación manual de capas.
Apuntar una herramienta compatible con OpenAI existente a un clúster local
Como exo expone una API compatible con OpenAI Chat Completions en http://localhost:52415 (o la dirección de un dispositivo del clúster), un cliente existente creado para la API de OpenAI, la API de Ollama o la API Claude Messages de Anthropic puede redirigirse a un clúster exo cambiando la URL base en lugar de reescribirlo.
Desarrollar sin conexión con modelos en caché
Establezca EXO_OFFLINE=true antes de iniciar exo para trabajar completamente con modelos ya descargados y almacenados en caché localmente, útil para probar una configuración de clúster sin depender del acceso de red a Hugging Face durante el desarrollo.
¿Para quién es exo?
Que exo sea adecuado depende en gran medida del hardware que ya posea y de si pertenece al ecosistema macOS — el clustering de exo está construido y probado primero en torno a Apple Silicon.
Use exo si
- Posee dos o más Mac Apple Silicon y quiere ejecutar modelos más grandes de lo que cabe en la memoria unificada de un solo Mac, en lugar de comprar un equipo con mucha memoria o alquilar tiempo de GPU en la nube
- Quiere descubrimiento automático de dispositivos y sharding consciente de la topología en lugar de decidir manualmente qué capas del modelo se ejecutan en qué dispositivo
- Tiene Mac compatibles con Thunderbolt 5 en macOS 26.2+ y quiere la opción de clustering de menor latencia que exo documenta actualmente (RDMA)
- Quiere una licencia de código abierto permisiva (Apache-2.0) sin dependencia de un proveedor
- Se siente cómodo compilando desde el código fuente con
uv, o prefiere la app prediseñada de macOS si busca un servicio en segundo plano sin terminal
Espere, o busque otra opción, si
- Su hardware de clúster es exclusivamente Linux y necesita aceleración por GPU — el propio PLATFORMS.md de exo sigue listando el soporte de GPU en Linux como en desarrollo, con soporte solo de CPU entregado hoy
- Usa Windows — la propia hoja de ruta de exo solo lista el soporte de Windows como un elemento "a largo plazo", no disponible actualmente
- Necesita soporte de modelos en formato GGUF — la ruta documentada de carga de modelos de exo es MLX/Hugging Face Hub, no GGUF; vea en su lugar llama.cpp o GPUStack
- Solo tiene un dispositivo y no necesita clustering en absoluto — una herramienta de un solo equipo como Ollama o LM Studio es una opción más sencilla
- Necesita una organización de soporte empresarial establecida — exo lo desarrolla un equipo pequeño (exo labs), el soporte pasa por los issues de GitHub y los canales de la comunidad, no por un SLA formal
exo frente a otras herramientas de inferencia distribuida
exo se ubica en el segmento de inferencia local distribuida/en clúster, junto a otros proyectos que reparten un modelo entre varias máquinas en lugar de servirlo desde una sola. Así se compara: consulte el directorio de software de IA local para el catálogo completo.
- GPUStack — un gestor de clústeres de GPU de código abierto (Apache-2.0) que agrupa GPU en Linux, Windows y macOS y puede servir modelos usando Ollama, vLLM o llama.cpp como backends; un gestor de clústeres más amplio y agnóstico del backend, frente al diseño específico de MLX y centrado en Apple Silicon de exo. GPUStack tiene su propia entrada en el directorio de software de IA local de PromptQuorum.
- El backend RPC de llama.cpp — llama.cpp incluye un
ggml-rpc-serverexperimental que delega el cómputo a hosts remotos para inferencia distribuida; sus propios mantenedores lo califican de "proof-of-concept" "fragile and insecure" y advierten que nunca debe exponerse en una red abierta, una postura de madurez y seguridad muy distinta del clustering documentado de exo. - Petals — un proyecto de investigación del taller BigScience que ejecuta modelos grandes "al estilo BitTorrent" sobre un enjambre público de GPU de consumo gestionado por voluntarios, en lugar de un clúster privado de dispositivos propios; un modelo de confianza distinto del clustering en red local de exo, orientado a inferencia colaborativa sobre hardware ajeno en vez de su propia red local.
Errores comunes al evaluar exo
La mayor parte de la confusión sobre exo viene de tratarlo como una app de chat de un solo dispositivo, o de esperar que Linux/Windows igualen las funciones de macOS.
Error 1: esperar soporte de modelos GGUF
exo carga modelos mediante MLX desde Hugging Face Hub, según su propio README; no documenta importación de GGUF. Quien tenga ya una biblioteca de archivos GGUF debería en su lugar considerar una herramienta GGUF-first como llama.cpp, Ollama o GPUStack.
Error 2: suponer que Linux obtiene la misma aceleración por GPU que macOS
El propio PLATFORMS.md de exo deja claro que Linux actualmente funciona solo con CPU, con soporte de GPU (CUDA/Vulkan) listado como planificado, no entregado. Agrupar varios equipos Linux con GPU para inferencia acelerada por GPU no es todavía lo que documenta la ruta de Linux de exo.
Error 3: esperar una aceleración casi lineal con cualquier conexión de red
Las cifras de aceleración documentadas por exo (hasta 1,8x en 2 dispositivos, 3,2x en 4) y los benchmarks RDMA de terceros citados asumen ambos enlaces de clase Thunderbolt, en varios casos con RDMA explícitamente activado. Un clúster conectado por Wi-Fi normal o Ethernet gigabit no necesariamente alcanzará las mismas cifras — la propia documentación de exo no publica cifras para esa configuración.
Error 4: tratar exo como una app de escritorio de un solo dispositivo
exo es un framework de clustering que se instala y ejecuta en cada dispositivo que se une al clúster, no una aplicación de chat de un clic — aunque la app en segundo plano prediseñada de macOS reduce considerablemente la barrera de entrada en un solo Mac frente a compilar desde el código fuente.
Preguntas frecuentes
¿Qué es exo?
exo (exolabs.net, código fuente en github.com/exo-explore/exo) es un framework de código abierto, con licencia Apache-2.0, que conecta varios dispositivos — principalmente Mac Apple Silicon — en un único clúster de inferencia de IA distribuida, de modo que modelos demasiado grandes para un solo dispositivo puedan ejecutarse igualmente repartiéndose entre el grupo.
¿Es gratis exo?
Sí. exo es de código abierto bajo licencia Apache-2.0, verificada frente al propio archivo LICENSE del repositorio — no hay un nivel de pago separado ni restricción de uso más allá de las condiciones estándar de Apache-2.0.
¿Qué licencia usa exo? ¿Ha cambiado?
exo tiene licencia Apache License 2.0, copyright de Exo Technologies Ltd, según el archivo LICENSE actual del repositorio, comprobado directamente el 12/09/2026. PromptQuorum no encontró ninguna restricción de uso adicional más allá del texto estándar de Apache-2.0 en el repositorio actual.
¿Cómo funciona realmente el clustering de exo?
Según el propio README de exo, los dispositivos que ejecutan exo se descubren automáticamente en la misma red, exo construye una vista en tiempo real de la memoria de cada dispositivo y los enlaces de red entre ellos, y reparte las capas de un modelo por el clúster en consecuencia, añadiendo paralelismo tensorial para una aceleración adicional. En hardware macOS compatible, puede además usar RDMA sobre Thunderbolt 5 para enlaces de menor latencia entre dispositivos.
¿Qué formatos de modelo admite exo?
El propio README de exo documenta la carga de modelos desde Hugging Face Hub mediante su backend de inferencia MLX; no documenta soporte para modelos en formato GGUF, lo que lo distingue de herramientas GGUF-first como llama.cpp u Ollama.
¿Funciona exo en Windows?
Actualmente no. El propio PLATFORMS.md de exo solo lista el soporte de Windows CUDA y Windows CPU bajo un encabezado de hoja de ruta "Longer term", separado de sus planes a corto plazo.
¿Funciona exo en Linux?
Sí, pero hoy solo con CPU. El propio README y PLATFORMS.md de exo dejan claro que el soporte de GPU para Linux (CUDA y Vulkan) está en desarrollo y aún no se ha entregado, en el momento de esta review.
¿Cómo instalo exo?
Compile desde el código fuente con git clone https://github.com/exo-explore/exo, construya el panel, ejecute uv sync --extra mlx (macOS) o uv sync --extra mlx-cpu (Linux), y luego uv run exo. En macOS, también puede instalar una app en segundo plano prediseñada con brew install --cask exo o descargando EXO-latest.dmg — requiere macOS Tahoe 26.2 o posterior.
¿Cuántas estrellas de GitHub tiene exo?
exo tenía 47.375 estrellas y 3.508 forks en GitHub, verificado mediante la API de GitHub el 12/09/2026. Consulte el repositorio en vivo para la cifra actual, ya que el número de estrellas cambia continuamente.
¿Quién desarrolla exo?
exo lo desarrolla exo-explore / exo labs en GitHub; el archivo LICENSE del repositorio indica a Exo Technologies Ltd como titular del copyright. El repositorio se creó en junio de 2024, según los propios metadatos de GitHub.