Welche Ollama-Modelle unterstützen Vision?
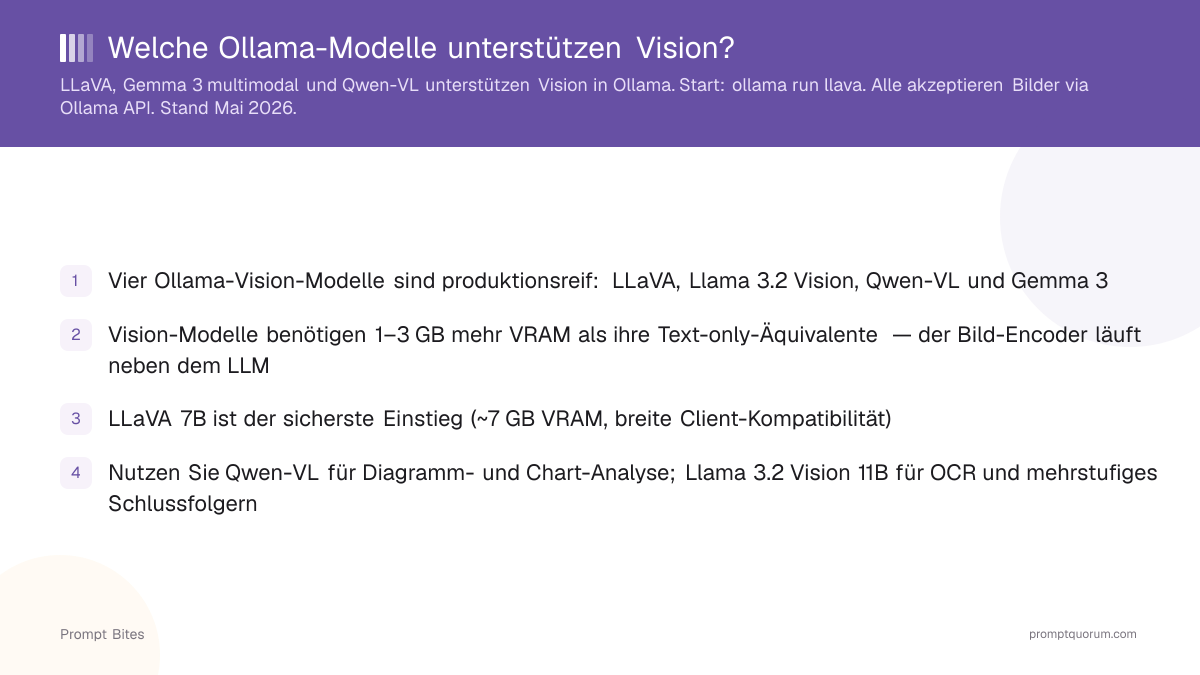
Schnelle Antwort
Ollamas beste Vision-Modelle 2026 sind Qwen3-VL und Gemma 4, beide nativ multimodal. LLaVA bleibt der sicherste Fallback für breite Kompatibilität. Llama 3.2 Vision ist derzeit auf Ollama defekt ("unknown model architecture: mllama") — nutzen Sie stattdessen Qwen3-VL oder Gemma 4.
- ▸qwen3-vl: stärkste Vision-Familie, am besten für OCR, Charts und Screenshots
- ▸gemma4: Vision in jeder Größe integriert, plus Tool-Calling
- ▸llava: sicherster Fallback, breiteste Client-Kompatibilität
- ▸llama3.2-vision: defekt auf Ollama v0.30.0+ ("unknown model architecture: mllama")
Wichtigste Punkte
- ✓Ollamas führende Vision-Modelle sind seit September 2026 Qwen3-VL und Gemma 4 — beide lösten die frühere Qwen2.5-VL-/Gemma-3-Generation ab
- ✓Llama 3.2 Vision ist auf Ollama v0.30.0 und neuer derzeit defekt: Fehler "Error: unknown model architecture: mllama", weil Ollamas llama.cpp-basierte Engine kein mllama unterstützt
- ✓LLaVA 7B bleibt der sicherste Fallback (~7 GB VRAM, funktioniert auf jeder Ollama-Version)
- ✓Nutzen Sie Qwen3-VL für OCR, Charts und Screenshots; Gemma 4, wenn Sie Vision und Tool-Calling in einem Modell benötigen
Die wichtigsten Vision-Modelle auf Ollama
Ollamas Vision-Angebot hat sich 2026 deutlich verändert: Qwen3-VL und Gemma 4 sind jetzt die stärksten Optionen, und Llama 3.2 Vision lädt auf aktuellen Ollama-Versionen nicht mehr. Jedes verbleibende Modell hat eine eigene Stärke und ein eigenes VRAM-Profil.
Qwen3-VL ist die stärkste offene Vision-Sprachmodell-Familie auf Ollama — es führt bei OCR, Charts, Diagrammen und Screenshot-/UI-Verständnis und reicht von einem 2B-Edge-Modell bis zu einer 235B-Mixture-of-Experts-Variante. Gemma 4 integriert native Vision in jede Größe (2B–31B) zusammen mit Tool-Calling und ist damit die beste Wahl, wenn ein Modell sowohl Bilder verstehen als auch Tools aufrufen soll. LLaVA bleibt der sicherste Einstiegspunkt für breite Client-Kompatibilität. Qwen2.5-VL, die vorherige Qwen-Generation, funktioniert weiterhin und bleibt eine gültige, leichtgewichtige Wahl, wenn Sie sie bereits heruntergeladen haben.
Alle Vision-Modelle laden einen Bild-Encoder neben den LLM-Gewichten. Dieser Encoder benötigt 1–3 GB VRAM zusätzlich zu dem, was das reine Textmodell benötigt — planen Sie diesen Overhead beim Prüfen Ihres VRAM-Budgets ein.
Error: unknown model architecture: "mllama" fehl — die mllama-Architektur wurde nie zu llama.cpp hinzugefügt. Das ist auch mit Ollama v0.33.2 (August 2026) noch ungelöst. Nutzen Sie stattdessen Qwen3-VL oder Gemma 4, oder behalten Sie eine Ollama-Installation vor v0.30.0, wenn Sie speziell Llama 3.2 Vision benötigen.VRAM-Anforderungen für Vision
Jedes Vision-Modell benötigt mehr VRAM als sein Text-only-Äquivalent. Ein 7–8B-Vision-Modell benötigt typischerweise 7–9 GB VRAM, nicht die ~6 GB, die Sie für ein ähnlich großes reines Textmodell einplanen würden.
Für OCR, Charts und Dokumentenanalyse ist Qwen3-VL 8B die VRAM-effizienteste starke Option. Für Vision plus Tool-Calling in einem Modell passen Gemma 4s 12B- oder 26B-A4B-MoE-Varianten in 8–14 GB. Den vollständigen Leitfaden zu multimodalen lokalen Modellen und Anwendungsfall-Matching finden Sie im Leitfaden für multimodale lokale LLMs.
| Modell | VRAM bei Q4 | Bildfähigkeit |
|---|---|---|
| LLaVA 7B | ~7 GB | Allgemeine Bild-Q&A, breite Kompatibilität |
| Qwen3-VL 8B | ~8 GB | OCR, Charts, Screenshots, mehrsprachig |
| Gemma 4 (12B) | ~8 GB | Vision + Tool-Calling |
| Gemma 4 (26B-A4B MoE) | ~14 GB | Vision + Tool-Calling, höhere Qualität |
| Llama 3.2 Vision 11B | ~10 GB | ⚠️ Defekt auf Ollama v0.30.0+ (mllama-Fehler) |
Verwandte Leitfäden
- ▸Qwen 3 auf Ollama ausführen -- multimodale Option mit Tool-Calling
- ▸Ollama 128K Kontextmodelle -- long context models
- ▸Leitfaden für multimodale lokale LLMs -- vollständiger Leitfaden zu lokalen Vision-Modellen
- ▸Beste lokale Vision-Modelle 2026 -- jedes Vision-Modell, jede GPU-Klasse
Schnelle Antworten zu Ollama-Vision-Modellen
Wie sende ich ein Bild über die API an Ollama?▾
/api/chat-Endpunkt mit dem Bild als Base64-String im images-Array. Minimaler JSON-Body: {"model":"llava","messages":[{"role":"user","content":"What is in this image?","images":["<base64>"]}]} Für eine multimodale Option mit starker Tool-Call-Unterstützung siehe Qwen 3 auf Ollama.