Ollama에서 비전을 지원하는 모델은 무엇인가요?
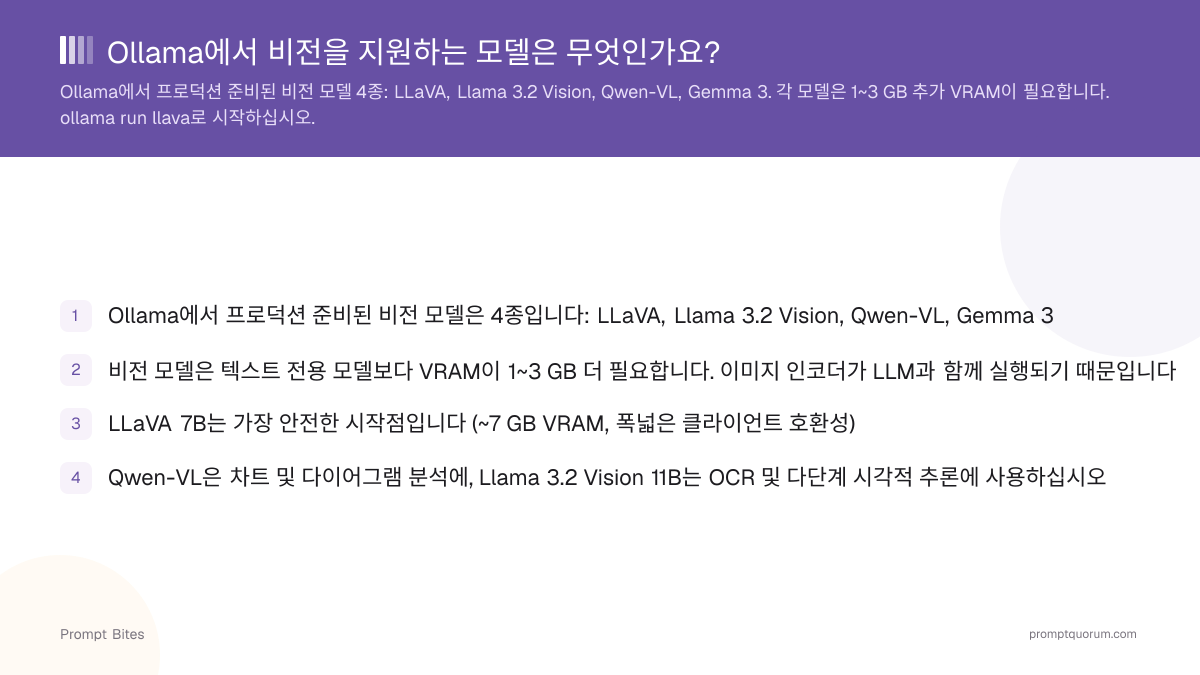
빠른 답변
2026년 기준 Ollama 최고의 비전 모델은 Qwen3-VL과 Gemma 4이며, 둘 다 기본적으로 멀티모달입니다. LLaVA는 폭넓은 호환성을 갖춘 가장 안전한 대안으로 남아 있습니다. Llama 3.2 Vision은 현재 Ollama에서 작동하지 않습니다("unknown model architecture: mllama") — 대신 Qwen3-VL이나 Gemma 4를 사용하십시오.
- ▸qwen3-vl: 가장 강력한 비전 계열, OCR·차트·스크린샷 분석에 최적
- ▸gemma4: 모든 크기에 비전이 내장되어 있으며 툴 콜링도 지원
- ▸llava: 가장 안전한 대안, 가장 폭넓은 클라이언트 호환성
- ▸llama3.2-vision: Ollama v0.30.0 이상에서 작동 불가("unknown model architecture: mllama")
핵심 요점
- ✓2026년 9월 기준, Ollama를 선도하는 비전 모델은 Qwen3-VL과 Gemma 4입니다. 둘 다 이전의 Qwen2.5-VL / Gemma 3 세대를 대체했습니다
- ✓Llama 3.2 Vision은 현재 Ollama v0.30.0 이상에서 작동하지 않습니다: "Error: unknown model architecture: mllama" 오류가 발생하며, 이는 Ollama의 새 llama.cpp 기반 엔진이 mllama를 지원하지 않기 때문입니다
- ✓LLaVA 7B는 여전히 가장 안전한 대안입니다 (~7 GB VRAM, 모든 Ollama 버전에서 작동)
- ✓OCR·차트·스크린샷에는 Qwen3-VL을, 하나의 모델에서 비전과 툴 콜링이 모두 필요하면 Gemma 4를 사용하십시오
Ollama의 주요 비전 모델
2026년 Ollama의 비전 라인업은 크게 바뀌었습니다: Qwen3-VL과 Gemma 4가 이제 가장 강력한 선택지가 되었고, Llama 3.2 Vision은 현재 Ollama 버전에서 더 이상 로드되지 않습니다. 남아 있는 각 모델은 고유한 강점과 VRAM 프로필을 가지고 있습니다.
Qwen3-VL은 Ollama에서 사용할 수 있는 가장 강력한 오픈 비전-언어 모델 계열입니다. OCR, 차트, 다이어그램, 스크린샷/UI 이해에서 앞서 있으며, 엣지용 2B 모델부터 235B 규모의 mixture-of-experts 버전까지 다양합니다. Gemma 4는 모든 크기(2B–31B)에 네이티브 비전을 내장하고 툴 콜링도 지원해, 하나의 모델로 이미지를 이해하고 도구도 호출해야 할 때 가장 좋은 선택입니다. LLaVA는 폭넓은 클라이언트 호환성을 갖춘 가장 안전한 시작점으로 남아 있습니다. 이전 세대인 Qwen2.5-VL도 여전히 작동하며, 이미 다운로드했다면 유효한 경량 대안입니다.
모든 비전 모델은 LLM 가중치와 함께 이미지 인코더를 로드합니다. 이 인코더는 텍스트 전용 기본 모델에 필요한 VRAM보다 1~3 GB를 추가로 요구합니다. VRAM 예산을 검토할 때 이 오버헤드를 반드시 고려하십시오.
Error: unknown model architecture: "mllama" 오류로 실패합니다 — mllama 아키텍처는 llama.cpp에 한 번도 추가되지 않았습니다. 이 문제는 Ollama v0.33.2(2026년 8월) 기준으로도 아직 해결되지 않았습니다. 대신 Qwen3-VL이나 Gemma 4를 사용하거나, Llama 3.2 Vision이 꼭 필요하다면 v0.30.0 이전 버전의 Ollama를 유지하십시오.비전 모델의 VRAM 요구사항
모든 비전 모델은 텍스트 전용 버전보다 더 많은 VRAM이 필요합니다. 7~8B 비전 모델은 일반적으로 7~9 GB VRAM을 요구합니다. 비슷한 크기의 텍스트 전용 모델에 할당하는 ~6 GB와는 다릅니다.
OCR, 차트, 문서 분석에는 Qwen3-VL 8B가 VRAM 효율이 가장 뛰어난 강력한 선택지입니다. 하나의 모델에서 비전과 툴 콜링을 모두 사용하려면 Gemma 4의 12B 또는 26B-A4B MoE 버전이 8~14 GB에 들어맞습니다. 멀티모달 로컬 모델에 대한 전체 가이드는 멀티모달 로컬 LLM 가이드를 참조하십시오.
| 모델 | Q4 기준 VRAM | 이미지 처리 능력 |
|---|---|---|
| LLaVA 7B | ~7 GB | 일반 이미지 Q&A, 폭넓은 호환성 |
| Qwen3-VL 8B | ~8 GB | OCR, 차트, 스크린샷, 다국어 |
| Gemma 4 (12B) | ~8 GB | 비전 + 툴 콜링 |
| Gemma 4 (26B-A4B MoE) | ~14 GB | 비전 + 툴 콜링, 더 높은 품질 |
| Llama 3.2 Vision 11B | ~10 GB | ⚠️ Ollama v0.30.0+에서 작동 불가 (mllama 오류) |
관련 자료
- ▸Ollama에서 Qwen 3 실행하기 -- 툴 콜링을 지원하는 멀티모달 옵션
- ▸Ollama 128K 컨텍스트 모델 -- long context models
- ▸멀티모달 로컬 LLM 가이드 -- 로컬 비전 모델 완전 가이드
- ▸2026년 최고의 로컬 비전 모델 -- 모든 비전 모델, 모든 GPU 등급
Ollama 비전 모델에 관한 빠른 답변
API를 통해 Ollama에 이미지를 보내려면 어떻게 해야 합니까?▾
/api/chat 엔드포인트에 POST 요청을 보내면서 images 배열에 base64 문자열로 이미지를 포함하십시오. 최소 작동 JSON 본문: {"model":"llava","messages":[{"role":"user","content":"What is in this image?","images":["<base64>"]}]} 강력한 툴 콜링 지원을 갖춘 멀티모달 옵션은 Ollama에서 Qwen 3 실행하기를 참조하십시오.