Quais modelos do Ollama suportam visão?
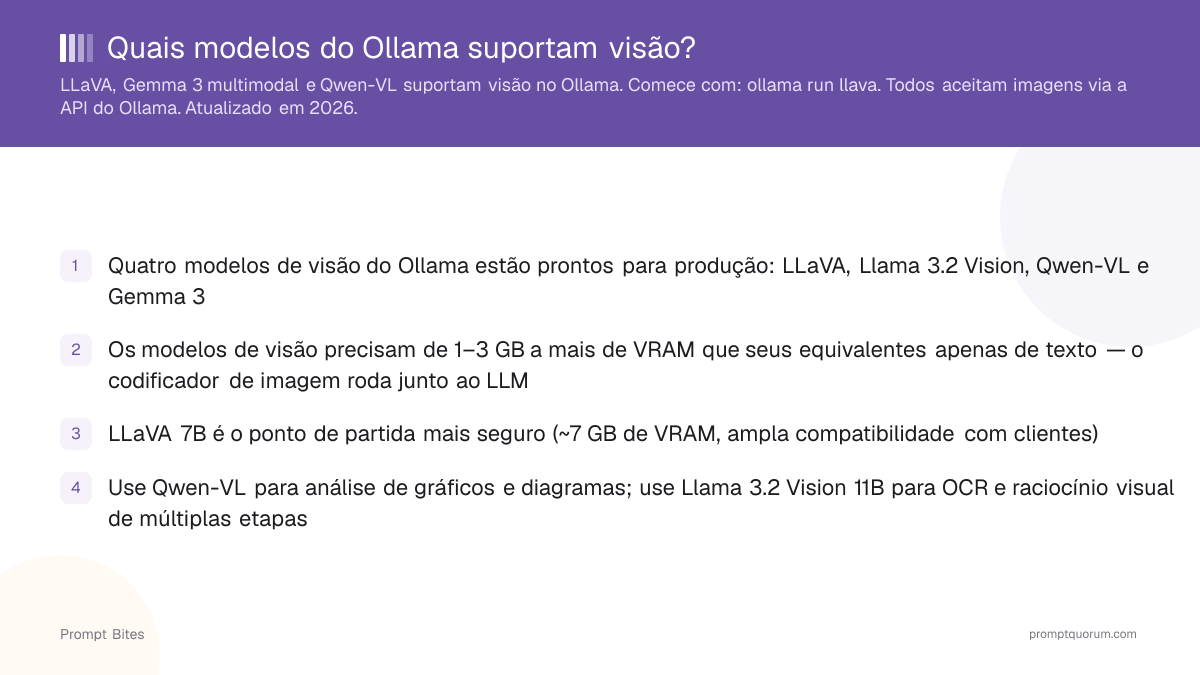
Resposta rápida
Os melhores modelos de visão do Ollama em 2026 são Qwen3-VL e Gemma 4, ambos nativamente multimodais. O LLaVA continua sendo o backup mais seguro pela ampla compatibilidade. O Llama 3.2 Vision está atualmente quebrado no Ollama ("unknown model architecture: mllama") — use Qwen3-VL ou Gemma 4 no lugar dele.
- ▸qwen3-vl: a família de visão mais forte, ideal para OCR, gráficos e capturas de tela
- ▸gemma4: visão integrada em todos os tamanhos, além de chamadas de ferramentas
- ▸llava: o backup mais seguro, maior compatibilidade com clientes
- ▸llama3.2-vision: quebrado no Ollama v0.30.0+ ("unknown model architecture: mllama")
Pontos principais
- ✓Desde setembro de 2026, os modelos de visão líderes do Ollama são Qwen3-VL e Gemma 4 — ambos substituíram a geração anterior Qwen2.5-VL/Gemma 3
- ✓O Llama 3.2 Vision está atualmente quebrado no Ollama v0.30.0 e versões posteriores: falha com "Error: unknown model architecture: mllama", porque o novo mecanismo do Ollama baseado em llama.cpp não suporta mllama
- ✓O LLaVA 7B continua sendo o backup mais seguro (~7 GB de VRAM, funciona em qualquer versão do Ollama)
- ✓Use Qwen3-VL para OCR, gráficos e capturas de tela; use Gemma 4 quando precisar de visão e chamadas de ferramentas em um único modelo
Os principais modelos de visão no Ollama
O catálogo de visão do Ollama mudou significativamente em 2026: Qwen3-VL e Gemma 4 agora são as opções mais fortes, e o Llama 3.2 Vision não carrega mais nas versões atuais do Ollama. Cada modelo restante tem uma força e um perfil de VRAM próprios.
O Qwen3-VL é a família de modelos de visão-linguagem aberta mais forte disponível no Ollama — lidera em OCR, gráficos, diagramas e compreensão de capturas de tela/UI, e vai de um modelo de 2B para dispositivos edge até uma variante de 235B em mixture-of-experts. O Gemma 4 traz visão nativa em todos os tamanhos (2B–31B) junto com chamadas de ferramentas, tornando-o a melhor escolha quando um único modelo precisa enxergar imagens e chamar ferramentas. O LLaVA continua sendo o ponto de partida mais seguro pela ampla compatibilidade com clientes. O Qwen2.5-VL, a geração anterior da Qwen, ainda funciona e continua sendo uma opção leve válida se você já o tiver baixado.
Todos os modelos de visão carregam um codificador de imagem junto aos pesos do LLM. Esse codificador adiciona 1–3 GB de VRAM além do que o modelo base apenas de texto precisa — considere esse overhead ao verificar seu orçamento de VRAM.
Error: unknown model architecture: "mllama" — a arquitetura mllama nunca foi adicionada ao llama.cpp. Isso ainda não foi resolvido no Ollama v0.33.2 (agosto de 2026). Use Qwen3-VL ou Gemma 4 no lugar dele, ou mantenha uma instalação do Ollama anterior à v0.30.0 se precisar especificamente do Llama 3.2 Vision.Requisitos de VRAM para visão
Cada modelo de visão precisa de mais VRAM que seu equivalente apenas de texto. Um modelo de visão de 7–8B normalmente requer 7–9 GB de VRAM, não os ~6 GB que você orçaria para um modelo de texto de tamanho semelhante.
Para OCR, gráficos e análise de documentos, o Qwen3-VL 8B é a opção forte mais eficiente em VRAM. Para visão mais chamadas de ferramentas em um único modelo, as variantes de 12B ou 26B-A4B MoE do Gemma 4 cabem em 8–14 GB. Para o guia completo sobre modelos locais multimodais e correspondência por caso de uso, veja o guia de LLMs locais multimodais.
| Modelo | VRAM em Q4 | Capacidade de imagem |
|---|---|---|
| LLaVA 7B | ~7 GB | Perguntas e respostas gerais sobre imagens, ampla compatibilidade |
| Qwen3-VL 8B | ~8 GB | OCR, gráficos, capturas de tela, multilíngue |
| Gemma 4 (12B) | ~8 GB | Visão + chamadas de ferramentas |
| Gemma 4 (26B-A4B MoE) | ~14 GB | Visão + chamadas de ferramentas, maior qualidade |
| Llama 3.2 Vision 11B | ~10 GB | ⚠️ Quebrado no Ollama v0.30.0+ (erro mllama) |
Guias relacionados
- ▸Rodar o Qwen 3 no Ollama -- opção multimodal com chamadas de ferramentas
- ▸Modelos Ollama com contexto de 128K -- long context models
- ▸Guia de LLMs locais multimodais -- guia completo de modelos de visão locais
- ▸Melhores modelos de visão locais 2026 -- todos os modelos de visão, todas as GPUs
Respostas rápidas sobre modelos de visão do Ollama
Como envio uma imagem ao Ollama via API?▾
/api/chat com a imagem como string base64 no array images. Corpo JSON mínimo funcional: {"model":"llava","messages":[{"role":"user","content":"What is in this image?","images":["<base64>"]}]} Veja Qwen 3 no Ollama para uma opção multimodal com forte suporte a chamadas de ferramentas.