Points clés
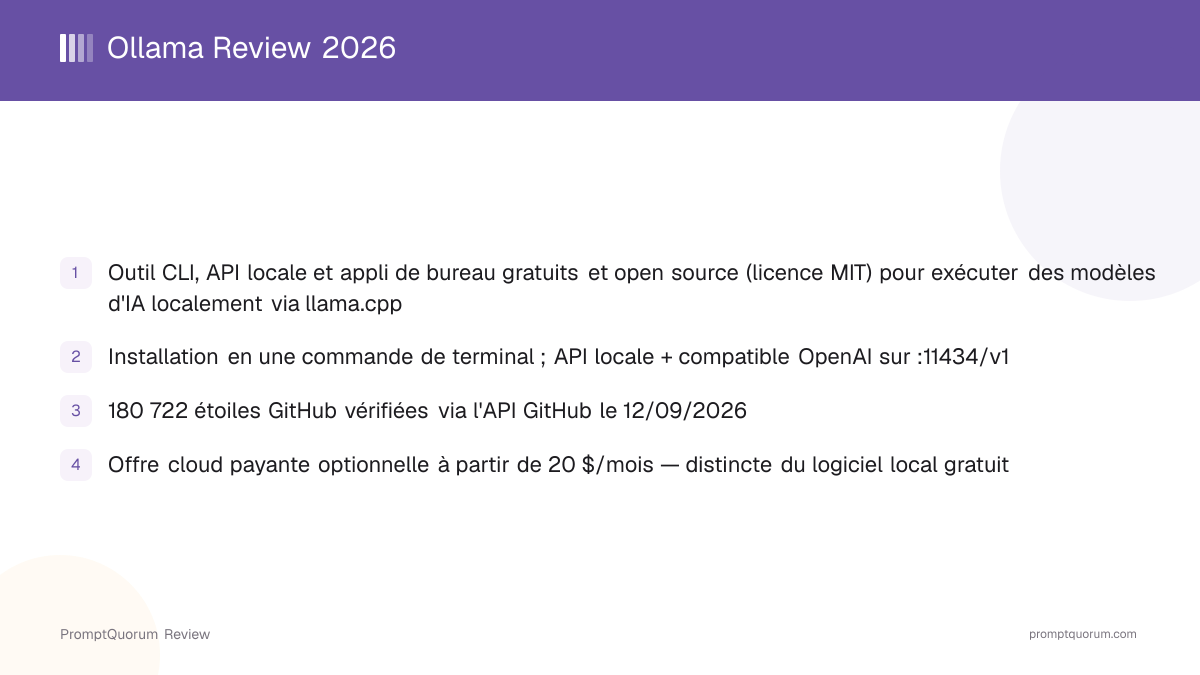
- Ollama est gratuit et open source ; la LICENSE officielle sur GitHub est la licence MIT
- Exécute des modèles locaux via un moteur intégré basé sur llama.cpp — aucune compilation ou configuration de serveur séparée nécessaire
- S'installe avec une commande sur macOS/Linux (
curl -fsSL https://ollama.com/install.sh | sh) ou une sur Windows (irm https://ollama.com/install.ps1 | iex), plus des installateurs signés, des images Docker et des paquets pour gestionnaires de paquets (Homebrew, Pacman, Nix, et autres) - Les modèles personnalisés se définissent avec un Modelfile utilisant les directives FROM, PARAMETER, TEMPLATE, SYSTEM, ADAPTER, LICENSE et MESSAGE
- Expose à la fois une API REST native (
/api/chat,/api/generate) et une API compatible OpenAI àhttp://localhost:11434/v1(/v1/chat/completions,/v1/completions,/v1/models,/v1/embeddings) - Bibliothèque de modèles sur ollama.com/library, avec des noms de modèles comme
llama3.2,gemma4,qwen3.5etgpt-ossd'après la documentation officielle actuelle ollama launchconnecte directement un modèle local à des outils de code comme Claude Code, Codex, VS Code, OpenCode et Droid- Développé par Ollama Inc., une entreprise de Palo Alto, en Californie, fondée en 2023 par Jeffrey Morgan et Michael Chiang
- Disponible sur macOS, Windows et Linux, ainsi que sur Docker Hub (
ollama/ollama) et via des gestionnaires de paquets dont Homebrew, Pacman, Nix et Guix
📍 En une phrase
Ollama est un outil en ligne de commande et une API locale gratuits et open source (licence MIT) qui téléchargent et exécutent des modèles d'IA ouverts sur votre propre ordinateur via un moteur basé sur llama.cpp, avec une offre cloud payante optionnelle pour l'inférence hébergée.
💬 En termes simples
Plutôt que de compiler manuellement un moteur d'inférence et d'écrire un serveur autour, Ollama vous donne deux commandes — télécharger un modèle, puis l'exécuter — et s'occupe du reste. Cela fonctionne comme Docker pour les modèles d'IA : une commande télécharge un modèle, une autre l'exécute, et une adresse web locale permet à d'autres programmes de lui parler comme ils parleraient à l'API d'OpenAI.
📌Remarque: Cette review est le complément détaillé de la fiche d'Ollama dans le répertoire des logiciels d'IA locale — consultez cette page pour voir comment Ollama se compare, en un coup d'œil, à des dizaines d'autres outils d'IA locale.
Qu'est-ce qu'Ollama ?
Ollama est un outil en ligne de commande, un serveur API local et (depuis juillet 2025) une application de bureau pour exécuter des modèles d'IA ouverts sur votre propre matériel. Son dépôt GitHub le décrit comme un logiciel permettant de « démarrer avec de grands modèles de langage » localement. La conception reprend délibérément le flux de travail de Docker — les deux cofondateurs avaient auparavant créé Kitematic, une interface graphique pour Docker rachetée par Docker en 2015 — si bien que ollama pull et ollama run fonctionnent de façon très similaire à docker pull et docker run.
- Fonction principale : télécharger des modèles ouverts et les exécuter localement via un moteur d'inférence intégré, avec une CLI, une API locale et une interface de chat de bureau, toutes connectées au même service en arrière-plan
- Moteur d'inférence local : construit sur llama.cpp et GGML, exécutant des modèles au format GGUF issus de la propre bibliothèque d'Ollama ou importés depuis des fichiers GGUF/Safetensors
- Interfaces : une CLI de terminal (
ollama run <modèle>), une application de bureau officielle pour macOS et Windows avec glisser-déposer de fichiers et d'images, et une API REST pour un usage programmatique - Développeur : Ollama Inc., une entreprise de Palo Alto, en Californie ; l'organisation GitHub hébergeant le code s'appelle ollama
- Dépôt canonique : github.com/ollama/ollama, sous licence MIT d'après le fichier LICENSE du dépôt
Historique et jalons de l'entreprise Ollama
Ollama a été fondée en 2023 par Jeffrey Morgan et Michael Chiang, qui se sont rencontrés à l'Université de Waterloo et avaient auparavant créé Kitematic, une interface graphique open source pour Docker rachetée par Docker en 2015 (plus tard intégrée à Docker Desktop). Ollama Inc. est basée à Palo Alto, en Californie, et a levé des fonds auprès d'investisseurs dont Benchmark et Theory Ventures, selon des trackers publics de financement de start-up ; PromptQuorum n'a pas pu vérifier de manière indépendante un montant exact de financement auprès d'une source primaire et recommande de consulter les annonces officielles d'Ollama pour des chiffres à jour.
- 12023 — Lancement du projet
Why it matters: Le dépôt GitHub d'Ollama et ses premières versions publiques ont établi le flux de travail CLI `pull`/`run` qui reste aujourd'hui le modèle d'interaction principal. - 2Juillet 2025 — Application de bureau officielle lancée
Why it matters: A ajouté une interface graphique native pour macOS et Windows avec téléchargement de modèles, chat, glisser-déposer de fichiers/images et longueur de contexte ajustable — auparavant, la CLI et des interfaces tierces (comme Open WebUI) étaient les seules options. - 32025–2026 — Extension de l'API compatible OpenAI
Why it matters: Ollama a ajouté et étendu un point de terminaison compatible OpenAI à `/v1`, couvrant les chat completions, completions, embeddings et le listing de modèles, en faisant un backend prêt à l'emploi pour les outils déjà construits sur le SDK OpenAI. - 42026 — Intégrations
ollama launch
Why it matters: A ajouté une configuration en une commande pour connecter des outils de code — Claude Code, Codex, VS Code, OpenCode et Droid — à un modèle exécuté localement, d'après la [référence CLI officielle](https://docs.ollama.com). - 52026 — Introduction de l'offre cloud
Why it matters: Ollama Inc. a commencé à proposer une inférence hébergée payante sur sa propre infrastructure (régions incluant les États-Unis, l'Europe et Singapour selon [ollama.com](https://ollama.com)) en option en plus du logiciel local gratuit, pour les utilisateurs souhaitant exécuter des modèles plus volumineux que ne le permet leur propre matériel.
Que pouvez-vous faire avec Ollama ?
L'ensemble des fonctionnalités d'Ollama vise à rendre l'inférence de modèles locale aussi simple qu'un gestionnaire de paquets plutôt qu'un projet de recherche. Voici ce que fait réellement chaque partie, d'après la documentation officielle et le README GitHub d'Ollama.
- Bibliothèque de modèles — téléchargez des modèles prêts à l'emploi depuis ollama.com/library avec une seule commande
ollama pull <modèle>; la documentation actuelle montre des exemples incluant Llama, Gemma, Qwen, gpt-oss, DeepSeek et des modèles d'embedding dédiés commenomic-embed-textetembeddinggemma - Personnalisation via Modelfile — définissez une configuration de modèle personnalisée avec un Modelfile utilisant les directives
FROM(modèle de base, requis),PARAMETER(réglages d'exécution comme la température et la longueur de contexte),TEMPLATE(format de prompt),SYSTEM(prompt système),ADAPTER(adaptateurs LoRA),LICENSEetMESSAGE(historique de conversation pré-rempli), puis compilez-le avecollama create <nom> -f Modelfile - API REST locale — une API native à
http://localhost:11434avec des points de terminaison incluant/api/generate,/api/chat,/api/embeddings,/api/pullet/api/create, documentés dans la référence API officielle - API compatible OpenAI — un second point de terminaison à
http://localhost:11434/v1implémentant/v1/chat/completions,/v1/completions,/v1/modelset/v1/embeddings, permettant aux applications écrites pour le SDK OpenAI de pointer vers Ollama en ne changeant que l'URL de base - Intégrations avec les outils de code (
ollama launch) — une commande interactive qui configure des outils externes — Claude Code, Codex, VS Code, OpenCode et Droid sont cités dans la documentation CLI actuelle — pour utiliser un modèle Ollama exécuté localement comme backend - Support multimodal et embeddings —
ollama runaccepte des entrées image pour les modèles multimodaux (la documentation CLI citellavaen exemple), et des modèles d'embedding dédiés peuvent être exécutés pour des pipelines de récupération/RAG - Application de bureau — une interface graphique native (macOS et Windows, lancée en juillet 2025) pour télécharger des modèles et discuter sans terminal, en complément de la CLI
- Offre cloud optionnelle — Ollama Inc. vend de l'inférence hébergée sur ses propres serveurs comme option payante séparée pour exécuter des modèles plus volumineux que ce que le matériel local peut gérer ; ceci n'est requis pour aucune des fonctionnalités locales ci-dessus
Exemples d'utilisation : trois façons d'utiliser Ollama
Voici des flux de travail concrets construits à partir des commandes et de l'API documentées d'Ollama ci-dessus — pas des cas d'usage hypothétiques.
Installer Ollama sur macOS, Windows et Linux
Ollama est disponible sur macOS, Windows et Linux, via des scripts d'installation en une ligne, des installateurs signés, Docker et plusieurs gestionnaires de paquets. Les commandes et liens ci-dessous proviennent de la page de téléchargement officielle et du README GitHub — vérifiez toujours directement ces pages, car les scripts et exigences d'installation peuvent changer d'une version à l'autre.
macOS
- Méthode d'installation:
- Ollama.dmg (nécessite macOS 14 Sonoma ou ultérieur) ou
curl -fsSL https://ollama.com/install.sh \| sh
Windows
- Méthode d'installation:
- Installateur signé ou
irm https://ollama.com/install.ps1 \| iexdans PowerShell
Linux
- Méthode d'installation:
curl -fsSL https://ollama.com/install.sh \| sh, ou installation manuelle selon le guide Linux officiel
Docker
- Méthode d'installation:
docker pull ollama/ollama— image officielle sur Docker Hub
Gestionnaires de paquets
- Méthode d'installation:
- Homebrew, Pacman, Nix, Guix, Gentoo, Flox, et un chart Helm pour Kubernetes — voir le README GitHub pour les noms exacts des paquets
Ollama n'a pas de configuration matérielle minimale fixe au-delà de faire tourner son système d'exploitation pris en charge — la limite pratique dépend du modèle chargé, les modèles plus volumineux nécessitant plus de RAM (ou de VRAM, pour l'accélération GPU) pour une vitesse utilisable. Vérifiez la taille d'un modèle sur ollama.com/library avant de le télécharger sur un matériel limité.
Tarifs Ollama : logiciel gratuit, cloud payant optionnel
Le logiciel Ollama — la CLI, l'API locale et l'application de bureau — est gratuit et open source. Le fichier LICENSE GitHub est la licence MIT standard, sans fonctionnalité verrouillée derrière un paiement. Séparément, Ollama Inc. vend un service cloud hébergé sur ollama.com pour exécuter des modèles plus volumineux sur ses propres serveurs plutôt que sur votre machine locale.
Logiciel local
- Prix:
- Gratuit
- Contenu:
- CLI, API REST/compatible OpenAI locale, application de bureau, personnalisation Modelfile et bibliothèque de modèles complète — fonctionne entièrement sur votre propre matériel
Cloud (gratuit)
- Prix:
- Gratuit
- Contenu:
- Accès hébergé limité à des modèles cloud selon la page de tarifs actuelle de ollama.com
Cloud Pro
- Prix:
- À partir de 20 $/mois
- Contenu:
- Crédit d'inférence hébergée et limites d'utilisation plus élevées sur les propres serveurs d'Ollama (régions incluant les États-Unis, l'Europe et Singapour, selon le site d'Ollama) — un produit payant distinct du logiciel local gratuit
Les prix et détails de l'offre cloud changent ; vérifiez directement la page de tarifs d'ollama.com avant toute décision d'achat. Rien dans l'offre cloud payante n'est requis pour installer et utiliser le logiciel local gratuit d'Ollama — le service cloud existe pour les modèles trop volumineux pour la RAM/VRAM d'une machine donnée.
Ollama vs. LM Studio
Ollama et LM Studio comptent parmi les outils les plus fréquemment recommandés pour exécuter des modèles d'IA locaux, et ils sont constamment comparés car tous deux enveloppent une inférence basée sur llama.cpp derrière une interface plus simple. La différence la plus nette est CLI-first contre GUI-first, et open source contre closed source.
Interface principale
- Ollama:
- D'abord en ligne de commande, avec une interface graphique de bureau officielle ajoutée en juillet 2025
- LM Studio:
- D'abord une application de bureau graphique ; pas de flux de travail CLI-first
Licence
- Ollama:
- MIT (entièrement open source)
- LM Studio:
- Propriétaire — gratuite pour un usage personnel et professionnel selon ses propres conditions d'utilisation, mais pas open source
API locale
- Ollama:
- API REST native plus point de terminaison compatible OpenAI à
:11434/v1 - LM Studio:
- Point de terminaison REST compatible OpenAI plus une API REST LM Studio bêta séparée
Formats de modèles
- Ollama:
- GGUF via sa propre bibliothèque et son système de Modelfile
- LM Studio:
- GGUF (via llama.cpp) et MLX (Apple Silicon)
Chat de documents intégré (RAG)
- Ollama:
- Pas une fonctionnalité intégrée — à combiner avec un client comme Open WebUI ou AnythingLLM
- LM Studio:
- Fonctionnalité intégrée « Chat with Documents »
Offre cloud optionnelle
- Ollama:
- Oui, à partir de 20 $/mois pour l'inférence hébergée
- LM Studio:
- Oui, « Bionic+ » à partir de 20 $/mois et « Pro » à partir de 100 $/mois pour des modèles hébergés et des limites plus élevées
Si vous voulez un outil scriptable, terminal-first, que d'autres applications peuvent appeler comme backend, le flux de travail d'Ollama convient plus directement. Si vous voulez une seule interface graphique aboutie avec un navigateur de modèles intégré et une fonction de chat de documents sans utiliser de terminal, évaluez LM Studio directement sur lmstudio.ai — voir le LM Studio Review complet pour les détails. Les deux sont gratuits pour leur fonctionnalité locale de base ; vérifiez les fonctionnalités actuelles sur le site de chaque projet avant de décider.
À qui s'adresse Ollama ?
Le choix d'Ollama dépend de votre aisance avec un flux de travail terminal-first et de votre besoin d'un backend scriptable que d'autres outils peuvent appeler.
Ollama face aux autres moteurs locaux
Ollama fait partie de plusieurs outils qui enveloppent l'inférence de modèles locale derrière une interface plus simple. Voici comment il se positionne face à d'autres options dans ce domaine — consultez le répertoire des logiciels d'IA locale pour le catalogue complet, et la comparaison dédiée Ollama vs. LM Studio ci-dessus pour le face-à-face le plus proche.
- LM Studio — une application de bureau GUI-first couvrant un terrain similaire (inférence locale, API compatible OpenAI) avec un navigateur de modèles intégré et une fonction de chat de documents ; voir le LM Studio Review et la section de comparaison ci-dessus pour un face-à-face direct.
- llama.cpp — le moteur d'inférence open source sur lequel Ollama lui-même est construit ; l'utiliser directement offre un contrôle de plus bas niveau (drapeaux de compilation personnalisés, chargement direct de GGUF) au prix de la commodité d'Ollama proche d'un gestionnaire de paquets. Voir l'explication de llama.cpp.
- KoboldCpp — un autre moteur d'exécution basé sur llama.cpp, historiquement populaire pour l'écriture créative et le jeu de rôle, avec une interface web intégrée ; voir le KoboldCpp Review.
- LocalAI — un moteur d'exécution open source compatible avec l'API OpenAI qui prend en charge une gamme plus large de backends de modèles au-delà de llama.cpp (y compris des modèles d'image et audio) dans un seul serveur ; voir l'explication de LocalAI.
Erreurs courantes en évaluant Ollama
La plupart des confusions autour d'Ollama viennent d'un amalgame entre le logiciel local gratuit et le produit cloud payant distinct, ou d'attentes envers des fonctionnalités (comme un RAG intégré) volontairement non incluses.
Questions fréquentes
Qu'est-ce qu'Ollama ?
Ollama (ollama.com, code source sur github.com/ollama/ollama) est un outil en ligne de commande, une API locale et une application de bureau gratuits et open source pour télécharger et exécuter des modèles d'IA ouverts sur votre propre ordinateur via un moteur intégré basé sur llama.cpp.
Ollama est-il gratuit ?
Oui. Le logiciel principal — CLI, API locale et application de bureau — est sous licence MIT et gratuit, sans fonctionnalité verrouillée derrière un paiement. Ollama Inc. vend séparément une offre cloud payante optionnelle (à partir de 20 $/mois) pour l'inférence hébergée sur ses propres serveurs ; ce produit cloud n'est pas requis pour utiliser le logiciel local gratuit.
Ollama est-il open source ? Quelle licence utilise-t-il ?
Oui. Le fichier LICENSE GitHub d'Ollama est la licence MIT standard, l'une des licences open source les plus permissives, sans obligation de copyleft.
Quelles plateformes Ollama prend-il en charge ?
macOS (14 Sonoma ou ultérieur), Windows et Linux, d'après la page de téléchargement officielle. Il est aussi distribué sous forme d'image Docker (ollama/ollama) et via des gestionnaires de paquets dont Homebrew, Pacman, Nix et Guix.
Ollama a-t-il une interface graphique, ou est-il uniquement en ligne de commande ?
Les deux. Ollama a débuté comme outil en ligne de commande et reste centré sur la CLI, mais Ollama Inc. a lancé une application de bureau officielle pour macOS et Windows en juillet 2025, ajoutant une interface de chat graphique en complément du flux de travail en terminal.
Ollama dispose-t-il d'une API compatible OpenAI ?
Oui. En plus de son API REST native à http://localhost:11434, Ollama expose un point de terminaison compatible OpenAI à http://localhost:11434/v1, couvrant /v1/chat/completions, /v1/completions, /v1/models et /v1/embeddings.
Qu'est-ce qu'un Modelfile ?
Un Modelfile est un fichier de configuration texte utilisé pour construire un modèle Ollama personnalisé. Il prend en charge les directives FROM (modèle de base, requis), PARAMETER, TEMPLATE, SYSTEM, ADAPTER, LICENSE et MESSAGE, et se compile en un modèle exécutable avec ollama create <nom> -f Modelfile.
Combien d'étoiles GitHub Ollama a-t-il ?
Le dépôt d'Ollama (github.com/ollama/ollama) affichait 180 722 étoiles au 12 septembre 2026, vérifié directement via l'API GitHub. Consultez le dépôt directement pour un chiffre à jour, car il change quotidiennement.
Qui développe Ollama ?
Ollama Inc., une entreprise basée à Palo Alto, en Californie, fondée en 2023 par Jeffrey Morgan et Michael Chiang, qui avaient auparavant créé Kitematic, une interface graphique pour Docker rachetée par Docker en 2015.
Ollama inclut-il la génération augmentée par récupération (RAG) ou le chat de documents ?
Pas de façon intégrée. Ollama fournit le moteur d'inférence et l'API ; les fonctionnalités de chat de documents et de RAG proviennent généralement d'une couche client séparée qui s'appuie dessus, comme Open WebUI ou AnythingLLM, toutes deux capables de se connecter à l'API d'Ollama.