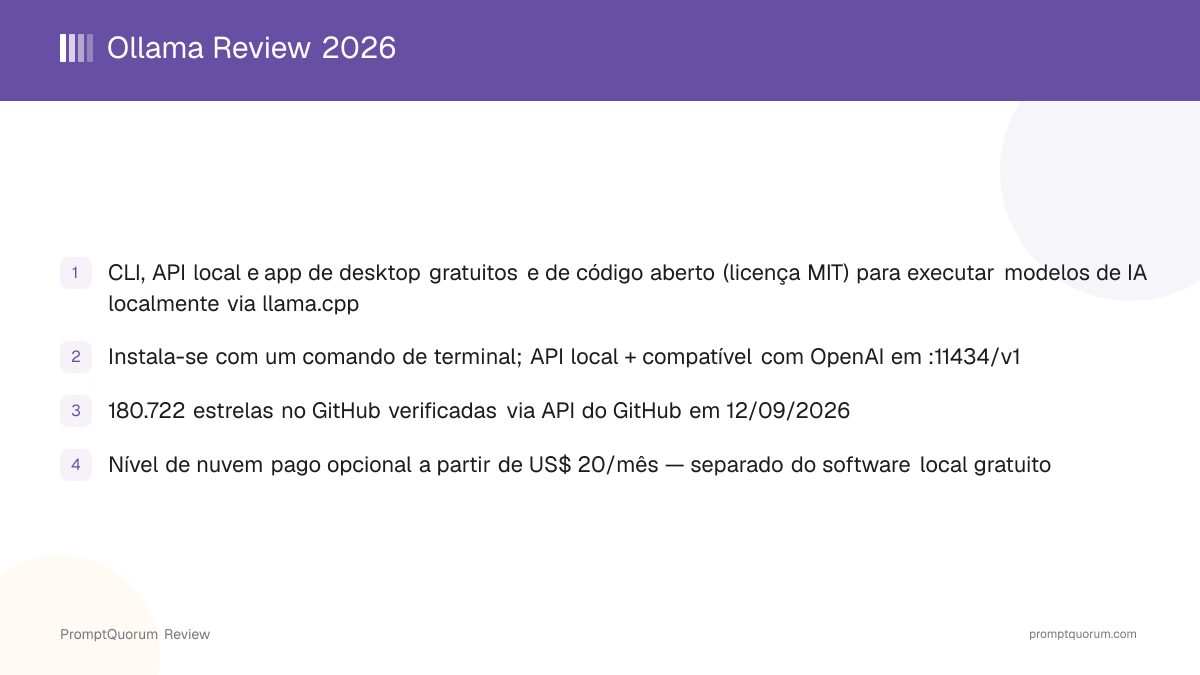
Principais conclusões
- Ollama é gratuito e de código aberto; a LICENSE oficial no GitHub é a licença MIT
- Executa modelos locais por meio de um motor embutido baseado em llama.cpp — sem necessidade de compilação ou configuração de servidor separada
- Instala-se com um comando no macOS/Linux (
curl -fsSL https://ollama.com/install.sh | sh) ou um no Windows (irm https://ollama.com/install.ps1 | iex), além de instaladores assinados, imagens Docker e pacotes para gerenciadores de pacotes (Homebrew, Pacman, Nix e outros) - Modelos personalizados são definidos com um Modelfile usando as diretivas FROM, PARAMETER, TEMPLATE, SYSTEM, ADAPTER, LICENSE e MESSAGE
- Expõe tanto uma API REST nativa (
/api/chat,/api/generate) quanto uma API compatível com OpenAI emhttp://localhost:11434/v1(/v1/chat/completions,/v1/completions,/v1/models,/v1/embeddings) - Biblioteca de modelos em ollama.com/library, com nomes de modelos como
llama3.2,gemma4,qwen3.5egpt-ossconforme a documentação oficial atual ollama launchconecta diretamente um modelo local a ferramentas de código como Claude Code, Codex, VS Code, OpenCode e Droid- Desenvolvido pela Ollama Inc., uma empresa de Palo Alto, Califórnia, fundada em 2023 por Jeffrey Morgan e Michael Chiang
- Disponível para macOS, Windows e Linux, além do Docker Hub (
ollama/ollama) e gerenciadores de pacotes incluindo Homebrew, Pacman, Nix e Guix
📍 Em uma frase
Ollama é uma ferramenta de linha de comando e uma API local gratuitas e de código aberto (licença MIT) que baixam e executam modelos de IA abertos no próprio computador por meio de um motor baseado em llama.cpp, com um nível de nuvem pago opcional para inferência hospedada.
💬 Em termos simples
Em vez de compilar manualmente um motor de inferência e escrever um servidor ao redor dele, o Ollama oferece dois comandos — baixar um modelo, depois executá-lo — e cuida do resto. Funciona como o Docker para modelos de IA: um comando baixa um modelo, outro o executa, e um endereço web local permite que outros programas conversem com ele da mesma forma que conversariam com a API da OpenAI.
📌Nota: Esta review é o complemento aprofundado da entrada do Ollama no diretório de software de IA local — veja essa página para comparar rapidamente o Ollama com dezenas de outras ferramentas de IA local.
O que é o Ollama?
Ollama é uma ferramenta de linha de comando, um servidor API local e (desde julho de 2025) um aplicativo de desktop para executar modelos de IA abertos no próprio hardware. Seu repositório no GitHub o descreve como software para "começar a rodar grandes modelos de linguagem" localmente. O design imita intencionalmente o fluxo de trabalho do Docker — os dois cofundadores haviam criado anteriormente o Kitematic, uma GUI para o Docker adquirida pela Docker em 2015 — de modo que ollama pull e ollama run funcionam de forma bem parecida a docker pull e docker run.
- Função principal: baixar modelos abertos e executá-los localmente por meio de um motor de inferência embutido, com uma CLI, uma API local e uma interface de chat de desktop, todas se comunicando com o mesmo serviço em segundo plano
- Motor de inferência local: construído sobre llama.cpp e GGML, executando modelos empacotados em formato GGUF da própria biblioteca do Ollama ou importados de arquivos GGUF/Safetensors
- Interfaces: uma CLI de terminal (
ollama run <modelo>), um aplicativo de desktop oficial para macOS e Windows com entrada de arquivos e imagens por arrastar e soltar, e uma API REST para uso programático - Desenvolvedor: Ollama Inc., uma empresa de Palo Alto, Califórnia; a organização no GitHub que hospeda o código se chama ollama
- Repositório canônico: github.com/ollama/ollama, com licença MIT segundo o arquivo LICENSE do repositório
Histórico e marcos da empresa Ollama
O Ollama foi fundado em 2023 por Jeffrey Morgan e Michael Chiang, que se conheceram na Universidade de Waterloo e haviam criado anteriormente o Kitematic, uma GUI de código aberto para o Docker adquirida pela Docker em 2015 (mais tarde incorporada ao Docker Desktop). A Ollama Inc. está sediada em Palo Alto, Califórnia, e captou investimento de risco de investidores como Benchmark e Theory Ventures, segundo rastreadores públicos de financiamento de startups; a PromptQuorum não conseguiu verificar de forma independente um valor exato de financiamento a partir de uma fonte primária e recomenda consultar os anúncios oficiais do Ollama para números atuais.
- 12023 — Lançamento do projeto
Why it matters: O repositório no GitHub do Ollama e seus primeiros lançamentos públicos estabeleceram o fluxo de trabalho de CLI `pull`/`run` que continua sendo o modelo de interação principal até hoje. - 2Julho de 2025 — Lançamento do aplicativo de desktop oficial
Why it matters: Adicionou uma GUI nativa para macOS e Windows com download de modelos, chat, entrada de arquivos/imagens por arrastar e soltar, e comprimento de contexto ajustável — antes, a CLI e GUIs de terceiros (como o Open WebUI) eram as únicas interfaces. - 32025–2026 — Expansão da API compatível com OpenAI
Why it matters: O Ollama adicionou e expandiu um endpoint compatível com OpenAI em `/v1`, cobrindo chat completions, completions, embeddings e listagem de modelos, tornando-o um backend plug-and-play para ferramentas já construídas sobre o SDK da OpenAI. - 42026 — Integrações
ollama launch
Why it matters: Adicionou configuração em um único comando para conectar ferramentas de código — Claude Code, Codex, VS Code, OpenCode e Droid — a um modelo rodando localmente, segundo a [referência oficial da CLI](https://docs.ollama.com). - 52026 — Introdução do nível de nuvem
Why it matters: A Ollama Inc. começou a oferecer inferência hospedada paga em sua própria infraestrutura (regiões incluindo EUA, Europa e Cingapura, segundo [ollama.com](https://ollama.com)) como opção ao lado do software local gratuito, para usuários que querem executar modelos maiores do que seu próprio hardware suporta.
O que você pode fazer com o Ollama?
O conjunto de recursos do Ollama tem como foco fazer a inferência de modelos locais parecer um gerenciador de pacotes em vez de um projeto de pesquisa. Aqui está o que cada parte realmente faz, segundo a documentação oficial e o README do GitHub do Ollama.
- Biblioteca de modelos — baixe modelos prontos para uso em ollama.com/library com um único comando
ollama pull <modelo>; a documentação atual mostra exemplos incluindo Llama, Gemma, Qwen, gpt-oss, DeepSeek e modelos de embedding dedicados comonomic-embed-texteembeddinggemma - Personalização com Modelfile — defina uma configuração de modelo personalizada com um Modelfile usando as diretivas
FROM(modelo base, obrigatório),PARAMETER(configurações de execução como temperatura e comprimento de contexto),TEMPLATE(formato do prompt),SYSTEM(prompt de sistema),ADAPTER(adaptadores LoRA),LICENSEeMESSAGE(histórico de conversa pré-definido), e então compile-o comollama create <nome> -f Modelfile - API REST local — uma API nativa em
http://localhost:11434com endpoints incluindo/api/generate,/api/chat,/api/embeddings,/api/pulle/api/create, documentados na referência oficial da API - API compatível com OpenAI — um segundo endpoint em
http://localhost:11434/v1implementando/v1/chat/completions,/v1/completions,/v1/modelse/v1/embeddings, para que aplicações escritas contra o SDK da OpenAI possam apontar para o Ollama alterando apenas a URL base - Integrações com ferramentas de código (
ollama launch) — um comando interativo que configura ferramentas externas — a documentação atual da CLI cita Claude Code, Codex, VS Code, OpenCode e Droid — para usar um modelo do Ollama rodando localmente como backend - Suporte multimodal e de embeddings —
ollama runaceita entrada de imagem para modelos multimodais (a documentação da CLI usallavacomo exemplo), e modelos de embedding dedicados podem ser executados para pipelines de recuperação/RAG - Aplicativo de desktop — uma GUI nativa (macOS e Windows, lançada em julho de 2025) para baixar modelos e conversar sem terminal, além da CLI
- Nível de nuvem opcional — a Ollama Inc. vende inferência hospedada em seus próprios servidores como opção paga separada para executar modelos maiores do que o hardware local consegue processar; isso não é exigido para nenhum dos recursos locais acima
Exemplos de uso: três formas de usar o Ollama
Estes são fluxos de trabalho concretos construídos a partir dos comandos e da API documentados do Ollama acima — não casos de uso hipotéticos.
Instalar o Ollama no macOS, Windows e Linux
O Ollama está disponível para macOS, Windows e Linux, por meio de scripts de instalação de uma linha, instaladores assinados, Docker e vários gerenciadores de pacotes. Os comandos e links abaixo vêm da página de downloads oficial e do README no GitHub — sempre confira diretamente nessas páginas, já que scripts e requisitos de instalação podem mudar entre versões.
macOS
- Método de instalação:
- Ollama.dmg (exige macOS 14 Sonoma ou posterior) ou
curl -fsSL https://ollama.com/install.sh \| sh
Windows
- Método de instalação:
- Instalador assinado ou
irm https://ollama.com/install.ps1 \| iexno PowerShell
Linux
- Método de instalação:
curl -fsSL https://ollama.com/install.sh \| sh, ou instalação manual conforme o guia oficial para Linux
Docker
- Método de instalação:
docker pull ollama/ollama— imagem oficial no Docker Hub
Gerenciadores de pacotes
- Método de instalação:
- Homebrew, Pacman, Nix, Guix, Gentoo, Flox, e um chart Helm para Kubernetes — veja o README no GitHub para os nomes exatos dos pacotes
O Ollama não tem um mínimo de hardware fixo além de rodar seu sistema operacional compatível — o limite prático depende do modelo carregado, já que modelos maiores exigem mais RAM (ou VRAM, para aceleração por GPU) para velocidade utilizável. Verifique o tamanho de um modelo em ollama.com/library antes de baixá-lo em hardware limitado.
Preços do Ollama: software gratuito, nuvem paga opcional
O software do Ollama — a CLI, a API local e o aplicativo de desktop — é gratuito e de código aberto. O arquivo LICENSE do GitHub é a licença MIT padrão, sem nenhum recurso bloqueado por pagamento. Separadamente, a Ollama Inc. vende um serviço de nuvem hospedado em ollama.com para executar modelos maiores em seus próprios servidores em vez da sua máquina local.
Software local
- Preço:
- Gratuito
- O que inclui:
- CLI, API REST/compatível com OpenAI local, aplicativo de desktop, personalização com Modelfile e a biblioteca completa de modelos — roda inteiramente no seu próprio hardware
Nuvem (gratuito)
- Preço:
- Gratuito
- O que inclui:
- Acesso hospedado limitado a modelos na nuvem, conforme a página de preços atual de ollama.com
Nuvem Pro
- Preço:
- A partir de US$ 20/mês
- O que inclui:
- Crédito de inferência hospedada e limites de uso mais altos nos próprios servidores do Ollama (regiões incluindo EUA, Europa e Cingapura, segundo o próprio site do Ollama) — um produto pago separado do software local gratuito
Preços e detalhes do nível de nuvem mudam; confira diretamente a página de preços de ollama.com antes de tomar uma decisão de compra. Nada no nível de nuvem pago é exigido para instalar e usar o software local gratuito do Ollama — o serviço de nuvem existe para modelos grandes demais para a RAM/VRAM de uma determinada máquina.
Ollama vs. LM Studio
Ollama e LM Studio estão entre as ferramentas mais recomendadas para executar modelos de IA locais, e são constantemente comparados porque ambos empacotam inferência baseada em llama.cpp por trás de uma interface mais simples. A diferença mais clara é CLI-first versus GUI-first, e código aberto versus código fechado.
Interface principal
- Ollama:
- Linha de comando em primeiro lugar, com uma GUI de desktop oficial adicionada em julho de 2025
- LM Studio:
- Aplicativo de desktop gráfico em primeiro lugar; sem fluxo de trabalho CLI-first
Licença
- Ollama:
- MIT (totalmente de código aberto)
- LM Studio:
- Proprietária — gratuita para uso pessoal e empresarial segundo seus próprios termos de serviço, mas não é de código aberto
API local
- Ollama:
- API REST nativa mais endpoint compatível com OpenAI em
:11434/v1 - LM Studio:
- Endpoint REST compatível com OpenAI mais uma API REST separada do LM Studio em beta
Formatos de modelo
- Ollama:
- GGUF por meio de sua própria biblioteca e sistema de Modelfile
- LM Studio:
- GGUF (via llama.cpp) e MLX (Apple Silicon)
Chat de documentos embutido (RAG)
- Ollama:
- Não é um recurso embutido — combine com um cliente como Open WebUI ou AnythingLLM
- LM Studio:
- Recurso embutido "Chat with Documents"
Nível de nuvem opcional
- Ollama:
- Sim, a partir de US$ 20/mês para inferência hospedada
- LM Studio:
- Sim, "Bionic+" a partir de US$ 20/mês e "Pro" a partir de US$ 100/mês para modelos hospedados e limites mais altos
Se você quer uma ferramenta programável, centrada em terminal, que outras aplicações possam chamar como backend, o fluxo de trabalho do Ollama encaixa mais diretamente. Se você quer uma única GUI polida com um navegador de modelos embutido e um recurso de chat de documentos sem usar o terminal, avalie o LM Studio diretamente em lmstudio.ai — veja a review completa do LM Studio para detalhes. Ambos são gratuitos para sua funcionalidade local principal; verifique os recursos atuais no site de cada projeto antes de decidir.
Quem deveria usar o Ollama?
Se o Ollama é adequado depende de você se sentir confortável com um fluxo de trabalho centrado em terminal e querer um backend programável que outras ferramentas possam chamar.
Ollama em comparação a outros runtimes locais
O Ollama é uma de várias ferramentas que empacotam inferência de modelos locais por trás de uma interface mais simples. Veja como ele se posiciona em relação a outras opções nesse espaço — veja o diretório de software de IA local para o catálogo completo, e a comparação dedicada Ollama vs. LM Studio acima para o confronto mais próximo.
- LM Studio — um aplicativo de desktop GUI-first cobrindo terreno semelhante (inferência local, API compatível com OpenAI) com um navegador de modelos embutido e um recurso de chat de documentos; veja a review do LM Studio e a seção de comparação acima para um confronto direto.
- llama.cpp — o motor de inferência de código aberto sobre o qual o próprio Ollama é construído; usá-lo diretamente oferece controle de nível mais baixo (flags de compilação personalizadas, carregamento direto de GGUF) ao custo da conveniência do Ollama parecida com gerenciador de pacotes. Veja a explicação do llama.cpp.
- KoboldCpp — outro runtime baseado em llama.cpp, historicamente popular para escrita criativa e roleplay com uma interface web embutida; veja a review do KoboldCpp.
- LocalAI — um runtime de código aberto compatível com a API da OpenAI que suporta uma gama mais ampla de backends de modelo além do llama.cpp (incluindo modelos de imagem e áudio) em um único servidor; veja a explicação do LocalAI.
Erros comuns ao avaliar o Ollama
A maior parte da confusão sobre o Ollama vem de misturar o software local gratuito com o produto de nuvem pago separado, ou de esperar recursos (como RAG embutido) que ele não inclui por design.
Perguntas frequentes
O que é o Ollama?
Ollama (ollama.com, código-fonte em github.com/ollama/ollama) é uma ferramenta de linha de comando, uma API local e um aplicativo de desktop gratuitos e de código aberto para baixar e executar modelos de IA abertos no próprio computador por meio de um motor embutido baseado em llama.cpp.
O Ollama é gratuito?
Sim. O software principal — CLI, API local e aplicativo de desktop — tem licença MIT e é gratuito, sem nenhum recurso bloqueado por pagamento. A Ollama Inc. vende separadamente um nível de nuvem pago opcional (a partir de US$ 20/mês) para inferência hospedada em seus próprios servidores; esse produto de nuvem não é exigido para usar o software local gratuito.
O Ollama é de código aberto? Qual licença ele usa?
Sim. O arquivo LICENSE do GitHub do Ollama é a licença MIT padrão, uma das licenças de código aberto mais permissivas, sem obrigação de copyleft.
Quais plataformas o Ollama suporta?
macOS (14 Sonoma ou posterior), Windows e Linux, segundo a página de downloads oficial. Também é distribuído como imagem Docker (ollama/ollama) e por gerenciadores de pacotes incluindo Homebrew, Pacman, Nix e Guix.
O Ollama tem interface gráfica, ou é só CLI?
As duas coisas. O Ollama começou como ferramenta de linha de comando e continua centrado na CLI, mas a Ollama Inc. lançou um aplicativo de desktop oficial para macOS e Windows em julho de 2025, adicionando uma interface de chat gráfica ao lado do fluxo de trabalho de terminal.
O Ollama tem uma API compatível com OpenAI?
Sim. Além de sua API REST nativa em http://localhost:11434, o Ollama expõe um endpoint compatível com OpenAI em http://localhost:11434/v1, cobrindo /v1/chat/completions, /v1/completions, /v1/models e /v1/embeddings.
O que é um Modelfile?
Um Modelfile é um arquivo de configuração em texto usado para construir um modelo Ollama personalizado. Ele suporta as diretivas FROM (modelo base, obrigatório), PARAMETER, TEMPLATE, SYSTEM, ADAPTER, LICENSE e MESSAGE, e é compilado em um modelo executável com ollama create <nome> -f Modelfile.
Quantas estrelas no GitHub o Ollama tem?
O repositório do Ollama (github.com/ollama/ollama) mostrava 180.722 estrelas em 12 de setembro de 2026, verificado diretamente via API do GitHub. Consulte o repositório diretamente para um número atual, já que muda diariamente.
Quem desenvolve o Ollama?
Ollama Inc., uma empresa sediada em Palo Alto, Califórnia, fundada em 2023 por Jeffrey Morgan e Michael Chiang, que anteriormente criaram o Kitematic, uma GUI do Docker adquirida pela Docker em 2015.
O Ollama inclui geração aumentada por recuperação (RAG) ou chat de documentos?
Não de forma embutida. O Ollama fornece o motor de inferência e a API; a funcionalidade de chat de documentos e RAG geralmente vem de uma camada de cliente separada construída sobre ele, como Open WebUI ou AnythingLLM, ambos capazes de se conectar à API do Ollama.