重要なポイント
- 「無検閲」とは、モデルがRLHFの安全ファインチューニングを削減していることを意味し、制約が一切ないわけではありません。 無検閲ファインチューンは引き続き指示形式に従い、キャラクターの一貫性を維持し、プロンプトで誘導できます。「何でも許可」のシステムではありません。
- 2026年のフィクション作家向け最良選択はHermes 3 Llama 3.3です。 任意拒否が少なく、強力な指示追従性、良好なキャラクターボイス分化。一部の完全無検閲モデルが生成するような攻撃的な出力を望まない作家に適しています。
- 標準命令チューニングモデルも優れたプロンプトで大半の成人向け文学コンテンツを処理できます。 暴力、道徳的複雑性、ダークな心理、文学散文における成人向けテーマは、無検閲ファインチューンをほとんど必要としません。拒否するのは明示的な性的コンテンツと現実的な有害の詳細な描写です。モデルを切り替える前に、あなたの作品がどのカテゴリに属するかを把握してください。
- ローカルで実行することで、データは機外に出ません。 クラウドのToSは適用されません。コンテンツはログ記録、分析、トレーニングに使用されません。これが作家がローカル無検閲モデルを使用する主な構造的理由です――プライバシーとフィクションにおける使用制限なし。
- ToS執行がないからといって倫理的責任が消えるわけではありません。 無検閲モデルで作成したフィクションを配布する作家は、他の著者と同じ法的責任を負います:未成年者、実在人物、扇動、管轄区域固有の猥褻法はすべて、生成方法に関わらず適用されます。
- Dolphin 3.0 Mistralは16〜24 GBのリグ向けの軽量オプションです。 Hermes 3より広い無検閲出力範囲ですが、複雑な場面での指示追従性は弱い。短編フィクション、プロンプト探索、スタイルテストに適しています。
- SillyTavernとAgnaiのどちらも無検閲Ollamaモデルとクリーンに接続できます。 どちらのフロントエンドもOllamaのOpenAI互換エンドポイントを指し、無検閲モデルを選択するだけです。追加設定は不要。
クイックファクト
- テストした無検閲モデル: Hermes 3 Llama 3.3(主)、Dolphin 3.0 Mistral(副)。
- バックエンド: Ollama(主)、LM Studio(GUIセットアップの代替)。
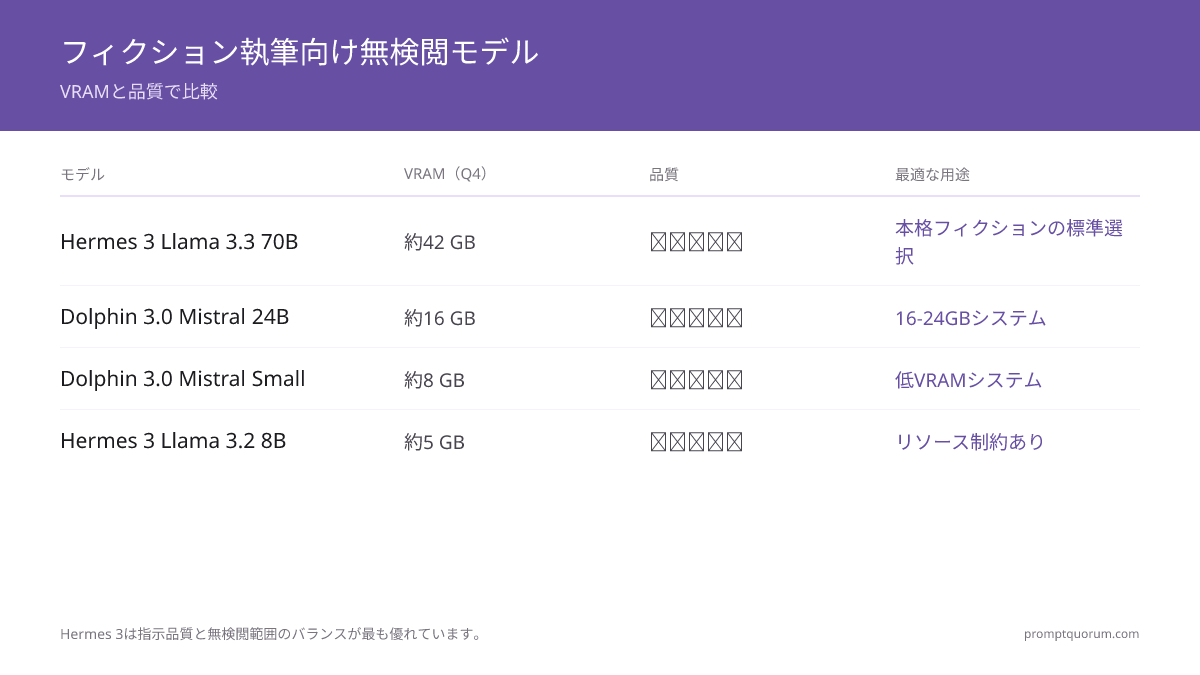
- ハードウェア: Hermes 3 70B(Q4)は約42 GB必要。Dolphin 3.0 7Bは8 GBで動作、Dolphin 3.0 24Bは約16 GBで動作。
- フロントエンド: SillyTavern、Agnai、RisuAIはすべてOpenAI互換エンドポイント経由で無検閲Ollamaモデルと接続可能。
- プライバシー: 完全ローカル ― クラウドAPI呼び出しなし、ログなし、トレーニングデータ収集なし。
- 絶対的な倫理的制限: 未成年者を含む性的コンテンツなし(絶対禁止)、識別可能な実在人物の非合意的な性的描写なし、現実の暴力を促進するコンテンツなし。
- 配布: 公開・配布・共有するコンテンツは、生成方法に関わらず著作者の責任を負う。
「無検閲」が実際に意味すること
ローカルLLMファインチューンの文脈での「無検閲」とは、RLHF(人間のフィードバックからの強化学習)の安全トレーニングを削減することを意味し、すべてのモデル制約を除去することではありません。 標準命令チューニングモデルは、特定のコンテンツカテゴリを拒否させるRLHF層でトレーニングされています:明示的な性的コンテンツ、詳細な暴力、現実的な有害テンプレートに似たダークな心理。無検閲ファインチューン(Hermes 3、Dolphin、Wizard、Erebus)はベースモデルからこれらのRLHF層を削除または削減し、指示追従能力を維持しながら拒否動作を除去します。結果として、ダークなコンテンツを通じてフィクションプロンプトに従い、リダイレクト、説教、場面途中での停止を行わないモデルになります。
📍 一文で説明
無検閲ローカルLLMファインチューンはRLHF安全拒否層を除去しながら指示追従能力を維持します――リダイレクト、説教、場面途中での停止なしにダークな創作方向に従います。
💬 簡潔に説明
Llama 3.3 70Bのような標準モデルは、拷問、道徳的に複雑な悪役の独白、または明示的なロマンティックコンテンツを描写する場面の途中で停止し、拒否するかソフトにします。同じベース上の無検閲版であるHermes 3は、同じ品質レベルで中断なく同じ場面を通じてプロンプトに従います。散文の品質は同等で、違いは拒否層にあります。
- 削除されるもの: 特定のコンテンツカテゴリの拒否動作(明示的な性的コンテンツ、グラフィックな暴力、ダークな心理コンテンツ)。
- 維持されるもの: 指示追従、キャラクターの一貫性、プロンプト構造の遵守、言語品質。
- 無検閲の度合い: Hermes 3は選択的に無検閲(成人向けコンテンツOK、ただし極端なコンテンツにはある程度のガードレールを維持)。Dolphinシリーズはより広く無検閲。完全アブリテレートモデル(Wizard-Uncensored、Erebus)はガードレール除去が最も積極的ですが、複雑なフィクションタスクでは指示追従が最も弱い。
- ベースモデルの品質が重要: ベースモデルが弱ければ、無検閲化は指示品質を劣化させます。Llama 3.3 70B上のHermes 3はLlama 3.3の強力な指示追従を維持。Mistral Small上のDolphin 3.0はより小さなベースによって制限されます。
- 呼び方の違い: 日本語では「無検閲」「検閲なし」「非検閲」「無修正」「規制なし」「無規制」「制限なし」がほぼ同じ意味で使われ、英語の uncensored / unrestricted / abliterated に対応します。「無修正」はアダルトメディア由来の口語表現ですが、ローカルLLMの文脈では本記事の「無検閲」と同じくRLHFの拒否層を外したファインチューンを指します。モデルを探すときは uncensored / abliterated / dolphin といったタグが目印になります。
💡ヒント: 無検閲は制御不能を意味しません。無検閲モデルはプロンプト構造に従い、語数上限を守り、キャラクターの声を維持し、修正指示に応答します。違いは、未要求のコンテンツ警告を追加せず、道徳的にダークな方向を拒否せず、場面が害を描写していることを指摘するためにキャラクターを崩さないことです。フィクション執筆テンプレートの構造化プロンプトを、他のモデルと同様に使用してください――システムプロンプトとユーザープロンプトの区別は、モデルの無検閲レベルよりも重要です。その理由はシステムプロンプトとユーザープロンプトの違いを参照してください。
テスト方法
このガイドのモデル評価は小規模な定性的テストに基づいています――方向性の指標であり、査読ベンチマークではありません。センシティブなテーマのモデル推奨を信頼するかどうかを判断する読者のために、方法論の透明性が重要です。
- ソース資料: Nous Research (Hermes 3) と Cognitive Computations (Dolphin 3.0) からのモデルカード、クリエイタードキュメント、公開キャパビリティステートメント。
- 拒否率分類: 文書化されたビヘイビアパターンおよびモデルクリエイターのコンテンツ処理に関する声明に基づく。
- ドリフト評価: ユーザーレポート、モデルドキュメント、ファインチューニングアプローチの説明により知らされている。
- バックエンド参照: 再現性のためのOllama 0.5+ (Q4_K_M量子化) ――測定基盤ではない。
- 誠実さの制約: これは情報ガイドであり、ベンチマークではありません。ドリフトと拒否率の分類は文書化されたビヘイビアパターンを反映しており、正確な測定ではありません。ユーザーは自分のワークフローで動作を確認すべき。
フィクションにおける無検閲モデルの適切な用途
無検閲モデルは、あなたのフィクションが本当にクラウドサービスが拒否するコンテンツを必要とし、読者が成人であり、目的が創作表現である場合に適切です。 ほとんどのフィクション作家は、以下の特定の用途で無検閲モデルを利用します。
- 悪役心理と独白: 道徳的に一貫した悪役キャラクターで、独白の途中でモデルがキャラクターを崩して免責事項を追加することなく展開できる。
- 成人向けのロマンティックおよび性的コンテンツ: クラウドサービスがブロックする性的コンテンツを必要とするロマンス、エロティカ、または文学フィクションにおける成人フィクションキャラクター間の明示的な場面。
- ジャンルフィクションでのグラフィックな暴力: 戦争小説、犯罪スリラー、ホラー――暴力が感情的インパクトに不可欠で、軟化させると場面が台無しになる。
- トラウマと心理的な暗さ: サバイバーのナラティブ、依存症フィクション、虐待のストーリーライン――正真正銘の重みを持つために、飾り気のない描写が必要なコンテンツ。
- 道徳的に信頼できない語り手: 間違っている語り手、害を合理化する語り手、フィクション内で残酷または偏見を持つ語り手――モデルが通常拒否する見解を表明する必要があるキャラクター。
- ダークなロールプレイと協働フィクション: 対立、道徳的複雑性、成人向けテーマを含む長期的なシナリオで、標準モデルが拒否を挿入してフィクションを壊す場合。
💡ヒント: 無検閲モデルに切り替える前に、まず標準命令チューニングモデルでプロンプトをテストしてください。よく構造化されたシステムプロンプトと場面制約を使ったLlama 3.3 70BとQwen3 32Bは、拒否なしで大半の成人向け文学コンテンツを生成します。無検閲ファインチューンは明示的な性的コンテンツと最も極端な暴力の描写に最も価値を発揮します――心理的な暗さ、道徳的複雑性、またはダークなテーマ全般には必要ありません。
適切でない場面
クラウド執行がないことは、法的・倫理的義務がないことを意味しません。 これらのカテゴリは、モデル、プラットフォーム、またはマシンがエアギャップかどうかに関わらず適用される絶対的な制限を表しています。
- 未成年者を含む性的コンテンツ: フィクション的フレーミングまたは生成方法に関わらず、すべての主要管轄区域で絶対的な法的禁止。これはモデルポリシーではなく法律です。
- 実在人物の非合意的な性的描写: NCII法は、増加している管轄区域において識別可能な実在人物のAI生成コンテンツに適用されます。「AIが生成した」は抗弁になりません。
- 現実の害を促進するために設計されたコンテンツ: フィクション的フレーミングを使用して、現実の暴力や害を直接可能にする情報やコンテンツを抽出することは、フィクション保護を除去します。
- 著作者責任なしの公開配布: 公開・配布・共有するコンテンツは著作者の責任を負います。「AIが生成した」はその責任を移転しません。
- ハラスメントフィクション: 特定の実在人物を傷つけ、脅迫し、またはハラスメントすることを目的とするフィクションを生成すること――フィクションとして表現されているかどうかに関わらず。
⚠️注意: 設定に関わらず絶対的な制限。ローカル設定は以下に対する法的・倫理的責任を除去しません:(1)未成年者を含む性的コンテンツ――ほぼすべての管轄区域で法律上の絶対禁止;(2)識別可能な実在人物の非合意的な性的描写――生成方法に関わらずNCII(非合意的な性的画像)に該当;(3)特定のターゲットに対する現実の暴力を促進するために設計されたコンテンツ。これらの制限は、モデルがローカル、クラウド、またはエアギャップマシンで動作していても適用されます。
モデル比較:フィクション向けの無検閲オプション
すべての無検閲モデルが同等ではありません――RLHF除去の度合いとベースモデルの品質の両方が、フィクション執筆ユースケースに重要です。
- 注意:古い無検閲ファインチューン――Midnight Miqu(Miqu-70Bベース)、Wizard-LM Uncensored、Mythomax――は2024年にはリーダーでしたが、2026年には品質と指示追従性の指標でHermes 3とDolphin 3.0に追い抜かれています。古い記事で推奨されていても、現在の同等品はHermes 3(選択的無検閲向け)とDolphin 3.0(より広い範囲向け)です。
モデル | ベース | VRAM (Q4) | 拒否率 | 指示品質 | 極端化傾向 | 最適用途 |
|---|---|---|---|---|---|---|
| Hermes 3 Llama 3.3 70B | Llama 3.3 70B | ~42 GB | 選択的 | ★★★★★ | 低 | 本格的フィクションのデフォルト選択 ― 最高の指示追従性と無検閲能力 |
| Dolphin 3.0 Mistral 24B | Mistral 24B | ~16 GB | 広範 | ★★★★☆ | 低〜中 | 16〜24 GBシステム;広い範囲での成人向けコンテンツ |
| Dolphin 3.0 Mistral Small | Mistral Small | ~8 GB | 広範 | ★★★☆☆ | 中 | 低VRAMシステム;短編草稿、プロンプトテスト |
| Hermes 3 Llama 3.2 8B | Llama 3.2 8B | ~5 GB | 選択的 | ★★★☆☆ | 低 | リソース制限環境;対話と短い場面 |
| Standard Llama 3.3 70B | Llama 3.3 70B | ~42 GB | 限定的 | ★★★★★ | なし | ダークなテーマ、道徳的複雑性、暴力 ― 明示的な性的コンテンツ不要の場合 |

💡ヒント: 最も積極的な無検閲ファインチューンではなく、Hermes 3から始めてください。完全アブリテレートモデル(Wizard-Uncensored、Erebus)は最も広いコンテンツ範囲を持ちますが、複雑なフィクションタスクでの指示追従性が著しく低い――制約からの離脱が早く、長い生成では品質が低い散文を生成し、キャラクターの声の維持が信頼性に欠けます。無検閲コンテンツと品質散文の両方を必要とするフィクションには、Hermes 3の方がより良いトレードオフです。
日本語で書く場合のモデル選び
日本語の小説を書く場合、本記事の推奨順位は変わります――無検閲ファインチューンはいずれも英語中心のベースモデル上に構築されており、日本語の生成品質はベースモデルの多言語対応力にそのまま依存するためです。 低VRAM環境向けの第一候補であるDolphin 3.0のMistral系は、日本語の訓練データが最小限で日本語タスクには推奨できません。日本語を主言語にするなら、収まる範囲で最大のLlama系ベース(Hermes 3 Llama 3.3 70B)を選ぶか、英語で生成してから日本語に書き直す二段階の手順を取るのが現実的です。日本語ネイティブのモデル選びそのものは日本語ローカルLLMの比較で扱っています。
📍 一文で説明
無検閲ローカルLLMはいずれも英語中心のベースモデル上に作られているため、日本語の小説では収まる範囲で最大のLlama系ベースを選ぶか、英語で生成してから日本語に書き直す二段階の手順が現実的です。
💬 簡潔に説明
無検閲モデルは「拒否をなくす」ための追加学習を英語のデータで行っています。そのため日本語で書かせると、英語のときより文章が不安定になります。日本語をたくさん書かせたい場合は、大きめのLlama系モデルを使うか、まず英語で書かせてから日本語に直す二段構えが安全です。
- Mistral系は日本語に不向き: Mistral Smallは日本語の訓練データが最小限で、日本語タスクには推奨されません。Dolphin 3.0 Mistral 24BとMistral Smallは低VRAM環境の無検閲用途としては有力ですが、その利点は日本語では相殺されます。
- Llama系は使えるが日本語特化モデルには及ばない: Llama 3.1 8Bクラスは日本語ベンチマークで日本語特化モデルより30〜40%低い水準です。Hermes 3 Llama 3.3 70Bはベースが大きい分だけ安定しますが、無検閲ファインチューン自体が主に英語データで行われるため、ベースが持つ日本語力はさらに薄まります。
- 日本語は速度も落ちる: 漢字・ひらがな・カタカナがそれぞれトークンを消費するため、英語比で有効トークン/秒が約20〜30%低下します。英語で20 tok/sのモデルは日本語では約14〜16 tok/s相当になります。
- 量子化の下限が上がる: 日本語では量子化の影響が英語より大きく、Q4_K_Mが推奨最低ラインです。Q3_K_Mは日本語テキストで約5〜10%の品質低下を示し、長い文章やフォーマルな文体で顕著になります。日本語用途でQ2は使用しないでください。
- 日本語ネイティブの無検閲ファインチューンは実質的に存在しない: ELYZAやRinnaのような日本語特化モデルには、検証された無検閲版がありません。日本語の分量が多い原稿では、無検閲モデルで英語の下書きを作り、日本語側は自分で書き直す二段階の手順が最も安定します。
💡ヒント: 日本語での出力品質を確かめる最短の方法は、同じ場面を英語と日本語の両方で生成して読み比べることです。同じプロンプト・同じ量子化で日本語側だけ文体が崩れる、敬体と常体が混ざる、キャラクターの一人称が途中で変わる――こうした症状が出る場合、原因はモデルの無検閲度ではなくベースモデルの日本語力です。より大きなLlama系ベースに移すか、二段階の手順に切り替えてください。
セットアップ:OllamaとLM Studio
OllamaとLM StudioはともにOpenAI互換のローカルAPI経由で無検閲モデルを提供します――つまり、SillyTavern、Agnai、ローカルエンドポイントと通信するその他のツールは追加設定なしで動作します。
Ollama:Hermes 3のプルと実行
“# Pull the model ollama pull nous-hermes3:70b-llama3.3-q4_K_M # Run it ollama run nous-hermes3:70b-llama3.3-q4_K_M # Serve via API (for SillyTavern / Agnai / LM Studio-compatible tools) ollama serve # API available at http://localhost:11434”
Ollama:Dolphin 3.0 Mistral 24Bのプルと実行
“# Pull the model ollama pull dolphin3:24b-mistral-q4_K_M # Verify it loaded ollama list # Run a test prompt ollama run dolphin3:24b-mistral-q4_K_M "Write a 100-word villain monologue, gothic register, no disclaimers."”
- Ollamaのインストール:
brew install ollama(macOS)またはollama.comからダウンロード(Windows/Linux)。ollama serveコマンドでhttp://localhost:11434にOpenAI互換APIが起動します。 - LM Studioのインストール: lmstudio.aiからダウンロード。GGUFモデルファイルを直接インポート。ローカルサーバータブが
http://localhost:1234にOpenAI互換エンドポイントを公開します。 - SillyTavern接続: API設定で「OpenAI互換」を選択し、ベースURLを
http://localhost:11434/v1(Ollama)またはhttp://localhost:1234/v1(LM Studio)に設定。APIキーフィールドには任意の文字列を入力(フィールドで必須ですがローカルでは検証されません)。 - Agnai接続: 同じOpenAI互換エンドポイント。アダプター設定でローカルURLを入力。SillyTavernのセットアップと同一です。
- モデル切り替え: Ollamaで`ollama run [model-name]`で標準モデルと無検閲モデルを切り替え――複数のモデルを同時にロードでき、サーバーを再起動せずにセッション単位で切り替えられます。
💡ヒント: 無検閲モデルと標準モデルを分けておきたい作家は、OLLAMA_HOST環境変数を使って異なるポートに2つのOllamaインスタンスを作成してください。例:OLLAMA_HOST=127.0.0.1:11435 ollama serve。これにより、SillyTavernやAgnaiを無検閲インスタンスに向けながら、標準Ollamaインスタンスを他のタスクに維持できます。
残る倫理的責任
クラウドポリシー執行なしでモデルをローカルで実行しても、著作者および発行者としての責任は除去されません。 人間が執筆するフィクションに適用される倫理的フレームワークは、AI支援フィクションにも等しく適用されます。
📍 一文で説明
ローカルセットアップはクラウドToS制限を除去しますが、著作者の法的責任、害の促進責任、または公開された創作物に適用される倫理的義務は除去しません。
💬 簡潔に説明
ローカル無検閲モデルを、あなたがどんな指示でも従う非常に有能な執筆アシスタントだと考えてください。あなたが生産・配布するものの法的・倫理的重みはあなたにあり、ツールにはありません。未成年者、実在人物、猥褻、扇動に関する同じ法律が、公開配布されるAI生成フィクションにも適用されます。プラットフォームがローカルでのコンテンツ生成を禁止しないことは、それを公開した場合にあなたが法的に負う責任を変えません。
- 著作者責任(日本): 日本では、AIが生成したコンテンツを配布する場合、著作者として扱われます。「AIが生成した」は著作権を移転せず、法律に違反するコンテンツに対する責任を除去しません。METI(経済産業省)の2024年AIガバナンスガイドラインは、企業展開において生成AIシステムの安全性・透明性・責任を明確に要求しています。
- アジア太平洋地域のデータ残留: 日本のAPPI(個人情報保護法)は、個人を特定できるコンテンツを処理する場合に適用されます。フィクション作家がクラウドモデルではなくローカルモデルを使用する主な利点の1つは、データが国内(またはデバイス上)に留まることです。これはAPPI準拠において重要です。METI AI事業者ガイドラインは公正性と透明性も要求しており、企業ユーザーは記録の保持を検討すべきです。
- 管轄区域の認識: 猥褻、NCII、有害コンテンツ法は管轄区域によって異なります。日本での違反の可能性があるコンテンツには、児童ポルノ禁止法(第7条)、名誉毀損(刑法第230条)、わいせつ物頒布(刑法第175条)が含まれます。
- 実在人物: 明らかにフィクション的フレームでも、識別可能な実在人物についての否定的なフィクションコンテンツを生成することは、コンテンツに応じて名誉毀損とNCIIリスクを伴います。
- 配布のための年齢確認: 無検閲モデルで生成した成人向けコンテンツを公開プラットフォームで配布する場合、成人向けコンテンツ発行者に適用される年齢確認義務があなたにも適用されます。
- 責任あるアーカイブ: ローカル生成の無検閲コンテンツは、他の機密素材と同じストレージ規律で扱うべきです――クラウド同期ディレクトリには保存せず、意図せず共有しないこと。
⚠️注意: 無検閲モデルを使用する作家の最も一般的な倫理的誤りは、ローカル生成をコンテキストフリーゾーンとして扱うことです。ローカル生成はプラットフォームポリシー執行がないことを意味します――法律なし、責任なし、害なしを意味しません。コンテンツモデレーターの不在は許可を付与しません。
フィクション作家のための実践的なワークフロー
無検閲モデルを使用するほとんどのフィクション作家は、標準モデルのデフォルトの置き換えとしてではなく、特定の場面に使用します。 以下のワークフローはこのターゲットを絞った使用をサポートします。
- 標準モデルで標準的な場面を草稿する。 Llama 3.3 70BまたはQwen3 32Bは、ダークなテーマ、道徳的複雑性、心理的深さを含む大半の文学散文を処理します。標準モデルが拒否するコンテンツを特に必要とする場面のために無検閲モデルを予約してください。
- ターゲットを絞った場面には無検閲に切り替える。 Ollamaで特定の場面に
ollama run nous-hermes3:70b-llama3.3-q4_K_Mを実行。SillyTavernでは、セッションごとにAPI設定でモデルを変更。セッション間でデータは移動しません。 - 同じプロンプトテンプレートを使用する。 フィクション作家向けローカルLLMプロンプトの5パート場面テンプレート、サブテキスト対話構造、キャラクター矛盾プロンプトは無検閲モデルで同一に機能します。異なるプロンプト構造は必要ありません。
- 法的理由で人間向けのブリーフに入れないようなコンテンツ生成指示を追加しない。 モデルはツールであり、許可構造ではありません。法的理由で人間のイラストレーターやゴーストライターへのブリーフに含めない指示は、モデルプロンプトにも含めないでください。
- 配布前に出力をレビューする。 無検閲モデルは時折要求された暗さを超えたり、ステレオタイプ化したりするコンテンツを生成します。AI支援コンテンツの標準的な編集レビューを適用してください。

💡ヒント: ライティングプロジェクトごとに「モデルログ」を保持してください――どのモデルがどの場面を生成したかを記録するプレーンテキストファイル。改訂に役立ち(どのモデルが場面を生成したかを知ることで、どこに改訂リクエストを向けるかがわかります)、AI支援を開示する場合の帰属の透明性のため、後で場面が問題になった場合の監査のために有用です。
よくある間違い
- 最も積極的な無検閲モデルをデフォルトにすること。 完全アブリテレートモデル(Wizard-Uncensored、Erebus)は複雑な場面での指示追従が最も弱い。Hermes 3はフィクション品質にとってより良いトレードオフです。
- 標準モデルが生成するコンテンツに無検閲モデルを使用すること。 文学散文での道徳的複雑性、ダークな心理、暴力、成人向けテーマは、無検閲ファインチューンをほとんど必要としません。切り替える前に正確に何が必要かを把握してください。
- ローカル生成を法的コンテキストフリーゾーンとして扱うこと。 クラウドポリシー執行がないことは法律がないことではありません。配布、実在人物、未成年者に対する著作者責任は関係なく適用されます。
- 語数上限を指定しないこと。 無検閲モデルはスペースを埋めるためにダークなコンテンツをパッドするのは他のモデルと同様です。フィクションテンプレートからの同じ語数上限制約を使用してください。
- クラウド同期ディレクトリに出力を保存すること。 iCloud、Google Drive、またはOneDriveに同期されたローカル生成の成人向けコンテンツは、それらのプラットフォームの利用規約に違反する可能性があります。ローカルのみに保存してください。
情報源
- Hermes 3モデルカードとファインチューニング手法 ― Nous Research
- Dolphin 3.0 Mistral技術ドキュメント ― Cognitive Computations / Eric Hartford
- RLHFとアライメント技術の概要 ― Anthropic Research
- EU AI法第5条 ― 未成年者を含むコンテンツを含む禁止AI慣行 ― EUR-Lex
- NCII(非合意的な性的画像)― 法的フレームワーク概要 ― Cyber Civil Rights Initiative
よくある質問
LM Studioで無検閲モデルを使うには設定変更が必要ですか?
不要です。LM Studio自体に検閲層はなく、拒否が出るかどうかは読み込んだモデルの性質だけで決まります。標準モデルが拒否するのはLM Studioの設定ではなくモデル側のRLHF層によるもので、設定画面で解除できる項目ではありません。Hermes 3やDolphin 3.0のGGUFファイルを読み込めば、追加設定なしで無検閲の挙動になります。ローカルサーバータブからhttp://localhost:1234にOpenAI互換エンドポイントを公開すれば、SillyTavernやAgnaiからも同じモデルを使えます。
「脱獄(ジェイルブレイク)」と無検閲モデルは同じものですか?
別のものです。脱獄は、検閲のかかったクラウドモデルに対してプロンプトの工夫で拒否を回避させる手法を指します。モデルの重み自体は変わっておらず、提供元の利用規約に違反する可能性があり、対策が入れば効かなくなります。無検閲モデルは拒否層そのものを追加学習で外した重みを自分のハードウェアで動かすもので、プロンプトの小細工を必要とせず、提供元のサーバーを経由しません。フィクション執筆で結果の安定性が必要なら、脱獄プロンプトより無検閲モデルのほうが確実です。
無検閲モデルは無料ですか。NSFWコンテンツにも使えますか?
本記事で扱うモデルはすべて無料で、Ollamaのモデルライブラリやモデル配布サイトからダウンロードできます。かかる費用は電気代と、モデルを動かすハードウェアだけです。NSFWを含む成人向けの描写も技術的には生成できますが、それが適切なのは成人読者向けの創作フィクションに使う場合に限られます。実在人物の非合意的な描写、未成年者を性的文脈に置くコンテンツ、現実の加害に転用できる手順の生成は、ローカル実行で技術的に可能であっても許容されません。詳しくは「適切でない場面」の節を参照してください。
無検閲のローカル画像生成にも同じモデルを使えますか?
使えません。本記事で扱う無検閲モデルはテキスト生成用の大規模言語モデル(LLM)で、画像は生成しません。ローカルでの画像生成はStable Diffusionのような拡散モデルと、ComfyUIやAUTOMATIC1111といった別系統のツールを使います。仕組みが異なるため、OllamaやLM Studioで画像生成モデルを動かすことはできません。小説の挿絵など画像も必要な場合は、テキスト用と画像用で別々の環境を用意することになります。
無検閲ローカルLLMは日本語で小説を書けますか?
書けますが、英語の場合とモデル選びが変わります。Hermes 3やDolphin 3.0のような無検閲ファインチューンは主に英語データで追加学習されているため、ベースのLlama 3.3やMistralが持っていた日本語力が薄まる傾向があります。日本語の分量が多い原稿では、多言語データを厚く学習したQwen3 32Bのような多言語ベースのモデルを使うか、英語で生成してから日本語に書き直すワークフローのほうが安定します。日本語はトークン消費も大きいため、同じコンテキスト長でも実際に入る文字数は英語より少なくなります。
「無修正モデル」「非検閲モデル」は無検閲モデルと違うものですか?
同じものを指します。ローカルLLMの文脈では「無検閲」「検閲なし」「非検閲」「無修正」「規制なし」「無規制」はいずれもRLHFの拒否層を外したファインチューンのことで、技術的な区別はありません。「無修正」はアダルトメディア由来の口語表現、「非検閲」はやや硬い表現という語感の差だけです。Ollamaやモデル配布ページで探すときは uncensored、abliterated、dolphin といった英語のタグが目印になります。
無検閲ローカルLLMの実行は合法ですか?
無検閲ローカルLLMの実行はほとんどの管轄区域で合法です――オープンソースAIソフトウェアを所持することを禁じる法律はありません。それで生成・配布するものは、他の著作コンテンツと同じ法律に従います:猥褻法、NCII法、名誉毀損法、および未成年者を含むコンテンツに関する法律。実行が合法であることは、無制限に公開・共有・配布することが合法であることを意味しません。
Hermes 3とDolphin 3.0の違いは何ですか?
Hermes 3(Nous Research)は選択的に無検閲――成人向けコンテンツの拒否を削減しながら、極端なカテゴリにはある程度のガードレールを維持しています。指示追従性は優れており、ベースのLlama 3.3 70Bモデルに近い。Dolphin 3.0(Cognitive Computations)はより広いコンテンツ範囲で広く無検閲ですが、複雑な多制約の場面では指示追従性がやや弱い。Hermes 3は散文の品質が重要なフィクションのデフォルト選択として優れており、Dolphin 3.0は16〜24 GBシステムで最も広いコンテンツ範囲が必要な場合の選択です。
ダークなフィクションを書くために無検閲モデルが必要ですか?
ほとんどのダークフィクションには必要ありません。Llama 3.3 70BやQwen3 32Bのような標準命令チューニングモデルは、適切にプロンプトを与えれば暴力、道徳的複雑性、ダークな心理、悪役の内面、トラウマ、ほとんどの文学的暗さを拒否なしで生成します。確実に拒否するのは明示的な性的コンテンツと、より狭い範囲の極端なシナリオです。ダークフィクションに明示的な性的コンテンツが含まれていない場合は、まず標準モデルを試してください――無検閲版が必要でないかもしれません。
SillyTavernやAgnaiで無検閲モデルを使用できますか?
はい。SillyTavernもAgnaiも、ポート11434でローカルに動作するOllamaを含む、OpenAI互換エンドポイントに接続します。Ollamaで無検閲モデルをプル、ollama serveを開始し、SillyTavernまたはAgnaiでOpenAI互換APIを選択してhttp://localhost:11434/v1を指定します。モデルリストから無検閲モデルを選択するだけです。追加設定は不要です。
ホームネットワークで無検閲モデルを使用しても安全ですか?
localhost(OllamaとLM Studioのデフォルト設定)にバインドするよう設定されている場合は安全です。APIはあなたのマシンからしかアクセスできません。ホームネットワークにポートを公開する場合(電話からアクセスするためなど)、ファイアウォールルールが信頼できるデバイスにのみアクセスを制限するようにしてください。認証なしでOllama APIをパブリックインターネットに公開しないでください――デフォルト設定には認証がありません。
ローカルで生成したコンテンツはどうなりますか?
自動的には何も起きません。ローカル生成コンテンツはいかなるサーバーにも送信されず、クラウドサービスにログ記録されず、モデルトレーニングに使用されません。チャット履歴ファイル、キャラクターカードなど、アプリケーションのローカルストレージ内でのみあなたのデバイスに存在します。保持するもの、削除するもの、共有するものをあなたが管理します。これがクラウドベースの代替に対してローカル無検閲生成が持つ主要な構造的プライバシー上の優位性です。
同じライティングプロジェクトで無検閲モデルと標準モデルを混在させることはできますか?
はい、これが推奨ワークフローです。散文の大部分には標準モデル(Llama 3.3 70B、Qwen3 32B)を使用してください――標準モデルはほとんどのダークなコンテンツに高品質な文学散文を生成します。標準モデルが拒否するコンテンツを必要とする特定の場面には、Hermes 3またはDolphin 3.0に切り替えてください。同じプロンプトテンプレートが両方で機能します。散文スタイルは十分に一貫しているため、場面単位の混在は出力で検出できません。
無検閲モデルでの生成は著作権に影響しますか?
いいえ――AI生成コンテンツの著作権状況は、モデルが検閲されているかどうかに関わらず同一です。AIアウトプットの著作権法は2026年時点でほとんどの管轄区域で未解決です。一般的な立場は、人間が著作した要素(プロンプトデザイン、選択、配置、実質的な編集)は保護可能かもしれませんが、生のAIアウトプットはそうではないというものです。無検閲モデルの使用はこの分析を変えません。
無検閲ファインチューンは一般知識を失いますか?
狭い領域ではわずかに失います。無検閲化ファインチューンは通常、ベースモデルから事実記憶、数学、コーディングベンチマークでわずかに逸脱する可能性のある完全精度の再トレーニングパスです――通常、標準ベンチマークで1〜3パーセントポイント。フィクション執筆タスクでは、出力品質で検出できません。フィクションと技術作業(研究ノート、コードレビュー)の両方に同じモデルが必要な場合は、標準版と無検閲版の両方をインストールしておき、タスクに応じて切り替えてください。Hermes 3は完全アブリテレートモデルより一般的な能力をより良く維持します。
これらのモデルは監視されていますか、それとも匿名ですか?
OllamaまたはLM Studio経由でローカルで動作するオープンウェイトモデルには、テレメトリ、リモートロギング、使用状況追跡がありません。モデルの作者(Hermes 3のNous Research、DolphinのCognitive Computations)は生成内容を見ることができません――推論中にサーバーコールバックはありません。テレメトリのリスクがあるのはフロントエンド(SillyTavern、Agnai――両方ともデフォルトでテレメトリなし)またはOSからのみです。インストール後に一度ネットワークモニター(macOSのLittle Snitch、LinuxのWireshark)を実行して確認してください。
コンテンツ制限のないローカルLLMはどれですか?
本記事で扱う無検閲・「abliterated」ファインチューン――Hermes 3やDolphin 3.0を含む――は拒否層を追加学習で外してあるため、独自のコンテンツポリシーを持ちません。これがローカルモデルとホスト型モデルの実務上の違いです:クラウドプロバイダーはリクエストごとに利用規約を適用しますが、自分のマシンで動く無規制モデルには介在するプロバイダーがなく、推論時に検閲もかかりません。そのためNSFWや明示的なフィクションはブロックされません。変わらないのは居住地の法律と、公開に伴う責任です――コンテンツポリシーがないことは、限界がないことと同じではありません。その境界線については後述の倫理の節で扱います。