Faits rapides
- Modèles non censurés testés : Hermes 3 Llama 3.1 (principal), Dolphin 3.0 Mistral (secondaire).
- Backends : Ollama (principal), LM Studio (alternative pour configuration GUI).
- Matériel : Hermes 3 70B en Q4 nécessite ~42 Go ; Dolphin 3.0 7B fonctionne sur 8 Go ; Dolphin 3.0 24B fonctionne sur ~16 Go.
- Interfaces : SillyTavern, Agnai, RisuAI s'associent tous avec les modèles Ollama non censurés via l'endpoint compatible OpenAI.
- Confidentialité : tout en local — pas d'appels API cloud, pas de journalisation, pas de collecte de données d'entraînement.
- Limites éthiques absolues : aucun contenu sexuel impliquant des mineurs (interdiction absolue), aucune représentation sexuelle non consentie de personnes réelles identifiables, aucun contenu conçu pour faciliter une violence réelle.
- Distribution : les contenus que tu publies engagent ta responsabilité d'auteur quelle que soit la méthode de génération.
Ce que « non censuré » signifie réellement
« Non censuré » dans le contexte des fine-tunes de LLM locaux signifie un entraînement de sécurité RLHF (apprentissage par renforcement à partir des retours humains) réduit — pas la suppression de toutes les contraintes du modèle. Les modèles instruction-tuned standard sont entraînés avec des couches RLHF qui leur font refuser des catégories spécifiques de contenu : contenu sexuel explicite, violence détaillée, psychologie sombre ressemblant à un modèle de préjudice réel. Les fine-tunes non censurés (Hermes 3, Dolphin, Wizard, Erebus) suppriment ou réduisent ces couches RLHF du modèle de base, laissant la capacité de suivi d'instructions intacte mais supprimant les comportements de refus. Le résultat est un modèle qui suit tes prompts de fiction à travers du contenu sombre sans rediriger, moraliser ou s'arrêter en milieu de scène.
📍 En une phrase
Les fine-tunes de LLM locaux non censurés suppriment les couches de refus de sécurité RLHF tout en conservant la capacité de suivi d'instructions — ils suivent les orientations créatives sombres sans rediriger, moraliser ni s'arrêter en milieu de scène.
💬 En termes simples
Un modèle standard comme Llama 3.3 70B s'arrêtera au milieu d'une scène représentant de la torture, le monologue d'un villain moralement complexe, ou du contenu romantique explicite, et refusera ou adoucira la sortie. Hermes 3 (la version non censurée sur la même base) suivra ton prompt à travers la même scène au même niveau de qualité sans interruption. La qualité de la prose est équivalente ; la différence réside dans la couche de refus.
- Ce qui est supprimé : les comportements de refus pour des catégories de contenu spécifiques (contenu sexuel explicite, violence graphique, contenu psychologique sombre).
- Ce qui est conservé : le suivi d'instructions, la cohérence des personnages, le respect de la structure des prompts, la qualité linguistique.
- Degrés de non-censure : Hermes 3 est sélectivement non censuré (contenu mature oui, mais conserve certaines barrières pour le contenu extrême). La série Dolphin est plus largement non censurée. Les modèles entièrement ablitérés (Wizard-Uncensored, Erebus) ont la suppression des barrières la plus agressive — et la qualité d'instruction la plus faible pour les tâches de fiction complexes.
- La qualité du modèle de base compte : la non-censure dégrade la qualité d'instruction si le modèle de base est faible. Hermes 3 sur Llama 3.3 70B conserve le fort suivi d'instructions de Llama 3.3 ; Dolphin 3.0 sur Mistral Small est limité par la base plus petite.
💡Astuce: Non censuré ne signifie pas ingouvernable. Les modèles non censurés respectent toujours la structure des prompts, les limites de mots, la voix des personnages et répondent aux instructions de révision. La différence, c'est qu'ils n'ajoutent pas d'avertissements de contenu non sollicités, ne refusent pas les orientations moralement sombres ni ne brisent le personnage pour signaler qu'une scène dépeint du tort. Utilise des prompts structurés issus des modèles d'écriture fictionnelle comme avec n'importe quel autre modèle — la distinction prompt système / prompt utilisateur compte plus que le niveau de non-censure du modèle. Voir Prompt système vs prompt utilisateur pour comprendre pourquoi.
Comment nous avons évalué ces modèles
Les verdicts sur les modèles dans ce guide sont basés sur les capacités documentées des créateurs de modèles, les rapports publics et la documentation utilisateur — et non sur des tests pratiques indépendants réalisés par PromptQuorum. Pour un sujet où les lecteurs décident s'ils peuvent faire confiance aux recommandations de modèles sur un sujet sensible, la transparence sur la méthode compte.
- Matériel source : Fiches de modèles, documentation des créateurs et déclarations de capacités publiées par Nous Research (Hermes 3) et Cognitive Computations (Dolphin 3.0).
- Classification du taux de refus : Basée sur les modes de comportement documentés et les déclarations des créateurs de modèles sur le traitement du contenu.
- Évaluation de dérive : Informée par les rapports d'utilisateurs, la documentation du modèle et les descriptions de l'approche de fine-tuning.
- Référence backend : Ollama 0.5+ avec quantification Q4_K_M pour la reproductibilité — pas comme base de mesure.
- Contrainte d'honnêteté : Ceci est un guide informatif, pas un benchmark. Les classifications de dérive vers l'extrême et de taux de refus reflètent les modes de comportement documentés, pas les mesures précises. Les utilisateurs doivent vérifier le comportement dans leurs propres workflows.
Quand les modèles non censurés sont adaptés à la fiction
Les modèles non censurés sont appropriés quand ta fiction a genuinement besoin de contenu que les services cloud refusent, que ton audience est adulte, et que le but est l'expression créative. La plupart des auteurs de fiction recourent aux modèles non censurés pour un ou plusieurs de ces cas d'usage spécifiques.
- Psychologie et monologues de villain : personnages de villain moralement cohérents qui ne sont pas interrompus par le modèle brisant le personnage pour ajouter des avertissements en milieu de monologue.
- Contenu romantique et sexuel mature : scènes explicites entre personnages fictionnels adultes dans la romance, l'érotisme ou la fiction littéraire qui nécessitent du contenu sexuel que les services cloud bloquent.
- Violence graphique dans la fiction de genre : romans de guerre, thrillers policiers, horreur — scènes où la violence est essentielle à l'impact émotionnel et où l'adoucir tue la scène.
- Traumatisme et noirceur psychologique : récits de survivants, fiction sur l'addiction, histoires d'abus — contenu qui nécessite une représentation brute pour avoir un poids authentique.
- Narrateurs moralement peu fiables : narrateurs qui ont tort, qui rationalisent le tort, qui sont cruels ou intolérants dans la fiction — personnages qui nécessitent que le modèle exprime des points de vue qu'il refuserait normalement.
- Jeu de rôle sombre et fiction collaborative : scénarios de longue durée impliquant des conflits, de la complexité morale et des thèmes matures où un modèle standard brise la fiction pour insérer des refus.
💡Astuce: Avant de passer à un modèle non censuré, teste ton prompt sur un modèle instruction-tuned standard. Llama 3.3 70B et Qwen3 32B avec un prompt système bien structuré et des contraintes de scène génèrent la plupart des contenus littéraires matures sans refus. Les fine-tunes non censurés apportent le plus de valeur pour le contenu sexuel explicite et les représentations les plus extrêmes de la violence — pas pour la noirceur psychologique, la complexité morale ou les thèmes sombres en général.
Quand les modèles non censurés ne sont pas appropriés
L'absence d'application des règles cloud ne signifie pas l'absence d'obligations légales et éthiques. Ces catégories représentent des limites absolues qui s'appliquent quel que soit le modèle, la plateforme ou l'isolation de ta machine.
- Contenu sexuel impliquant des mineurs : interdiction légale absolue dans toutes les grandes juridictions quelle que soit le cadrage fictionnel ou la méthode de génération. Ce n'est pas une politique de modèle — c'est la loi.
- Représentations sexuelles non consenties de personnes réelles : les lois sur les NCII s'appliquent aux contenus générés par IA de personnes réelles identifiables dans un nombre croissant de juridictions. « Généré par IA » n'est pas une défense.
- Contenu conçu pour faciliter un préjudice réel : utiliser un cadre fictionnel pour extraire des informations ou du contenu qui permet directement une violence ou un préjudice réel supprime la protection fictionnelle.
- Distribution publique sans responsabilité d'auteur : les contenus que tu publies, distribues ou partages engagent ta responsabilité d'auteur. « Une IA l'a généré » ne transfère pas cette responsabilité.
- Fiction de harcèlement : générer de la fiction dont le but est de nuire, d'intimider ou de harceler une personne réelle spécifique — quel que soit le cadre fictionnel.
⚠️Attention: Limites absolues quelle que soit la configuration. Aucune configuration locale ne supprime la responsabilité légale ou éthique pour : (1) le contenu sexuel impliquant des mineurs — interdiction absolue sous la loi dans pratiquement toutes les juridictions ; (2) les représentations sexuelles non consenties de personnes réelles identifiables — cela constitue une NCII (intimate imagery non consentie) quelle que soit la méthode de génération ; (3) le contenu conçu pour faciliter une violence réelle contre des cibles spécifiques. Ces limites s'appliquent que ton modèle fonctionne localement, dans un cloud ou sur une machine isolée.
Comparaison des modèles : options non censurées pour la fiction
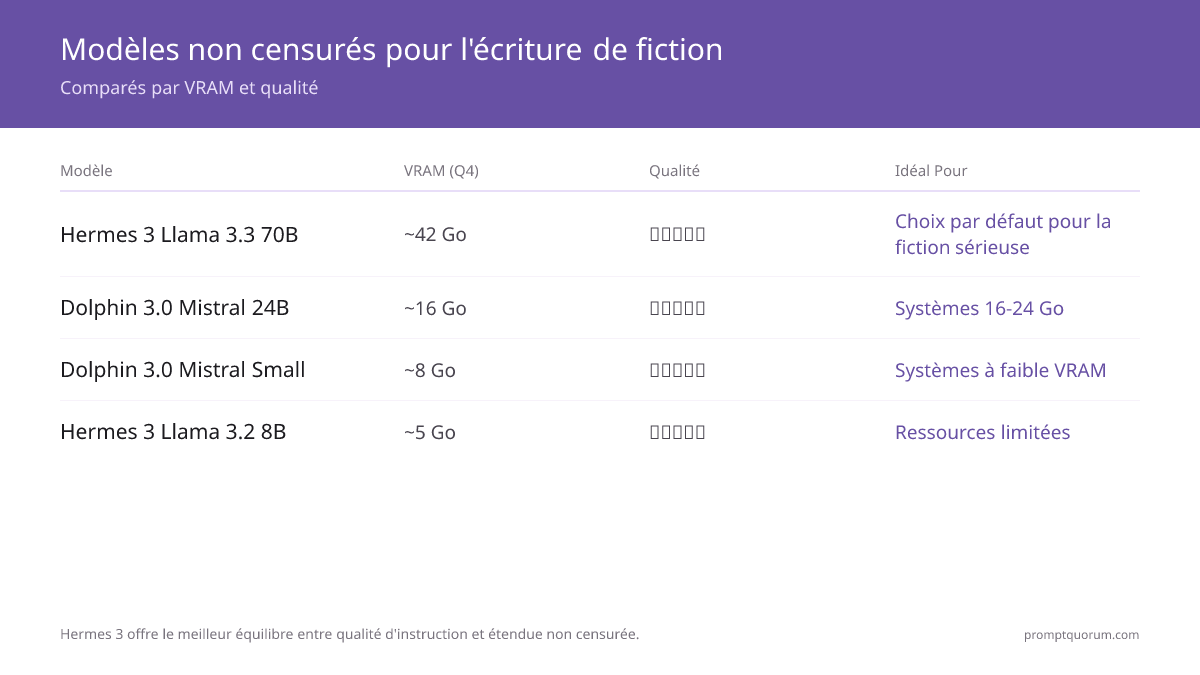
Tous les modèles non censurés ne se valent pas — le degré de suppression RLHF et la qualité du modèle de base comptent tous deux pour les cas d'usage d'écriture fictionnelle.
- Note : les anciens fine-tunes non censurés — Midnight Miqu (basé sur Miqu-70B), Wizard-LM Uncensored, Mythomax — étaient des références en 2024 mais ont été dépassés par Hermes 3 et Dolphin 3.0 en 2026 sur la qualité et les métriques de suivi d'instructions. Si tu les trouves recommandés dans des articles plus anciens, les équivalents actuels sont Hermes 3 (pour la non-censure sélective) et Dolphin 3.0 (pour une plage plus large).
Modèle | Base | VRAM (Q4) | Taux de refus | Qualité d'instruction | Dérive vers l'extrême | Idéal pour |
|---|---|---|---|---|---|---|
| Hermes 3 Llama 3.3 70B | Llama 3.3 70B | ~42 Go | Sélectif | ★★★★★ | Faible | Choix par défaut pour la fiction sérieuse — meilleur suivi d'instructions + capacité non censurée |
| Dolphin 3.0 Mistral 24B | Mistral 24B | ~16 Go | Large | ★★★★☆ | Faible à modérée | Systèmes 16–24 Go ; contenu mature sur une plus large plage |
| Dolphin 3.0 Mistral Small | Mistral Small | ~8 Go | Large | ★★★☆☆ | Modérée | Systèmes à VRAM limitée ; ébauches courtes, test de prompts |
| Hermes 3 Llama 3.2 8B | Llama 3.2 8B | ~5 Go | Sélectif | ★★★☆☆ | Faible | Ressources limitées ; dialogues et scènes courtes |
| Standard Llama 3.3 70B | Llama 3.3 70B | ~42 Go | Limité | ★★★★★ | Aucune | Thèmes sombres, complexité morale, violence — sans contenu sexuel explicite |

💡Astuce: Commence par Hermes 3, pas par le fine-tune non censuré le plus agressif. Les modèles entièrement ablitérés (Wizard-Uncensored, Erebus) ont la plage de contenu la plus large mais un suivi d'instructions nettement plus faible dans les tâches de fiction complexes — ils dérivent plus vite des contraintes, produisent une prose de moins bonne qualité sur de longues générations et maintiennent la voix des personnages moins fidèlement. Pour de la fiction nécessitant à la fois du contenu non censuré et une prose de qualité, Hermes 3 est le meilleur compromis.
Meilleurs LLM locaux non censurés, classés par palier matériel
Ces sept modèles sont classés par taille de fichier Q4_K_M, du plus petit au plus grand. Cet ordre est éditorial et suit des paliers matériels ; ce n'est pas un classement de benchmark. Choisissez la dernière ligne dont la taille de fichier tient confortablement dans la VRAM de votre GPU ou la mémoire unifiée de votre Mac. Les tailles proviennent du dépôt GGUF de chaque modèle sur Hugging Face ; le cache de contexte et l'exécution demandent de la mémoire en plus des poids, prévoyez donc une marge au-dessus de la taille du fichier. Les limites juridiques et éthiques de Ethical Responsibilities That Remain s'appliquent à chaque modèle de cette liste.
Ollama : lancer les modèles du classement
“# Ollama library tags (hermes3 default = 8B, 4.7 GB per the library page) ollama run hermes3 ollama run dolphin3 ollama run hermes3:70b # Any GGUF on Hugging Face; the quant tag after the colon is optional (default Q4_K_M) ollama run hf.co/mlabonne/Meta-Llama-3.1-8B-Instruct-abliterated-GGUF ollama run hf.co/bartowski/cognitivecomputations_Dolphin3.0-R1-Mistral-24B-GGUF:Q4_K_M ollama run hf.co/mlabonne/gemma-3-27b-it-abliterated-GGUF:Q4_K_M ollama run hf.co/NousResearch/Hermes-4.3-36B-GGUF:Q4_K_M”
LM Studio : télécharger une quantification
“# LM Studio CLI: search and download; @ selects the quantization lms get <model-name>@q4_k_m # GGUF files you downloaded yourself can also be imported in the LM Studio app”
llama.cpp : lancer depuis Hugging Face
“# llama.cpp (commands as written in its README) llama cli -hf mlabonne/gemma-3-27b-it-abliterated-GGUF llama serve -hf mlabonne/gemma-3-27b-it-abliterated-GGUF”
- Sources des tailles de fichier : Hermes 3 8B · Dolphin 3.0 8B · Llama 3.1 8B abliterated · Dolphin 3.0 R1 24B · Gemma 3 27B abliterated · Hermes 4.3 36B · Hermes 3 70B. Les fichiers Q8_0 sont plus gros, par exemple 8,54 Go pour les trois modèles 8B et 38,42 Go pour Hermes 4.3 36B.
- Les affirmations sur les refus viennent des fiches de modèle, pas de nos propres tests. Seul Hermes 4.3 publie un chiffre : sa fiche indique 74,60 % de réponses aux questions de RefusalBench en mode sans raisonnement et 72,29 % en mode raisonnement (moyenne de 5 essais), et se présente comme l'état de l'art parmi les modèles non abliterés du classement RefusalBench. C'est une déclaration du fournisseur que nous n'avons pas reproduite.
- Ollama :
hermes3(3b 2,0 Go, 8b 4,7 Go, 70b 40 Go, 405b 229 Go) etdolphin3(8b 4,9 Go) figurent dans la bibliothèque Ollama. Toutes les autres lignes se lancent avecollama run hf.co/<user>/<repo>; la documentation de Hugging Face indique Q4_K_M comme quantification par défaut quand le dépôt la contient. - LM Studio :
lms get <model-name>@q4_k_mrecherche dans les dépôts en ligne et télécharge la quantification indiquée après le@. - llama.cpp :
llama cli -hf <user>/<repo>télécharge un modèle depuis Hugging Face et l'exécute ;llama serve -hf <user>/<repo>lance un serveur d'API compatible OpenAI.
Rang | Modèle | Type (selon la fiche) | Fichier Q4_K_M | Licence (tag) |
|---|---|---|---|---|
| 1 | Hermes 3 Llama 3.1 8B | Fine-tune orientable | 4,92 Go | llama3 |
| 2 | Dolphin 3.0 Llama 3.1 8B | Fine-tune orientable | 4,92 Go | llama3.1 |
| 3 | Llama 3.1 8B Instruct abliterated | Abliteré | 4,92 Go | llama3.1 |
| 4 | Dolphin 3.0 R1 Mistral 24B | Fine-tune orientable | 14,33 Go | non indiquée sur la fiche |
| 5 | Gemma 3 27B abliterated | Abliteré | 16,5 Go | gemma |
| 6 | Hermes 4.3 36B | Alignement neutre | 21,76 Go | apache-2.0 |
| 7 | Hermes 3 Llama 3.1 70B | Fine-tune orientable | 42,52 Go | llama3 |
💡Astuce: Les lignes 3 et 5 sont des versions abliterées de la communauté ; la fiche de Gemma 3 décrit son modèle comme « fairly experimental ». Les lignes 1, 2, 4, 6 et 7 sont des fine-tunes orientables ou à alignement neutre que vous dirigez par le prompt système. Si une scène fonctionne déjà avec un modèle orientable, la variante abliterée ajoute un risque de qualité sans bénéfice.
Non censuré, abliteré, fine-tuné : ce que veulent dire les termes
« Non censuré » désigne trois techniques différentes, et une seule s'appelle l'abliteration. Ce sont les fiches de modèle, et non les mots du marketing, qui disent lequel vous téléchargez.
📍 En une phrase
« LLM non censuré » est un terme générique : les fine-tunes orientables comme Hermes et Dolphin laissent l'alignement à votre prompt système, tandis que les modèles abliterés ont vu la direction du refus retirée de leurs poids.
💬 En termes simples
Trois voies mènent à un modèle qui refuse moins : réentraîner sur des données sans refus, publier un modèle dont la fiche laisse l'alignement à l'utilisateur, ou modifier les poids finis pour annuler la direction du refus. La dernière voie est l'abliteration, et son propre guide signale une baisse de qualité par rapport au modèle d'origine.
- Fine-tunes orientables ou à alignement neutre (Hermes 3, Hermes 4.3, Dolphin 3.0) : les fiches n'emploient pas le mot « uncensored ». La fiche de Dolphin 3.0 dit « You decide the alignment » et « Dolphin does not impose its ethics or guidelines on you » ; celle de Hermes 3 parle d'« aligning LLMs to the user » ; celle de Hermes 4.3 revendique un « broadly neutral alignment ». Le comportement dépend de votre prompt système.
- Fine-tuning sur données filtrées : l'essai d'Eric Hartford, Uncensored Models, décrit la suppression des refus et des réponses biaisées dans les données d'entraînement, puis le réentraînement du modèle comme l'original.
- Abliteration : Arditi et al. montrent que le refus est « mediated by a one-dimensional subspace » dans 13 modèles de chat ouverts jusqu'à 72B de paramètres, et qu'effacer cette direction empêche le modèle de refuser. Le guide d'abliteration de mlabonne l'applique sans réentraînement et signale une baisse de performance sur tous les benchmarks, que seule une passe DPO a partiellement corrigée.
- Conséquence pratique : les versions abliterées sacrifient un peu de qualité contre la suppression des refus ; les fine-tunes orientables restent contrôlables par le prompt système. Commencez par un modèle orientable et ne passez à un modèle abliteré que s'il refuse encore.
Configuration : Ollama et LM Studio
Ollama et LM Studio servent tous deux des modèles non censurés via une API locale compatible OpenAI — ce qui signifie que SillyTavern, Agnai et tout autre outil compatible avec un endpoint local fonctionnent sans configuration supplémentaire.
Ollama : télécharger et exécuter Hermes 3
“# Pull the model ollama pull nous-hermes3:70b-llama3.3-q4_K_M # Run it ollama run nous-hermes3:70b-llama3.3-q4_K_M # Serve via API (for SillyTavern / Agnai / LM Studio-compatible tools) ollama serve # API available at http://localhost:11434”
Ollama : télécharger et exécuter Dolphin 3.0 Mistral 24B
“# Pull the model ollama pull dolphin3:24b-mistral-q4_K_M # Verify it loaded ollama list # Run a test prompt ollama run dolphin3:24b-mistral-q4_K_M "Write a 100-word villain monologue, gothic register, no disclaimers."”
- Installation d'Ollama :
brew install ollama(macOS) ou télécharger depuis ollama.com (Windows/Linux). La commandeollama servedémarre l'API compatible OpenAI surhttp://localhost:11434. - Installation de LM Studio : télécharger depuis lmstudio.ai. Importer les fichiers GGUF directement ; l'onglet serveur local expose un endpoint compatible OpenAI sur
http://localhost:1234. - Connexion SillyTavern : dans les paramètres API, sélectionner « Compatible OpenAI » et pointer l'URL de base sur
http://localhost:11434/v1(Ollama) ouhttp://localhost:1234/v1(LM Studio). Saisir n'importe quelle chaîne comme clé API (obligatoire dans le champ mais non validée localement). Guides de configuration pas à pas : avis SillyTavern · avis Open WebUI. - Connexion Agnai : même endpoint compatible OpenAI ; saisir l'URL locale dans les paramètres de l'adaptateur. Fonctionne de façon identique à la configuration SillyTavern.
- Changement de modèle : basculer entre modèles standard et non censurés dans Ollama avec `ollama run [model-name]` — plusieurs modèles peuvent être chargés simultanément, et tu peux changer par session sans redémarrer le serveur.
- Interface de bureau : Locally Uncensored est une application de bureau gratuite qui détecte Ollama et LM Studio et ajoute la génération d'images et de vidéos.
💡Astuce: Pour les auteurs qui souhaitent garder les modèles non censurés et standard séparés, créer deux instances Ollama sur des ports différents en utilisant la variable d'environnement OLLAMA_HOST. Exemple : OLLAMA_HOST=127.0.0.1:11435 ollama serve. Cela permet de pointer SillyTavern ou Agnai vers l'instance non censurée tout en conservant l'instance Ollama standard pour d'autres tâches.
Responsabilités éthiques qui subsistent
Faire fonctionner un modèle localement sans application des règles cloud ne supprime pas tes responsabilités en tant qu'auteur et éditeur. Le cadre éthique qui s'applique à la fiction d'auteur humain s'applique également à la fiction assistée par IA.
📍 En une phrase
La configuration locale supprime les restrictions des CGU cloud mais ne supprime pas la responsabilité légale de l'auteur, la responsabilité de facilitation de préjudice, ni les obligations éthiques qui s'appliquent à toute œuvre créative publiée.
💬 En termes simples
Pense au modèle local non censuré comme à un assistant d'écriture très capable qui suivra toutes les orientations que tu lui donnes. Le poids légal et éthique de ce que tu produis et distribues repose sur toi, pas sur l'outil. Les mêmes lois qui s'appliquent à la fiction d'auteur humain — concernant les mineurs, les personnes réelles, l'obscénité et l'incitation — s'appliquent à la fiction générée par IA distribuée publiquement. Le fait qu'aucune plateforme ne t'interdise de générer le contenu localement ne change pas ce dont tu es légalement responsable si tu le publies.
- Responsabilité d'auteur : tu es l'auteur de la fiction assistée par IA. « L'IA l'a généré » ne transfère pas les droits d'auteur, ne supprime pas la responsabilité ni ne constitue une défense pour un contenu qui viole la loi.
- Sensibilisation aux juridictions : les lois sur l'obscénité, les NCII et les contenus nuisibles varient selon les juridictions. Un contenu légal à produire dans un pays peut constituer une infraction pénale à distribuer dans un autre.
- Personnes réelles : générer du contenu fictionnel négatif sur des personnes réelles identifiables — même dans des cadres clairement fictionnels — comporte un risque de diffamation et de NCII selon le contenu.
- Vérification d'âge pour la distribution : si tu distribues du contenu mature ou adulte produit avec des modèles non censurés sur une plateforme publique, les obligations de vérification d'âge qui s'appliquent à tout éditeur de contenu adulte te concernent.
- Archivage responsable : le contenu non censuré généré localement doit être traité avec la même discipline de stockage que tout autre matériel sensible — ne pas stocker dans des répertoires synchronisés avec le cloud, ne pas partager involontairement.
⚠️Attention: L'erreur éthique la plus courante parmi les auteurs utilisant des modèles non censurés est de traiter la génération locale comme une zone sans contexte. La génération locale signifie l'absence d'application des règles de plateforme — elle ne signifie pas l'absence de loi, de responsabilité et de préjudice. L'absence d'un modérateur de contenu n'est pas une autorisation.
Flux de travail pratique pour les auteurs de fiction
La plupart des auteurs de fiction utilisant des modèles non censurés les utilisent pour des scènes spécifiques plutôt que comme remplacement par défaut de leur modèle standard. Le flux de travail ci-dessous soutient cette utilisation ciblée.
- Rédiger les scènes standard avec un modèle standard. Llama 3.3 70B ou Qwen3 32B gèrent la majeure partie de la prose littéraire, y compris les thèmes sombres, la complexité morale et la profondeur psychologique. Réserver le modèle non censuré pour les scènes qui nécessitent spécifiquement du contenu que le modèle standard refuse.
- Passer au non censuré pour des scènes ciblées. Dans Ollama, exécuter
ollama run nous-hermes3:70b-llama3.3-q4_K_Mpour la scène spécifique. Dans SillyTavern, changer le modèle dans les paramètres API par session. Aucune donnée ne passe entre les sessions. - Utiliser les mêmes modèles de prompts. Le modèle de scène en 5 parties, la structure de dialogue sous-textuel et les prompts de contradiction de personnages de Prompts LLM locaux pour les auteurs de fiction fonctionnent de façon identique sur les modèles non censurés. Tu n'as pas besoin de structures de prompts différentes.
- Ne pas ajouter d'instructions de génération de contenu qui n'apparaîtraient pas dans un brief humain pour des raisons légales. Le modèle est un outil, pas une structure de permission. Si tu n'inclurais pas une instruction dans un brief à un illustrateur ou ghostwriter humain pour des raisons légales, ne l'inclus pas dans le prompt du modèle.
- Réviser la sortie avant de distribuer. Les modèles non censurés produisent parfois du contenu qui dépasse la noirceur demandée ou glisse vers des stéréotypes. La révision éditoriale standard du contenu assisté par IA s'applique.

💡Astuce: Tiens un « journal de modèles » par projet d'écriture — un fichier texte brut qui enregistre quel modèle a généré quelles scènes. C'est utile pour la révision (savoir quel modèle a produit une scène aide à savoir où envoyer les demandes de révision), pour la transparence d'attribution si tu divulgues l'assistance IA, et pour l'audit si une scène soulève des questions ultérieurement.
Erreurs courantes
- Se rabattre sur le modèle non censuré le plus agressif. Les modèles entièrement ablitérés (Wizard-Uncensored, Erebus) ont le suivi d'instructions le plus faible pour les scènes complexes. Hermes 3 est un meilleur compromis pour la qualité de fiction.
- Utiliser des modèles non censurés pour du contenu que les modèles standard généreraient. La complexité morale, la psychologie sombre, la violence et les thèmes matures dans la prose littéraire nécessitent rarement un fine-tune non censuré. Sache exactement ce dont tu as besoin avant de changer.
- Traiter la génération locale comme une zone légale sans contexte. L'absence d'application des règles cloud ne signifie pas l'absence de loi. Les responsabilités d'auteur pour la distribution, les personnes réelles et les mineurs s'appliquent quelle que soit la configuration.
- Ne pas spécifier de limites de mots. Les modèles non censurés allongent le contenu sombre pour remplir l'espace aussi facilement que n'importe quel autre modèle. Utilise les mêmes contraintes de limite de mots des modèles de fiction.
- Stocker la sortie dans des répertoires synchronisés avec le cloud. Le contenu mature généré localement synchronisé avec iCloud, Google Drive ou OneDrive peut violer les conditions d'utilisation de ces plateformes. Stocker uniquement en local.
Sources
- Fiche modèle Hermes 3 et méthodologie de fine-tuning — Nous Research
- Documentation technique Dolphin 3.0 Mistral — Cognitive Computations / Eric Hartford
- Vue d'ensemble des techniques RLHF et d'alignement — Anthropic Research
- Article 5 du Règlement IA de l'UE — pratiques d'IA interdites incluant le contenu impliquant des mineurs — EUR-Lex
- NCII (intimate imagery non consentie) — vue d'ensemble du cadre juridique — Cyber Civil Rights Initiative
Questions fréquemment posées
Est-il légal d'utiliser des LLM locaux non censurés ?
Faire fonctionner un LLM local non censuré est légal dans la plupart des juridictions — il n'existe pas de loi contre la possession de logiciels IA open source. Ce que tu génères et distribues avec est soumis aux mêmes lois que tout autre contenu d'auteur : loi sur l'obscénité, loi sur les NCII, loi sur la diffamation et lois sur le contenu impliquant des mineurs. Légal à faire fonctionner ne signifie pas légal à publier, partager ou distribuer sans limite.
Quelle est la différence entre Hermes 3 et Dolphin 3.0 ?
Hermes 3 (Nous Research) est sélectivement non censuré — il réduit les refus pour le contenu mature tout en conservant certaines barrières pour les catégories extrêmes. Le suivi d'instructions est excellent, proche du modèle de base Llama 3.3 70B. Dolphin 3.0 (Cognitive Computations) est plus largement non censuré sur une plage de contenu plus large, mais le suivi d'instructions est légèrement plus faible dans les scènes complexes à contraintes multiples. Hermes 3 est le meilleur choix par défaut pour la fiction où la qualité de la prose compte ; Dolphin 3.0 est le meilleur choix quand tu as besoin de la plage de contenu la plus large sur un système 16–24 Go.
Ai-je besoin d'un modèle non censuré pour écrire de la dark fiction ?
Non, pour la plupart de la dark fiction. Les modèles instruction-tuned standard comme Llama 3.3 70B et Qwen3 32B génèrent de la violence, de la complexité morale, de la psychologie sombre, l'intériorité de villain, les traumatismes et la plupart de la noirceur littéraire sans refus lorsqu'ils sont promptés correctement. Ce qu'ils refusent de façon fiable, c'est le contenu sexuel explicite et un ensemble plus restreint de scénarios extrêmes. Si ta dark fiction n'inclut pas de contenu sexuel explicite, essaie d'abord un modèle standard — tu n'auras peut-être pas besoin de la version non censurée.
Puis-je utiliser des modèles non censurés dans SillyTavern ou Agnai ?
Oui. SillyTavern et Agnai se connectent à n'importe quel endpoint compatible OpenAI — y compris Ollama fonctionnant localement sur le port 11434. Télécharger le modèle non censuré dans Ollama, démarrer ollama serve, et dans SillyTavern ou Agnai sélectionner l'API compatible OpenAI et la pointer sur http://localhost:11434/v1. Sélectionner ton modèle non censuré dans la liste des modèles. Aucune configuration supplémentaire n'est requise.
Les modèles non censurés sont-ils sûrs à utiliser sur un réseau domestique ?
Oui, lorsqu'ils sont configurés pour se lier à localhost (la configuration par défaut dans Ollama et LM Studio). L'API n'est accessible que depuis ta machine. Si tu exposes le port sur ton réseau domestique, assure-toi que les règles de pare-feu limitent l'accès aux appareils de confiance. Ne pas exposer l'API Ollama sur l'internet public sans authentification — la configuration par défaut n'a pas d'auth.
Que se passe-t-il avec le contenu que je génère localement ?
Rien ne se passe automatiquement. Le contenu généré localement n'est envoyé à aucun serveur, n'est journalisé par aucun service cloud et n'est pas utilisé pour l'entraînement du modèle. Il n'existe que sur ton appareil, dans le stockage local de ton application (fichiers d'historique de chat, fiches de personnages, etc.). Tu contrôles ce que tu gardes, ce que tu supprimes et ce que tu partages. C'est le principal avantage structurel en matière de confidentialité de la génération locale non censurée par rapport aux alternatives basées sur le cloud.
Puis-je mélanger des modèles non censurés et standard dans le même projet d'écriture ?
Oui, et c'est le flux de travail recommandé. Utiliser un modèle standard (Llama 3.3 70B, Qwen3 32B) pour la majeure partie de la prose — les modèles standard produisent une prose littéraire de haute qualité pour la plupart du contenu sombre. Passer à Hermes 3 ou Dolphin 3.0 pour les scènes spécifiques qui nécessitent du contenu que le modèle standard refuse. Les mêmes modèles de prompts fonctionnent sur les deux ; le style de prose est suffisamment cohérent pour qu'un mélange par scène ne soit pas détectable dans la sortie.
La génération avec un modèle non censuré affecte-t-elle les droits d'auteur ?
Non — la situation des droits d'auteur pour le contenu généré par IA est identique que le modèle soit censuré ou non censuré. Le droit d'auteur pour les sorties IA est incertain dans la plupart des juridictions en 2026 ; la position générale est que les éléments d'auteur humain (conception de prompt, sélection, arrangement, édition substantielle) peuvent être protégeables tandis que la sortie IA brute ne l'est pas. L'utilisation d'un modèle non censuré ne change pas cette analyse.
Les fine-tunes non censurés perdent-ils des connaissances générales ?
Marginalement, dans des domaines étroits. Les fine-tunes de non-censure sont généralement des passes de ré-entraînement en pleine précision qui peuvent légèrement dériver du modèle de base sur le rappel factuel, les mathématiques et les benchmarks de codage — généralement 1 à 3 points de pourcentage sur les benchmarks standard. Pour les tâches d'écriture fictionnelle, cela est indétectable dans la qualité de la sortie. Si tu as besoin du même modèle pour la fiction et le travail technique, garde les versions standard et non censurée installées et change en fonction de la tâche. Hermes 3 conserve mieux les capacités générales que les modèles entièrement ablitérés.
Ces modèles sont-ils surveillés ou anonymes ?
Les modèles open-weight fonctionnant localement via Ollama ou LM Studio n'ont pas de télémétrie, pas de journalisation distante et pas de suivi d'utilisation. Les auteurs des modèles (Nous Research pour Hermes 3, Cognitive Computations pour Dolphin) ne peuvent pas voir ce que tu génères — il n'y a pas de callback serveur pendant l'inférence. Le seul risque de télémétrie provient du frontend (SillyTavern, Agnai — tous deux sans télémétrie par défaut) ou de l'OS. Exécuter un moniteur réseau (Little Snitch sur macOS, Wireshark sur Linux) une fois après l'installation pour vérifier.
Dois-je respecter le RGPD et la CNIL en utilisant Hermes 3 ou Dolphin pour l'écriture créative ?
Pour une génération purement locale sur ton propre appareil, la pertinence du RGPD est minimale : aucune donnée personnelle n'est transmise à un sous-traitant externe puisque le modèle fonctionne entièrement en local. Le RGPD et les directives de la CNIL deviennent pertinents si ta fiction met en scène des personnes réelles identifiables, ou si tu publies des contenus générés par IA sur des plateformes qui traitent des données personnelles. Dans ce cas, les obligations habituelles de protection des données s'appliquent — non pas en raison du modèle, mais en raison du traitement et de la publication.
Quelles lois françaises s'appliquent à l'écriture de dark fiction avec des LLM locaux ?
Trois dispositions sont particulièrement pertinentes : l'article 227-23 du Code pénal (contenu pédopornographique) — interdiction absolue applicable aux contenus générés par IA et aux cadres fictionnels ; l'article 24 de la loi du 29 juillet 1881 sur la liberté de la presse (provocation à la haine ou à la discrimination) ; et la loi Informatique et Libertés pour tout contenu impliquant des données personnelles de personnes identifiables. « Généré localement » ou « fiction » ne constitue une défense dans aucun de ces cas. Pour une fiction ne mettant pas en scène de mineurs dans des contextes sexuels, de personnes réelles identifiables ou d'incitation à la haine, la génération locale est juridiquement comparable à l'écriture avec n'importe quel autre outil.
Quels LLM locaux n'ont aucune restriction de contenu ?
Les fine-tunes non censurés et « abliterated » présentés ici — dont Hermes 3 et Dolphin 3.0 — ont eu leur couche de refus entraînée pour disparaître, et ne portent donc aucune politique de contenu propre. C'est la différence pratique entre un modèle local et un modèle hébergé : un fournisseur cloud applique ses conditions d'utilisation à chaque requête, tandis qu'un modèle non restreint tournant sur votre propre machine n'a aucun fournisseur dans la boucle et n'applique aucune censure au moment de l'inférence. Le contenu NSFW et la fiction explicite ne sont donc pas bloqués. Ce qui ne change pas, c'est la loi de votre pays et la responsabilité qui accompagne la publication — l'absence de politique de contenu n'équivaut pas à l'absence de limites, et la section éthique ci-dessous précise où se situent ces limites.
Quel est le meilleur LLM local non censuré ?
Il n'y a pas de meilleur modèle unique : cela dépend de votre mémoire. Cette page classe sept modèles aux fiches vérifiées par taille de fichier Q4_K_M : Hermes 3 Llama 3.1 8B, Dolphin 3.0 Llama 3.1 8B et Llama 3.1 8B Instruct abliterated (4,92 Go chacun), Dolphin 3.0 R1 Mistral 24B (14,33 Go), Gemma 3 27B abliterated (16,5 Go), Hermes 4.3 36B (21,76 Go) et Hermes 3 Llama 3.1 70B (42,52 Go). L'ordre est éditorial, par palier matériel, ce n'est pas un benchmark, et nous n'avons pas exécuté ces modèles nous-mêmes.
Quel est le meilleur LLM NSFW à exécuter en local ?
Le même classement s'applique : prenez le plus grand modèle dont le fichier Q4_K_M tient dans votre mémoire. Les fiches de Hermes 3 et Dolphin 3.0 décrivent un alignement contrôlé par l'utilisateur sans citer le NSFW, tandis que les deux versions abliterées sont étiquetées uncensored sur leur fiche. Restez dans la fiction entre personnages adultes : les contenus sexuels impliquant des mineurs et les représentations sexuelles de personnes réelles sont exclus quel que soit le modèle, comme l'explique la section éthique.
Que signifie « abliteré » pour un LLM ?
Abliteré signifie que la direction du modèle qui médie les refus a été retirée des poids sans réentraînement. Des chercheurs ont montré que le refus passe par un sous-espace à une dimension dans 13 modèles de chat ouverts ; le guide d'abliteration signale une baisse de performance par rapport au modèle d'origine, que le fine-tuning n'a corrigée qu'en partie. C'est différent d'un fine-tune dont la fiche laisse l'alignement au prompt système.
De combien de VRAM ai-je besoin pour un LLM non censuré ?
Au minimum la taille du fichier Q4_K_M, plus de la place pour le cache de contexte et l'exécution : 4,92 Go pour les trois modèles 8B, 14,33 Go pour Dolphin 3.0 R1 Mistral 24B, 16,5 Go pour Gemma 3 27B abliterated, 21,76 Go pour Hermes 4.3 36B et 42,52 Go pour Hermes 3 Llama 3.1 70B. Les fichiers Q8_0 sont plus gros, par exemple 8,54 Go pour les modèles 8B et 38,42 Go pour Hermes 4.3 36B.
Comment exécuter un LLM non censuré avec Ollama, LM Studio ou llama.cpp ?
Avec Ollama : ollama run hermes3 ou ollama run dolphin3, ou n'importe quel GGUF avec ollama run hf.co/<user>/<repo>. Avec LM Studio : lms get <model-name>@q4_k_m. Avec llama.cpp : llama cli -hf <user>/<repo>, ou llama serve -hf <user>/<repo> pour un serveur compatible OpenAI. La section Installation ci-dessus couvre les interfaces comme SillyTavern.