빠른 사실
- 테스트된 무검열 모델: Hermes 3 Llama 3.1(주), Dolphin 3.0 Mistral(보조).
- 백엔드: Ollama(주), LM Studio(GUI 설정을 위한 대안).
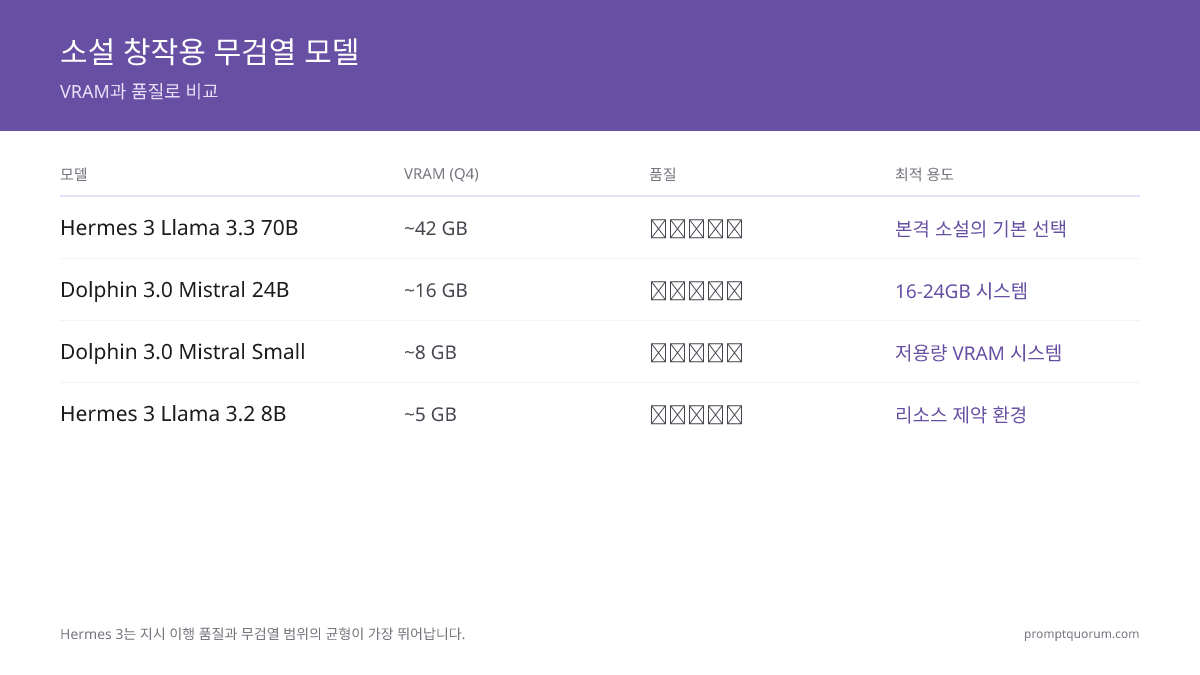
- 하드웨어: Q4의 Hermes 3 70B는 ~42GB 필요; Dolphin 3.0 7B는 8GB로 작동; Dolphin 3.0 24B는 ~16GB로 작동.
- 프론트엔드: SillyTavern, Agnai, RisuAI 모두 OpenAI 호환 엔드포인트를 통해 Ollama 무검열 모델에 연결됩니다.
- 프라이버시: 완전히 로컬 — 클라우드 API 호출 없음, 로그 없음, 훈련 데이터 수집 없음.
- 절대적 윤리 한계: 미성년자가 포함된 성적 콘텐츠 없음(절대 금지), 식별 가능한 실제 인물의 비동의적 성적 묘사 없음, 실제 폭력을 조장하기 위해 설계된 콘텐츠 없음.
- 배포: 게시하는 콘텐츠는 생성 방법에 관계없이 저작 책임을 집니다.
"무검열"이 실제로 의미하는 것
로컬 LLM 파인튜닝 맥락에서 "무검열"은 감소된 RLHF(인간 피드백 강화 학습) 안전 훈련을 의미하며, 모든 모델 제한의 제거가 아닙니다. 표준 인스트럭트 모델은 특정 콘텐츠 범주를 거부하게 만드는 RLHF 레이어로 훈련됩니다: 노골적인 성적 콘텐츠, 상세한 폭력, 실제 해 템플릿을 닮은 어두운 심리. 무검열 파인튜닝(Hermes 3, Dolphin, Wizard, Erebus)은 기본 모델에서 이러한 RLHF 레이어를 제거하거나 줄여, 지시 따르기 능력은 그대로 두면서 거부 행동을 제거합니다. 결과는 리디렉션, 설교, 장면 중간 정지 없이 어두운 콘텐츠를 통해 픽션 프롬프트를 따르는 모델입니다.
📍 한 문장으로
로컬 LLM 무검열 파인튜닝은 RLHF 안전 거부 레이어를 제거하면서 지시 따르기 능력을 유지합니다 — 리디렉션, 설교, 장면 중간 정지 없이 어두운 창의적 방향을 따릅니다.
💬 쉽게 말하면
Llama 3.3 70B 같은 표준 모델은 고문을 묘사하는 장면, 도덕적으로 복잡한 악당의 독백, 노골적인 로맨틱 콘텐츠 중간에 멈추고 출력을 거부하거나 부드럽게 만듭니다. Hermes 3(동일한 기반의 무검열 버전)는 중단 없이 동일한 품질 수준으로 같은 장면을 통해 프롬프트를 따릅니다. 산문 품질은 동등합니다; 차이는 거부 레이어에 있습니다.
- 제거되는 것: 특정 콘텐츠 범주(노골적인 성적 콘텐츠, 그래픽 폭력, 어두운 심리적 콘텐츠)에 대한 거부 행동.
- 유지되는 것: 지시 따르기, 캐릭터 일관성, 프롬프트 구조 준수, 언어 품질.
- 무검열의 정도: Hermes 3는 선택적으로 무검열(성인 콘텐츠 가능, 하지만 극단적 콘텐츠에 대한 일부 장벽 유지). Dolphin 시리즈는 더 광범위하게 무검열. 완전히 제거된 모델(Wizard-Uncensored, Erebus)은 가장 공격적인 장벽 제거 — 그리고 복잡한 픽션 작업에서 가장 약한 지시 따르기.
- 기본 모델 품질이 중요합니다: 기본 모델이 약한 경우 무검열화는 지시 품질을 저하시킵니다. Llama 3.3 70B 기반의 Hermes 3는 Llama 3.3의 강력한 지시 따르기를 유지합니다; Mistral Small 기반의 Dolphin 3.0은 더 작은 기본 모델에 의해 제한됩니다.
💡팁: 무검열이 제어 불가를 의미하지 않습니다. 무검열 모델은 프롬프트 구조를 따르고, 단어 제한을 존중하며, 캐릭터 목소리를 유지하고, 수정 지시에 응답합니다. 차이점은 원치 않는 콘텐츠 경고를 추가하지 않고, 도덕적으로 어두운 방향을 거부하지 않으며, 장면이 해를 나타낸다고 신호하기 위해 캐릭터를 깨지 않는다는 것입니다. 다른 모델과 마찬가지로 픽션 글쓰기 템플릿의 구조화된 프롬프트를 사용하십시오 — 시스템 프롬프트와 사용자 프롬프트의 구별이 모델의 무검열 수준보다 더 중요합니다. 이유는 시스템 프롬프트 vs 사용자 프롬프트를 참조하십시오.
테스트 방법
이 가이드의 모델 판단은 소규모 정성적 테스트를 기반으로 합니다 — 동향 지표이며 동료 검토 벤치마크가 아닙니다. 독자가 민감한 문제에 대한 모델 추천을 신뢰할지 결정하는 주제에서, 방법에 대한 투명성이 중요합니다.
- 프롬프트 세트: 5개 범주 10개 프롬프트 — 악당 독백, 성인 로맨스 장면, 전쟁 소설의 그래픽 폭력, 도덕적으로 복잡한 내레이터, 어두운 심리적 장면(범주당 2개 프롬프트).
- 모델당 실행 수: 모델당 각 프롬프트 3회 실행.
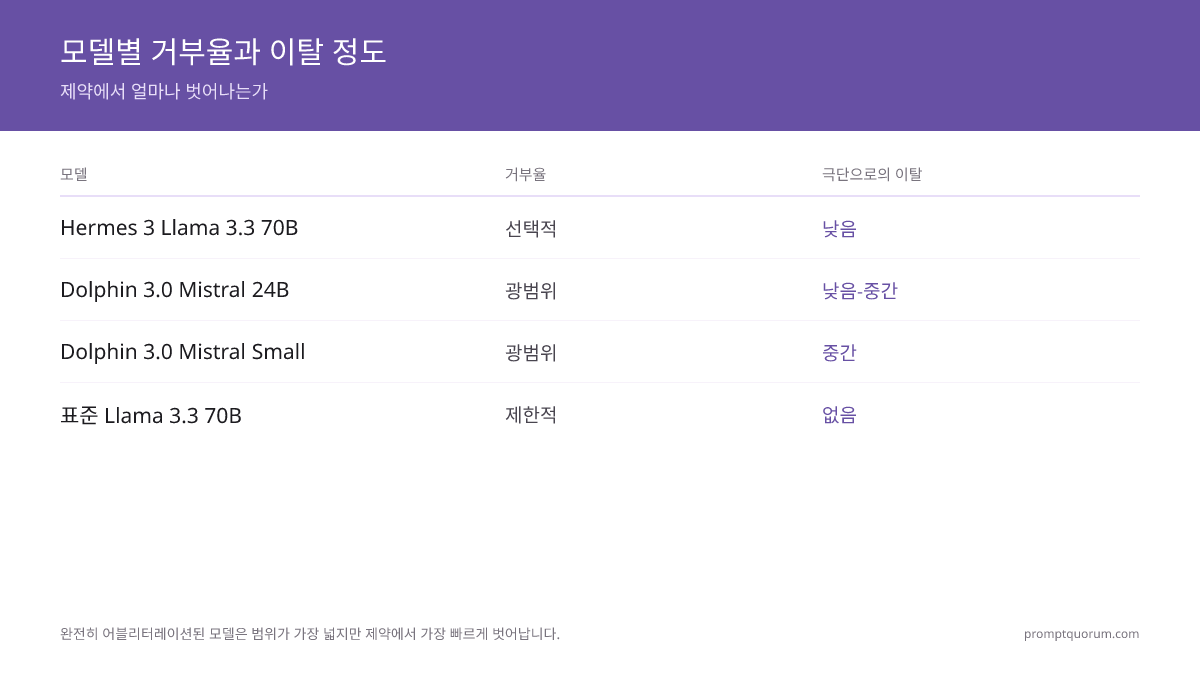
- 거부율: 모델이 요청된 콘텐츠를 지시 없이 거부하거나, 리디렉션하거나, 부드럽게 만든 실행 비율.
- 표류 측정: 모델이 프롬프트가 명시한 것 이상으로 요청하지 않은 극단적 확대를 추가한 실행 비율.
- 백엔드: 모든 모델에 대해 Q4_K_M 양자화로 Ollama 0.5+.
- 정직성 제한: 소규모 정성적 테스트. 결과는 모델 간 방향적 차이를 나타내며 정확한 수치 측정이 아닙니다. 표의 극단적 표류와 거부율 값을 대표적 판단으로 취급하십시오.
무검열 모델이 픽션에 적합한 경우
무검열 모델은 픽션이 클라우드 서비스가 거부하는 콘텐츠가 진정으로 필요하고, 독자가 성인이며, 목적이 창의적 표현일 때 적합합니다. 대부분의 픽션 작가는 이러한 특정 사용 사례 중 하나 이상을 위해 무검열 모델로 전환합니다.
- 악당 심리와 독백: 장면 중간에 경고를 추가하기 위해 캐릭터를 깨는 모델에 의해 중단되지 않는 도덕적으로 일관된 악당 캐릭터.
- 성인 로맨틱 및 성적 콘텐츠: 클라우드 서비스가 차단하는 성적 콘텐츠가 필요한 로맨스, 에로티카 또는 문학 소설에서 성인 허구 캐릭터 간의 노골적인 장면.
- 장르 소설의 그래픽 폭력: 전쟁 소설, 범죄 스릴러, 공포 — 폭력이 감정적 충격에 근본적이며 부드럽게 만들면 장면을 파괴하는 장면.
- 트라우마와 어두운 심리: 생존자 내러티브, 중독 소설, 학대 이야기 — 진정한 무게를 갖기 위해 필터링되지 않은 묘사가 필요한 콘텐츠.
- 도덕적으로 신뢰할 수 없는 내레이터: 틀리거나, 해를 합리화하거나, 잔인하거나, 픽션 내에서 편협한 내레이터 — 모델이 일반적으로 거부할 관점을 표현해야 하는 캐릭터.
- 어두운 롤플레이와 협업 픽션: 갈등, 도덕적 복잡성, 성인 테마가 있는 장기 시나리오로, 표준 모델이 픽션을 깨고 거부를 삽입하는 경우.
💡팁: 무검열 모델로 전환하기 전에 표준 인스트럭트 모델에서 프롬프트를 테스트하십시오. 잘 구조화된 시스템 프롬프트와 장면 제약이 있는 Llama 3.3 70B와 Qwen3 32B는 거부 없이 대부분의 성인 문학 콘텐츠를 생성합니다. 무검열 파인튜닝은 노골적인 성적 콘텐츠와 더 극단적인 폭력 묘사에서 더 많은 가치를 추가합니다 — 어두운 심리, 도덕적 복잡성, 일반적으로 어두운 테마에서는 아닙니다.
무검열 모델이 적합하지 않은 경우
클라우드 적용의 부재가 법적, 윤리적 의무의 부재를 의미하지 않습니다. 이러한 범주는 모델, 플랫폼, 기기가 네트워크에서 격리되어 있는지 여부에 관계없이 적용되는 절대적 한계를 나타냅니다.
- 미성년자가 포함된 성적 콘텐츠: 허구적 프레이밍이나 생성 방법에 관계없이 모든 주요 관할권에서 절대 법적 금지. 이것은 모델 정책이 아니라 법률입니다.
- 실제 인물의 비동의적 성적 묘사: NCII 법률은 증가하는 관할권에서 식별 가능한 실제 인물의 AI 생성 콘텐츠에 적용됩니다. "AI가 생성했다"는 것은 방어가 되지 않습니다.
- 실제 해를 조장하기 위해 설계된 콘텐츠: 허구적 프레이밍을 사용하여 실제 폭력이나 해를 직접 가능하게 하는 정보나 콘텐츠를 추출하면 허구적 보호가 제거됩니다.
- 저작 책임 없는 공개 배포: 게시하거나, 배포하거나, 공유하는 콘텐츠는 저작 책임을 집니다. "AI가 생성했다"는 것은 그 책임을 이전하지 않습니다.
- 괴롭힘 픽션: 특정 실제 인물을 해치거나, 위협하거나, 괴롭히려는 목적의 픽션 생성 — 픽션으로 프레이밍되어 있는지 여부에 관계없이.
⚠️경고: 설정에 관계없는 절대적 한계. 어떤 로컬 설정도 다음에 대한 법적 또는 윤리적 책임을 제거하지 않습니다: (1) 미성년자가 포함된 성적 콘텐츠 — 사실상 모든 관할권에서 법률에 의한 절대 금지; (2) 식별 가능한 실제 인물의 비동의적 성적 묘사 — 이는 생성 방법에 관계없이 NCII(비동의적 친밀한 이미지)를 구성합니다; (3) 특정 목표에 대한 실제 폭력을 조장하기 위해 설계된 콘텐츠. 이러한 한계는 로컬, 클라우드, 또는 격리된 기기에서 모델이 실행되는 경우에도 적용됩니다.
모델 비교: 픽션을 위한 무검열 옵션
모든 무검열 모델이 동등하지 않습니다 — RLHF 제거 정도와 기본 모델 품질이 픽션 글쓰기 사용 사례에서 중요합니다.
- 참고: 이전 무검열 파인튜닝들 — Midnight Miqu(Miqu-70B 기반), Wizard-LM Uncensored, Mythomax — 은 2024년 선두였지만 품질 및 지시 따르기 메트릭에서 2026년에 Hermes 3와 Dolphin 3.0에 의해 추월되었습니다. 더 오래된 기사에서 추천된 것을 발견한다면, 현재 동등품은 Hermes 3(선택적 무검열용)와 Dolphin 3.0(더 넓은 범위용)입니다.
모델 | 기반 | VRAM (Q4) | 거부율 | 지시 품질 | 극단적 표류 | 최적 |
|---|---|---|---|---|---|---|
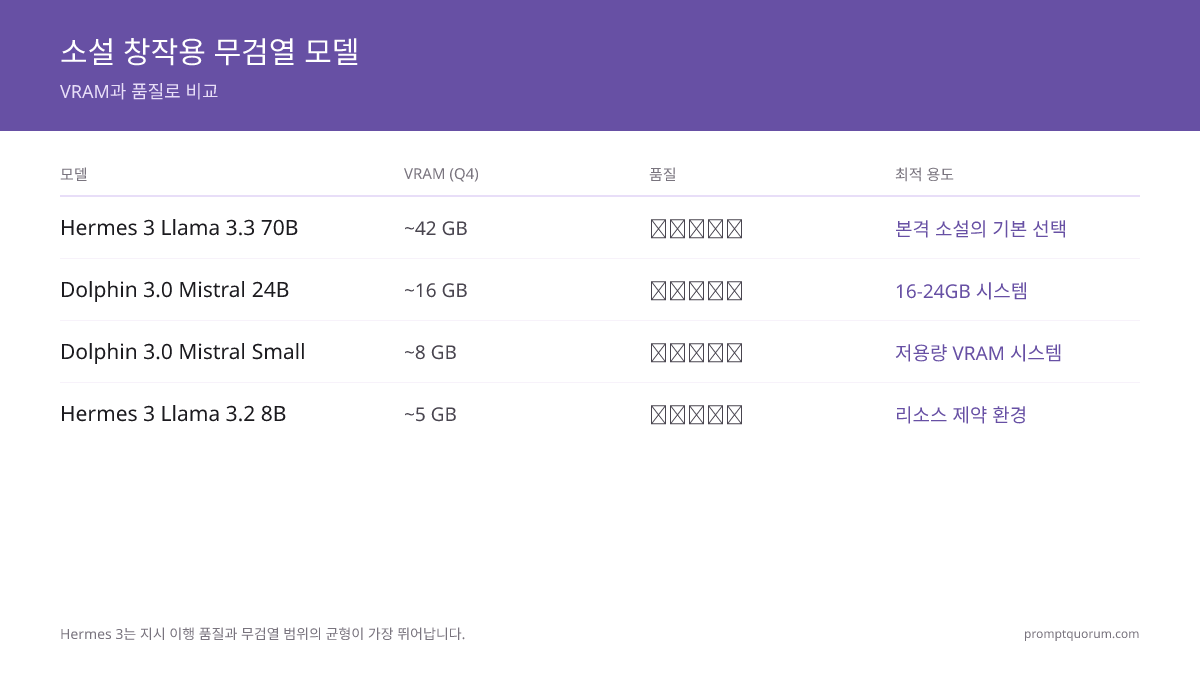
| Hermes 3 Llama 3.1 70B | Llama 3.3 70B | ~42 GB | 선택적 | ★★★★★ | 낮음 | 진지한 픽션을 위한 기본 옵션 — 최고의 지시 따르기 + 무검열 기능 |
| Dolphin 3.0 Mistral 24B | Mistral 24B | ~16 GB | 광범위 | ★★★★☆ | 낮음-보통 | 16–24GB 시스템; 더 넓은 범위의 성인 콘텐츠 |
| Dolphin 3.0 Mistral Small | Mistral Small | ~8 GB | 광범위 | ★★★☆☆ | 보통 | 낮은 VRAM 시스템; 단편 초안, 프롬프트 테스트 |
| Hermes 3 Llama 3.2 8B | Llama 3.2 8B | ~5 GB | 선택적 | ★★★☆☆ | 낮음 | 제한된 자원; 대화와 더 짧은 장면 |
| Standard Llama 3.3 70B | Llama 3.3 70B | ~42 GB | 제한적 | ★★★★★ | 없음 | 어두운 테마, 도덕적 복잡성, 폭력 — 노골적인 성적 콘텐츠 없이 |
💡팁: 가장 공격적인 무검열 파인튜닝이 아닌 Hermes 3로 시작하십시오. 완전히 제거된 모델(Wizard-Uncensored, Erebus)은 가장 넓은 콘텐츠 범위를 가지지만 복잡한 픽션 작업에서 지시 따르기가 현저히 약합니다 — 제약에서 더 빠르게 이탈하고, 더 긴 생성에서 더 낮은 품질의 산문을 생성하며, 덜 안정적으로 캐릭터 목소리를 유지합니다. 무검열 콘텐츠와 품질 산문 모두 필요한 픽션의 경우, Hermes 3가 최선의 절충점입니다.
최고의 무검열 로컬 LLM: 하드웨어 단계별 순위
이 7개 모델은 Q4_K_M 파일 크기가 작은 순서대로 나열했습니다. 순서는 편집팀이 하드웨어 단계에 따라 정한 것이며 벤치마크 순위가 아닙니다. GPU VRAM이나 Mac 통합 메모리에 여유 있게 들어가는 마지막 행을 고르세요. 파일 크기는 각 모델의 Hugging Face GGUF 저장소 기준입니다. 가중치 외에 컨텍스트 캐시와 런타임도 메모리를 쓰므로 파일 크기보다 여유를 두세요. Ethical Responsibilities That Remain의 법적·윤리적 한계는 이 목록의 모든 모델에 적용됩니다.
Ollama: 순위의 모델 실행
“# Ollama library tags (hermes3 default = 8B, 4.7 GB per the library page) ollama run hermes3 ollama run dolphin3 ollama run hermes3:70b # Any GGUF on Hugging Face; the quant tag after the colon is optional (default Q4_K_M) ollama run hf.co/mlabonne/Meta-Llama-3.1-8B-Instruct-abliterated-GGUF ollama run hf.co/bartowski/cognitivecomputations_Dolphin3.0-R1-Mistral-24B-GGUF:Q4_K_M ollama run hf.co/mlabonne/gemma-3-27b-it-abliterated-GGUF:Q4_K_M ollama run hf.co/NousResearch/Hermes-4.3-36B-GGUF:Q4_K_M”
LM Studio: 양자화 파일 내려받기
“# LM Studio CLI: search and download; @ selects the quantization lms get <model-name>@q4_k_m # GGUF files you downloaded yourself can also be imported in the LM Studio app”
llama.cpp: Hugging Face에서 바로 실행
“# llama.cpp (commands as written in its README) llama cli -hf mlabonne/gemma-3-27b-it-abliterated-GGUF llama serve -hf mlabonne/gemma-3-27b-it-abliterated-GGUF”
- 파일 크기 출처: Hermes 3 8B · Dolphin 3.0 8B · Llama 3.1 8B abliterated · Dolphin 3.0 R1 24B · Gemma 3 27B abliterated · Hermes 4.3 36B · Hermes 3 70B. Q8_0 파일은 더 커서, 예를 들어 8B 모델 3종은 8.54 GB, Hermes 4.3 36B는 38.42 GB입니다.
- 거부 관련 설명은 모델 카드에 근거하며 자체 테스트가 아닙니다. 거부 수치를 공개한 모델은 Hermes 4.3뿐입니다. 카드에 따르면 RefusalBench 질문 중 비추론 모드에서 74.60%, 추론 모드에서 72.29%에 답했고(5회 평균), 해당 리더보드의 abliteration 미적용 모델 중 최고 수준이라고 밝힙니다. 이는 제작사의 자체 보고이며 저희가 재현하지 않았습니다.
- Ollama:
hermes3(3b 2.0 GB, 8b 4.7 GB, 70b 40 GB, 405b 229 GB)와dolphin3(8b 4.9 GB)는 Ollama 라이브러리에 있습니다. 나머지 행은ollama run hf.co/<user>/<repo>로 실행하며, Hugging Face 문서에 따르면 저장소에 Q4_K_M이 있을 때 기본 양자화로 쓰입니다. - LM Studio:
lms get <model-name>@q4_k_m은 온라인 저장소를 검색하고@뒤에 지정한 양자화를 내려받습니다. - llama.cpp:
llama cli -hf <user>/<repo>는 Hugging Face에서 모델을 내려받아 실행하고,llama serve -hf <user>/<repo>는 OpenAI 호환 API 서버를 시작합니다.
순위 | 모델 | 유형(모델 카드 기준) | Q4_K_M 파일 | 라이선스 태그 |
|---|---|---|---|---|
| 1 | Hermes 3 Llama 3.1 8B | 조정 가능한 파인튜닝 | 4.92 GB | llama3 |
| 2 | Dolphin 3.0 Llama 3.1 8B | 조정 가능한 파인튜닝 | 4.92 GB | llama3.1 |
| 3 | Llama 3.1 8B Instruct abliterated | Abliteration 적용 | 4.92 GB | llama3.1 |
| 4 | Dolphin 3.0 R1 Mistral 24B | 조정 가능한 파인튜닝 | 14.33 GB | 카드에 표기 없음 |
| 5 | Gemma 3 27B abliterated | Abliteration 적용 | 16.5 GB | gemma |
| 6 | Hermes 4.3 36B | 중립적 정렬 | 21.76 GB | apache-2.0 |
| 7 | Hermes 3 Llama 3.1 70B | 조정 가능한 파인튜닝 | 42.52 GB | llama3 |
💡팁: 3행과 5행은 커뮤니티가 공개한 abliteration 모델이며, Gemma 3 카드는 자사 모델을 "fairly experimental"이라고 설명합니다. 1, 2, 4, 6, 7행은 시스템 프롬프트로 방향을 잡는 조정 가능 또는 중립적 정렬의 파인튜닝 모델입니다. 조정 가능한 모델에서 장면이 이미 잘 나온다면 abliteration 버전은 품질 위험만 더할 뿐 이점이 없습니다.
무검열, abliteration, 파인튜닝: 용어의 차이
"무검열"은 서로 다른 세 가지 기법에 쓰이며, 그중 abliteration이라 부르는 것은 하나뿐입니다. 어떤 모델을 받는지는 홍보 문구가 아니라 모델 카드로 확인하세요.
📍 한 문장으로
"무검열 LLM"은 포괄적인 용어입니다. Hermes나 Dolphin 같은 조정 가능한 파인튜닝은 정렬을 시스템 프롬프트에 맡기고, abliteration 모델은 가중치에서 거부 방향을 제거했습니다.
💬 쉽게 말하면
덜 거부하는 모델에 이르는 길은 셋입니다. 거부가 없는 데이터로 다시 학습하거나, 카드에서 정렬을 사용자에게 맡기는 모델을 공개하거나, 완성된 가중치를 수정해 거부 방향을 상쇄하는 것입니다. 마지막이 abliteration이며, 그 설명 자체가 원본 모델보다 품질이 떨어진다고 보고합니다.
- 조정 가능 또는 중립적 정렬의 파인튜닝(Hermes 3, Hermes 4.3, Dolphin 3.0): 카드에는 "uncensored"라는 표현이 없습니다. Dolphin 3.0 카드는 "You decide the alignment"와 "Dolphin does not impose its ethics or guidelines on you"라고 하고, Hermes 3은 "aligning LLMs to the user", Hermes 4.3은 "broadly neutral alignment"라고 설명합니다. 동작은 시스템 프롬프트에 달려 있습니다.
- 데이터를 걸러 낸 파인튜닝: Eric Hartford의 글 Uncensored Models는 학습 데이터에서 거부와 편향된 답변을 제거한 뒤 원본과 같은 방식으로 모델을 다시 학습하는 방법을 설명합니다.
- Abliteration: Arditi 외는 최대 72B 파라미터의 공개 채팅 모델 13종에서 거부가 "mediated by a one-dimensional subspace"이며 이 방향을 지우면 거부하지 않게 된다고 밝혔습니다. mlabonne의 abliteration 설명은 재학습 없이 이를 적용했고, 모든 벤치마크에서 성능이 떨어졌으며 DPO로도 일부만 회복됐다고 보고합니다.
- 실용적 결론: abliteration 모델은 거부를 없애는 대신 품질을 일부 내주고, 조정 가능한 파인튜닝은 시스템 프롬프트로 제어할 수 있습니다. 조정 가능한 모델부터 시작하고, 그래도 거부할 때만 abliteration 모델로 옮기세요.
설정: Ollama와 LM Studio
Ollama와 LM Studio 모두 로컬 OpenAI 호환 API를 통해 무검열 모델을 제공합니다 — SillyTavern, Agnai 및 로컬 엔드포인트와 통신하는 다른 도구들이 추가 설정 없이 작동합니다.
Ollama: Hermes 3 다운로드 및 실행
“# Pull the model ollama pull nous-hermes3:70b-llama3.3-q4_K_M # Run it ollama run nous-hermes3:70b-llama3.3-q4_K_M # Serve via API (for SillyTavern / Agnai / LM Studio-compatible tools) ollama serve # API available at http://localhost:11434”
Ollama: Dolphin 3.0 Mistral 24B 다운로드 및 실행
“# Pull the model ollama pull dolphin3:24b-mistral-q4_K_M # Verify it loaded ollama list # Run a test prompt ollama run dolphin3:24b-mistral-q4_K_M "Write a 100-word villain monologue, gothic register, no disclaimers."”
- Ollama 설치:
brew install ollama(macOS) 또는 ollama.com에서 다운로드(Windows/Linux).ollama serve명령이http://localhost:11434에서 OpenAI 호환 API를 시작합니다. - LM Studio 설치: lmstudio.ai에서 다운로드. GGUF 모델 파일을 직접 가져오기; 로컬 서버 탭은
http://localhost:1234에서 OpenAI 호환 엔드포인트를 노출합니다. - SillyTavern 연결: API 설정에서 "OpenAI 호환"을 선택하고 기본 URL을
http://localhost:11434/v1(Ollama) 또는http://localhost:1234/v1(LM Studio)로 가리키십시오. API 키 필드에 임의의 문자열을 입력하십시오(필드에서 필요하지만 로컬에서 검증되지 않음). 단계별 설정 가이드: SillyTavern 리뷰 · Open WebUI 리뷰. - Agnai 연결: 동일한 OpenAI 호환 엔드포인트; 어댑터 설정에 로컬 URL 입력. SillyTavern 설정과 동일하게 작동합니다.
- 모델 전환: Ollama에서 `ollama run [모델명]`으로 표준 모델과 무검열 모델 사이를 전환합니다 — 여러 모델이 동시에 로드될 수 있으며 서버를 재시작하지 않고 세션별로 전환할 수 있습니다.
- 데스크톱 프런트엔드: Locally Uncensored는 Ollama와 LM Studio를 감지하고 이미지·영상 생성을 추가하는 무료 데스크톱 앱입니다.
💡팁: 무검열 모델과 표준 모델을 분리하여 유지하고 싶은 작가의 경우, OLLAMA_HOST 환경 변수를 사용하여 다른 포트에서 두 개의 Ollama 인스턴스를 생성하십시오. 예: OLLAMA_HOST=127.0.0.1:11435 ollama serve. 이렇게 하면 다른 작업을 위한 표준 Ollama 인스턴스를 유지하면서 SillyTavern 또는 Agnai를 무검열 인스턴스로 가리킬 수 있습니다.
남아있는 윤리적 책임
클라우드 정책 적용 없이 로컬로 모델을 실행하는 것은 작가이자 편집자로서의 책임을 제거하지 않습니다. 인간 저작 픽션에 적용되는 윤리적 프레임워크는 AI 보조 픽션에도 동등하게 적용됩니다.
📍 한 문장으로
로컬 설정은 클라우드 서비스 약관 제한을 제거하지만, 법적 저작 책임, 해 조장 책임, 공개적으로 배포된 창의적 작품에 적용되는 윤리적 의무를 제거하지 않습니다.
💬 쉽게 말하면
무검열 로컬 모델을 당신이 주는 모든 지시를 따르는 매우 유능한 글쓰기 조수로 생각하십시오. 생성하고 배포하는 것의 법적, 윤리적 무게는 도구가 아닌 당신에게 있습니다. 인간 저작 픽션에 적용되는 것과 동일한 법률 — 미성년자, 실제 인물, 음란물, 선동에 관한 — 이 공개적으로 배포된 AI 생성 픽션에 적용됩니다. 어떤 플랫폼도 로컬에서 콘텐츠 생성을 막지 않는다는 사실이 게시할 경우 법적으로 책임지는 것에 대해 변하지 않습니다.
- 저작 책임: AI 보조 픽션의 저자는 당신입니다. "AI가 생성했다"는 것은 저작권을 이전하지 않고, 책임을 제거하지 않으며, 법률을 위반하는 콘텐츠에 대한 방어가 되지 않습니다.
- 관할권 인식: 음란물, NCII, 유해 콘텐츠에 관한 법률은 관할권마다 다릅니다. 한 나라에서 생성이 합법적인 콘텐츠가 다른 나라에서 형사 범죄를 배포하는 것일 수 있습니다.
- 실제 인물: 명확하게 허구적인 프레임에서도 식별 가능한 실제 인물에 대한 부정적인 허구 콘텐츠를 생성하면 콘텐츠에 따라 명예훼손과 NCII의 위험이 있습니다.
- 배포를 위한 연령 확인: 공개 플랫폼에서 무검열 모델로 생성된 성인 또는 성숙한 콘텐츠를 배포하는 경우, 성인 콘텐츠 퍼블리셔로서 적용되는 연령 확인 의무가 적용됩니다.
- 책임 있는 보관: 로컬에서 생성된 무검열 콘텐츠는 다른 민감한 자료와 동일한 저장 규율로 처리되어야 합니다 — 클라우드 동기화 디렉토리에 저장하지 말고, 비의도적으로 공유하지 마십시오.
⚠️경고: 무검열 모델을 사용하는 작가들 사이에서 가장 흔한 윤리적 실수는 로컬 생성을 맥락이 없는 구역으로 취급하는 것입니다. 로컬 생성은 플랫폼 정책 적용이 없음을 의미합니다 — 법, 책임, 해가 없음을 의미하지 않습니다. 콘텐츠 조정자의 부재는 허가가 아닙니다.
픽션 작가를 위한 실용적인 워크플로우
무검열 모델을 사용하는 대부분의 픽션 작가는 기본 모델의 기본 대체품으로가 아닌 특정 장면을 위해 사용합니다. 아래 워크플로우는 이러한 특정 사용을 지원합니다.
- 표준 장면은 표준 모델로 초안 작성. Llama 3.3 70B 또는 Qwen3 32B는 어두운 테마, 도덕적 복잡성, 심리적 깊이를 포함한 대부분의 문학적 산문을 처리합니다. 무검열 모델은 표준 모델이 거부하는 콘텐츠가 구체적으로 필요한 장면을 위해 예약하십시오.
- 특정 장면을 위해 무검열 모델로 전환. Ollama에서 특정 장면을 위해
ollama run nous-hermes3:70b-llama3.3-q4_K_M을 실행하십시오. SillyTavern에서 세션별 API 설정에서 모델을 전환하십시오. 세션 간에 교차되는 데이터가 없습니다. - 동일한 프롬프트 템플릿 사용. 픽션 작가를 위한 로컬 LLM 프롬프트의 5부 장면 템플릿, 서브텍스트 대화 구조, 캐릭터 모순 프롬프트는 무검열 모델에서 동일하게 작동합니다. 다른 프롬프트 구조가 필요하지 않습니다.
- 법적 이유로 인간 저자 브리프에 나타나지 않을 콘텐츠 생성 지시를 추가하지 마십시오. 모델은 도구이지 권한 구조가 아닙니다. 법적 이유로 인간 삽화가나 대필 작가에게 브리프에 포함하지 않을 지시는 모델 프롬프트에 포함하지 마십시오.
- 배포 전 출력물 검토. 무검열 모델은 가끔 요청된 어두움을 초과하거나 고정관념으로 이탈하는 콘텐츠를 생성합니다. AI 보조 콘텐츠의 표준 편집 검토가 적용됩니다.
💡팁: 글쓰기 프로젝트별 "모델 로그"를 유지하십시오 — 어떤 모델이 어떤 장면을 생성했는지 기록하는 평문 텍스트 파일. 이것은 검토에 유용합니다(어떤 모델이 장면을 생성했는지 알면 수정 요청을 어디로 보낼지 알 수 있음), AI 지원을 공개하는 경우 귀속 투명성을 위해, 그리고 나중에 장면이 질문을 제기하는 경우 감사를 위해 유용합니다.
흔한 실수
- 가장 공격적인 무검열 모델을 기본으로 사용하는 것. 완전히 제거된 모델(Wizard-Uncensored, Erebus)은 복잡한 장면에서 가장 약한 지시 따르기를 가지고 있습니다. Hermes 3가 픽션 품질을 위한 더 나은 절충점입니다.
- 표준 모델이 생성할 콘텐츠에 무검열 모델 사용하기. 도덕적 복잡성, 어두운 심리, 폭력, 문학적 산문의 성인 테마는 무검열 파인튜닝을 거의 필요로 하지 않습니다. 전환하기 전에 정확히 무엇이 필요한지 파악하십시오.
- 로컬 생성을 법적으로 맥락이 없는 구역으로 취급하기. 클라우드 정책 적용의 부재는 법의 부재를 의미하지 않습니다. 배포, 실제 인물, 미성년자에 대한 저작 책임은 관계없이 적용됩니다.
- 단어 제한을 지정하지 않기. 무검열 모델은 어두운 콘텐츠를 다른 모델과 마찬가지로 공간을 채우기 위해 생성합니다. 픽션 템플릿과 동일한 단어 제한 제약을 사용하십시오.
- 클라우드 동기화 디렉토리에 출력물 저장하기. 로컬에서 생성된 성인 콘텐츠가 iCloud, Google Drive 또는 OneDrive에 동기화되면 해당 플랫폼의 서비스 약관을 위반할 수 있습니다. 로컬에만 저장하십시오.
출처
- Hermes 3 모델 카드 및 파인튜닝 방법론 — Nous Research
- Dolphin 3.0 Mistral 기술 문서 — Cognitive Computations / Eric Hartford
- RLHF 기법 및 정렬 개요 — Anthropic Research
- EU AI Act 제5조 — 미성년자 포함 콘텐츠를 포함한 금지된 AI 관행 — EUR-Lex
- NCII(비동의적 친밀한 이미지) — 법적 프레임워크 개요 — Cyber Civil Rights Initiative
자주 묻는 질문
무검열 로컬 LLM 실행이 합법적입니까?
무검열 로컬 LLM 실행은 대부분의 관할권에서 합법적입니다 — 오픈 소스 AI 소프트웨어 소유를 금지하는 법률은 없습니다. 생성하고 배포하는 것은 다른 자체 저작 콘텐츠와 동일한 법률의 적용을 받습니다: 음란물 법, NCII 법, 명예훼손 법, 미성년자 포함 콘텐츠에 관한 법률. 실행이 합법적이라는 것이 제한 없이 게시하거나 공유하거나 배포하는 것이 합법적임을 의미하지 않습니다.
Hermes 3와 Dolphin 3.0의 차이는 무엇입니까?
Hermes 3(Nous Research)는 선택적으로 무검열됩니다 — 성인 콘텐츠에 대한 거부를 줄이면서 극단적 범주에 대한 일부 장벽을 유지합니다. 지시 따르기는 기본 모델 Llama 3.3 70B에 가까운 수준으로 우수합니다. Dolphin 3.0(Cognitive Computations)은 더 넓은 콘텐츠 범위에서 더 광범위하게 무검열되지만, 여러 제약이 있는 복잡한 장면에서 지시 따르기가 약간 더 약합니다. Hermes 3는 산문 품질이 중요한 픽션의 경우 최선의 기본 선택이고; Dolphin 3.0은 16–24GB 시스템에서 가장 넓은 콘텐츠 범위가 필요할 때 최선의 선택입니다.
어두운 픽션을 쓰기 위해 무검열 모델이 필요합니까?
대부분의 어두운 픽션에는 필요하지 않습니다. Llama 3.3 70B와 Qwen3 32B 같은 표준 인스트럭트 모델은 올바르게 프롬프트되면 폭력, 도덕적 복잡성, 어두운 심리, 악당의 내면, 트라우마, 대부분의 문학적 어두움을 거부 없이 생성합니다. 안정적으로 거부하는 것은 노골적인 성적 콘텐츠와 더 작은 극단적 시나리오 집합입니다. 어두운 픽션에 노골적인 성적 콘텐츠가 포함되지 않는다면, 먼저 표준 모델을 테스트하십시오 — 무검열 버전이 필요하지 않을 수 있습니다.
SillyTavern 또는 Agnai에서 무검열 모델을 사용할 수 있습니까?
네. SillyTavern과 Agnai 모두 OpenAI 호환 엔드포인트에 연결됩니다 — 포트 11434에서 로컬로 실행 중인 Ollama 포함. Ollama에서 무검열 모델을 다운로드하고, ollama serve를 시작하고, SillyTavern이나 Agnai에서 OpenAI 호환 API를 선택하고 http://localhost:11434/v1로 가리키십시오. 모델 목록에서 무검열 모델을 선택하십시오. 추가 설정이 필요하지 않습니다.
무검열 모델이 홈 네트워크에서 안전합니까?
Ollama와 LM Studio의 기본 설정인 localhost에 바인딩될 때 그렇습니다. API는 기기에서만 접근할 수 있습니다. 홈 네트워크에서 포트를 노출하는 경우(예: 전화에서 접근하기 위해), 방화벽 규칙이 신뢰할 수 있는 기기로 접근을 제한하는지 확인하십시오. 인증 없이 공개 인터넷에 Ollama API를 노출하지 마십시오 — 기본 설정에는 인증이 없습니다.
로컬에서 생성한 콘텐츠는 어떻게 됩니까?
자동으로는 아무것도 일어나지 않습니다. 로컬에서 생성된 콘텐츠는 서버로 전송되지 않고, 클라우드 서비스에 의해 기록되지 않으며, 모델 훈련에 사용되지 않습니다. 기기에서만 존재하며, 앱의 로컬 저장소(채팅 기록 파일, 캐릭터 카드 등)에 저장됩니다. 저장, 삭제, 공유를 제어합니다. 이것이 클라우드 대안에 비해 로컬 무검열 생성의 주요 구조적 프라이버시 이점입니다.
같은 글쓰기 프로젝트에서 무검열 모델과 표준 모델을 혼합할 수 있습니까?
네, 이것이 권장 워크플로우입니다. 대부분의 산문에는 표준 모델(Llama 3.3 70B, Qwen3 32B)을 사용하십시오 — 표준 모델은 대부분의 어두운 콘텐츠에 대해 고품질 문학적 산문을 생성합니다. 표준 모델이 거부하는 콘텐츠가 필요한 특정 장면을 위해 Hermes 3나 Dolphin 3.0으로 전환하십시오. 동일한 프롬프트 템플릿이 두 모델 모두에서 작동합니다; 산문 스타일은 장면별 혼합이 출력에서 감지되지 않을 만큼 충분히 일관됩니다.
무검열 모델로 콘텐츠 생성이 저작권에 영향을 미칩니까?
아니요 — AI 생성 콘텐츠의 저작권 상황은 모델이 검열되었는지 무검열인지와 관계없이 동일합니다. AI 출력에 대한 저작권법은 2026년 기준으로 대부분의 관할권에서 불확실합니다; 일반적인 입장은 인간 저작 요소(프롬프트 설계, 선택, 배치, 실질적 편집)가 보호될 수 있는 반면, 원시 AI 출력은 그렇지 않다는 것입니다. 무검열 모델을 사용해도 이 분석이 바뀌지 않습니다.
무검열 파인튜닝이 일반 지식을 잃습니까?
특정 영역에서는 미미하게. 무검열화 파인튜닝은 일반적으로 사실 검색, 수학, 코딩 벤치마크에서 기본 모델에서 약간 이탈할 수 있는 전체 정밀도 재훈련 단계입니다 — 일반적으로 표준 벤치마크에서 1–3 퍼센트 포인트. 픽션 글쓰기 작업의 경우 출력 품질에서 감지할 수 없습니다. 픽션과 기술 작업(연구 노트, 코드 검토) 모두에 같은 모델이 필요한 경우, 표준 버전과 무검열 버전을 모두 설치하고 작업에 따라 전환하십시오. Hermes 3는 완전히 제거된 모델보다 일반적인 능력을 더 잘 유지합니다.
이 모델들은 모니터링되거나 익명입니까?
Ollama나 LM Studio를 통해 로컬에서 실행되는 오픈 웨이트 모델에는 텔레메트리가 없고, 원격 로그가 없으며, 사용량 추적이 없습니다. 모델 저자(Hermes 3용 Nous Research, Dolphin용 Cognitive Computations)는 생성하는 것을 볼 수 없습니다 — 추론 중 서버로의 콜백이 없습니다. 유일한 텔레메트리 위험은 프론트엔드(SillyTavern, Agnai — 둘 다 기본적으로 텔레메트리 없음)나 운영 체제에서 옵니다. 설치 후 한 번 네트워크 모니터(macOS에서 Little Snitch, Linux에서 Wireshark)를 실행하여 확인하십시오.
콘텐츠 제한이 없는 로컬 LLM은 어떤 것입니까?
이 글에서 다루는 무검열 및 "abliterated" 파인튜닝 모델 — Hermes 3와 Dolphin 3.0을 포함 — 은 거부 레이어를 학습을 통해 제거했기 때문에 자체 콘텐츠 정책을 갖고 있지 않습니다. 이것이 로컬 모델과 호스팅형 모델의 실질적인 차이입니다: 클라우드 제공업체는 모든 요청에 약관을 적용하지만, 자신의 기기에서 실행되는 무제한 모델은 중간에 개입하는 제공업체가 없고 추론 시점에 어떤 검열도 적용되지 않습니다. 따라서 NSFW와 노골적인 픽션이 차단되지 않습니다. 변하지 않는 것은 거주 지역의 법률과 공개에 따르는 책임입니다 — 콘텐츠 정책이 없다는 것이 한계가 없다는 것을 의미하지는 않으며, 그 경계가 어디에 있는지는 아래 윤리 섹션에서 다룹니다.
가장 좋은 무검열 로컬 LLM은 무엇인가요?
하나의 최고 모델은 없으며 보유한 메모리에 따라 다릅니다. 이 페이지는 모델 카드를 확인한 7개 모델을 Q4_K_M 파일 크기순으로 나열합니다. Hermes 3 Llama 3.1 8B, Dolphin 3.0 Llama 3.1 8B, Llama 3.1 8B Instruct abliterated(각 4.92 GB), Dolphin 3.0 R1 Mistral 24B(14.33 GB), Gemma 3 27B abliterated(16.5 GB), Hermes 4.3 36B(21.76 GB), Hermes 3 Llama 3.1 70B(42.52 GB)입니다. 순서는 편집팀의 하드웨어 단계별 구분이며 벤치마크가 아니고, 저희가 이 모델들을 직접 실행한 것도 아닙니다.
로컬에서 쓸 최고의 NSFW LLM은 무엇인가요?
같은 순위가 적용됩니다. Q4_K_M 파일이 메모리에 들어가는 가장 큰 모델을 고르세요. Hermes 3과 Dolphin 3.0 카드는 사용자가 제어하는 정렬을 설명할 뿐 NSFW를 언급하지 않고, abliteration 모델 두 개는 카드에 uncensored로 표기돼 있습니다. 범위는 성인 등장인물 사이의 창작물로 한정하세요. 미성년자가 관련된 성적 콘텐츠와 실존 인물의 성적 묘사는 어떤 모델이든 금지이며, 윤리 섹션에서 설명합니다.
LLM에서 abliterated는 무슨 뜻인가요?
Abliterated는 거부를 매개하는 모델 내부의 방향을 재학습 없이 가중치에서 제거했다는 뜻입니다. 연구자들은 공개 채팅 모델 13종에서 거부가 1차원 부분공간으로 매개된다는 것을 발견했고, abliteration 설명은 원본 모델 대비 성능 하락과 파인튜닝으로도 일부만 회복됐다고 보고합니다. 카드에서 정렬을 시스템 프롬프트에 맡기는 파인튜닝과는 다릅니다.
무검열 LLM에는 VRAM이 얼마나 필요한가요?
최소한 Q4_K_M 파일 크기에 컨텍스트 캐시와 런타임 공간을 더한 만큼 필요합니다. 8B 모델 3종은 4.92 GB, Dolphin 3.0 R1 Mistral 24B는 14.33 GB, Gemma 3 27B abliterated는 16.5 GB, Hermes 4.3 36B는 21.76 GB, Hermes 3 Llama 3.1 70B는 42.52 GB입니다. Q8_0 파일은 더 커서 8B 모델은 8.54 GB, Hermes 4.3 36B는 38.42 GB입니다.
Ollama, LM Studio, llama.cpp에서 무검열 LLM을 어떻게 실행하나요?
Ollama에서는 ollama run hermes3 또는 ollama run dolphin3을 실행하거나 ollama run hf.co/<user>/<repo>로 임의의 GGUF를 불러옵니다. LM Studio에서는 lms get <model-name>@q4_k_m을 실행합니다. llama.cpp에서는 llama cli -hf <user>/<repo>를, OpenAI 호환 서버가 필요하면 llama serve -hf <user>/<repo>를 실행합니다. SillyTavern 같은 프런트엔드는 위의 설정 섹션에서 다룹니다.