Faits rapides
- Modèles de départ (d'après les fiches de modèle) : Qwen3.6 27B (dense, Apache-2.0, contexte de 262 144 tokens), Gemma 4 31B (dense, Apache-2.0, contexte de 256K), Llama 3.3 70B (dense, contexte de 128K, Llama 3.3 Community License).
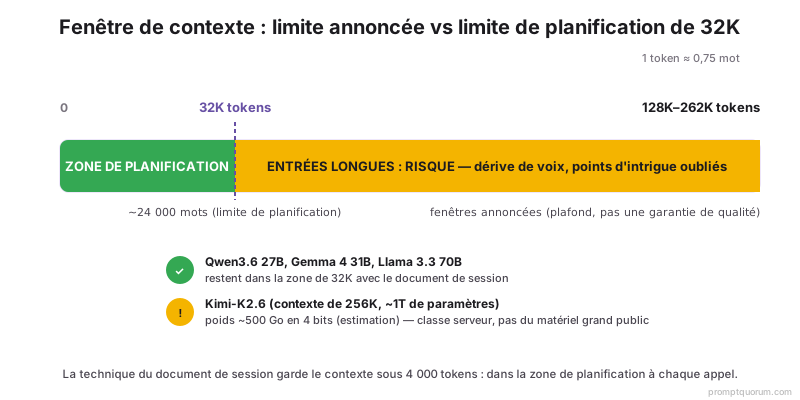
- Limite de planification de la fenêtre de contexte : ~32 000 tokens (~24 000 mots) par génération ; les modèles annoncent 128K–262 144 tokens, ce qui est un plafond, pas une garantie de qualité.
- Taille du document de session : viser moins de 4 000 tokens (fiches personnages + résumés chapitres + configuration scène actuelle).
- Cible de génération de scène : 200–600 mots par appel de génération ; scènes plus longues via plusieurs prompts séquentiels.
- Format scénario : combiner Ollama avec des instructions de sortie au format Fountain pour du texte formaté screenplay.
- Outils d'écriture compatibles Ollama : Scrivener (coller la sortie ; pas d'API de plugins documentée), Obsidian (via plugin local ou scripts), VS Code (via Continue.dev ou appels API directs), terminal brut.
- Option à faible taux de refus : Hermes 4 70B (base Llama-3.1-70B) pour la fiction adulte ; même workflow, même technique du document de session.
Le problème de la fenêtre de contexte pour l'écriture longue
Prévoir environ 32 000 tokens par génération, même quand un modèle en annonce bien davantage. Il s'agit d'une règle de planification prudente de PromptQuorum, non d'une limite mesurée : la recherche sur les contextes longs (Liu et al., « Lost in the Middle ») a constaté que les modèles exploitent plus fiablement les informations du début et de la fin d'une longue entrée que celles du milieu, et que la qualité peut baisser à mesure que l'entrée s'allonge. Les modèles récents annoncent des fenêtres bien plus grandes — Qwen3.6 27B annonce 262 144 tokens en natif et Gemma 4 31B 256K —, il faut donc tester son propre modèle. Pour un roman, coller le manuscrit écrit jusque-là et demander le chapitre suivant reste l'approche la moins fiable, et un long contexte consomme aussi plus de mémoire, car le cache KV grossit avec lui.
Kimi-K2.6 de Moonshot AI annonce une fenêtre de contexte de 256K tokens (262 144), de la même classe que les modèles ci-dessus, mais c'est un modèle à mélange d'experts d'environ 1 000 milliards de paramètres au total (32 milliards actifs) livré avec des poids int4 natifs. Même en 4 bits, les poids seuls représentent environ 500 Go (estimation PromptQuorum : 1 000 milliards de paramètres × 0,5 octet) ; c'est un modèle de classe serveur, pas un modèle de portable. La technique du document de session et la génération scène par scène s'appliquent aux modèles exécutables en local, quelle que soit la taille de leur contexte.
📍 En une phrase
Un plafond de planification prudent pour l'adhérence au contexte des LLM locaux est d'environ 32 000 tokens (~24 000 mots) par génération — au-delà, la recherche sur les contextes longs constate une exploitation moins fiable du contenu antérieur, ce qui peut se traduire par une dérive de voix et des incohérences d'intrigue sur un long manuscrit.
💬 En termes simples
On ne peut pas compter sur un modèle pour se souvenir de ce qui s'est passé au chapitre 3 en écrivant le chapitre 20 simplement parce que tout le manuscrit tient dans sa fenêtre de contexte. À la place : compresser ce que le modèle doit savoir — fiches personnages, résumés de chapitres, configuration de la scène en cours — dans un document de session de moins de 4 000 tokens, et l'injecter au début de chaque session d'écriture. Le modèle n'a besoin de connaître que ce qui est pertinent pour la scène qu'il génère à cet instant.
- Conversion token-mot : 1 token ≈ 0,75 mot en anglais (règle empirique). 32K tokens ≈ 24 000 mots. 128K tokens ≈ 96 000 mots (environ un roman) ; 262 144 tokens ≈ 196 000 mots.
- Dégradation de l'attention : les modèles peuvent perdre la référence fiable au contenu du début d'une longue fenêtre — erreurs de noms de personnages, points d'intrigue oubliés, dérive de voix.
- L'asymétrie : dans l'étude Lost in the Middle, les modèles exploitaient le mieux le début et la fin de l'entrée, et le moins fiablement le contenu du milieu. L'étude portait sur des modèles disponibles en 2023 ; il faut donc tester les modèles actuels plutôt que de supposer le même schéma.
- Document de session comme solution : compresser tout ce dont le modèle a besoin dans un court document structuré. Injecter au début. Générer la scène. Terminer la session. Réinitialiser. Recommencer avec le document mis à jour.
⚠️Attention: Ne pas coller le manuscrit complet dans le contexte. Au-delà de 10 000 mots, le risque de dérive de contexte apparaît — le modèle peut oublier les détails des personnages, contredire les points d'intrigue établis et retomber vers un registre générique. Utiliser la technique du document de session.
Technique du document de session
La technique du document de session est une recommandation de workflow de PromptQuorum, fondée sur les limites de contexte décrites plus haut. PromptQuorum ne l'a pas soumise à un test contrôlé, et les tailles ci-dessous (4 000 tokens, 150 mots par fiche de personnage, 100–150 mots par résumé de chapitre) sont des repères de planification, non des seuils mesurés.
Le document de session est un fichier texte brut maintenu à côté du manuscrit — l'état compressé du roman que le modèle doit connaître pour générer du contenu cohérent. Il comporte trois sections : fiches de personnages actifs, résumés de chapitres et configuration de la scène en cours.
Modèle de document de session
“# SESSION DOCUMENT — [NOVEL TITLE] ## ACTIVE CHARACTERS [Character Name] Dominant trait: [one trait] Contradicting behaviour: [one behaviour] Speech register: [formal/casual/specific verbal tics] Relationship to [other character]: [brief] [Character Name 2] [same structure] ## CHAPTER SUMMARIES (completed) Chapter 1: [100–150 words — what happened, what changed, where it ended] Chapter 2: [100–150 words] [continue for all completed chapters] ## CURRENT SCENE SETUP Chapter: [N] Scene: [brief description of what this scene needs to accomplish] POV: [character name] Opening state: [where we are at the start of this scene — 1 sentence] Emotional beat to land on: [what the POV character feels at the end — do not state it directly in the scene] Word ceiling: [200–500 words]”
- Fiches de personnages — cible 150 mots par personnage actif. Inclure trait dominant, comportement contradictoire, registre de parole et relation clé aux autres personnages actifs.
- Résumés de chapitres — cible 100–150 mots par chapitre terminé. Focus sur : ce qui s'est passé, ce qui a changé dans les relations, ce que le lecteur sait maintenant, où le chapitre s'est terminé spatialement et émotionnellement.
- Configuration de la scène actuelle — spécifique et bref. Nommer le PDV, le but de la scène, le beat émotionnel à atteindre et le plafond de mots. C'est l'action que le modèle exécute.
- Taille du document — cible moins de 4 000 tokens (~3 000 mots). Un document dépassant cette taille empiète sur l'espace de contexte dédié à la génération. Compresser agressivement.
- Mettre à jour après chaque session. Ajouter 1–2 phrases au résumé du chapitre et mettre à jour les fiches modifiées. Le document de session est un fichier vivant.
💡Astuce: Conserver le document de session dans un fichier texte brut à côté du manuscrit. Dans Ollama, créer un Modelfile avec le document dans le bloc SYSTEM et le rafraîchir avant chaque session. Dans SillyTavern, le coller dans le champ system prompt au début de chaque session.
Workflow d'écriture de roman
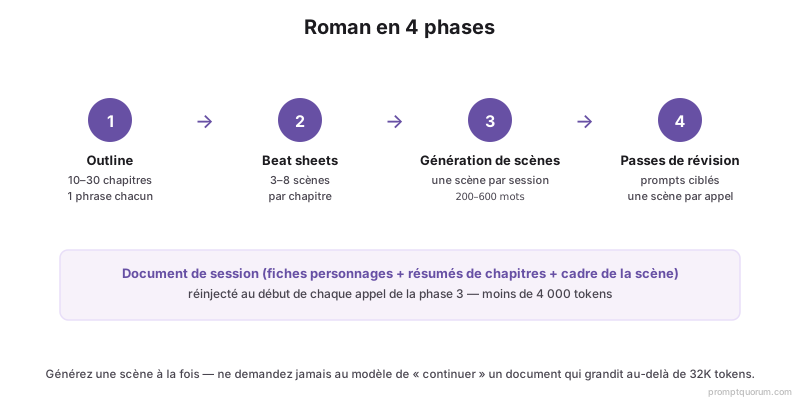
Le workflow d'écriture de roman avec un LLM local comporte quatre phases : outline, beat sheets de chapitres, génération de scènes et passes de révision. Chaque phase utilise une structure de prompt différente.
- Phase 1 — Outline : générer un outline au niveau des chapitres (10–30 chapitres, une phrase par chapitre). Prompt : « Genre : [genre]. Protagoniste : [Nom + blessure fondamentale]. Conflit central : [en une phrase]. Écrire un outline de 20 chapitres — une phrase par chapitre, chaque phrase nommant la scène et le changement. » Réviser l'outline avant de continuer.
- Phase 2 — Beat sheets : développer chaque entrée de chapitre en beat sheet de niveau scène (3–8 scènes par chapitre). Prompt par chapitre : « Résumé chapitre [N] : [coller l'entrée]. Développer en beat sheet : 4–6 scènes, chacune décrite en une phrase nommant lieu, participants et le seul changement de la scène. Pas de prose encore. »
- Phase 3 — Génération de scènes : utiliser le document de session + le beat de la scène actuelle pour générer une scène à la fois. Générer, réviser, coller dans le manuscrit, mettre à jour le document de session. Répéter.
- Phase 4 — Passes de révision : après avoir terminé un chapitre, appliquer des prompts de révision ciblés sur des scènes spécifiques. Voir Prompts LLM locaux pour les auteurs de fiction. Ne jamais demander au modèle de réviser plus d'une scène par appel.
💡Astuce: Conserver l'outline et les beat sheets dans des fichiers séparés du manuscrit. Ils sont le squelette — le manuscrit est la chair. Des fichiers séparés permettent de régénérer n'importe quelle partie sans écraser l'autre.
Workflow scénario
L'écriture de scénarios avec un LLM local utilise les mêmes techniques de document de session et de beat sheet, avec deux ajouts : des instructions de format dans le system prompt et la génération des en-têtes de scène (slug lines) comme étape séparée de la génération de pages.
System prompt pour scénario
“You are a screenplay formatting assistant. All prose you generate is formatted in standard US screenplay format: - Scene headers: INT./EXT. LOCATION — DAY/NIGHT - Action lines: present tense, concrete, maximum 3 lines per block - Character names: ALL CAPS above dialogue - Dialogue: centred, no dialogue tags - Parentheticals: sparingly, only for delivery or action mid-dialogue Generate in Fountain-compatible plain text.”
Prompt beat de scène vers pages de script
“Beat: [paste the one-sentence scene beat from the beat sheet] POV character: [Name] Page target: [1–3 pages] Generate the script pages for this beat. Use standard screenplay format. Begin with the slug line. No narration — action lines and dialogue only.”
- Format dans le system prompt, pas dans le tour utilisateur. Placer les instructions de format dans le message système signifie que chaque génération de la session suit le format sans répéter l'instruction.
- Sortie compatible Fountain : Fountain est un format de balisage en texte brut pour scénarios ; Highland et Fade In le lisent, comme d'autres applications du répertoire d'applications Fountain. Demander « Fountain-compatible plain text » produit une sortie que l'on peut ouvrir dans ces outils ou convertir pour d'autres (voir la question sur Final Draft dans la FAQ).
- Slug lines d'abord : générer la slug line comme prompt d'une ligne avant de générer le contenu de la scène. Cela ancre le lieu physique avant que le modèle commence.
- Passes de dialogue : après les lignes d'action, faire une passe séparée : « Les lignes d'action sont définies. Écrire le dialogue pour [Personnage A] et [Personnage B]. Personnage A veut [X]. Personnage B veut [Y]. Pas de balises de dialogue. 5–8 échanges. »
- Gestion du nombre de pages : il n'existe pas de nombre de mots par page fixe, et « une page égale une minute » n'est qu'une règle empirique. Compter la moyenne de mots par page de son propre script et fixer les plafonds de mots à partir de là.
💡Astuce: La discipline beat-sheet-first est plus importante pour les scénarios que pour les romans. Une scène de scénario a une fonction structurelle précise et un objectif de pages. Générer des pages sans beat sheet produit des scènes qui dérivent en longueur et perdent leur fonction. Toujours savoir ce qu'une scène doit accomplir avant de générer les pages.
Templates de génération de scènes pour le long format
La génération de scènes longues nécessite le document de session comme préfixe et un seul prompt de scène comme action. Les templates ci-dessous supposent que le document de session est déjà dans le message système ou le premier tour utilisateur.
📍 En une phrase
Pour la fiction longue, un schéma de génération fiable est : document de session dans le system prompt → unique prompt de scène dans le tour utilisateur → réviser → mettre à jour le document de session → répéter, une scène par session.
💬 En termes simples
Le modèle doit savoir trois choses pour écrire la scène suivante de façon cohérente : qui sont ces personnages (fiches), ce qui s'est déjà passé (résumés de chapitres) et ce que cette scène doit accomplir (configuration). Donner exactement ces trois choses, rien de plus. Générer la scène, la coller dans le manuscrit, mettre à jour le document de session. Répéter.
Prompt de génération de scène de roman
“[SESSION DOCUMENT ALREADY IN SYSTEM PROMPT] Current scene: Chapter: [N] Beat: [one sentence from the beat sheet] POV: [character name] Opening: [one sentence — where we are, who is present] Emotional landing: [what the POV character feels at the end — show, don't state] Word ceiling: [300–500 words] Write this scene. No summarising. Every sentence renders a moment.”
Prompt de vérification de continuité
“Before writing the next scene, check for continuity. The session document says: - [Character A] is [trait/state] - The last scene ended with [brief description] The next scene opens with [brief description]. Does this transition make sense? If not, what needs to change in the transition? One paragraph answer only.”
💡Astuce: Utiliser le prompt de vérification de continuité aux transitions de chapitres — pas à chaque scène. Les transitions de chapitres (où le lieu, le temps ou le personnage PDV change) sont l'endroit où les ruptures de continuité sont les plus fréquentes.
Intégrations d'outils pour les auteurs
Ollama expose une API compatible OpenAI sur localhost qu'un écosystème croissant d'outils orientés auteurs connecte. Les intégrations ci-dessous représentent les options les plus établies.
Obsidian
- Lien:
- obsidian.md
- Intégration:
- Plugin Copilot ou Smart Connections → API Ollama. Voir Obsidian + Plugins LLM locaux pour le guide approfondi.
- Idéal pour:
- Auteurs utilisant déjà Obsidian pour les notes + manuscrit ; génération dans la même appli sans changer de contexte
Scrivener
- Intégration:
- Script externe via API Ollama → coller dans le document
- Idéal pour:
- Auteurs structurant leurs romans dans Scrivener ; brouillons IA collés dans la structure de projet existante
VS Code
- Intégration:
- Extension Continue.dev → backend Ollama
- Idéal pour:
- Auteurs techniques et concepteurs de narration de jeux à l'aise dans un éditeur de code
SillyTavern
- Intégration:
- API compatible OpenAI → Ollama
- Idéal pour:
- Fiction roleplay et rédaction guidée par fiches personnages ; mémoire de personnage persistante
Articles sur SillyTavern (10)
- SillyTavern in 2026: The Free Frontend for AI Character Roleplay and Long-Form ChatMis à jour 5 septembre 2026
- RisuAI Review: Open-Source Roleplay Chat ClientMis à jour 2 novembre 2026
- Agnai Review: Self-Hostable AI Roleplay ChatMis à jour 30 octobre 2026
- Castmates Review: Offline AI Character Chat for iPhoneMis à jour 26 octobre 2026
- Best Uncensored Local LLMs for Erotica & Creative Writing 2026: Hermes 3 vs DolphinMis à jour 18 octobre 2026
- text-generation-webui in 2026: How Oobabooga's Local LLM UI Became "TextGen"Mis à jour 5 septembre 2026
- LibreChat Review: Self-Hosted ChatGPT Alternative for Local LLMsMis à jour 3 septembre 2026
- Backyard AI Review: Local AI Character Chat and RoleplayMis à jour 2 septembre 2026
- Open WebUI vs SillyTavern: Best Chat UI for Local LLMsMis à jour 30 août 2026
- SillyTavern vs Agnai vs RisuAI: Best Local Roleplay Frontend (2026)Mis à jour 29 août 2026
+7 autres non affichés
Terminal brut
- Lien:
- —
- Intégration:
- `ollama run [model]` ou curl vers l'API Ollama
- Idéal pour:
- Workflows scriptables ; contrôle maximal avec overhead d'interface minimal
LM Studio
- Lien:
- lmstudio.ai
- Intégration:
- Interface de chat intégrée + API serveur local
- Idéal pour:
- Auteurs souhaitant un gestionnaire de modèles GUI sans installer Ollama séparément
Articles sur LM Studio (10)
- LM Studio Review: The GUI-First Local AI Desktop AppMis à jour 23 octobre 2026
- Apple Silicon for Local LLMs 2026: M1 to M6 Complete GuideMis à jour 6 novembre 2026
- LLM Quantization Explained: Q4_K_M vs Q4_0 vs Q8_0 (2026)Mis à jour 6 novembre 2026
- LobeChat vs Big-AGI vs NextChat vs Page Assist vs Chatbox: 2026 ComparisonMis à jour 6 novembre 2026
- NextChat Review 2026: Lightweight, One-Click-Deploy Chat UIMis à jour 6 novembre 2026
- Qwen Local Deployment Guide 2026: Qwen 3.6 27B, Coder & VL Hardware TiersMis à jour 6 novembre 2026
- Best Local LLM Apps for Mac in 2026: LM Studio, Ollama, Jan and 5 MoreMis à jour 6 novembre 2026
- Ollama MCP Setup 2026: Connect Local Models to Files, Databases and APIsMis à jour 6 novembre 2026
- Local LLM Prompts for Fiction Writers: 15 Templates & Techniques (2026)Mis à jour 6 novembre 2026
- Page Assist Review 2026: Browser Sidebar for Local AI ModelsMis à jour 3 novembre 2026
+162 autres non affichés
NovelCrafter
- Lien:
- novelcrafter.com
- Intégration:
- Intégration IA intégrée ; ses pages d'aide mentionnent des connexions LM Studio, Ollama et des endpoints compatibles avec l'API OpenAI
- Idéal pour:
- Auteurs souhaitant une assistance IA au niveau chapitre dans une seule app dédiée au roman
Plottr
- Lien:
- plottr.com
- Intégration:
- Workflow manuel : structurer les romans dans Plottr, coller scènes/beats dans Ollama en externe (Plottr indique ne pas ajouter de fonctions d'IA)
- Idéal pour:
- Fiction de genre à plot dense (polar, thriller, fantasy) où la structure narrative est le cœur du workflow
💡Astuce: L'intégration la plus simple pour la plupart des auteurs : Obsidian + le plugin Copilot pointant vers Ollama. Le document de session, les chapitres du manuscrit et la génération dans la même appli sans changement de contexte. Voir Obsidian + Plugins LLM locaux pour le guide approfondi.
Recommandations de modèles pour le long format
Le long format a des exigences différentes de la fiction courte. L'adhérence au contexte, la cohérence du suivi des instructions sur des sessions longues et la capacité à maintenir la voix sur plusieurs appels de génération sont les facteurs décisifs. Les lignes ci-dessous sont des points de départ tirés de la fiche de chaque modèle ; PromptQuorum n'a pas évalué ces modèles pour la fiction, et les classements publics d'écriture créative notent les modèles différemment — il faut donc tester deux candidats sur l'une de ses propres scènes. Les modèles ouverts de classe serveur comme Command A+ (218 milliards de paramètres au total, 25 milliards actifs, Apache 2.0) et Mistral Large 3 (675 milliards de paramètres au total, contexte de 256K, Apache 2.0) dépassent la portée du matériel grand public. Pour le panorama complet des modèles, voir Meilleurs LLM locaux en 2026.
Rédaction de roman (principal)
- Modèle recommandé:
- Qwen3.6 27B ou Gemma 4 31B
- Pourquoi:
- Modèles denses de 27B–31B annonçant 256K+ de contexte sous licences Apache ; une classe de taille adaptée à un GPU de 24 Go ou à 32 Go+ de mémoire unifiée en 4 bits (estimation)
Écriture de scénarios
- Modèle recommandé:
- Qwen3.6 27B ou Llama 3.3 70B
- Pourquoi:
- L'adhérence au format dépend surtout du prompt système ; tester une scène Fountain sur deux modèles. Llama 3.3 70B est dense, annonce 128K de contexte et demande environ 40 Go en 4 bits (estimation)
Génération de beat sheet / outline
- Modèle recommandé:
- Qwen3.6 35B-A3B
- Pourquoi:
- Mélange d'experts avec 3B de 35B paramètres actifs par token (Apache-2.0), donc génération plus rapide par token ; qualité des outlines non évaluée par PromptQuorum
Passes de dialogue
- Modèle recommandé:
- Le modèle dont les échantillons conviennent
- Pourquoi:
- Faire le dialogue en passe séparée avec le modèle dont les lignes de calibration correspondent au registre du personnage ; il n'existe pas de classement vérifié des modèles pour le dialogue
Révision (structurelle)
- Modèle recommandé:
- Le modèle utilisé pour le premier jet
- Pourquoi:
- Les prompts de révision qui nomment une contrainte structurelle par appel fonctionnent avec tout modèle suivant les instructions ; une scène par appel
Fiction adulte / sombre
- Modèle recommandé:
- Hermes 4 70B
- Pourquoi:
- Base Llama-3.1-70B ; Nous Research décrit un alignement globalement neutre et moins de refus ; licence Llama 3 ; mode de raisonnement hybride
Erreurs fréquentes
- Coller le manuscrit complet dans le contexte. Même quand un modèle annonce une fenêtre de 128K–262K, les longues entrées sont exploitées moins fiablement ; il faut donc prévoir environ 32 000 tokens. Utiliser la technique du document de session — fiches de personnages et résumés de chapitres compressés.
- Demander au modèle de « continuer » un document ouvert. « Continue le roman » produit de la dérive. « Écris la scène suivante : [configuration spécifique, PDV, plafond de mots] » produit une sortie bornée et cohérente.
- Pas de beat sheets pour les scénarios. Générer des pages sans beat sheet produit des scènes qui dérivent en longueur et perdent leur fonction structurelle. Générer le beat sheet en premier, toujours.
- Ignorer les mises à jour du document de session. Un document de session obsolète produit des incohérences en quelques sessions.
- Générer plus d'une scène par session. La génération multi-scènes dans une fenêtre produit la première scène correctement et chaque suivante avec moins de cohérence. Une scène par session ; réinitialiser et réinjecter.
Sources
- Fiche de modèle Qwen3.6-27B et fiche de modèle Qwen3.6-35B-A3B — paramètres, contexte natif de 262 144 tokens, extension YaRN, Apache-2.0, consultées le 26 octobre 2026
- Fiche de modèle Gemma 4 31B — 31B dense, contexte de 256K, Apache 2.0, consultée le 26 octobre 2026
- Fiche de modèle Llama 3.3 70B Instruct — 70B, contexte de 128K, Llama 3.3 Community License, publié le 6 décembre 2024
- Fiche de modèle Hermes 4 70B — base Llama-3.1-70B, raisonnement hybride, « broadly neutral alignment »
- Fiche de modèle Kimi-K2.6 — 1 000 milliards de paramètres au total et 32 milliards actifs, contexte de 256K, int4 natif
- Documentation Command A+ et fiche de modèle Mistral Large 3 — nombre de paramètres et licences des modèles de classe serveur
- Lost in the Middle: How Language Models Use Long Contexts — Liu et al., 2023
- Fountain.io — spécification du format de scénario Fountain et liste d'applications
- Centre d'aide Final Draft — indique que Final Draft ne peut pas importer directement les fichiers .fountain
- Règles d'IA d'Amazon KDP, Publishers Weekly et soumissions à Clarkesworld — politiques d'IA des éditeurs et plateformes ; vérifier la formulation en vigueur avant d'envoyer
- Notes de version Scrivener — versions 3.4.0 à 3.5.2 (décembre 2025) : aucune entrée sur les plugins ou l'API ; « Scrivener itself contains no AI » ; consultées le 26 octobre 2026
- Plottr in 2026 et aide NovelCrafter sur les connexions IA — Plottr indique ne pas développer de fonctions d'IA ; NovelCrafter mentionne des connexions LM Studio, Ollama et des endpoints compatibles avec l'API OpenAI
- Documentation API Ollama — Ollama
Questions fréquemment posées
Un LLM local peut-il écrire un roman complet ?
Un LLM local peut générer la prose d'un roman complet — mais l'intelligence structurelle et éditoriale doit venir de l'auteur. Le modèle génère des scènes à partir de consignes précises ; il ne planifie, n'évalue ni ne prend de décisions thématiques de lui-même. Il vaut mieux le voir comme un générateur rapide de premiers jets pour des scènes que l'on sait déjà écrire : il fait gagner du temps face à la page blanche, tandis que l'auteur prend toutes les décisions importantes. Vérifier les politiques d'IA des éditeurs et des plateformes avant d'envoyer (voir la question sur les éditeurs plus bas).
Quelle est la fenêtre de contexte maximale utilisable de façon fiable ?
Les modèles annoncent de 128K à 262 144 tokens, mais PromptQuorum recommande de prévoir environ 32 000 tokens (~24 000 mots) par génération, car la recherche sur les contextes longs montre que les modèles exploitent moins fiablement le milieu des longues entrées. C'est une règle de planification prudente, non une limite mesurée pour chaque modèle — il faut tester le sien. La technique du document de session garde le contexte de travail sous 4 000–6 000 tokens, de sorte que chaque appel de génération reste bien dans cette plage.
Comment empêcher le modèle de changer la voix de mon personnage en cours de roman ?
La dérive de voix a deux causes : un document de session obsolète et la dilution du contexte. Solution : placer la fiche de personnage dans le message système, la mettre à jour après chaque scène avec un moment d'arc significatif, et la garder concise.
Puis-je utiliser Scrivener avec un LLM local ?
Pas nativement — Scrivener 3 ne documente aucun système de plugins, et ses notes de version officielles jusqu'à la 3.5.2 (décembre 2025) ne mentionnent aucune intégration d'IA : les notes de la 3.4.0 indiquent « Scrivener itself contains no AI » et ajoutent la prise en charge des Writing Tools d'Apple, une fonction système de macOS. Un workflow courant : générer dans Ollama (via le terminal ou un script compagnon), copier la sortie, la coller dans le document Scrivener concerné. Certains auteurs utilisent Obsidian comme couche de rédaction assistée et importent les chapitres terminés dans Scrivener pour la structuration finale. Les scripts qui appellent l'API Ollama et copient la sortie dans le presse-papiers sont ce qui se rapproche le plus d'une intégration native.
Qu'est-ce qui est mieux pour les scénarios : Ollama ou une IA cloud ?
Pour les scénaristes qui doivent générer du contenu adulte (violence, psychologie sombre, personnages moralement complexes), un modèle local donne le contrôle du modèle et de son comportement de refus — certains modèles hébergés refusent ou adoucissent des contenus présents dans les scripts dramatiques, et les politiques des services hébergés évoluent avec le temps. Un modèle local à faible taux de refus comme Hermes 4 70B a moins de refus intégrés, mais l'on reste responsable du contenu généré et publié. La cohérence du format dépend surtout des instructions du prompt système, qui fonctionnent dans les deux cas. Le choix porte surtout sur le contrôle du contenu, la confidentialité et le coût ; PromptQuorum n'a pas comparé la qualité de sortie entre modèles hébergés et locaux pour le scénario.
Comment générer du dialogue qui ressemble à un personnage spécifique ?
Approche en trois étapes : (1) Ajouter le registre de parole du personnage au document de session. (2) Générer 3–5 lignes de dialogue d'exemple comme étape de calibration en début de session. (3) Utiliser ces lignes d'exemple dans le prompt de dialogue : « Écrire du dialogue dans le même registre que ces exemples : [coller]. »
Ai-je besoin d'un GPU pour utiliser un LLM local pour la rédaction de roman ?
Un GPU accélère nettement la génération mais n'est pas indispensable. Sur Apple Silicon, la mémoire unifiée permet à un MacBook Pro de 16 Go d'exécuter des modèles plus petits (environ la classe 8B en 4 bits, une estimation, car macOS en réserve environ 8 Go) — plus lent qu'une machine à GPU de 24 Go, mais acceptable quand on lit et évalue la sortie entre deux générations. Un GPU NVIDIA de 24 Go (RTX 4090, RTX 3090) accueille des modèles de la classe 27B–32B en 4 bits (estimation) ; les modèles de classe 70B demandent environ 40 Go ou plus en 4 bits et nécessitent donc deux GPU, une carte de 48 Go, 64 Go de mémoire unifiée ou un déchargement vers le CPU, plus lent.
Puis-je utiliser des LLM locaux avec Final Draft ou d'autres logiciels de scénario professionnels ?
Pas directement. Selon le centre d'aide de Final Draft, Final Draft ne peut pas importer les fichiers .fountain ; sa recommandation est d'enregistrer le texte en .txt brut et d'importer ce fichier comme un script, ou de l'importer en FDX depuis une application qui exporte ce format. Highland convertit entre Fountain, FDX et PDF, et Fade In importe et exporte Fountain (d'après le répertoire d'applications Fountain). Workflow : générer du texte au format Fountain dans Ollama, l'ouvrir dans Highland ou Fade In, puis exporter en FDX pour Final Draft.
Puis-je utiliser Kimi-K2.6 localement pour la rédaction de roman ?
Kimi-K2.6 annonce une fenêtre de contexte de 256K tokens, de la même classe que Qwen3.6 27B et Gemma 4 31B, mais c'est un modèle à mélange d'experts d'environ 1 000 milliards de paramètres au total (32 milliards actifs) avec des poids int4 natifs. Les poids seuls représentent environ 500 Go (estimation PromptQuorum) ; il faut un serveur multi-GPU ou une machine à très grande mémoire unifiée, et il est peu pratique sur du matériel grand public. Pour des workflows entièrement locaux, un modèle dense de 27B–70B avec la technique du document de session couvre un travail de la longueur d'un roman sans modèle à mille milliards de paramètres.
Quelle est la position des éditeurs sur les manuscrits assistés par IA ?
Les politiques varient selon l'éditeur et la plateforme et continuent d'évoluer en 2026 ; il faut donc vérifier celle qui s'applique avant d'envoyer. Amazon KDP exige de signaler quand le texte, les images ou les traductions sont générés par IA, et considère un contenu créé par un outil d'IA comme généré par IA même après une retouche importante ; un texte écrit par soi-même que l'IA a seulement aidé à relire ou à affiner est « assisté par IA » et n'a pas à être déclaré (d'après les règles d'Amazon rapportées par Publishers Weekly en septembre 2023). Certaines revues rejettent d'emblée tout travail impliquant l'IA — les consignes de soumission de Clarkesworld, dans sa déclaration sur l'usage d'outils d'écriture « IA » comme ChatGPT, indiquent que la revue n'examinera aucune soumission traduite, écrite, développée ou assistée par ces outils. Un texte de scène généré par un LLM local relève de définitions comme celle de « généré par IA » de KDP : le déclarer là où c'est exigé. Il s'agit d'informations générales, et non d'un conseil juridique.
De quel matériel ai-je besoin pour des contextes d'un million de tokens ?
Qwen3.6 27B et Qwen3.6 35B-A3B annoncent un contexte natif de 262 144 tokens, extensible jusqu'à environ 1 010 000 tokens avec la mise à l'échelle YaRN (d'après leurs fiches de modèle). Un long contexte demande de la mémoire pour le cache KV en plus des poids ; une exécution à un million de tokens exige donc bien plus de mémoire qu'une configuration grand public typique ; PromptQuorum n'a pas mesuré ce besoin. La technique du document de session de cet article est conçue précisément pour cet écart : obtenir une sortie longue et cohérente sans dépendre d'une fenêtre d'un million de tokens.
Dois-je respecter le RGPD en utilisant un LLM local pour écrire des romans ou des scénarios ?
Avec des modèles entièrement locaux (Ollama sur son propre matériel, pas d'API cloud), aucune donnée personnelle n'est transmise à des serveurs externes — les exigences du RGPD pour les transferts de données (Art. 28) ne s'appliquent pas. Si des données personnelles de personnes réelles entrent dans les prompts, les principes du RGPD (minimisation des données, limitation des finalités) peuvent s'appliquer. Pour la fiction fictive sans lien avec des personnes réelles, les workflows LLM entièrement locaux ne posent généralement pas de problème RGPD.
Quelles restrictions légales s'appliquent en France à l'écriture de contenus à caractère sexuel ou violent avec un LLM local ?
Pour la fiction adulte légale avec des scénarios consentis entre personnages adultes, il n'existe pas de restrictions spécifiques à l'IA en France. L'article 227-23 du Code pénal interdit les représentations de mineurs à caractère pornographique — cela s'applique indépendamment du fait qu'un humain ou un modèle IA génère le texte. Pour les contenus violents, le droit pénal général s'applique. La responsabilité juridique incombe à l'utilisateur.