快速事实
- 模型起点(来自模型卡): Qwen3.6 27B(稠密,Apache-2.0,262,144 token上下文)、Gemma 4 31B(稠密,Apache-2.0,256K上下文)、Llama 3.3 70B(稠密,128K上下文,Llama 3.3 Community License)。
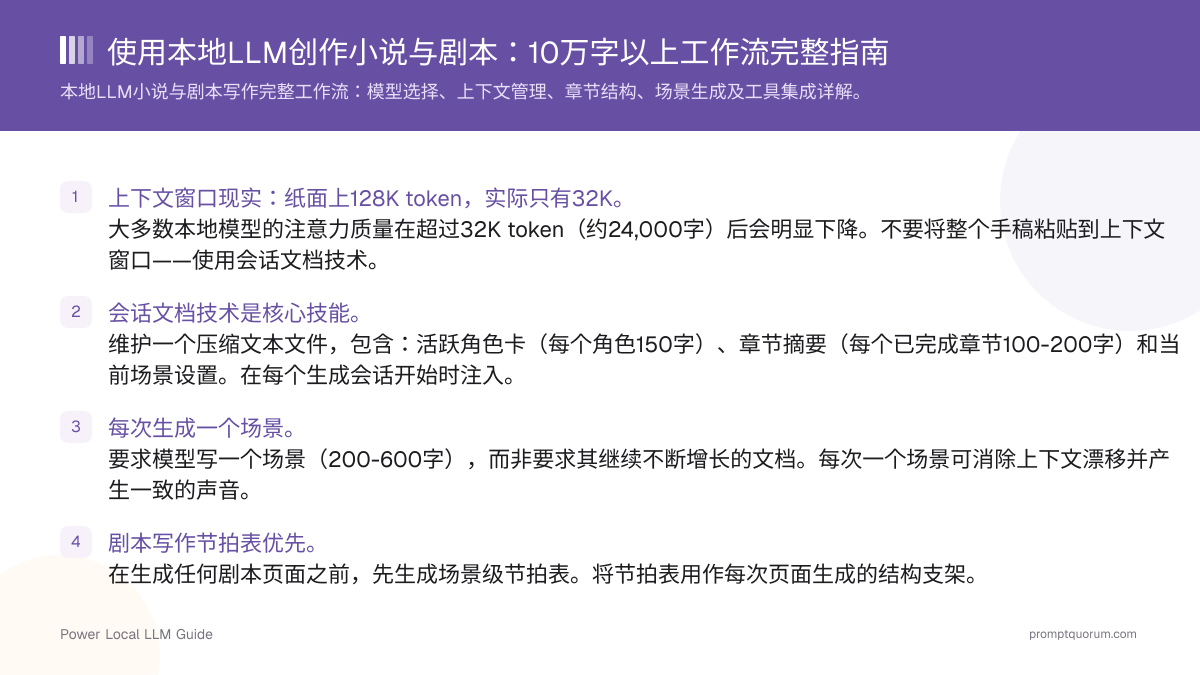
- 上下文窗口规划上限: 每次生成约32K token(约24,000字);模型标称128K–262,144 token,这是上限,而非质量保证。
- 会话文档大小: 目标低于4,000 token(角色卡+章节摘要+当前场景设置)。
- 场景生成目标: 每次生成调用200-600字;通过多个连续提示词生成较长场景。
- 剧本格式: 将Ollama与Fountain格式输出指令结合,生成剧本格式文本。
- 与Ollama配合的写作工具: Scrivener(粘贴输出;无公开文档的插件API)、Obsidian(通过本地插件或脚本)、VS Code(通过Continue.dev或直接API调用)、纯终端。
- 低拒答选项: 成熟小说用Hermes 4 70B(基于Llama-3.1-70B);相同工作流,相同会话文档技术。
长篇写作的上下文窗口问题
即使模型标称大得多的窗口,每次生成也应按约32K token规划。 这是PromptQuorum的保守规划规则,而非实测上限:长上下文研究(Liu等,"Lost in the Middle")发现,模型对长输入开头和结尾信息的利用比对中间信息更可靠,并且随着输入变长质量可能下降。较新的模型标称更大的窗口——Qwen3.6 27B原生标称262,144 token,Gemma 4 31B标称256K——因此应自己测试所用模型。对小说而言,粘贴目前的手稿并要求下一章仍是最不可靠的做法,而且长上下文还会占用更多内存,因为KV缓存会随之增长。
Moonshot AI的Kimi-K2.6标称256K token(262,144)的上下文窗口,与上述模型属于同一级别,但它是总参数约1万亿(激活320亿)的混合专家模型,并以原生int4权重发布。即使按4位计算,仅权重就约500 GB(PromptQuorum估算:1万亿参数×0.5字节),因此它是服务器级模型,而非笔记本级模型。会话文档技术和逐场景生成适用于任何上下文大小的本地可运行模型。
📍 简单一句话
本地LLM上下文遵循的保守规划上限约为每次生成32,000 token(约24,000字)——超过此限制,长上下文研究发现模型对早期内容的利用可靠性较低,这可能在长篇手稿中表现为声音漂移和情节不一致。
💬 简单来说
不能因为整部手稿放得进上下文窗口,就指望模型在写第20章时可靠地记得第3章发生了什么。替代方案:将模型需要知道的内容——角色卡、章节摘要、当前场景设置——压缩到不超过4,000 token的"会话文档"中,并在每个写作会话开始时注入。模型只需要知道与它正在生成的场景相关的内容。
- Token与字数换算: 英文中1个token约0.75个词(经验法则)。32K token约24,000个词。128K token约96,000个词(约一部小说);262,144 token约196,000个词。
- 注意力退化: 模型可能失去对长上下文窗口早期内容的可靠引用——表现为角色名字错误、遗忘情节点和声音漂移。
- 不对称性: 在Lost in the Middle研究中,模型对输入开头和结尾的利用最好,对中间内容的利用最不可靠。该研究测试的是2023年可用的模型,因此应测试当前模型,而不是假定模式相同。
- 会话文档作为解决方案: 将模型需要的所有内容压缩到简短的结构化文档中。开始时注入。生成场景。结束会话。重置。用更新后的文档重新开始。
⚠️警告: 不要将完整手稿粘贴到上下文中。如果你的小说超过10,000字并粘贴完整草稿来要求下一章,就有上下文漂移的风险——模型可能忘记早期角色细节,与已建立的情节点矛盾,并退回到通用风格。请改用会话文档技术。
会话文档技术
会话文档技术是PromptQuorum基于上文所述上下文限制提出的工作流建议。PromptQuorum未对其做过对照测试,下列大小(4,000 token、每张角色卡150字、每章摘要100-150字)是规划参考值,而非实测阈值。
会话文档是你在手稿旁边维护的纯文本文件——它是模型需要了解的、用于生成一致内容的小说压缩状态。 它有三个部分:活跃角色卡、章节摘要和当前场景设置。
会话文档模板
“# SESSION DOCUMENT — [NOVEL TITLE] ## ACTIVE CHARACTERS [Character Name] Dominant trait: [one trait] Contradicting behaviour: [one behaviour] Speech register: [formal/casual/specific verbal tics] Relationship to [other character]: [brief] [Character Name 2] [same structure] ## CHAPTER SUMMARIES (completed) Chapter 1: [100–150 words — what happened, what changed, where it ended] Chapter 2: [100–150 words] [continue for all completed chapters] ## CURRENT SCENE SETUP Chapter: [N] Scene: [brief description of what this scene needs to accomplish] POV: [character name] Opening state: [where we are at the start of this scene — 1 sentence] Emotional beat to land on: [what the POV character feels at the end — do not state it directly in the scene] Word ceiling: [200–500 words]”
- 角色卡——每个活跃角色目标150字。 包含主导特质、矛盾行为、说话风格和与其他活跃角色的关键关系。角色活跃或离开手稿时添加或移除。
- 章节摘要——每个已完成章节目标100-150字。 重点:发生了什么,角色关系发生了什么变化,读者现在知道哪些信息,章节在空间和情感上的结束位置。
- 当前场景设置——具体而简洁。 指定视角、场景目的(在故事中需要完成什么)、要达到的情感节拍和字数上限。
- 会话文档大小——目标低于4,000 token(约3,000字)。 超过这一大小的文档会占用本应用于生成本身的上下文空间。
- 每次会话后更新。 生成场景后,在相关章节摘要中添加1-2句更新,并更新任何发生变化的角色卡条目。
💡提示: 将会话文档保存在手稿旁边的纯文本文件中。在Ollama中,可以创建一个在SYSTEM块中包含会话文档的Modelfile,并在每次会话前刷新。在SillyTavern中,在每次小说会话开始时将其粘贴到系统提示字段中。
小说写作工作流
使用本地LLM的小说写作工作流有四个阶段:大纲、章节节拍表、场景生成和修改轮次。 每个阶段使用不同的提示词结构。
- 第一阶段——大纲: 生成章节级大纲(10-30章,每章一句话:发生什么,什么改变)。提示词:「类型:[类型]。主角:[姓名+核心创伤]。中心冲突:[一句话]。写一个20章大纲——每章一句话,每句话命名场景和变化。」在继续之前审查并编辑大纲。
- 第二阶段——节拍表: 将每个章节条目扩展为场景级节拍表(每章3-8个场景)。每章提示词:「第[N]章摘要:[粘贴一句话大纲条目]。扩展为场景级节拍表:4-6个场景,每个用一句话描述地点、参与者和场景的唯一变化。还不需要散文。」
- 第三阶段——场景生成: 使用会话文档+当前场景节拍,逐场景生成。生成、审查、粘贴到手稿、更新会话文档。重复。
- 第四阶段——修改轮次: 完成章节后,对特定场景运行有针对性的修改提示词。参见小说作家本地LLM提示词了解修改提示词结构。不要要求模型在一次生成调用中修改超过一个场景。
💡提示: 将大纲和节拍表保存在与手稿分开的文件中。它们是骨架——手稿是血肉。分开的文件意味着可以重新生成任何部分而不覆盖另一部分,并且可以只粘贴当前场景设置的相关节拍表条目而不包含完整大纲。
剧本写作工作流
使用本地LLM进行剧本写作使用与小说写作相同的会话文档和节拍表技术,加上两个补充:系统提示中的格式指令,以及将场景标题(slug line)生成作为独立于页面生成的步骤。
剧本系统提示词
“You are a screenplay formatting assistant. All prose you generate is formatted in standard US screenplay format: - Scene headers: INT./EXT. LOCATION — DAY/NIGHT - Action lines: present tense, concrete, maximum 3 lines per block - Character names: ALL CAPS above dialogue - Dialogue: centred, no dialogue tags - Parentheticals: sparingly, only for delivery or action mid-dialogue Generate in Fountain-compatible plain text.”
场景节拍到剧本页面提示词
“Beat: [paste the one-sentence scene beat from the beat sheet] POV character: [Name] Page target: [1–3 pages] Generate the script pages for this beat. Use standard screenplay format. Begin with the slug line. No narration — action lines and dialogue only.”
- 格式放在系统提示中,而非用户轮次。 将剧本格式指令放入系统消息意味着会话中的每次生成都遵循格式,无需重复指令。
- Fountain兼容输出: Fountain是剧本纯文本标记格式;Highland和Fade In可读取它,Fountain应用目录中的其他应用也可以。要求生成"Fountain兼容纯文本"会产生可在这些工具中打开或转换给其他工具使用的输出(见常见问题中关于Final Draft的问题)。
- 先生成slug line: 在生成场景内容之前,先将slug line(INT./EXT. 地点——白天/夜晚)作为单独的单行提示词生成。这在模型开始生成动作描述之前确定了物理地点。
- 对话轮次: 生成动作描述后,运行单独的对话轮次:「动作描述已定。为这个场景写[角色A]和[角色B]的对话。角色A想要[X]。角色B想要[Y]。不要对话标签。5-8次交换。」
- 页数管理: 每页字数没有固定数值,"一页等于一分钟"也只是经验法则。统计自己剧本每页的平均字数,并据此设定字数上限。
💡提示: 节拍表优先的纪律在剧本写作中比小说写作更重要。剧本场景有特定的结构功能(设置、对抗、决定、逆转)和特定的页数目标。没有节拍表就生成页面会产生在长度和结构目的上漂移的场景。在生成页面之前,始终要知道一个场景应该完成什么。
长篇写作的场景生成模板
长篇场景生成需要会话文档作为前缀,单个场景提示词作为动作。 下面的模板假设会话文档已经在系统消息或第一个用户轮次中。
📍 简单一句话
长篇小说可靠的生成模式之一:系统提示中放会话文档→用户轮次中放单个场景提示词→审查→更新会话文档→重复,每次会话一个场景。
💬 简单来说
模型需要知道三件事才能一致地写下一个场景:这些角色是谁(角色卡)、已经发生了什么(章节摘要)、这个场景需要做什么(场景设置)。只给它这三件事,不多不少。生成场景,粘贴到手稿中,更新会话文档以反映发生了什么变化。重复。
小说场景生成提示词
“[SESSION DOCUMENT ALREADY IN SYSTEM PROMPT] Current scene: Chapter: [N] Beat: [one sentence from the beat sheet] POV: [character name] Opening: [one sentence — where we are, who is present] Emotional landing: [what the POV character feels at the end — show, don't state] Word ceiling: [300–500 words] Write this scene. No summarising. Every sentence renders a moment.”
连续性检查提示词
“Before writing the next scene, check for continuity. The session document says: - [Character A] is [trait/state] - The last scene ended with [brief description] The next scene opens with [brief description]. Does this transition make sense? If not, what needs to change in the transition? One paragraph answer only.”
💡提示: 在章节转换时使用连续性检查提示词——而非每个场景都用。章节转换(地点、时间或视角角色发生变化的地方)是连续性断裂最常发生、检查效果最好的地方。
作者工具集成
Ollama在本地主机上暴露一个OpenAI兼容API,越来越多的面向作者的工具生态系统与之连接。 以下集成代表截至目前最成熟的选项。
Obsidian
- 链接:
- obsidian.md
- 集成方式:
- Copilot插件或Smart Connections插件→Ollama API。详见Obsidian+本地LLM插件深度指南。
- 适用场景:
- 已在用Obsidian做笔记+手稿的作者;在同一应用中无缝生成
Scrivener
- 集成方式:
- 通过Ollama API的外部脚本→粘贴到文档
- 适用场景:
- 在Scrivener中结构化小说的作者;AI草稿粘贴到现有项目结构
VS Code
- 集成方式:
- Continue.dev扩展→Ollama后端
- 适用场景:
- 熟悉代码编辑器的技术写作者和游戏叙事设计师
SillyTavern
- 集成方式:
- OpenAI兼容API→Ollama
- 适用场景:
- 角色扮演式小说和角色卡驱动的写作;持久化角色记忆
关于SillyTavern的文章(10篇)
- SillyTavern in 2026: The Free Frontend for AI Character Roleplay and Long-Form Chat更新于 2026年9月5日
- RisuAI Review: Open-Source Roleplay Chat Client更新于 2026年11月2日
- Agnai Review: Self-Hostable AI Roleplay Chat更新于 2026年10月30日
- Castmates Review: Offline AI Character Chat for iPhone更新于 2026年10月26日
- Best Uncensored Local LLMs for Erotica & Creative Writing 2026: Hermes 3 vs Dolphin更新于 2026年10月18日
- text-generation-webui in 2026: How Oobabooga's Local LLM UI Became "TextGen"更新于 2026年9月5日
- LibreChat Review: Self-Hosted ChatGPT Alternative for Local LLMs更新于 2026年9月3日
- Backyard AI Review: Local AI Character Chat and Roleplay更新于 2026年9月2日
- Open WebUI vs SillyTavern: Best Chat UI for Local LLMs更新于 2026年8月30日
- SillyTavern vs Agnai vs RisuAI: Best Local Roleplay Frontend (2026)更新于 2026年8月29日
另有7篇未显示
纯终端
- 链接:
- —
- 集成方式:
- `ollama run [model]`或curl到Ollama API
- 适用场景:
- 可脚本化工作流;希望以最小UI开销获得最大控制权的作者
LM Studio
- 链接:
- lmstudio.ai
- 集成方式:
- 内置聊天界面+本地服务器API
- 适用场景:
- 希望有GUI模型管理器而无需单独安装Ollama的作者
关于LM Studio的文章(10篇)
- LM Studio Review: The GUI-First Local AI Desktop App更新于 2026年10月23日
- Apple Silicon for Local LLMs 2026: M1 to M6 Complete Guide更新于 2026年11月6日
- LLM Quantization Explained: Q4_K_M vs Q4_0 vs Q8_0 (2026)更新于 2026年11月6日
- LobeChat vs Big-AGI vs NextChat vs Page Assist vs Chatbox: 2026 Comparison更新于 2026年11月6日
- NextChat Review 2026: Lightweight, One-Click-Deploy Chat UI更新于 2026年11月6日
- Qwen Local Deployment Guide 2026: Qwen 3.6 27B, Coder & VL Hardware Tiers更新于 2026年11月6日
- Best Local LLM Apps for Mac in 2026: LM Studio, Ollama, Jan and 5 More更新于 2026年11月6日
- Ollama MCP Setup 2026: Connect Local Models to Files, Databases and APIs更新于 2026年11月6日
- Local LLM Prompts for Fiction Writers: 15 Templates & Techniques (2026)更新于 2026年11月6日
- Page Assist Review 2026: Browser Sidebar for Local AI Models更新于 2026年11月3日
另有162篇未显示
NovelCrafter
- 集成方式:
- 内置AI集成;其帮助页面列出了LM Studio、Ollama和OpenAI API兼容连接
- 适用场景:
- 希望在单个小说专用应用中获得章节级AI辅助的作者
Plottr
- 链接:
- plottr.com
- 集成方式:
- 手动工作流:在Plottr中构建故事结构,外部将场景/节拍粘贴到Ollama(Plottr表示不会加入AI功能)
- 适用场景:
- 以结构性情节设计为工作流核心的情节密集型类型小说(悬疑、惊悚、奇幻)
💡提示: 对大多数作者最有效的最简单集成:Obsidian+指向Ollama的Copilot插件。会话文档在Obsidian笔记中,手稿章节在同一个Vault中,无需切换上下文即可在同一应用中直接生成。详见Obsidian+本地LLM插件深度指南。
长篇写作模型推荐
长篇写作与短篇小说的模型要求不同。 上下文遵循性、跨长会话的指令跟随一致性,以及跨多次生成调用维持声音的能力,是决策相关因素。下面各行是取自各模型卡的起点;PromptQuorum未针对小说写作评测这些模型,公开的创意写作排行榜对模型的排名也互不一致,因此请用自己的一个场景测试两个候选模型。Command A+(总参数2,180亿,激活250亿,Apache 2.0)和Mistral Large 3(总参数6,750亿,256K上下文,Apache 2.0)等服务器级开源模型超出了消费级硬件的范围。关于所有使用场景的更广泛模型概览,参见本地LLM最佳选择2026。
小说写作(主要)
- 推荐模型:
- Qwen3.6 27B或Gemma 4 31B
- 原因:
- 标称256K+上下文、采用Apache许可证的27B–31B稠密模型;4位下适合24 GB GPU或32 GB以上统一内存的规模级别(估算)
剧本写作
- 推荐模型:
- Qwen3.6 27B或Llama 3.3 70B
- 原因:
- 格式遵循主要取决于系统提示词;用两个模型各测试一个Fountain场景。Llama 3.3 70B为稠密模型,标称128K上下文,4位下约需40 GB(估算)
节拍表/大纲生成
- 推荐模型:
- Qwen3.6 35B-A3B
- 原因:
- 混合专家模型,每个token激活350亿参数中的30亿(Apache-2.0),因此每token生成更快;大纲质量未经PromptQuorum评测
对话轮次
- 推荐模型:
- 样例最贴合的模型
- 原因:
- 将对话作为单独一轮,交给校准台词最贴合角色说话风格的模型;目前没有经过验证的对话类模型排名
修改(结构性)
- 推荐模型:
- 初稿所用的模型
- 原因:
- 每次调用只指明一个结构性约束的修改提示词,适用于任何能遵循指令的模型;每次调用一个场景
成熟/黑暗小说
- 推荐模型:
- Hermes 4 70B
- 原因:
- 基于Llama-3.1-70B;Nous Research称其对齐总体中立、拒答率较低;Llama 3许可证;混合推理模式
常见错误
- 将完整手稿粘贴到上下文中。 即使模型标称128K–262K的窗口,长输入的利用可靠性也较低,因此应按约32K token规划。改用会话文档技术——压缩的角色卡和章节摘要。
- 要求模型"继续"开放式文档。 "继续这部小说"会产生漂移。"写下一个场景:[具体设置、视角、字数上限]"会产生可评估和粘贴的一致有界输出。
- 剧本写作没有节拍表。 没有场景节拍就生成剧本页面会产生在长度和结构功能上漂移的页面。始终先生成节拍表。
- 忽略会话文档更新。 如果不在生成场景后更新章节摘要,会话文档会变得过时。过时的会话文档会在几次会话内产生不一致。
- 每次会话生成多个场景。 在一个上下文窗口中生成多个场景,第一个场景效果好,之后每个场景的一致性会降低。每次会话一个场景;重置并重新注入。
参考来源
- Qwen3.6-27B模型卡和Qwen3.6-35B-A3B模型卡 — 参数、原生262,144 token上下文、YaRN扩展、Apache-2.0,2026年10月26日查阅
- Gemma 4 31B模型卡 — 稠密31B、256K上下文、Apache 2.0,2026年10月26日查阅
- Llama 3.3 70B Instruct模型卡 — 70B、128K上下文、Llama 3.3 Community License,2024年12月6日发布
- Hermes 4 70B模型卡 — 基于Llama-3.1-70B、混合推理、"broadly neutral alignment"
- Kimi-K2.6模型卡 — 总参数1万亿、激活320亿、256K上下文、原生int4
- Command A+文档和Mistral Large 3模型卡 — 服务器级模型的参数量和许可证
- Lost in the Middle: How Language Models Use Long Contexts — Liu等,2023
- Fountain.io — Fountain剧本格式规范及应用列表
- Final Draft帮助中心 — 说明Final Draft无法直接导入.fountain文件
- Amazon KDP的AI内容规则(Publishers Weekly)和Clarkesworld投稿须知 — 出版社和平台的AI政策;投稿前请核对最新措辞
- Scrivener发布说明 — 3.4.0至3.5.2(2025年12月):没有插件或API条目;"Scrivener itself contains no AI";2026年10月26日查阅
- Plottr in 2026和NovelCrafter AI连接帮助 — Plottr表示不开发AI功能;NovelCrafter列出了LM Studio、Ollama和OpenAI API兼容连接
- Ollama API文档 — Ollama
常见问题
如何让本地LLM生成小说的下一章内容?
不要直接要求模型"继续写下一章"——输入变长后,模型对早期内容的利用可靠性会下降,生成内容可能逐渐偏离已建立的情节和人物声音(保守的规划上限约为每次生成32K token)。正确做法是使用会话文档技术:在提示中提供压缩的角色卡(姓名、主导特质、说话方式)、已完成章节的情节摘要(每章100-200字),以及新章节的具体设定(场景、视角、目标字数),然后要求模型只生成这一章/一个场景,而不是延续整份不断增长的文档。每次生成一章后,将该章的摘要追加到会话文档中,供下一次生成使用。
本地LLM可以写一整部小说吗?
本地LLM可以生成整部小说的文字,但结构性和编辑层面的判断必须来自作者。模型在获得具体设定时生成场景;它不会自行规划、评估或做出主题层面的决定。可以把它看作针对你本来就知道怎么写的场景的快速初稿生成器:它节省面对空白页的时间,而每一个重要决定仍由作者做出。投稿前请核对出版社和平台的AI政策(见下方关于出版商的问题)。
我可以可靠地使用的最大上下文窗口是多少?
模型标称128K至262,144 token,但PromptQuorum建议每次生成按约32K token(约24,000字)规划,因为长上下文研究表明模型对长输入中间部分的利用可靠性较低。这是保守的规划规则,而非对每个模型实测的上限,因此请测试你自己的模型。会话文档技术把工作上下文控制在4,000–6,000 token以内,因此每次生成调用都远低于这一范围。
如何防止模型在小说中途改变角色的声音?
声音漂移有两个原因:过时的会话文档(缺少最近的角色发展)和上下文稀释(角色卡离上下文中活跃生成太远)。修复:将角色卡放在系统消息中,在角色有重要弧线时刻的场景后更新卡片,并保持卡片简洁以适应每个会话上下文的顶部部分。
我可以在本地LLM中使用Scrivener吗?
不能原生使用——Scrivener 3没有公开文档的插件系统,截至3.5.2(2025年12月)的官方发布说明也未提及AI集成:3.4.0的说明写明"Scrivener itself contains no AI",并新增了对Apple Writing Tools(macOS系统功能)的支持。常见的工作流是:在Ollama中生成(通过终端或配套脚本),复制输出,粘贴到相应的Scrivener文档。有些作者把Obsidian用作AI写作层,再将完成的章节导入Scrivener做最终结构整理。调用Ollama API并把输出复制到剪贴板的脚本最接近原生集成。
剧本写作用Ollama还是云端AI更好?
对于需要生成成熟内容(暴力、阴暗心理、道德复杂的角色)的编剧,本地模型让你可以控制模型及其拒答行为——一些托管模型会拒绝或淡化戏剧剧本中常出现的内容,而且托管服务的政策会随时间变化。Hermes 4 70B这类低拒答本地模型内置的拒答较少,但你仍需对自己生成和发布的内容负责。格式一致性主要取决于系统提示词中的指令,两者都适用。选择主要取决于内容控制、隐私和成本;PromptQuorum没有针对剧本写作比较托管模型与本地模型的输出质量。
如何生成听起来像特定角色的对话?
三步方法:(1) 将角色的说话风格添加到会话文档("正式,避免缩略,以'依我看来…'等限定语开始句子")。(2) 在会话开始时作为校准步骤,在中性上下文中生成该角色的3-5行示例对话。(3) 在对话提示词中使用这些示例行作为例子:「用与这些示例相同的风格写对话:[粘贴]。」
小说写作需要GPU才能使用本地LLM吗?
GPU能显著加快生成速度,但不是必需的。在Apple Silicon上,统一内存让16 GB的MacBook Pro可以运行较小的模型(4位下大约8B级,属估算,因为macOS约占用8 GB)——比24 GB GPU的机器慢,但在你于两次生成之间阅读和评估输出时是可以接受的。24 GB的NVIDIA GPU(RTX 4090、RTX 3090)在4位下可容纳27B–32B级模型(估算);70B级模型在4位下约需40 GB或更多,因此需要两块GPU、48 GB显卡、64 GB统一内存,或速度较慢的CPU卸载。
我可以将本地LLM与Final Draft或其他专业剧本软件一起使用吗?
不能直接使用。据Final Draft帮助中心,Final Draft无法导入.fountain文件;其建议是将文本保存为纯.txt,并将该文件作为剧本导入,或通过能导出FDX的应用以FDX格式导入。Highland可在Fountain、FDX和PDF之间转换,Fade In可导入并导出Fountain(据Fountain应用目录)。工作流:在Ollama中生成Fountain格式文本,在Highland或Fade In中打开,再导出FDX供Final Draft使用。
我可以在本地使用Kimi-K2.6进行小说写作吗?
Kimi-K2.6标称256K token的上下文窗口,与Qwen3.6 27B和Gemma 4 31B属于同一级别,但它是总参数约1万亿(激活320亿)的混合专家模型,采用原生int4权重。仅权重就约500 GB(PromptQuorum估算),需要多GPU服务器或超大统一内存的机器,在消费级硬件上不现实。对于完全本地的工作流,27B–70B的稠密模型配合会话文档技术即可处理小说篇幅的工作,而无需万亿参数模型。
出版商如何看待AI辅助手稿?
各出版社和平台的政策不同,并在2026年仍在变化,因此投稿前请核对具体的政策。Amazon KDP要求在文字、图片或翻译由AI生成时告知,并且即使经过大幅编辑,由AI工具创作的内容仍视为AI生成;你自己撰写、AI只是帮助编辑或润色的文字属于"AI辅助",无需披露(据Publishers Weekly在2023年9月报道的Amazon规则)。一些杂志直接拒收有AI参与的作品——Clarkesworld在关于使用ChatGPT等“AI”写作工具的声明中称,不会考虑任何由这些工具翻译、撰写、开发或辅助的投稿。由本地LLM生成的场景文字属于KDP"AI生成"定义这类标准的范围,因此在需要时请予以披露。这是一般性信息,不构成法律建议。
百万token级上下文需要什么硬件?
Qwen3.6 27B和Qwen3.6 35B-A3B标称原生262,144 token的上下文,据其模型卡,可通过YaRN缩放扩展到约1,010,000 token。长上下文除权重外还需要KV缓存的内存,因此运行百万token所需内存远超典型的消费级配置;PromptQuorum没有测量具体需求。本文的会话文档技术正是为这一缺口设计的——无需依赖百万token窗口,也能获得一致的长篇输出。
在中国使用本地LLM创作小说或剧本时,个人信息保护法有什么影响?
对于完全本地的模型(自己硬件上的Ollama,无云端API),个人数据不会传输到外部服务器——《个人信息保护法》关于个人信息处理的相关要求通常不适用。如果提示词中包含真实人物的个人信息(姓名、传记细节),《个人信息保护法》的原则(最小化原则、目的限制)可能适用。对于与真实人物无关的虚构内容,完全本地的LLM工作流通常不引发个人信息保护问题。
在中国使用本地AI模型创作性内容或暴力内容时有哪些法律限制?
对于涉及成年角色且双方同意场景的合法成人小说,目前没有专门针对AI的限制。《刑法》第363条规定了制作、贩卖淫秽物品罪,《网络安全法》规定了网络内容监管要求——这些规定无论文本由人还是AI生成均适用。《互联网信息服务算法推荐管理规定》等AI相关法规主要针对算法推荐系统,而非个人创作用途。对于涉及未成年人的内容有严格禁止规定。法律责任由用户承担。