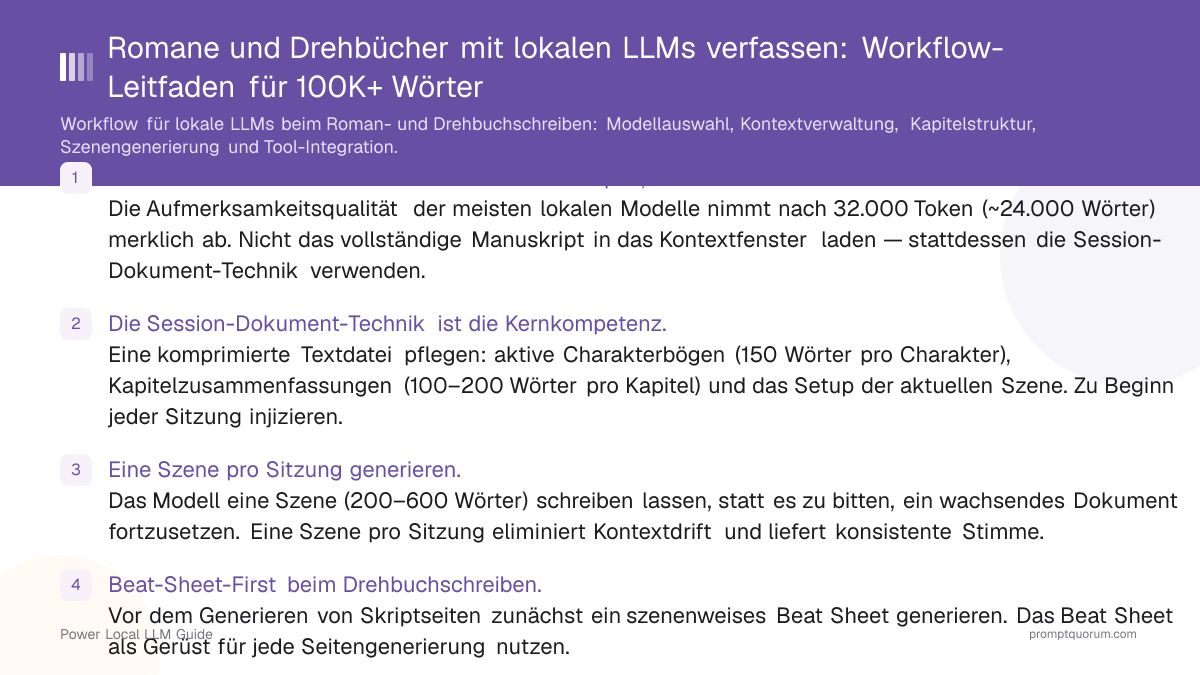
Schnellfakten
- Modell-Ausgangspunkte (laut Modellkarten): Qwen3.6 27B (dicht, Apache-2.0, 262.144 Token Kontext), Gemma 4 31B (dicht, Apache-2.0, 256K Kontext), Llama 3.3 70B (dicht, 128K Kontext, Llama 3.3 Community License).
- Planungsgrenze für das Kontextfenster: ~32.000 Token (~24.000 Wörter) pro Generierung; Modelle geben 128K–262.144 Token an — das ist eine Obergrenze, keine Qualitätsgarantie.
- Größe des Session-Dokuments: Ziel unter 4.000 Token (Charakterbögen + Kapitelzusammenfassungen + aktuelles Szenen-Setup).
- Szenengenerierungsziel: 200–600 Wörter pro Generierungsaufruf; längere Szenen über mehrere sequenzielle Prompts.
- Drehbuchformat: Ollama mit Fountain-Format-Ausgabeanweisungen kombinieren für Skript-formatierten Text.
- Schreibtools, die mit Ollama funktionieren: Scrivener (Ausgabe einfügen; keine dokumentierte Plugin-API), Obsidian (über lokales Plugin oder Skripte), VS Code (über Continue.dev oder direkte API-Aufrufe), reines Terminal.
- Low-Refusal-Option: Hermes 4 70B (Basis Llama-3.1-70B) für reife Fiktion; gleicher Workflow, gleiche Session-Dokument-Technik.
Das Kontextfensterproblem beim Langformschreiben
Pro Generierung etwa 32.000 Token einplanen — auch wenn ein Modell weit mehr angibt. Das ist eine vorsichtige PromptQuorum-Planungsregel, kein gemessenes Limit: Forschung zu langen Kontexten (Liu et al., „Lost in the Middle“) fand, dass Modelle Informationen am Anfang und am Ende einer langen Eingabe zuverlässiger nutzen als solche in der Mitte und dass die Qualität mit wachsender Eingabe sinken kann. Neuere Modelle geben deutlich größere Fenster an — Qwen3.6 27B nativ 262.144 Token, Gemma 4 31B 256K —, daher das eigene Modell testen. Bei einem Roman bleibt es der unzuverlässigste Weg, den bisherigen Entwurf einzufügen und nach dem nächsten Kapitel zu fragen; zudem braucht ein langer Kontext mehr Speicher, weil der KV-Cache mitwächst.
Kimi-K2.6 von Moonshot AI gibt ein Kontextfenster von 256K Token (262.144) an, also in derselben Klasse wie die genannten Modelle, ist aber ein Mixture-of-Experts-Modell mit rund 1 Billion Gesamtparametern (32 Milliarden aktiv) und nativen int4-Gewichten. Selbst mit 4 Bit kommen allein die Gewichte auf etwa 500 GB (PromptQuorum-Schätzung: 1 Billion Parameter × 0,5 Byte) — ein Serverklassen-Modell, kein Laptop-Modell. Die Session-Dokument-Technik und die Szene-für-Szene-Generierung gelten für lokal ausführbare Modelle jeder Kontextgröße.
📍 In einem Satz
Eine vorsichtige Planungsgrenze für Kontextadhärenz bei lokalen LLMs liegt bei etwa 32.000 Token (~24.000 Wörter) pro Generierung — darüber hinaus nutzen Modelle laut Forschung zu langen Kontexten früheren Inhalt weniger zuverlässig, was sich als Stimmdrift und Plotwidersprüche über ein langes Manuskript zeigen kann.
💬 In einfachen Worten
Man kann nicht darauf vertrauen, dass ein Modell sich an Kapitel 3 erinnert, während es Kapitel 20 schreibt, nur weil das gesamte Manuskript in sein Kontextfenster passt. Stattdessen: alles, was das Modell wissen muss — Charakterbögen, Kapitelzusammenfassungen, aktuelles Szenen-Setup — in ein Session-Dokument mit unter 4.000 Token komprimieren und dieses zu Beginn jeder Schreibsitzung injizieren. Das Modell muss immer nur wissen, was für die Szene relevant ist, die es gerade generiert.
- Token-zu-Wort-Umrechnung: 1 Token ≈ 0,75 Wörter auf Englisch (Faustregel). 32K Token ≈ 24.000 Wörter. 128K Token ≈ 96.000 Wörter (etwa ein Roman); 262.144 Token ≈ 196.000 Wörter.
- Aufmerksamkeitsdegradation: Modelle können die zuverlässige Referenz auf Inhalte aus dem frühen Teil eines langen Kontextfensters verlieren — Charakternamensfehler, vergessene Handlungspunkte und Stimmdrift.
- Die Asymmetrie: In der Studie „Lost in the Middle“ nutzten Modelle den Anfang und das Ende der Eingabe am besten und Inhalte in der Mitte am wenigsten zuverlässig. Die Studie testete Modelle, die 2023 verfügbar waren; aktuelle Modelle daher selbst testen, statt dasselbe Muster anzunehmen.
- Session-Dokument als Lösung: Alles komprimieren, was das Modell benötigt. Zu Beginn injizieren. Szene generieren. Sitzung beenden. Zurücksetzen. Mit aktualisiertem Session-Dokument neu beginnen.
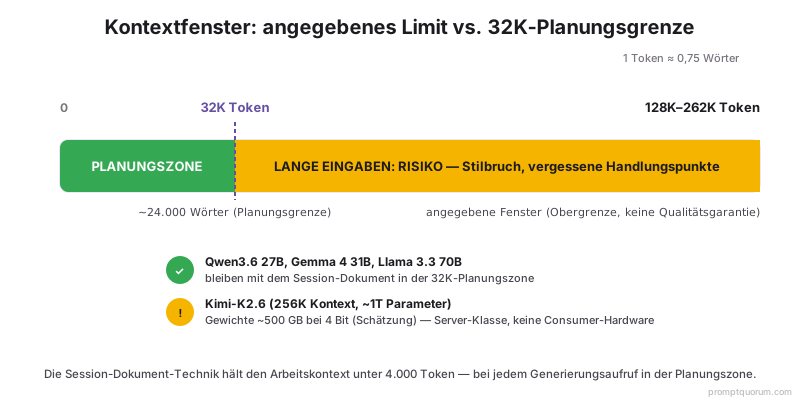
⚠️Warnung: Nicht das vollständige Manuskript in den Kontext einfügen. Über 10.000 Wörter droht Kontextdrift — das Modell kann frühe Charakterdetails vergessen, Handlungspunkten widersprechen und zu einem generischen Register zurückkehren. Stattdessen die Session-Dokument-Technik verwenden.
Session-Dokument-Technik
Die Session-Dokument-Technik ist eine PromptQuorum-Workflow-Empfehlung auf Grundlage der oben beschriebenen Kontextgrenzen. PromptQuorum hat sie nicht in einem kontrollierten Test geprüft, und die Größenangaben unten (4.000 Token, 150 Wörter pro Charakterbogen, 100–150 Wörter pro Kapitelzusammenfassung) sind Planungsrichtwerte, keine gemessenen Schwellen.
Das Session-Dokument ist eine Nur-Text-Datei neben dem Manuskript — der komprimierte Zustand des Romans, den das Modell kennen muss, um konsistenten Inhalt zu generieren. Es hat drei Abschnitte: aktive Charakterbögen, Kapitelzusammenfassungen und das aktuelle Szenen-Setup.
Session-Dokument-Vorlage
“# SESSION DOCUMENT — [NOVEL TITLE] ## ACTIVE CHARACTERS [Character Name] Dominant trait: [one trait] Contradicting behaviour: [one behaviour] Speech register: [formal/casual/specific verbal tics] Relationship to [other character]: [brief] [Character Name 2] [same structure] ## CHAPTER SUMMARIES (completed) Chapter 1: [100–150 words — what happened, what changed, where it ended] Chapter 2: [100–150 words] [continue for all completed chapters] ## CURRENT SCENE SETUP Chapter: [N] Scene: [brief description of what this scene needs to accomplish] POV: [character name] Opening state: [where we are at the start of this scene — 1 sentence] Emotional beat to land on: [what the POV character feels at the end — do not state it directly in the scene] Word ceiling: [200–500 words]”
- Charakterbögen — Ziel: 150 Wörter pro aktivem Charakter. Dominantes Merkmal, widersprüchliches Verhalten, Sprachregister und Schlüsselbeziehungen einbeziehen. Charaktere hinzufügen oder entfernen, wenn sie aktiv werden oder das Manuskript verlassen.
- Kapitelzusammenfassungen — Ziel: 100–150 Wörter pro abgeschlossenem Kapitel. Fokus auf: was passiert ist, was sich verändert hat, welche Informationen der Leser nun kennt, wo das Kapitel räumlich und emotional endete.
- Aktuelles Szenen-Setup — spezifisch und kurz. POV, Zweck der Szene, emotionalen Beat und Wörtergrenze angeben. Das ist die Aktion des Modells; Charakterbögen und Kapitelzusammenfassungen sind der Kontext.
- Größe des Session-Dokuments — Ziel: unter 4.000 Token (~3.000 Wörter). Ein Session-Dokument, das diesen Wert überschreitet, beansprucht Kontextraum für die Generierung. Aggressiv komprimieren.
- Nach jeder Sitzung aktualisieren. 1–2 Sätze zur Kapitelzusammenfassung hinzufügen und geänderte Charakterbogeneinträge aktualisieren. Das Session-Dokument ist eine lebendige Datei.
💡Tipp: Das Session-Dokument in einer Nur-Text-Datei neben dem Manuskript aufbewahren. In Ollama kann ein Modelfile mit dem Session-Dokument im SYSTEM-Block erstellt und vor jeder Sitzung aktualisiert werden. In SillyTavern das Dokument zu Beginn jeder Romansitzung in das System-Prompt-Feld einfügen.
Roman-Drafting-Workflow
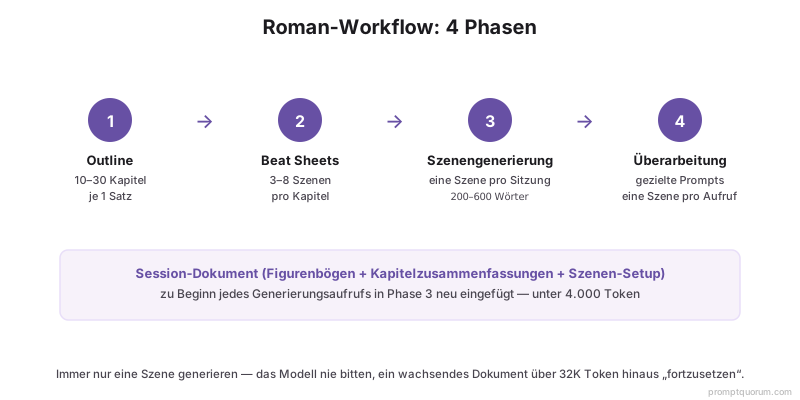
Der Roman-Drafting-Workflow mit einem lokalen LLM hat vier Phasen: Outline, Kapitel-Beat-Sheets, Szenengenerierung und Überarbeitungsdurchläufe. Jede Phase verwendet eine andere Prompt-Struktur.
- Phase 1 — Outline: Kapitelweises Outline generieren (10–30 Kapitel, ein Satz pro Kapitel: was passiert, was sich ändert). Prompt: „Genre: [Genre]. Protagonist: [Name + Kernwunde]. Zentraler Konflikt: [in einem Satz]. Schreibe ein 20-Kapitel-Outline — ein Satz pro Kapitel, jeder Satz benennt die Szene und die Änderung." Outline vor dem Fortfahren überprüfen und bearbeiten.
- Phase 2 — Beat Sheets: Jeden Kapiteleintrag in ein szenenweises Beat Sheet erweitern (3–8 Szenen pro Kapitel). Prompt: „Kapitel-[N]-Zusammenfassung: [Einzeiler einfügen]. Erweitern zu einem szenenweisen Beat Sheet: 4–6 Szenen, jede in einem Satz mit Ort, Beteiligten und der einzigen Änderung beschrieben. Noch keine Prosa."
- Phase 3 — Szenengenerierung: Session-Dokument + aktuellen Szenen-Beat verwenden, um eine Szene nach der anderen zu generieren. Generieren, überprüfen, in das Manuskript einfügen, Session-Dokument aktualisieren. Wiederholen.
- Phase 4 — Überarbeitungsdurchläufe: Nach Abschluss eines Kapitels gezielte Überarbeitungs-Prompts auf bestimmte Szenen anwenden. Siehe Lokale LLM-Prompts für Romanautoren für Überarbeitungs-Prompt-Strukturen. Nie mehr als eine Szene pro Generierungsaufruf überarbeiten.
💡Tipp: Outline und Beat Sheets in separaten Dateien vom Manuskript aufbewahren. Sie sind das Skelett — das Manuskript ist das Fleisch. Getrennte Dateien ermöglichen die Regenerierung jedes Teils, ohne den anderen zu überschreiben.
Drehbuch-Workflow
Das Drehbuchschreiben mit einem lokalen LLM verwendet dieselben Session-Dokument- und Beat-Sheet-Techniken, mit zwei Ergänzungen: Formatanweisungen im System-Prompt und Szenenheader (Slug Lines) als separater Schritt von der Seitengenerierung.
Drehbuch-System-Prompt
“You are a screenplay formatting assistant. All prose you generate is formatted in standard US screenplay format: - Scene headers: INT./EXT. LOCATION — DAY/NIGHT - Action lines: present tense, concrete, maximum 3 lines per block - Character names: ALL CAPS above dialogue - Dialogue: centred, no dialogue tags - Parentheticals: sparingly, only for delivery or action mid-dialogue Generate in Fountain-compatible plain text.”
Szenen-Beat zu Skriptseiten-Prompt
“Beat: [paste the one-sentence scene beat from the beat sheet] POV character: [Name] Page target: [1–3 pages] Generate the script pages for this beat. Use standard screenplay format. Begin with the slug line. No narration — action lines and dialogue only.”
- Format im System-Prompt, nicht im User-Turn. Formatanweisungen in der Systemnachricht bedeuten, dass jede Generierung der Sitzung dem Format folgt, ohne die Anweisung zu wiederholen.
- Fountain-kompatibler Output: Fountain ist ein Nur-Text-Markup-Format für Drehbücher; Highland und Fade In lesen es, ebenso weitere Apps im Fountain-App-Verzeichnis. Wird das Modell um „Fountain-compatible plain text“ gebeten, entsteht Output, den man in diesen Tools öffnen oder für andere konvertieren kann (siehe die Final-Draft-Frage in den FAQs).
- Slug Lines zuerst: Die Slug Line als separaten Einzeiler-Prompt generieren, bevor der Szeneninhalt generiert wird. Dies verankert den physischen Ort.
- Dialogdurchläufe: Nach Action Lines einen separaten Dialogdurchlauf: „Die Action Lines sind gesetzt. Schreibe den Dialog für [Charakter A] und [Charakter B]. Charakter A will [X]. Charakter B will [Y]. Keine Dialognachführer. 5–8 Austausche."
- Seitenanzahlverwaltung: Es gibt keine feste Wörterzahl pro Seite, und „eine Seite entspricht einer Minute“ ist nur eine Faustregel. Die durchschnittliche Wörterzahl pro Seite im eigenen Drehbuch zählen und die Wörterobergrenzen daraus ableiten.
💡Tipp: Die Beat-Sheet-First-Disziplin ist beim Drehbuchschreiben wichtiger als beim Romandrafting. Seiten ohne Beat Sheet produzieren Szenen, die in Länge und strukturellem Zweck abdriften. Immer wissen, was eine Szene leisten soll, bevor die Seiten generiert werden.
Szenengenerierungs-Templates für Langformarbeiten
Die Langform-Szenengenerierung erfordert das Session-Dokument als Präfix und einen einzelnen Szenen-Prompt als Aktion. Die Templates setzen voraus, dass das Session-Dokument bereits in der Systemnachricht oder im ersten User-Turn vorhanden ist.
📍 In einem Satz
Ein zuverlässiges Generierungsmuster für Langformfiktion: Session-Dokument im System-Prompt → einzelner Szenen-Prompt im User-Turn → überprüfen → Session-Dokument aktualisieren → wiederholen, eine Szene pro Sitzung.
💬 In einfachen Worten
Das Modell muss drei Dinge wissen: wer diese Charaktere sind (Charakterbögen), was bereits passiert ist (Kapitelzusammenfassungen) und was diese Szene leisten muss (Szenen-Setup). Genau diese drei Dinge angeben, nicht mehr. Szene generieren, in das Manuskript einfügen, Session-Dokument aktualisieren. Wiederholen.
Roman-Szenengenerierungs-Prompt
“[SESSION DOCUMENT ALREADY IN SYSTEM PROMPT] Current scene: Chapter: [N] Beat: [one sentence from the beat sheet] POV: [character name] Opening: [one sentence — where we are, who is present] Emotional landing: [what the POV character feels at the end — show, don't state] Word ceiling: [300–500 words] Write this scene. No summarising. Every sentence renders a moment.”
Kontinuitätsprüfungs-Prompt
“Before writing the next scene, check for continuity. The session document says: - [Character A] is [trait/state] - The last scene ended with [brief description] The next scene opens with [brief description]. Does this transition make sense? If not, what needs to change in the transition? One paragraph answer only.”
💡Tipp: Den Kontinuitätsprüfungs-Prompt bei Kapitelübergängen verwenden — nicht bei jeder Szene. Kapitelübergänge (wo sich Ort, Zeit oder POV-Charakter ändern) sind die Stellen, an denen Kontinuitätsbrüche am häufigsten auftreten.
Tool-Integrationen für Autoren
Ollama stellt eine OpenAI-kompatible API auf localhost bereit, mit der eine wachsende Zahl von autorenseitigen Tools verbindet. Die folgenden Integrationen stellen die etabliertesten Optionen dar.
Obsidian
- Link:
- obsidian.md
- Integration:
- Copilot-Plugin oder Smart Connections-Plugin → Ollama API. Siehe Obsidian + Lokale LLM-Plugins für den ausführlichen Leitfaden.
- Ideal für:
- Autoren, die Obsidian bereits für Notizen + Manuskript verwenden; nahtlose Generierung in derselben App
Scrivener
- Integration:
- Externes Skript über Ollama API → in Dokument einfügen
- Ideal für:
- Autoren, die Romane in Scrivener strukturieren; KI-Entwürfe in bestehende Projektstruktur einfügen
VS Code
- Integration:
- Continue.dev-Erweiterung → Ollama-Backend
- Ideal für:
- Technische Autoren und Game-Narrative-Designer im Code-Editor
SillyTavern
- Integration:
- OpenAI-kompatible API → Ollama
- Ideal für:
- Roleplay-Fiktion und charakterkarten-gesteuertes Drafting; persistentes Charaktergedächtnis
Artikel über SillyTavern (10)
- SillyTavern in 2026: The Free Frontend for AI Character Roleplay and Long-Form ChatAktualisiert 5. September 2026
- RisuAI Review: Open-Source Roleplay Chat ClientAktualisiert 2. November 2026
- Agnai Review: Self-Hostable AI Roleplay ChatAktualisiert 30. Oktober 2026
- Castmates Review: Offline AI Character Chat for iPhoneAktualisiert 26. Oktober 2026
- Best Uncensored Local LLMs for Erotica & Creative Writing 2026: Hermes 3 vs DolphinAktualisiert 18. Oktober 2026
- text-generation-webui in 2026: How Oobabooga's Local LLM UI Became "TextGen"Aktualisiert 5. September 2026
- LibreChat Review: Self-Hosted ChatGPT Alternative for Local LLMsAktualisiert 3. September 2026
- Backyard AI Review: Local AI Character Chat and RoleplayAktualisiert 2. September 2026
- Open WebUI vs SillyTavern: Best Chat UI for Local LLMsAktualisiert 30. August 2026
- SillyTavern vs Agnai vs RisuAI: Best Local Roleplay Frontend (2026)Aktualisiert 29. August 2026
+7 weitere nicht angezeigt
Reines Terminal
- Link:
- —
- Integration:
- `ollama run [model]` oder curl zur Ollama API
- Ideal für:
- Skriptierbare Workflows; maximale Kontrolle mit minimalem UI-Overhead
LM Studio
- Link:
- lmstudio.ai
- Integration:
- Integrierte Chat-Benutzeroberfläche + lokale Server-API
- Ideal für:
- Autoren, die einen GUI-Modellmanager ohne separaten Ollama-Install wünschen
Artikel über LM Studio (10)
- LM Studio Review: The GUI-First Local AI Desktop AppAktualisiert 23. Oktober 2026
- Apple Silicon for Local LLMs 2026: M1 to M6 Complete GuideAktualisiert 6. November 2026
- LLM Quantization Explained: Q4_K_M vs Q4_0 vs Q8_0 (2026)Aktualisiert 6. November 2026
- LobeChat vs Big-AGI vs NextChat vs Page Assist vs Chatbox: 2026 ComparisonAktualisiert 6. November 2026
- NextChat Review 2026: Lightweight, One-Click-Deploy Chat UIAktualisiert 6. November 2026
- Qwen Local Deployment Guide 2026: Qwen 3.6 27B, Coder & VL Hardware TiersAktualisiert 6. November 2026
- Best Local LLM Apps for Mac in 2026: LM Studio, Ollama, Jan and 5 MoreAktualisiert 6. November 2026
- Ollama MCP Setup 2026: Connect Local Models to Files, Databases and APIsAktualisiert 6. November 2026
- Local LLM Prompts for Fiction Writers: 15 Templates & Techniques (2026)Aktualisiert 6. November 2026
- vLLM Explained: High-Throughput LLM Serving with PagedAttention (2026)Aktualisiert 6. November 2026
+162 weitere nicht angezeigt
NovelCrafter
- Link:
- novelcrafter.com
- Integration:
- Integrierte KI-Anbindung; die Hilfeseiten nennen Verbindungen zu LM Studio, Ollama und OpenAI-API-kompatiblen Endpunkten
- Ideal für:
- Autoren, die kapitelbezogene KI-Unterstützung in einer einzigen roman-fokussierten App wünschen
Plottr
- Link:
- plottr.com
- Integration:
- Manueller Workflow: Romane in Plottr strukturieren, Szenen/Beats extern in Ollama einfügen (Plottr gibt an, keine KI-Funktionen zu ergänzen)
- Ideal für:
- Plot-intensive Genrefiktion (Krimi, Thriller, Fantasy) mit strukturellem Plotten als Workflow-Mittelpunkt
💡Tipp: Die einfachste Integration für die meisten Autoren: Obsidian + das Copilot-Plugin, das auf Ollama zeigt. Session-Dokument und Manuskriptkapitel im selben Vault, Generierung direkt in derselben App ohne Kontextwechsel. Siehe Obsidian + Lokale LLM-Plugins für den ausführlichen Leitfaden.
Modellempfehlungen für Langformarbeiten
Langform-Drafting hat andere Modellanforderungen als Kurzformfiktion. Kontextadhärenz, konsistente Instruktionsbefolgung über lange Sitzungen und die Fähigkeit, die Stimme über mehrere Generierungsaufrufe beizubehalten, sind die entscheidenden Faktoren. Die Zeilen unten sind Ausgangspunkte aus den jeweiligen Modellkarten; PromptQuorum hat diese Modelle nicht für Fiktion getestet, und öffentliche Ranglisten zum kreativen Schreiben bewerten Modelle unterschiedlich — daher zwei Kandidaten an einer eigenen Szene testen. Serverklassen-Modelle wie Command A+ (218 Mrd. Gesamtparameter, 25 Mrd. aktiv, Apache 2.0) und Mistral Large 3 (675 Mrd. Gesamtparameter, 256K Kontext, Apache 2.0) liegen außerhalb der Reichweite von Consumer-Hardware. Für das breitere Modellspektrum über alle Anwendungsfälle, siehe Beste lokale LLMs 2026.
Roman-Drafting (primär)
- Empfohlenes Modell:
- Qwen3.6 27B oder Gemma 4 31B
- Warum:
- Dichte 27B–31B-Modelle mit 256K+ angegebenem Kontext unter Apache-Lizenzen; eine Größenklasse, die zu einer 24-GB-GPU oder 32 GB+ Unified Memory bei 4 Bit passt (Schätzung)
Drehbuchschreiben
- Empfohlenes Modell:
- Qwen3.6 27B oder Llama 3.3 70B
- Warum:
- Formatadhärenz hängt vor allem vom System-Prompt ab; eine Fountain-Szene an zwei Modellen testen. Llama 3.3 70B ist dicht, gibt 128K Kontext an und braucht bei 4 Bit grob 40 GB (Schätzung)
Beat Sheet / Outline-Generierung
- Empfohlenes Modell:
- Qwen3.6 35B-A3B
- Warum:
- Mixture-of-Experts mit 3B von 35B aktiven Parametern pro Token (Apache-2.0), daher schnellere Generierung pro Token; Outline-Qualität von PromptQuorum nicht getestet
Dialogdurchläufe
- Empfohlenes Modell:
- Das Modell, dessen Beispiele passen
- Warum:
- Dialog als separaten Durchlauf mit dem Modell fahren, dessen Kalibrierzeilen zum Sprachregister der Figur passen; es gibt keine belastbare Rangliste von Modellen für Dialog
Überarbeitung (strukturell)
- Empfohlenes Modell:
- Das Modell, mit dem entworfen wurde
- Warum:
- Überarbeitungs-Prompts, die pro Aufruf eine strukturelle Einschränkung nennen, funktionieren mit jedem instruktionsfolgenden Modell; eine Szene pro Aufruf
Reife / dunkle Fiktion
- Empfohlenes Modell:
- Hermes 4 70B
- Warum:
- Basis Llama-3.1-70B; Nous Research beschreibt eine weitgehend neutrale Ausrichtung und geringere Ablehnungsraten; Llama-3-Lizenz; hybrider Reasoning-Modus
Häufige Fehler
- Das vollständige Manuskript in den Kontext einfügen. Auch wenn ein Modell ein 128K–262K-Fenster angibt, werden lange Eingaben weniger zuverlässig genutzt — daher etwa 32.000 Token einplanen. Stattdessen die Session-Dokument-Technik verwenden — komprimierte Charakterbögen und Kapitelzusammenfassungen.
- Das Modell bitten, ein offenes Dokument „fortzusetzen". „Setze den Roman fort" führt zu Drift. „Schreibe die nächste Szene: [spezifisches Setup, POV, Wörtergrenze]" produziert einen konsistenten, begrenzten Output.
- Keine Beat Sheets beim Drehbuchschreiben. Skriptseiten ohne einen Szenen-Beat produzieren Seiten, die in Länge und struktureller Funktion abdriften. Das Beat Sheet immer zuerst generieren.
- Session-Dokument-Aktualisierungen ignorieren. Ein veraltetes Session-Dokument produziert innerhalb weniger Sitzungen Inkonsistenzen.
- Mehr als eine Szene pro Sitzung generieren. Mehrere Szenen in einem Kontextfenster produzieren die erste gut und jede weitere mit geringerer Konsistenz. Eine Szene pro Sitzung; zurücksetzen und neu injizieren.
Quellen
- Qwen3.6-27B-Modellkarte und Qwen3.6-35B-A3B-Modellkarte — Parameter, nativer Kontext von 262.144 Token, YaRN-Erweiterung, Apache-2.0, gelesen am 26. Oktober 2026
- Gemma-4-31B-Modellkarte — dichtes 31B-Modell, 256K Kontext, Apache 2.0, gelesen am 26. Oktober 2026
- Llama-3.3-70B-Instruct-Modellkarte — 70B, 128K Kontext, Llama 3.3 Community License, veröffentlicht am 6. Dezember 2024
- Hermes-4-70B-Modellkarte — Basis Llama-3.1-70B, hybrides Reasoning, „broadly neutral alignment“
- Kimi-K2.6-Modellkarte — 1 Billion Gesamt- und 32 Milliarden aktive Parameter, 256K Kontext, natives int4
- Command-A+-Dokumentation und Mistral-Large-3-Modellkarte — Parameterzahlen und Lizenzen der Serverklassen-Modelle
- Lost in the Middle: How Language Models Use Long Contexts — Liu et al., 2023
- Fountain.io — Fountain-Drehbuchformat-Spezifikation und App-Liste
- Final-Draft-Hilfecenter — nennt, dass Final Draft .fountain-Dateien nicht direkt importieren kann
- Amazon-KDP-KI-Regeln, Publishers Weekly und Clarkesworld-Einreichungen — KI-Richtlinien von Verlagen und Plattformen; vor dem Einreichen den aktuellen Wortlaut prüfen
- Scrivener-Release-Notes — Versionen 3.4.0 bis 3.5.2 (Dezember 2025): keine Plugin- oder API-Einträge; „Scrivener itself contains no AI“; gelesen am 26. Oktober 2026
- Plottr in 2026 und NovelCrafter-Hilfe zu KI-Verbindungen — Plottr gibt an, keine KI-Funktionen zu entwickeln; NovelCrafter nennt Verbindungen zu LM Studio, Ollama und OpenAI-API-kompatiblen Endpunkten
- Ollama API-Dokumentation — Ollama
Häufig gestellte Fragen
Kann ein lokales LLM einen vollständigen Roman schreiben?
Ein lokales LLM kann die Prosa für einen vollständigen Roman generieren — die strukturelle und redaktionelle Intelligenz muss jedoch vom Autor kommen. Das Modell generiert Szenen auf Basis konkreter Vorgaben; es plant, bewertet oder trifft thematische Entscheidungen nicht selbstständig. Am besten versteht man es als schnellen Erstentwurfs-Generator für Szenen, die man ohnehin schreiben kann: Es spart Zeit gegenüber dem leeren Blatt, während der Autor jede wesentliche Entscheidung trifft. Vor dem Einreichen die KI-Richtlinien von Verlagen und Plattformen prüfen (siehe die Verlagsfrage unten).
Was ist das maximale Kontextfenster, das ich zuverlässig verwenden kann?
Modelle geben 128K bis 262.144 Token an, doch PromptQuorum empfiehlt, pro Generierung etwa 32.000 Token (~24.000 Wörter) einzuplanen, weil Forschung zu langen Kontexten zeigt, dass Modelle die Mitte langer Eingaben weniger zuverlässig nutzen. Das ist eine vorsichtige Planungsregel, kein gemessenes Limit für jedes Modell — das eigene Modell also testen. Die Session-Dokument-Technik hält den Arbeitskontext unter 4.000–6.000 Token, sodass jeder Generierungsaufruf deutlich innerhalb dieses Bereichs bleibt.
Wie verhindere ich, dass das Modell die Stimme meines Charakters ändert?
Stimmungsdrift hat zwei Ursachen: ein veraltetes Session-Dokument und Kontextverdünnung. Lösung: Charakterbogen in der Systemnachricht platzieren, nach bedeutsamen Szenen aktualisieren und kurz genug halten, um im obersten Abschnitt jedes Sitzungskontexts Platz zu finden.
Kann ich Scrivener mit einem lokalen LLM verwenden?
Nicht nativ — für Scrivener 3 ist kein Plugin-System dokumentiert, und die offiziellen Release Notes bis Version 3.5.2 (Dezember 2025) nennen keine KI-Integration: Die Notizen zu 3.4.0 sagen „Scrivener itself contains no AI“ und ergänzen die Unterstützung für Apples Writing Tools, eine macOS-Systemfunktion. Ein gängiger Workflow: in Ollama generieren (über Terminal oder ein Begleitskript), die Ausgabe kopieren und in das passende Scrivener-Dokument einfügen. Manche Autoren nutzen Obsidian als KI-Entwurfsebene und importieren fertige Kapitel zur finalen Strukturierung in Scrivener. Skripte, die die Ollama-API aufrufen und die Ausgabe in die Zwischenablage kopieren, kommen einer nativen Integration am nächsten.
Was ist besser fürs Drehbuchschreiben: Ollama oder eine Cloud-KI?
Für Drehbuchautoren, die reife Inhalte erzeugen müssen (Gewalt, dunkle Psychologie, moralisch komplexe Figuren), gibt ein lokales Modell Kontrolle über das Modell und sein Ablehnungsverhalten — manche gehostete Modelle lehnen Inhalte ab oder entschärfen sie, die in dramatischen Drehbüchern vorkommen, und gehostete Richtlinien ändern sich mit der Zeit. Ein lokales Low-Refusal-Modell wie Hermes 4 70B hat weniger eingebaute Ablehnungen; für die erzeugten und veröffentlichten Inhalte bleibt man dennoch selbst verantwortlich. Die Formatkonsistenz hängt vor allem von den Anweisungen im System-Prompt ab, die bei beiden funktionieren. Die Wahl betrifft hauptsächlich Inhaltskontrolle, Datenschutz und Kosten; PromptQuorum hat die Ausgabequalität gehosteter und lokaler Modelle für das Drehbuchschreiben nicht verglichen.
Wie generiere ich Dialog, der wie ein bestimmter Charakter klingt?
Drei Schritte: (1) Sprachregister des Charakters zum Session-Dokument hinzufügen. (2) 3–5 Beispieldialogzeilen als Kalibrierungsschritt zu Sitzungsbeginn generieren. (3) Diese Beispiele im Dialog-Prompt verwenden: „Schreibe Dialog im selben Register wie diese Beispiele: [einfügen]."
Brauche ich eine GPU für ein lokales LLM beim Roman-Drafting?
Eine GPU beschleunigt die Generierung deutlich, ist aber nicht erforderlich. Bei Apple Silicon erlaubt Unified Memory einem MacBook Pro mit 16 GB, kleinere Modelle auszuführen (grob die 8B-Klasse bei 4 Bit, eine Schätzung, da macOS etwa 8 GB belegt) — langsamer als ein 24-GB-GPU-Rechner, aber akzeptabel, wenn man die Ausgabe zwischen den Generierungen liest und bewertet. Eine NVIDIA-GPU mit 24 GB (RTX 4090, RTX 3090) fasst Modelle der 27B–32B-Klasse bei 4 Bit (Schätzung); Modelle der 70B-Klasse brauchen bei 4 Bit grob 40 GB oder mehr und erfordern daher zwei GPUs, eine 48-GB-Karte, 64 GB Unified Memory oder langsameres CPU-Offloading.
Kann ich lokale LLMs mit Final Draft oder anderer professioneller Drehbuchsoftware verwenden?
Nicht direkt. Laut Hilfecenter von Final Draft kann Final Draft keine .fountain-Dateien importieren; empfohlen wird, den Text als reine .txt-Datei zu speichern und diese Datei als Drehbuch (Script) zu importieren, oder ihn als FDX aus einer App zu übernehmen, die dieses Format exportiert. Highland konvertiert zwischen Fountain, FDX und PDF, und Fade In importiert und exportiert Fountain (laut Fountain-App-Verzeichnis). Workflow: Fountain-Text in Ollama generieren, in Highland oder Fade In öffnen und FDX für Final Draft exportieren.
Kann ich Kimi-K2.6 lokal für Roman-Drafting verwenden?
Kimi-K2.6 gibt ein Kontextfenster von 256K Token an, also dieselbe Klasse wie Qwen3.6 27B und Gemma 4 31B, ist aber ein Mixture-of-Experts-Modell mit rund 1 Billion Gesamtparametern (32 Milliarden aktiv) und nativen int4-Gewichten. Allein die Gewichte kommen auf etwa 500 GB (PromptQuorum-Schätzung); es braucht einen Multi-GPU-Server oder einen Rechner mit sehr großem Unified Memory und ist auf Consumer-Hardware unpraktisch. Für vollständig lokale Workflows deckt ein dichtes 27B–70B-Modell mit der Session-Dokument-Technik Arbeiten in Romanlänge ab, ohne ein Billionen-Parameter-Modell.
Wie stehen Verlage zu KI-gestützten Manuskripten?
Die Richtlinien unterscheiden sich je nach Verlag und Plattform und ändern sich 2026 weiter — vor dem Einreichen also die jeweilige prüfen. Amazon KDP verlangt, dass man mitteilt, wenn Text, Bilder oder Übersetzungen KI-generiert sind, und behandelt von einem KI-Tool erzeugte Inhalte auch nach umfangreicher Bearbeitung als KI-generiert; selbst verfasste Texte, bei denen KI nur beim Bearbeiten oder Verfeinern half, gelten als „KI-unterstützt“ und müssen nicht offengelegt werden (laut Amazons Regeln, wie von Publishers Weekly im September 2023 berichtet). Manche Magazine lehnen KI-beteiligte Arbeiten grundsätzlich ab — die Einreichungsrichtlinien von Clarkesworld besagen in der Erklärung zur Nutzung von „KI“-Schreibwerkzeugen wie ChatGPT, dass das Magazin keine Einsendungen berücksichtigt, die mit diesen Werkzeugen übersetzt, geschrieben, entwickelt oder unterstützt wurden. Von einem lokalen LLM generierter Szenentext fällt unter Definitionen wie die „KI-generiert“-Definition von KDP; daher dort offenlegen, wo es verlangt wird. Dies sind allgemeine Informationen und keine Rechtsberatung.
Welche Hardware brauche ich für Kontexte mit einer Million Token?
Qwen3.6 27B und Qwen3.6 35B-A3B geben einen nativen Kontext von 262.144 Token an, der sich laut Modellkarten mit YaRN-Skalierung auf rund 1.010.000 Token erweitern lässt. Ein langer Kontext braucht zusätzlich zu den Gewichten Speicher für den KV-Cache; ein Lauf mit einer Million Token braucht daher weit mehr Speicher als ein typisches Consumer-Setup; PromptQuorum hat den Bedarf nicht gemessen. Die Session-Dokument-Technik in diesem Artikel ist genau für diese Lücke gedacht — konsistente Langformausgaben, ohne auf ein Fenster von einer Million Token angewiesen zu sein.
Muss ich bei der Verwendung eines lokalen LLMs zum Schreiben von Romanen oder Drehbüchern die DSGVO beachten?
Bei vollständig lokalen Modellen (Ollama auf eigener Hardware, keine Cloud-API) werden keine personenbezogenen Daten an externe Server übertragen — DSGVO-Anforderungen für Datenübertragungen (Art. 28) entfallen. Wenn personenbezogene Daten realer Personen in Prompts einfließen, können DSGVO-Grundsätze (Datensparsamkeit, Zweckbindung) greifen. Für fiktive Inhalte ohne Bezug zu realen Personen stellen vollständig lokale LLM-Workflows in der Regel kein DSGVO-Problem dar.
Was gilt in Deutschland beim Schreiben von Texten mit sexuellem oder gewalttätigem Inhalt mithilfe lokaler KI-Modelle?
Für legale Erwachsenenfiktion mit einvernehmlichen Szenarien zwischen erwachsenen Charakteren gibt es keine spezifischen KI-Einschränkungen. §184b und §184c StGB verbieten Inhalte, die den sexuellen Missbrauch von Minderjährigen darstellen — unabhängig davon, ob Mensch oder KI den Text generiert. Für Gewaltinhalte gilt §131 StGB (Gewaltverherrlichung). Die rechtliche Verantwortung liegt beim Nutzer.