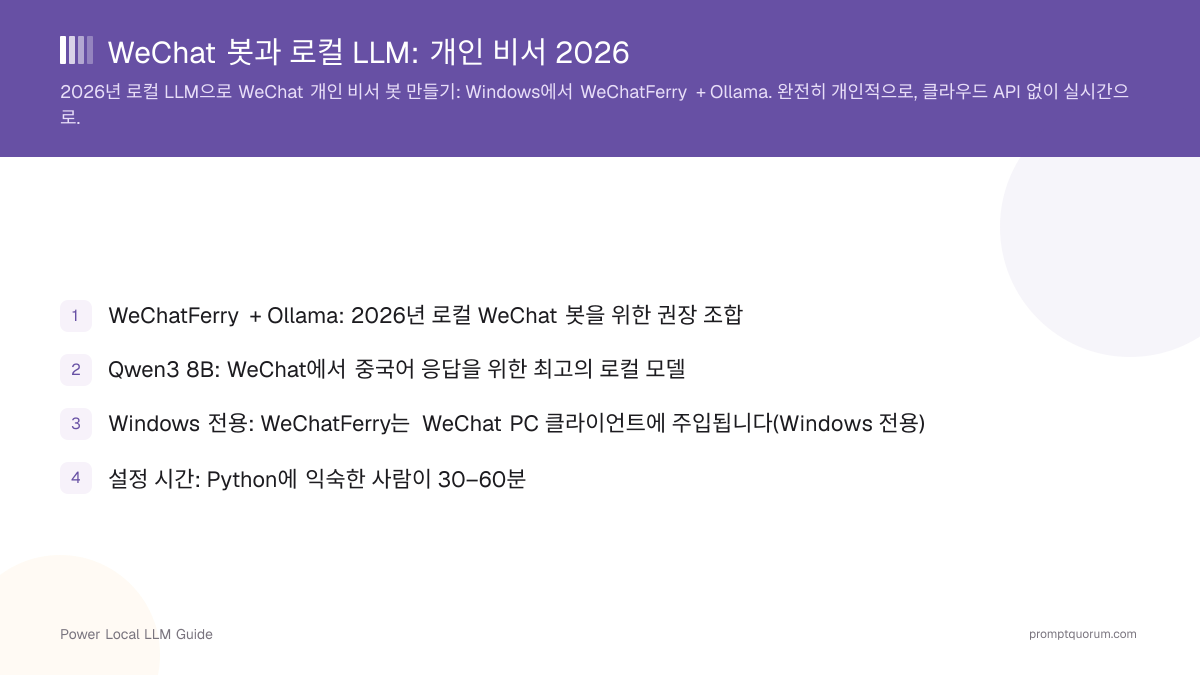
핵심 요점
- WeChatFerry + Ollama + Qwen3은 2026년 기준 실제로 동작하는 로컬 LLM 위챗 비서 스택입니다 — Windows 전용, 클라우드 API 없음
- 실제 필요에 맞게 하드웨어를 구매하세요: 저가형 N150 기기(GMKtec G3 Plus, 약 $140–200)면 가벼운 Qwen3 3B 비서에 충분합니다
- 단순한 봇을 넘어서는 상시 가동 로컬 AI 서버를 원한다면 Minisforum UM890 Pro(32GB 구성 기준 약 $649)가 더 나은 투자입니다 — 가격은 약 3~4배지만 여유 공간의 수준 자체가 다릅니다
- 중국어 품질에는 Qwen3 8B가 추천되는 시작 모델이며, Python에 익숙한 사람이라면 설정에 약 30~60분이 걸립니다
- 실재하는 위험: 위챗 이용약관은 자동화된 봇을 금지합니다 — 이는 대량 발송 도구가 아니라 개인 생산성 향상을 위한 용도입니다
- 정확하게 표현한 프라이버시 주장: 메시지 내용은 클라우드 LLM API로 전송되지 않지만, 위챗 자체는 여전히 텐센트의 인프라를 통해 동작합니다
- 다음 경우 저가형 N150 미니PC(GMKtec G3 Plus 또는 Beelink EQ14)를 구매하세요: 위챗 비서가 유일한 진지한 로컬 AI 작업이고, Qwen3 3B 모델로 충분하며, 24/7 가동 시 낮은 전력 소비가 속도보다 중요한 경우.
- 다음 경우 Ryzen급 기기(Minisforum UM890 Pro)를 구매하세요: Qwen3 8B나 14B가 반응성 있게 느껴지길 원하고, 나중에 RAG나 문서 검색 등 다른 로컬 서비스를 추가할 계획이 있거나, 재구매 대신 진짜 여유 공간을 원하는 경우.
- 다음 경우 이 프로젝트 자체를 건너뛰세요: macOS/Linux에서 네이티브로 실행해야 하는 경우(WeChatFerry는 Windows 전용), 비공식 통합에 따르는 계정 위험을 감수할 수 없는 경우, 개인 사용 범위를 넘어서는 메시지 양이 필요한 경우.

- 예산형 구성(16GB RAM, 현행 CPU)은 낮은 사용량의 소규모 비서에는 실제로 충분합니다 — 이 용도에 과잉 투자하지 마세요.
- 추천 등급(32GB, Ryzen급 CPU)은 진짜 개인 비서를 구축하려는 대부분의 사람에게 적절한 지점입니다 — Qwen3 8B가 위챗 브리지와 Ollama 자체와 함께 편안하게 동작합니다.
- 고성능 등급은 위챗 봇이 여러 인터페이스 중 하나에 불과한 범용 로컬 AI 서버가 실제 목표인 독자를 위한 것입니다 — 추가 여유가 필요한 것은 RAG, 문서 검색, 다중 서비스이지 봇 자체가 아닙니다.
등급 | RAM | 적합한 모델 | 최적 용도 |
|---|---|---|---|
| 예산형 | 16GB | Qwen3 3B | 개념 실험, 낮은 사용량의 개인 용도, 간단한 중국어 응답 |
| 추천 | 32GB | Qwen3 8B | 대부분의 진지한 개인 비서 구축 — 더 긴 대화 기록, 24/7 가동, 더 반응성 있는 응답 |
| 고성능 로컬 AI | 64GB 이상 | Qwen3 14B 이상 | 다중 동시 사용자, RAG, 문서 검색, 에이전트 워크플로, 추가 로컬 AI 서비스 |
- 선택 이유는 순수한 CPU 속도가 아니라 RAM 여유 공간입니다. 로컬 AI 서버는 운영체제, Ollama, 모델 자체, 대화 기록, 그리고 나중에 추가한다면 임베딩과 데이터베이스를 위한 메모리가 필요합니다. 96GB의 상한은 진짜 성장 여지를 줍니다 — 저가형 N150 기기는 훨씬 낮은 지점에서 한계에 도달합니다.
- SSD 슬롯 2개로 하나는 운영체제와 애플리케이션 전용, 다른 하나는 모델과 데이터 전용으로 사용할 수 있습니다 — 로컬 AI 서비스를 하나 이상 실행하게 되면 중요해지는 부분입니다.
- 듀얼 2.5GbE는 단순한 위챗 봇에는 불필요하지만, 이 기기가 나중에 네트워크상의 더 넓은 로컬 서버가 된다면 실제로 유용합니다.
- 솔직한 단점: Qwen3 3B나 가벼운 8B 사용에는 이만큼 강력한 기기가 필요하지 않습니다. "저렴한 위챗 봇을 원한다"가 전부라면 이는 과잉 사양입니다 — 아래 예산형 옵션을 참고하세요. "위챗으로 시작해 성장할 수 있는 상시 가동 로컬 AI 서버"가 목표라면, UM890 Pro가 더 정당화하기 쉬운 지출입니다.
- 가격이 가장 중요하고, Qwen3 3B 모델로 충분하며, 매우 낮은 전력 소비를 원하고, 이 기기가 Home Assistant 등 다른 가벼운 서비스도 함께 실행할 예정이라면 N150 기기를 선택하세요.
- 로컬 AI가 주된 작업이고, Qwen3 8B 이상이 반응성 있게 느껴지길 원하며, 32GB 이상의 RAM을 원하거나, 같은 기기에서 RAG나 여러 로컬 AI 서비스를 실행할 계획이라면 대신 UM890 Pro를 선택하세요.
- 전체 사양 비교는 GMKtec G3 Plus 리뷰와 Beelink EQ14 리뷰를, 다른 옵션은 로컬 AI를 위한 최고의 미니PC 정리를 참고하세요.
- 1Ollama 설치 및 Qwen3 8B 다운로드
Why it matters: ollama.com에서 Ollama를 다운로드하고 실행: `ollama pull qwen3:8b` - 2위챗 PC에 로그인
Why it matters: Windows에서 위챗을 열고 QR 코드를 스캔해 로그인합니다. 백그라운드에서 로그인 상태와 실행 상태를 유지하세요. - 3WeChatFerry 설치
Why it matters: pip으로 설치: `pip install wcferry`. WeChatFerry는 위챗 프로세스에 주입되어 메시지 API를 노출합니다 — 진행하기 전에 GitHub에서 현재 지원되는 위챗 클라이언트 버전을 확인하세요. - 4Python 메시지 핸들러 생성
Why it matters: WeChatFerry 클라이언트, Ollama HTTP API 호출, 트리거 키워드 확인을 포함한 메시지 라우팅 로직을 갖춘 `wechat_bot.py`를 작성합니다. - 5자신에게 보내는 메시지로 테스트
Why it matters: "@ai"로 시작하는 위챗 메시지를 자신에게 보내고, CPU에서 약 10~15초 이내에 봇이 응답하는지 확인합니다. - 6대화 기록 추가
Why it matters: 연락처별로 최근 10~20개 메시지를 저장하여 다중 턴 대화 맥락을 가능하게 합니다. - 7백그라운드 서비스로 실행
Why it matters: NSSM(Non-Sucking Service Manager)을 사용해 Python 스크립트를 자동 시작되는 Windows 서비스로 실행하여, 재부팅 후에도 봇이 계속 동작하게 합니다.
- 대부분의 사용자에게 Qwen3:8b가 합리적인 첫 모델입니다 — 중국어 대화, 요약, 재작성, 질의응답, 간단한 개인 생산성 자동화에 충분한 성능을 제공합니다.
- 파일이 RAM에 "들어간다"는 이유만으로 모델을 선택하지 마세요 — 들어간다고 빠른 것은 아닙니다. 대화형 비서에서는 응답 지연이 중요합니다. 기술적으로는 로드되지만 20초 이상 걸려 응답하는 모델은 채팅 앱에서 고장 난 것처럼 느껴집니다.
- CPU 전용 하드웨어(N150 기기)에서는 8B 이상 모델의 경우 위 수치보다 눈에 띄게 느린 생성 속도를 예상해야 합니다 — 이것이 바로 Minisforum UM890 Pro가 메워주는 격차입니다.
모델 | 대략적 크기 (Q4) | 중국어 품질 | 속도 (CPU) | 속도 (8GB VRAM) |
|---|---|---|---|---|
| Qwen3:3b | ~2GB | 양호 | 8–12 tok/s | 60+ tok/s |
| Qwen3:8b | ~4.7GB | 우수 — 최적의 시작점 | 3–5 tok/s | 30–45 tok/s |
| Qwen3:14b | ~9GB | 최고 | 1–2 tok/s | 15–20 tok/s |
| Llama3.1:8b | ~4.7GB | 보통 | 3–5 tok/s | 30–45 tok/s |

- 로컬 RAG: 자신의 문서에 대해 네트워크 밖으로 나가지 않고 질문할 수 있습니다.
- 개인 지식 베이스: 같은 위챗 인터페이스를 통해 노트, PDF, 저장된 정보를 검색합니다.
- 자동화: 위챗 메시지로 스크립트와 로컬 서비스를 트리거합니다.
- Home Assistant: 스마트홈에 명령을 전송합니다 — Ollama를 Home Assistant에 연결하기를 참고하세요.
- 예약 작업: 일일 요약이나 보고서를 생성합니다.
- 이는 프로젝트를 "위챗 봇"에서 위챗을 하나의 인터페이스로 삼는 프라이빗 로컬 AI 서버로 재정의합니다 — 다음 단계는 MCP를 활용한 로컬 AI 에이전트를 참고하세요.
- 정확하고 방어 가능한 주장: 로컬 LLM 추론은 비서에게 보내는 내용이 처리를 위해 제3자 클라우드 LLM 제공업체로 전달되지 않는다는 것을 의미합니다. 이는 실재하는 구체적인 프라이버시 이점입니다.
- 이 구성이 뒷받침하지 않는 주장: 위챗 커뮤니케이션 전반이 프라이빗하다거나, 텐센트가 자사 플랫폼을 통해 메시지 메타데이터나 내용을 볼 수 없다는 것 — 이는 이 프로젝트가 바꾸지 않는 별개의 문제입니다.
- Windows 전용: WeChatFerry는 Windows DLL 인젝션을 사용해 위챗 프로세스에 연결합니다. macOS나 Linux에서는 네이티브로 동작하지 않습니다. VM(Parallels, VMware Fusion)에서 Windows를 실행하는 것은 가능한 우회 방법이지만 복잡성이 추가됩니다.
- 위챗 클라이언트 버전 의존성: WeChatFerry는 특정 위챗 PC 클라이언트 버전(현재 3.9.12.17)을 추적합니다. 위챗을 업데이트하기 전에 WeChatFerry GitHub 저장소의 호환 버전 목록을 확인하세요. 그렇지 않으면 봇이 조용히 동작을 멈출 수 있습니다.
- 지연 시간: 8B 모델의 CPU 전용 추론은 응답당 약 5~15초가 걸리며, 채팅 맥락에서는 느리게 느껴질 수 있습니다. 8GB급 GPU나 Ryzen의 iGPU는 이를 상당히 줄여줍니다.
- 계정 위험은 이론이 아니라 실재합니다. 메시지량을 낮고 개인적인 수준으로 유지하고, 비공식 자동화를 사용함으로써 어느 정도의 위험을 감수하고 있다는 점을 이해하세요 — 이는 공식적으로 승인된 통합이 아닙니다.
이 위챗 봇은 Mac에서도 동작하나요?
네이티브로는 동작하지 않습니다. WeChatFerry는 Windows가 필요하며 DLL 인젝션을 통해 Windows용 위챗 PC 클라이언트에 연결합니다. macOS 사용자는 가상머신(Parallels 또는 VMware Fusion)에서 Windows를 실행하여 이 구성을 사용할 수 있지만 복잡성이 추가됩니다.
봇을 사용하면 위챗 계정이 정지될 수 있나요?
위챗 이용약관은 자동화된 봇을 금지합니다. 자동화 도구 사용이 탐지된 계정은 일시 정지나 영구 차단의 위험이 있습니다. 낮은 메시지량의 개인 생산성 향상 용도로만 사용하세요 — 계정 위험은 실재하며, 이는 공식적으로 승인된 통합이 아닙니다.
중국어 위챗 메시지에 가장 적합한 Ollama 모델은?
대부분의 사용자에게는 Qwen3 8B가 품질과 속도의 최적 균형을 제공합니다 — 중국어 이해력이 뛰어나며, 약 4.7GB(Q4)의 모델은 8GB VRAM에 들어가거나 16GB CPU RAM에서 받아들일 만한 속도로 동작합니다.
봇이 그룹 채팅을 처리할 수 있나요?
네. WeChatFerry는 방 ID와 함께 그룹 메시지를 노출합니다. msg.roomid로 봇이 응답해야 할 그룹을 필터링하고, 모든 그룹 메시지에 반응하지 않도록 명시적인 트리거 키워드(예: "@ai")를 요구하세요.
이 프로젝트에 실제로 필요한 하드웨어는 무엇인가요?
가벼운 Qwen3 3B 비서라면 16GB RAM을 갖춘 현행 Windows PC로 충분합니다 — GMKtec G3 Plus 같은 저가형 N150 미니PC(약 $140–200)가 이를 충족합니다. Qwen3 8B가 반응성 있게 느껴지고 24/7 상시 가동을 원한다면, 32GB RAM과 Ryzen급 CPU가 더 나은 투자입니다 — 이 등급에서 저희의 선택은 Minisforum UM890 Pro(32GB 구성 기준 약 $649)입니다.
Minisforum UM890 Pro는 위챗 봇에 과잉 사양인가요?
Qwen3 3B로 동작하는 단순한 위챗 봇이라면 그렇습니다 — 저가형 N150 기기로 충분하며 가격도 약 3분의 1입니다. 32~96GB RAM, 여러 모델, RAG, 봇 외 다른 서비스를 갖춘 범용 로컬 AI 서버로는 UM890 Pro가 훨씬 정당화하기 쉽습니다.
로컬 LLM 추론이 위챗을 프라이빗하게 만들어주나요?
아닙니다. 그리고 이 구분은 중요합니다. 로컬 추론은 메시지 내용이 처리를 위해 제3자 클라우드 LLM 제공업체로 전송되지 않는다는 것을 의미합니다. 이것이 위챗 자체를 프라이빗 통신 플랫폼으로 만들어주지는 않습니다 — AI 모델이 어디서 동작하든 위챗은 여전히 텐센트 자체 인프라를 통해 동작합니다.
이것은 공식 위챗 통합인가요?
아닙니다. WeChatFerry는 비공식 자동화/통합 방식이며 공식 위챗 봇 API가 아닙니다. 신중하게 사용하고, 메시지량을 낮고 개인적인 수준으로 유지하며, 모든 비공식 자동화에 따르는 계정 위험을 이해하세요.
로컬 LLM으로 위챗 봇을 만들려면 어떻게 해야 하나요?
WeChatFerry(Windows)로 위챗 PC 클라이언트에 연결하고, 로컬 HTTP API를 통해 Ollama에 연결한 뒤, 메시지를 Qwen3 모델로 전달합니다. Python 사용 시 설정에 약 30~60분이 걸립니다.