Wichtigste Erkenntnisse
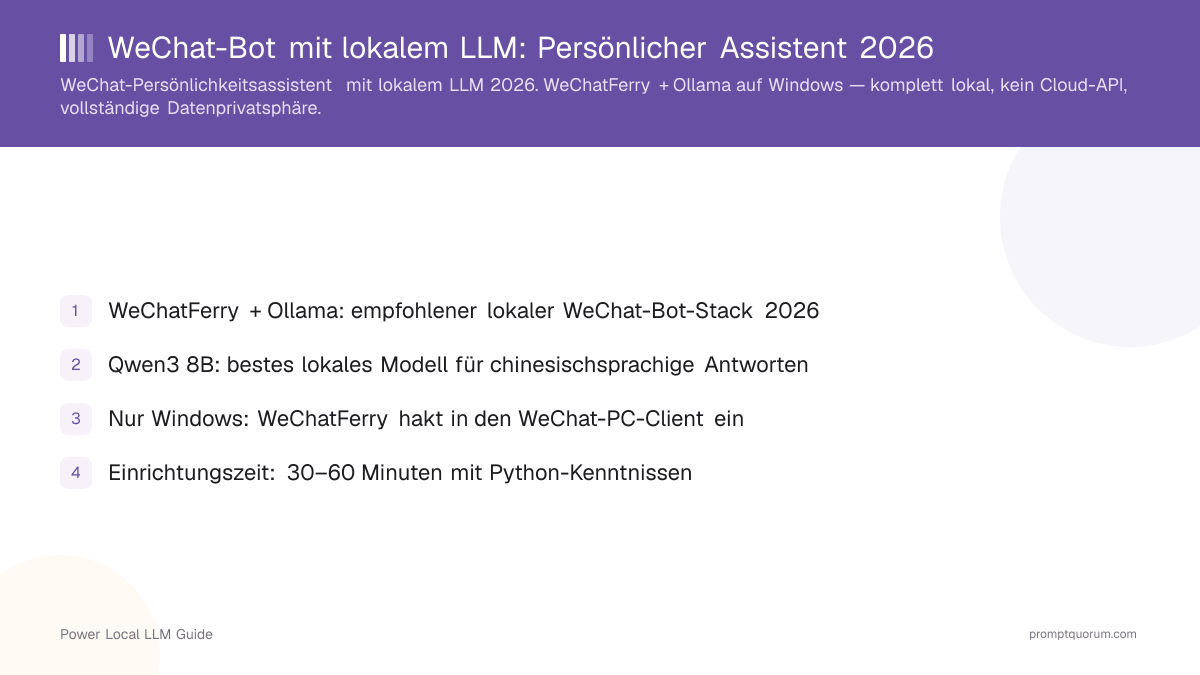
- WeChatFerry + Ollama + Qwen3 ist der funktionierende Stack 2026 für einen WeChat-Assistenten mit lokalem LLM — nur Windows, keine Cloud-API
- Kaufen Sie Hardware für die Aufgabe, die Sie wirklich haben: Ein günstiger N150-Rechner (GMKtec G3 Plus, ab 159,99 €) reicht für einen leichten Qwen3-3B-Assistenten
- Für einen dauerhaft laufenden lokalen KI-Server, der über einen einfachen Bot hinauswächst, ist der Minisforum UM890 Pro (ab ca. 489 € Barebone / ca. 649 € mit 32 GB) die bessere Wahl — etwa das 3- bis 4-Fache des Preises, aber eine andere Klasse an Spielraum
- Qwen3 8B ist das empfohlene Startmodell für chinesischsprachige Qualität; die Einrichtung dauert für jemanden mit Python-Kenntnissen etwa 30–60 Minuten
- Echtes Risiko: Die WeChat-Nutzungsbedingungen verbieten automatisierte Bots — dies ist persönliche Produktivität, kein Massenversand-Werkzeug
- Datenschutz-Anspruch, präzise formuliert: Nachrichteninhalte gehen nicht an eine Cloud-LLM-API — WeChat selbst läuft weiterhin über die Infrastruktur von Tencent
- Günstigen N150-Mini-PC (GMKtec G3 Plus oder Beelink EQ14) kaufen, wenn: der WeChat-Assistent Ihre einzige ernsthafte lokale KI-Aufgabe ist, ein Qwen3-3B-Modell für Sie ausreicht und niedriger Stromverbrauch im 24/7-Betrieb wichtiger ist als Geschwindigkeit.
- Ryzen-Box (Minisforum UM890 Pro) kaufen, wenn: Qwen3 8B oder 14B sich reaktionsschnell anfühlen soll, Sie später RAG, eine Dokumentensuche oder andere lokale Dienste hinzufügen wollen, oder Sie echten Spielraum statt eines zweiten Kaufs wollen.
- Dieses Projekt ganz überspringen, wenn: Sie es nativ unter macOS/Linux betreiben müssen (WeChatFerry ist reines Windows), Sie das Kontenrisiko einer inoffiziellen Integration nicht akzeptieren möchten, oder Sie ein Nachrichtenvolumen jenseits persönlicher Nutzung brauchen.

- Eine Budget-Konfiguration (16 GB RAM, jede moderne CPU) reicht für einen kleinen Assistenten mit geringem Volumen wirklich aus — kaufen Sie dafür nicht über.
- Die empfohlene Stufe (32 GB, Ryzen-Klasse) ist der richtige Punkt für die meisten, die einen echten persönlichen Assistenten bauen wollen — Qwen3 8B läuft dort komfortabel neben der WeChat-Brücke und Ollama selbst.
- Die umfangreiche Stufe ist für Leser gedacht, deren eigentliches Ziel ein allgemeiner lokaler KI-Server ist, bei dem der WeChat-Bot nur eine Schnittstelle unter mehreren ist — RAG, Dokumentensuche und mehrere Dienste brauchen den zusätzlichen Spielraum, nicht der Bot selbst.
Stufe | RAM | Passendes Modell | Am besten für |
|---|---|---|---|
| Budget | 16 GB | Qwen3 3B | Zum Ausprobieren des Konzepts, geringes Nachrichtenvolumen, einfache chinesischsprachige Antworten |
| Empfohlen | 32 GB | Qwen3 8B | Die meisten ernsthaften Installationen — mehr Verlauf, 24/7-Betrieb, schnellere Antworten |
| Umfangreiche lokale KI | 64 GB+ | Qwen3 14B und größer | Mehrere gleichzeitige Nutzer, RAG, Dokumentensuche, Agenten-Workflows, weitere lokale KI-Dienste |
- Der RAM-Spielraum ist der eigentliche Grund für die Wahl, nicht die reine CPU-Geschwindigkeit. Ein lokaler KI-Server braucht Speicher für das Betriebssystem, Ollama, das Modell selbst, den Gesprächsverlauf und — falls Sie es später hinzufügen — Embeddings und eine Datenbank. Eine Obergrenze von 96 GB gibt echten Raum zum Wachsen; eine günstige N150-Box endet weit darunter.
- Zwei SSD-Steckplätze erlauben, einen für Betriebssystem und Anwendungen zu nutzen und den zweiten für Modelle und Daten zu reservieren — relevant, sobald mehr als ein lokaler KI-Dienst läuft.
- Dual-2,5GbE ist für einen einfachen WeChat-Bot unnötig, aber nützlich, falls die Maschine später zu einem breiteren lokalen Server im Netzwerk wird.
- Der ehrliche Nachteil: Für Qwen3 3B oder leichte 8B-Nutzung brauchen Sie nicht so viel Maschine. Wenn „ich will einen günstigen WeChat-Bot" das ganze Ziel ist, ist dies überdimensioniert — siehe die Budget-Option unten. Wenn das Ziel „ein dauerhaft laufender lokaler KI-Server, der mit WeChat beginnt und wachsen kann" ist, ist der UM890 Pro die vertretbarere Ausgabe.
- Wählen Sie eine N150-Maschine, wenn: der Preis am wichtigsten ist, ein Qwen3-3B-Modell für Ihren Anwendungsfall wirklich ausreicht, Sie sehr niedrigen Stromverbrauch wollen und die Box daneben eventuell auch Home Assistant oder andere leichte Dienste betreiben soll.
- Wählen Sie stattdessen den UM890 Pro, wenn: lokale KI die Hauptaufgabe ist, Qwen3 8B+ sich reaktionsschnell anfühlen soll, Sie 32 GB+ RAM wollen, oder Sie RAG oder mehrere lokale KI-Dienste auf derselben Box betreiben wollen.
- Siehe den vollständigen GMKtec-G3-Plus-Test und Beelink-EQ14-Test für die kompletten Spezifikationen, oder die Übersicht der besten Mini-PCs für lokale KI für weitere Optionen.
- 1Ollama installieren und Qwen3 8B laden
Why it matters: Ollama von ollama.com herunterladen und ausführen: `ollama pull qwen3:8b` - 2Bei WeChat PC anmelden
Why it matters: WeChat unter Windows öffnen und den QR-Code zum Anmelden scannen. Im Hintergrund angemeldet und laufend halten. - 3WeChatFerry installieren
Why it matters: Installation über pip: `pip install wcferry`. WeChatFerry klinkt sich in den WeChat-Prozess ein, um eine Nachrichten-API bereitzustellen — vor dem Fortfahren im GitHub-Repository prüfen, welche WeChat-Client-Version aktuell unterstützt wird. - 4Python-Nachrichtenhandler erstellen
Why it matters: `wechat_bot.py` mit WeChatFerry-Client, Ollama-HTTP-API-Aufrufen und Nachrichtenrouting-Logik inklusive Prüfung des Auslöse-Schlüsselworts anlegen. - 5Mit einer Selbstnachricht testen
Why it matters: Eine WeChat-Nachricht beginnend mit „@ai" an sich selbst senden und prüfen, ob der Bot innerhalb von etwa 10–15 Sekunden auf der CPU antwortet. - 6Gesprächsverlauf hinzufügen
Why it matters: Die letzten 10–20 Nachrichten pro Kontakt speichern, um mehrstufigen Gesprächskontext zu ermöglichen. - 7Als Hintergrunddienst ausführen
Why it matters: NSSM (Non-Sucking Service Manager) nutzen, um das Python-Skript als Windows-Dienst mit automatischem Start auszuführen, damit der Bot Neustarts übersteht.
- Qwen3:8b ist das sinnvolle erste Modell für die meisten Nutzer — genug Leistung für chinesische Konversation, Zusammenfassungen, Umformulierung, Fragenbeantwortung und einfache Automatisierungen.
- Wählen Sie kein Modell nur, weil die Datei „passt" — passen bedeutet nicht schnell. Bei einem Konversationsassistenten zählt die Antwortlatenz; ein Modell, das technisch lädt, aber 20+ Sekunden für eine Antwort braucht, wirkt in einer Chat-App kaputt.
- Auf reiner CPU-Hardware (einer N150-Box) ist bei einem 8B+-Modell mit spürbar langsamerer Generierung zu rechnen, als die obigen Zahlen nahelegen — genau diese Lücke schließt der Minisforum UM890 Pro.
Modell | Ca. Größe (Q4) | Chinesisch-Qualität | Geschwindigkeit (CPU) | Geschwindigkeit (8 GB VRAM) |
|---|---|---|---|---|
| Qwen3:3b | ~2 GB | Gut | 8–12 Tok/s | 60+ Tok/s |
| Qwen3:8b | ~4,7 GB | Ausgezeichnet — bester Startpunkt | 3–5 Tok/s | 30–45 Tok/s |
| Qwen3:14b | ~9 GB | Beste | 1–2 Tok/s | 15–20 Tok/s |
| Llama3.1:8b | ~4,7 GB | Mäßig | 3–5 Tok/s | 30–45 Tok/s |

- Lokales RAG: Fragen zu eigenen Dokumenten stellen, ohne dass sie Ihr Netzwerk verlassen.
- Persönliche Wissensdatenbank: Notizen, PDFs und gespeicherte Informationen über dieselbe WeChat-Schnittstelle durchsuchen.
- Automatisierung: Skripte und lokale Dienste per WeChat-Nachricht auslösen.
- Home Assistant: Befehle an Ihr Smart Home senden — siehe Ollama mit Home Assistant verbinden.
- Geplante Aufgaben: tägliche Zusammenfassungen oder Berichte erstellen.
- Das verwandelt das Projekt von „ein WeChat-Bot" in einen privaten lokalen KI-Server mit WeChat als eine Schnittstelle hinein — siehe Lokale KI-Agenten mit MCP für den nächsten Schritt.
- Der präzise, vertretbare Anspruch: Lokale LLM-Inferenz bedeutet, dass die Inhalte, die Sie an Ihren Assistenten senden, nicht zur Verarbeitung an einen Cloud-LLM-Anbieter weitergeleitet werden. Das ist ein echter, konkreter Datenschutzvorteil.
- Was dieses Setup NICHT belegt: dass Ihre WeChat-Kommunikation allgemein privat ist oder dass Tencent Nachrichtenmetadaten oder -inhalte über die eigene Plattform nicht einsehen kann — das ist eine separate Frage, die dieses Projekt nicht ändert.
- Nur Windows: WeChatFerry nutzt Windows-DLL-Injection, um sich in den WeChat-Prozess einzuklinken. Es funktioniert nicht nativ unter macOS oder Linux; Windows in einer VM (Parallels, VMware Fusion) ist ein möglicher Workaround mit zusätzlicher Komplexität.
- Abhängigkeit von der WeChat-Client-Version: WeChatFerry verfolgt bestimmte WeChat-PC-Client-Versionen (aktuell 3.9.12.17). Prüfen Sie die Liste kompatibler Versionen im WeChatFerry-GitHub-Repository, bevor Sie WeChat aktualisieren — sonst kann der Bot stillschweigend aufhören zu funktionieren.
- Latenz: Reine CPU-Inferenz mit einem 8B-Modell dauert etwa 5–15 Sekunden pro Antwort, was im Chat-Kontext langsam wirken kann. Eine GPU der 8-GB-Klasse oder eine Ryzen-iGPU senkt dies spürbar.
- Das Kontenrisiko ist real, nicht theoretisch. Halten Sie das Nachrichtenvolumen niedrig und persönlich, und seien Sie sich bewusst, dass Sie mit einer inoffiziellen Automatisierung ein gewisses Risiko eingehen — dies ist keine offizielle, sanktionierte Integration.
Funktioniert der WeChat-Bot auch auf macOS?
Nicht nativ. WeChatFerry benötigt Windows und hakt sich via DLL-Injektion in den WeChat-Windows-PC-Client ein. macOS-Nutzer können Windows in einer virtuellen Maschine (Parallels oder VMware Fusion) verwenden, mit zusätzlicher Komplexität.
Riskiert mein WeChat-Konto eine Sperre durch die Nutzung eines Bots?
Die WeChat-Nutzungsbedingungen verbieten automatisierte Bots. Konten, bei denen Automatisierungstools erkannt werden, riskieren eine vorübergehende Sperre oder einen dauerhaften Bann. Nutzen Sie dies nur bei geringem Nachrichtenvolumen für persönliche Produktivität — das Kontenrisiko ist real, und dies ist keine offiziell sanktionierte Integration.
Welches Ollama-Modell eignet sich am besten für chinesische WeChat-Nachrichten?
Qwen3 8B bietet für die meisten Nutzer die beste Balance aus Qualität und Geschwindigkeit — starkes Chinesisch-Verständnis, und das etwa 4,7 GB große (Q4) Modell passt in 8 GB VRAM oder läuft mit 16 GB CPU-RAM in akzeptablem Tempo.
Kann der Bot Gruppenchats verarbeiten?
Ja. WeChatFerry liefert Gruppennachrichten inklusive Raum-ID. Filtern Sie über msg.roomid, in welchen Gruppen der Bot antworten soll, und verlangen Sie ein explizites Auslöse-Schlüsselwort (z. B. „@ai"), damit der Bot nicht auf jede Gruppennachricht reagiert.
Welche Hardware brauche ich für dieses Projekt wirklich?
Für einen leichten Qwen3-3B-Assistenten reicht jeder moderne Windows-PC mit 16 GB RAM — ein günstiger N150-Mini-PC wie der GMKtec G3 Plus (ab 159,99 €) deckt das ab. Damit sich Qwen3 8B reaktionsschnell anfühlt und für dauerhaften 24/7-Betrieb ist 32 GB RAM und eine Ryzen-Klasse-CPU die bessere Ausgabe — unsere Wahl dafür ist der Minisforum UM890 Pro (ab ca. 489 € Barebone / ca. 649 € mit 32 GB).
Ist der Minisforum UM890 Pro für einen WeChat-Bot überdimensioniert?
Für einen einfachen WeChat-Bot mit Qwen3 3B ja — eine günstige N150-Box reicht und kostet etwa ein Drittel. Für einen universellen lokalen KI-Server mit 32–96 GB RAM, mehreren Modellen, RAG und weiteren Diensten neben dem Bot ist der UM890 Pro deutlich leichter zu rechtfertigen.
Macht lokale LLM-Inferenz WeChat privat?
Nein, und diese Unterscheidung ist wichtig. Lokale Inferenz bedeutet, dass Ihre Nachrichteninhalte nicht zur Verarbeitung an einen Cloud-LLM-Anbieter gesendet werden. Sie macht WeChat selbst nicht zu einer privaten Kommunikationsplattform — WeChat läuft weiterhin über die eigene Infrastruktur von Tencent, unabhängig davon, wo das KI-Modell läuft.
Ist dies eine offizielle WeChat-Integration?
Nein. WeChatFerry ist ein inoffizieller Automatisierungs-/Integrationsansatz, keine offizielle WeChat-Bot-API. Nutzen Sie es vorsichtig, halten Sie das Nachrichtenvolumen niedrig und persönlich, und seien Sie sich des Kontenrisikos jeder inoffiziellen Automatisierung bewusst.
Muss ich bei diesem Setup die DSGVO beachten?
Die lokale Verarbeitung durch Ollama und das Qwen-Modell erleichtert die DSGVO-Konformität, weil Nachrichteninhalte zur KI-Verarbeitung nicht an einen Drittanbieter außerhalb Ihres Netzwerks übermittelt werden — das unterstützt die Datenresidenz- und Verarbeitungspflichten nach DSGVO-Artikel 28. Das ändert jedoch nichts daran, dass WeChat selbst als Messaging-Plattform über die eigene Infrastruktur von Tencent läuft; für sensible dienstliche Nutzung dokumentieren Sie den Datenfluss und sichern Sie den Rechner im Netzwerk ab.
Ist dieses Setup für den deutschen Mittelstand geeignet?
Als produktiver Geschäftsprozess eher nicht — WeChatFerry ist eine inoffizielle Integration mit echtem Kontenrisiko, was für den geschäftlichen Einsatz ein reales Problem ist. Für IT-Verantwortliche, die das Konzept lokaler LLM-Automatisierung intern evaluieren wollen (z. B. für andere Messaging-Kanäle mit offizieller API), ist der Aufbau als technischer Proof-of-Concept auf Basis der BSI-Grundschutz-Kataloge (Netzsegmentierung, Zugriffskontrolle) durchaus lehrreich — für den produktiven WeChat-Einsatz im Mittelstand raten wir davon ab.
Wie baue ich einen WeChat-Bot mit einem lokalen LLM?
WeChatFerry (Windows) zum Einhaken in den WeChat-PC-Client nutzen, über die lokale HTTP-API mit Ollama verbinden und Nachrichten an ein Qwen3-Modell weiterleiten. Einrichtungszeit: etwa 30–60 Minuten mit Python-Kenntnissen.