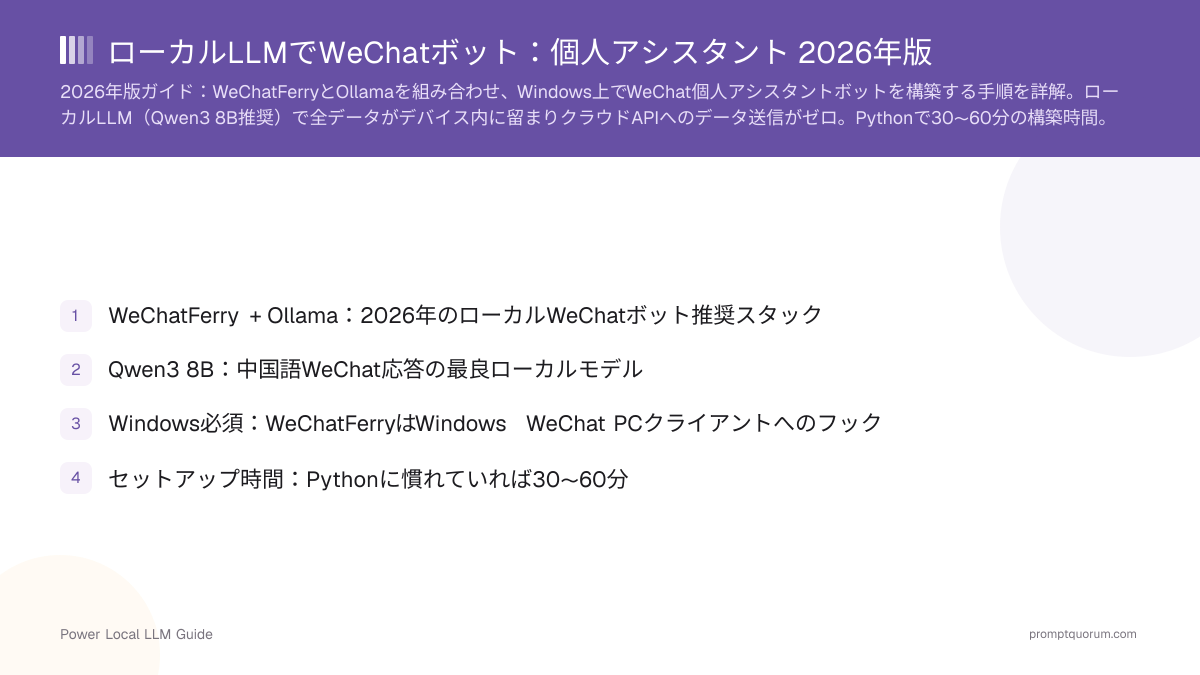
重要なポイント
- WeChatFerry+Ollama+Qwen3が2026年時点で機能するローカルLLM WeChatアシスタントの構成——Windows専用、クラウドAPIなし
- 実際の用途に合わせてハードウェアを選ぶ:軽量なQwen3 3Bアシスタントなら安価なN150ボックス(GMKtec G3 Plus、約2万〜3万円台から)で十分
- 単純なボットを超えて常時稼働のローカルAIサーバーを目指すなら、Minisforum UM890 Pro(32GB構成で約15万〜18万円)がより良い投資——価格は約3〜4倍だが、拡張性のクラスが異なる
- 中国語の品質にはQwen3 8Bが推奨される出発点。Pythonに慣れた人であればセットアップは約30〜60分
- 実在するリスク:WeChatの利用規約は自動化ボットを禁止しており、これは個人的な生産性向上のための用途であって、大量送信ツールではない
- 正確に言えばプライバシー面での利点:メッセージ内容はクラウドLLM APIに送られない——ただしWeChat自体はTencentのインフラ上で動作し続ける
- 次の場合は安価なN150ミニPC(GMKtec G3 PlusまたはBeelink EQ14)を: WeChatアシスタントが唯一の本格的なローカルAI用途で、Qwen3 3Bモデルで十分、24時間稼働時の低消費電力が速度より重要な場合。
- 次の場合はRyzen級マシン(Minisforum UM890 Pro)を: Qwen3 8Bや14Bを快適に応答させたい、後でRAGやドキュメント検索など他のローカルサービスを追加したい、あるいは買い直しではなく本当の余裕が欲しい場合。
- 次の場合はこのプロジェクト自体を見送る: macOS/Linuxでネイティブに動かす必要がある(WeChatFerryはWindows専用)、非公式インテグレーションのアカウントリスクを受け入れられない、または個人利用を超えるメッセージ量が必要な場合。

- 予算重視構成(16GB RAM、任意の現行CPU)は、低頻度・小規模なアシスタントには実際に十分です——この用途にオーバースペックな投資は不要です。
- 推奨ティア(32GB、Ryzen級CPU)は、本格的なパーソナルアシスタントを構築したいほとんどの人にとって適切な落としどころです——WeChatブリッジとOllama自体と並行してQwen3 8Bが快適に動作します。
- 本格ティアは、WeChatボットが数あるインターフェースの一つに過ぎない汎用ローカルAIサーバーが実際の目標である読者向けです——RAG、ドキュメント検索、複数サービスにはボット自体ではなく追加の余裕が必要です。
ティア | RAM | 対応モデル | 最適な用途 |
|---|---|---|---|
| 予算重視 | 16GB | Qwen3 3B | コンセプトの試用、低頻度の個人利用、シンプルな中国語応答 |
| 推奨 | 32GB | Qwen3 8B | ほとんどの本格的なアシスタント導入——長めの会話履歴、24時間稼働、より応答性の高い返信 |
| 本格的なローカルAI | 64GB以上 | Qwen3 14B以上 | 複数同時ユーザー、RAG、ドキュメント検索、エージェントワークフロー、追加のローカルAIサービス |
- 選ぶ理由は純粋なCPU速度ではなく、RAMの余裕です。 ローカルAIサーバーには、OS、Ollama、モデル本体、会話履歴、そして後で追加する場合はエンベディングやデータベース用のメモリが必要です。96GBという上限は本当の成長余地を与えてくれます——予算重視のN150ボックスははるかに低い上限で頭打ちになります。
- 2つのSSDスロットにより、一方をOSとアプリケーション用に、もう一方をモデルとデータ用に割り当てられます——複数のローカルAIサービスを動かすようになると重要になります。
- デュアル2.5GbEはシンプルなWeChatボットには不要ですが、後にこのマシンがネットワーク上のより広範なローカルサーバーになる場合には本当に役立ちます。
- 正直な欠点: Qwen3 3Bや軽量な8B利用のためだけならここまでのマシンは不要です。「安価なWeChatボットが欲しいだけ」が目的のすべてなら、これはオーバースペックです——下記の予算オプションを参照してください。「WeChatから始めて成長できる常時稼働のローカルAIサーバーが欲しい」が目的なら、UM890 Proの方が正当化しやすい投資です。
- 価格が最優先、Qwen3 3Bモデルで本当に十分、非常に低い消費電力が欲しい、そしてこのボックスがHome Assistantなど他の軽量サービスも兼ねる場合はN150マシンを選んでください。
- ローカルAIが主目的、Qwen3 8B以上を快適に動かしたい、32GB以上のRAMが欲しい、あるいは同じボックスでRAGや複数のローカルAIサービスを動かす予定があるなら、代わりにUM890 Proを選んでください。
- 完全な仕様比較はGMKtec G3 PlusレビューとBeelink EQ14レビューを、他の選択肢はローカルAI向けベストミニPC総まとめを参照してください。
- 1Ollamaをインストールし、Qwen3 8Bを取得
Why it matters: ollama.comからOllamaをダウンロードし、`ollama pull qwen3:8b`を実行します。 - 2WeChat PCにログイン
Why it matters: Windows版WeChatを開き、QRコードをスキャンしてログインします。バックグラウンドでログインし続けた状態を維持してください。 - 3WeChatFerryをインストール
Why it matters: pip経由でインストール:`pip install wcferry`。WeChatFerryはWeChatプロセスにインジェクションしてメッセージAPIを公開します——進める前にGitHubで現在対応しているWeChatクライアントのバージョンを確認してください。 - 4Pythonメッセージハンドラーを作成
Why it matters: WeChatFerryクライアント、OllamaのHTTP APIコール、トリガーキーワードのチェックを含むメッセージルーティングロジックを備えた`wechat_bot.py`を作成します。 - 5自分宛のメッセージでテスト
Why it matters: 「@ai」で始まるWeChatメッセージを自分自身に送信し、CPU上で約10〜15秒以内にボットが応答することを確認します。 - 6会話履歴を追加
Why it matters: 連絡先ごとに直近10〜20件のメッセージを保存し、複数ターンの会話コンテキストを可能にします。 - 7バックグラウンドサービスとして実行
Why it matters: NSSM(Non-Sucking Service Manager)を使ってPythonスクリプトをWindowsサービスとして自動起動させ、再起動後もボットが動作し続けるようにします。
- ほとんどのユーザーにとってQwen3:8bが合理的な最初のモデルです——中国語での会話、要約、リライト、質問応答、シンプルな個人生産性向上の自動化には十分な能力があります。
- ファイルが「メモリに収まる」という理由だけでモデルを選ばないでください——収まることは速いことを意味しません。 会話型アシスタントでは応答レイテンシが重要です。技術的には読み込めても20秒以上かかるモデルは、チャットアプリでは壊れているように感じられます。
- CPUのみのハードウェア(N150ボックス)では、8B以上のモデルは上記の数値よりも明らかに遅い生成速度になると想定してください——これはまさにMinisforum UM890 Proが埋めてくれるギャップです。
モデル | 概算サイズ(Q4) | 中国語品質 | 速度(CPU) | 速度(8GB VRAM) |
|---|---|---|---|---|
| Qwen3:3b | 約2GB | 良好 | 8〜12トークン/秒 | 60トークン/秒以上 |
| Qwen3:8b | 約4.7GB | 優秀——最良の出発点 | 3〜5トークン/秒 | 30〜45トークン/秒 |
| Qwen3:14b | 約9GB | 最良 | 1〜2トークン/秒 | 15〜20トークン/秒 |
| Llama3.1:8b | 約4.7GB | 普通 | 3〜5トークン/秒 | 30〜45トークン/秒 |

- ローカルRAG:自分自身のドキュメントについて、ネットワークの外に出すことなく質問できます。
- 個人用ナレッジベース:同じWeChatインターフェースからメモ、PDF、保存済み情報を検索します。
- 自動化:WeChatメッセージからスクリプトやローカルサービスをトリガーします。
- Home Assistant:スマートホームにコマンドを送信します——OllamaをHome Assistantに接続するを参照してください。
- スケジュールされたタスク:日次のサマリーやレポートを生成します。
- これにより、プロジェクトは「WeChatボット」から、WeChatをインターフェースの一つとする private なローカルAIサーバーへと再定義されます——次のステップはMCPを使ったローカルAIエージェントを参照してください。
- 正確で擁護可能な主張:ローカルLLM推論とは、アシスタントに送信する内容がサードパーティのクラウドLLMプロバイダーに処理のため転送されないことを意味します。これは実在する、具体的なプライバシー上の利点です。
- この構成が裏付けないもの:WeChatでのコミュニケーション全般がプライベートであること、あるいはTencentが自社プラットフォーム経由でメッセージのメタデータや内容を確認できないこと——これはこのプロジェクトが変えることのない別の問題です。
- Windows専用: WeChatFerryはWindowsのDLLインジェクションを使ってWeChatプロセスにフックします。macOSやLinuxではネイティブに動作しません。VM(Parallels、VMware Fusion)でWindowsを動かすことは可能な回避策ですが、複雑さが増します。
- WeChatクライアントのバージョン依存性: WeChatFerryは特定のWeChat PCクライアントバージョン(現在は3.9.12.17)を追跡しています。WeChatを更新する前にWeChatFerryのGitHubリポジトリで対応バージョン一覧を確認してください。さもないとボットが静かに動作しなくなる可能性があります。
- レイテンシ:8BモデルでのCPUのみの推論は1回の応答に約5〜15秒かかり、チャットとしては遅く感じられることがあります。8GBクラスのGPUやRyzenのiGPUはこれを大幅に短縮します。
- アカウントリスクは理論上のものではなく実在します。メッセージ量を低く個人的な範囲に抑え、非公式な自動化を使用することである程度のリスクを受け入れていることを理解してください——これは公式に承認されたインテグレーションではありません。
このWeChatボットはMacでも動きますか?
ネイティブには動きません。WeChatFerryはWindowsを必要とし、DLLインジェクションを介してWindows版WeChat PCクライアントにフックします。macOSユーザーは仮想マシン(ParallelsやVMware Fusion)でWindowsを動かすことでこの構成を利用できますが、複雑さが増します。
ボットを使うとWeChatアカウントが停止されますか?
WeChatの利用規約は自動化ボットを禁止しています。自動化ツールの使用が検出されたアカウントは、一時停止または永久停止のリスクがあります。低頻度の個人的な生産性向上目的にのみ使用してください——アカウントリスクは実在し、これは公式に承認されたインテグレーションではありません。
中国語のWeChatメッセージに最適なOllamaモデルは?
ほとんどのユーザーにとって、Qwen3 8Bが品質と速度の最良のバランスです——中国語の理解力が高く、約4.7GB(Q4)のモデルは8GBのVRAMに収まるか、16GBのCPU RAMで許容できる速度で動作します。
ボットはグループチャットに対応できますか?
はい。WeChatFerryはルームIDとともにグループメッセージを公開します。msg.roomidでボットが応答すべきグループをフィルタリングし、すべてのグループメッセージに反応しないよう「@ai」などの明示的なトリガーキーワードを設定してください。
このプロジェクトに実際に必要なハードウェアは?
軽量なQwen3 3Bアシスタントであれば、16GB RAMを備えた現行のWindows PCで十分です——GMKtec G3 Plusのような安価なN150ミニPCがこれをカバーします。Qwen3 8Bを快適に応答させ、24時間常時稼働させるには、32GB RAMとRyzen級CPUがより良い投資です——このティアで推奨するのはMinisforum UM890 Pro(32GB構成で約15万〜18万円)です。
Minisforum UM890 ProはWeChatボットにはオーバースペックですか?
Qwen3 3BによるシンプルなWeChatボットには、その通りオーバースペックです——安価なN150ボックスで十分で、価格もおよそ3分の1です。32〜96GBのRAM、複数のモデル、RAG、そしてボットと並行する他のサービスを備えた汎用ローカルAIサーバーとしては、UM890 Proの方がはるかに正当化しやすくなります。
ローカルLLM推論を使えばWeChatはプライベートになりますか?
いいえ、この区別は重要です。ローカル推論とは、メッセージ内容がサードパーティのクラウドLLMプロバイダーに処理のため送信されないことを意味します。それによってWeChat自体がプライベートな通信プラットフォームになるわけではありません——AIモデルがどこで動作していても、WeChatは引き続き自社のTencentインフラ上で動作します。
これは公式のWeChatインテグレーションですか?
いいえ。WeChatFerryは非公式な自動化・インテグレーション手法であり、公式のWeChatボットAPIではありません。慎重に使用し、メッセージ量を低く個人的な範囲に抑え、あらゆる非公式自動化に伴うアカウントリスクを理解した上で利用してください。
ローカルLLMでWeChatボットを構築するには?
WeChatFerry(Windows)でWeChat PCクライアントにフックし、ローカルのHTTP API経由でOllamaに接続し、メッセージをQwen3モデルに転送します。セットアップ時間はPythonの知識があれば約30〜60分です。