LLM 파인튜닝을 위한 최저가 클라우드 GPU — 시간당 $1 미만 (2026)
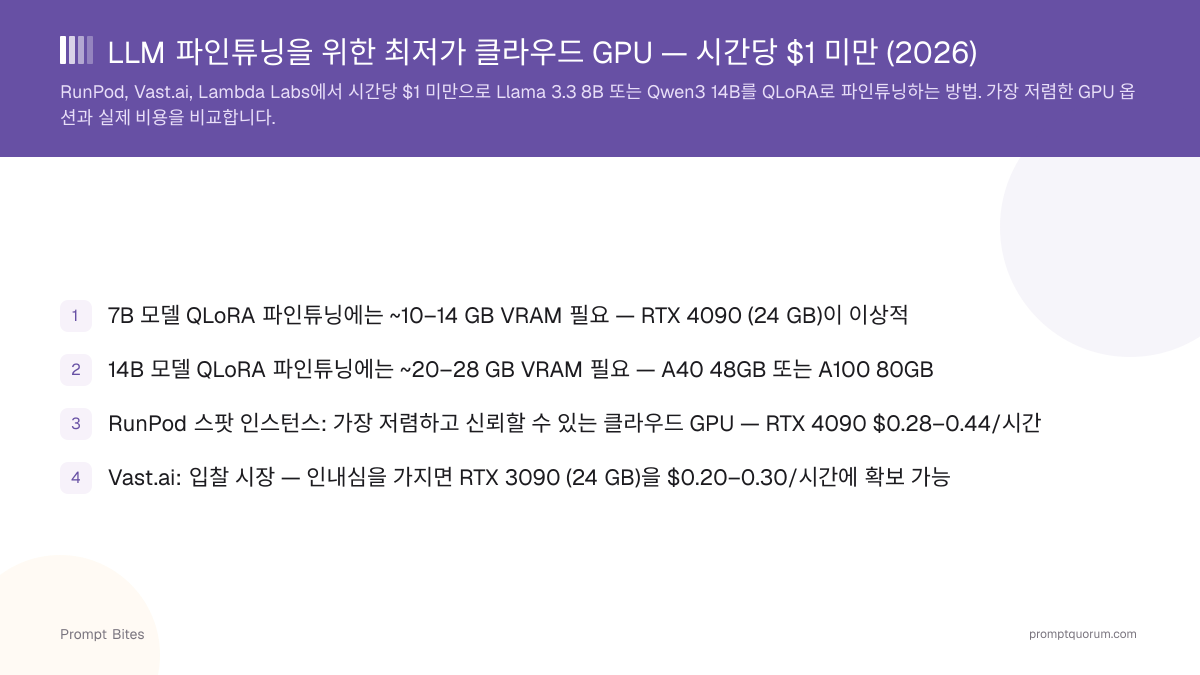
2026년 QLoRA로 Llama 3.1 8B 또는 Qwen3 14B를 파인튜닝한다면 RunPod Community Cloud의 RTX 4090 24GB($0.34/시간)나 A40 48GB($0.35/시간) 모두 시간당 $1을 크게 밑돕니다. Vast.ai의 RTX 3090(24GB)은 약 $0.13/시간부터로 7B 실행의 최저가 수준입니다. 전체 파인튜닝 실행의 총비용은 보통 $1–3입니다.
이 페이지에는 타사 제품에 대한 참조 링크가 포함되어 있습니다. PromptQuorum은 어떤 제휴 프로그램에도 등록되어 있지 않습니다 — 이는 수수료가 발생하지 않는 일반 링크입니다. 링크 클릭 및 이후 단계는 전적으로 귀하의 책임입니다. 이 링크는 PromptQuorum의 어떠한 보증이나 검증을 나타내지 않습니다.
핵심 요점
- ✓QLoRA 최소 VRAM은 7B–8B 모델 5–6GB, 14B 8.5GB(Unsloth); 24GB RTX 4090이면 현실적인 배치 크기와 컨텍스트에 여유가 있습니다
- ✓48GB A40은 더 긴 컨텍스트와 30B급 모델에 여유를 더하며, 70B QLoRA는 최소 약 41GB가 필요해 80GB A100이 적합합니다
- ✓RunPod Community Cloud: RTX 4090 $0.34/시간, A40 $0.35/시간, RTX 3090 $0.22/시간
- ✓Vast.ai 마켓플레이스: RTX 3090 약 $0.13/시간부터; 가격과 호스트 안정성은 변동됩니다
- ✓전체 실행(1K 스텝, 1K 샘플): $0.34/시간로 2–4시간 = $0.68–$1.36
- ✓Unsloth 공식 Docker 이미지로 몇 분 만에 작동하는 QLoRA 환경을 갖출 수 있습니다
시간당 $1 미만으로 LLM 파인튜닝을 위한 최고의 클라우드 GPU 플랫폼
📍 한 문장으로
RunPod Community Cloud(RTX 4090 $0.34/시간, A40 $0.35/시간)와 Vast.ai(RTX 3090 약 $0.13/시간부터)는 2026년 7B–14B 모델 QLoRA 파인튜닝에 가장 저렴한 클라우드 GPU 옵션입니다.
💬 쉽게 설명하면
파인튜닝은 QLoRA라는 방법을 사용해 사전 학습된 AI 모델을 특정 데이터에 적응시킵니다. QLoRA는 모델의 대부분을 압축 형태로 고정하고 소형 어댑터 레이어만 학습시켜 VRAM 사용량을 4–8배 줄입니다. 이를 통해 몇 달러의 임대 GPU에서도 저렴하게 파인튜닝할 수 있습니다.
RunPod — 종합 최고(Community Cloud + Secure Cloud)
RunPod는 고정되어 예측 가능한 가격과 좋은 개발자 경험을 함께 제공합니다. Community Cloud: RTX 3090 $0.22/시간, RTX 4090 $0.34/시간, A40 48GB $0.35/시간. Secure Cloud(데이터센터 호스트): RTX 4090 $0.89/시간, A40 $0.59/시간. 둘 다 영구 네트워크 볼륨과 Docker 기반 템플릿을 지원하므로 Unsloth 공식 이미지나 Axolotl 컨테이너를 사용할 수 있습니다. Community Cloud 호스트는 제3자 머신이므로 수백 스텝마다 체크포인트를 볼륨에 저장하세요.
Vast.ai — 가장 저렴한 마켓플레이스
Vast.ai는 호스트가 가격을 정하는 P2P GPU 마켓플레이스입니다. 최근 가격 추적 결과 RTX 3090(24GB)은 약 $0.13/시간부터, RTX 4090은 약 $0.30/시간부터이며 중단 가능 인스턴스는 더 저렴합니다. RunPod의 비슷한 24GB 카드보다 약 40–60% 낮지만, 호스트 안정성·대역폭·스토리지 요금은 제각각이므로 임대 전에 각 목록을 확인하세요. 체크포인트를 저장하는 짧은 실행에 적합하며, 체크포인트 전략 없이 12시간을 넘는 실행은 권장하지 않습니다.
Lambda — 안정적인 온디맨드, 하지만 $1 선 초과
Lambda는 중단 위험 없는 온디맨드 GPU를 제공하지만 현재 카드는 시간당 $1 예산에 맞지 않습니다: A10 24GB $1.29/시간, RTX A6000 48GB $1.09/시간, A100 40GB $1.99/시간. 시간당 $1 미만은 Quadro RTX 6000 24GB($0.69/시간)와 V100 16GB($0.79/시간) 같은 구형 카드뿐입니다. 가격보다 확실한 가용성이 중요할 때 Lambda를 고르세요. A10에서 4시간 실행은 약 $5.16입니다.
실제 파인튜닝 비용 추정
위 가격을 기준으로 한 Unsloth QLoRA 대표 시나리오의 컴퓨팅 비용 추정(스토리지 제외): 가격은 각 업체의 공개 가격 페이지와 제3자 가격 추적 사이트를 기준으로 하며 자주 바뀌므로, 임대 전에 업체 사이트에서 확인하세요.
| 작업 | 필요한 GPU | 소요 시간 | 플랫폼 | 총비용 |
|---|---|---|---|---|
| Llama 3.1 8B QLoRA, 1K 샘플, 1K 스텝 | RTX 4090 (24GB) | 약 2시간 | RunPod Community ($0.34/시간) | 약 $0.68 |
| Qwen3 14B QLoRA, 5K 샘플, 3K 스텝 | A40 48GB | 약 5시간 | RunPod Community ($0.35/시간) | 약 $1.75 |
| Llama 3.3 70B QLoRA 4bit, 1K 샘플 | A100 80GB | 약 8시간 | RunPod Community ($1.19/시간) | 약 $9.52 |
| Qwen2.5-Coder 7B, SQL 데이터, 10K 스텝 | RTX 3090 (24GB) | 약 4시간 | Vast.ai (약 $0.13/시간) | 약 $0.52 |
파인튜닝용 GPU를 빌리는 5단계
파인튜닝용 GPU 임대는 약 15분의 준비로 끝납니다. VRAM으로 카드를 고르고, 영구 볼륨이 있는 팟을 빌리고, 준비된 학습 이미지로 시작하고, 짧게 테스트한 뒤 전체 작업을 실행하고, 끝나면 팟을 중지합니다.
적은 예산으로 빠르게 쓰는 파인튜닝 환경
**예산이 적을 때 가장 빠른 구성은 24GB 카드에 준비된 학습 이미지를 쓰는 것입니다: Unsloth 공식 Docker 이미지, Axolotl 컨테이너, 또는 LLaMA-Factory.** 셋 모두 CUDA, PyTorch, Hugging Face PEFT를 포함해 팟이 몇 분 안에 학습 준비를 마치며, 단일 소비자용 GPU에서 QLoRA를 지원합니다.
Unsloth 카탈로그에는 Llama 3.1 8B와 Qwen3 14B의 4bit 체크포인트는 물론 Qwen3.5, Qwen3.6, Qwen3.8, Llama 4 같은 최신 릴리스도 올라와 있습니다. 같은 크기의 밀집 모델에는 위의 VRAM 기준이 그대로 적용되지만, Llama 4와 대형 MoE 모델은 훨씬 많은 메모리가 필요해 시간당 $1 예산을 벗어납니다.
관련 가이드
- ▸RunPod vs Vast.ai Pricing: Which Is Cheaper? -- GPU cloud pricing comparison
- ▸Cloud GPU Cost per Hour -- cloud GPU pricing
- ▸DeepSeek-R1 Distill VRAM Cheatsheet -- VRAM requirements
- ▸Best DeepSeek Distill for Your GPU -- DeepSeek distill guide
Quick Answers
14B 모델을 $1 미만으로 파인튜닝할 수 있나요?▾
클라우드 GPU에서 QLoRA 파인튜닝에 필요한 소프트웨어는?▾
더 큰 베이스 모델을 쓰는 것보다 파인튜닝이 가치 있나요?▾
로컬 LLM 파인튜닝에 가장 저렴한 클라우드 GPU는?▾
LLM 파인튜닝용 GPU를 저렴하게 빌리려면 어떻게 하나요?▾
적은 예산의 파인튜닝에 최적화된 GPU 환경은?▾
전체 설명이 필요하십니까?
전체 가이드 읽기 →