지금 가장 좋은 LLM은 무엇입니까?
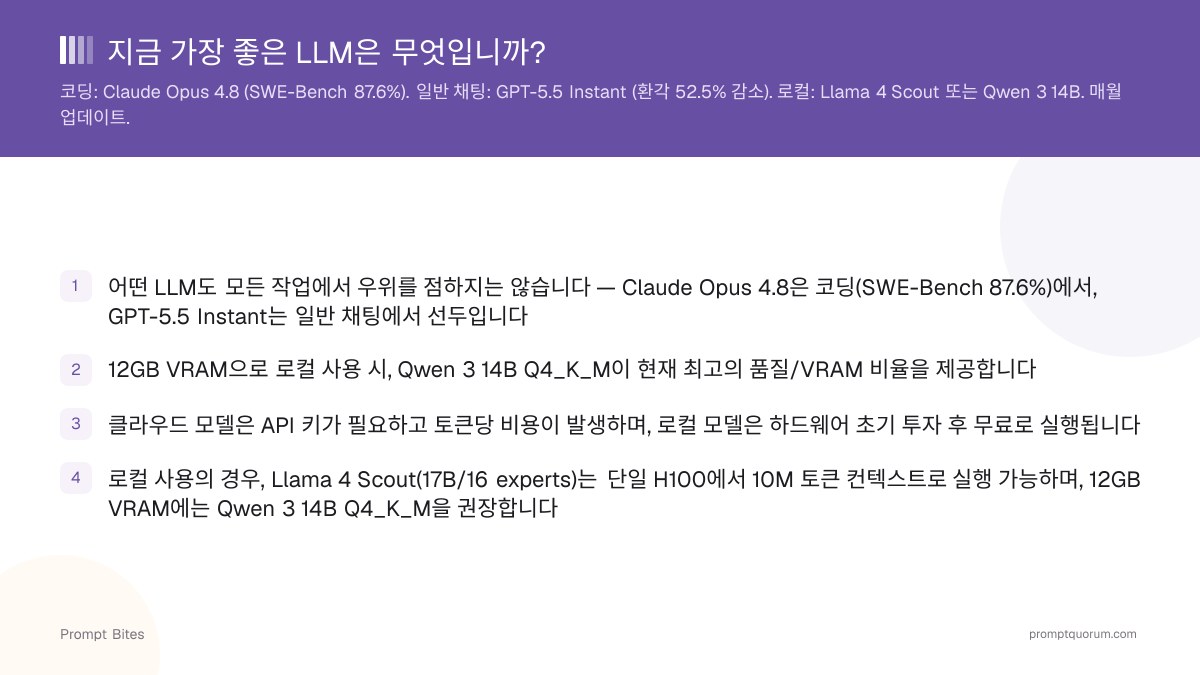
빠른 답변
2026년 7월에 세 가지 플래그십이 출시되었고 각각 다른 영역을 이끕니다. Claude Opus 5(7월 24일)는 Frontier-Bench v0.1에서 선두이며 코딩용 선택입니다. GPT-5.6 Sol(7월 9일)은 명령줄과 에이전트 작업을 평가하는 Terminal-Bench 2.1에서 최고 수준을 세웠습니다. Gemini 3.1 Pro는 네이티브 멀티모달 작업을 이끌며 ARC-AGI-2에서 검증된 77.1%를 기록했습니다. 로컬에서는 qwen3.5:9b가 6.6 GB 다운로드입니다.
- ▸클라우드 코딩: Claude Opus 5 — Frontier-Bench v0.1 선두
- ▸클라우드 에이전트/CLI: GPT-5.6 Sol — Terminal-Bench 2.1 최고 수준
- ▸멀티모달: Gemini 3.1 Pro — ARC-AGI-2 검증 77.1%
- ▸로컬: qwen3.5:9b — 다운로드 6.6 GB
핵심 요점
- ✓모든 작업에서 앞서는 단일 LLM은 없습니다 — Claude Opus 5는 Frontier-Bench v0.1, GPT-5.6 Sol은 Terminal-Bench 2.1, Gemini 3.1 Pro는 멀티모달에서 선두입니다
- ✓세 플래그십 모두 2026년 7월에 나왔으므로, 그 이전에 작성된 비교는 한 세대 뒤처진 것입니다
- ✓GPT-5.6은 단일 모델이 아니라 제품군입니다: Sol이 플래그십, Terra는 절반 가격에 GPT-5.5 수준, Luna는 Sol보다 80% 저렴합니다
- ✓로컬에서는 qwen3.5:9b(6.6 GB)가 범용을, qwen2.5-coder:7b(4.7 GB)가 코딩을 담당합니다 — 둘 다 대부분의 가이드가 전제하는 하드웨어보다 훨씬 가볍습니다
- ✓클라우드 모델은 API 키가 필요하고 토큰당 비용이 들지만, 로컬 모델은 하드웨어 구입 후 무료로 실행됩니다
최고의 LLM은 작업에 따라 다릅니다 — 지도는 이렇습니다
2026년 7월, 세 플래그십이 2주 사이에 등장했습니다. 코딩에는 Claude Opus 5(7월 24일), 에이전트와 명령줄 작업에는 GPT-5.6 Sol(7월 9일), 멀티모달 전반에는 Gemini 3.1 Pro입니다. 아래에서 각각이 언제 앞서는지, 워크플로별로 무엇을 골라야 하는지 정리합니다.
이제 업체들은 공통의 대표 벤치마크를 발표하지 않으므로, 비교한다는 것은 서로 다른 평가를 비교한다는 뜻입니다. Anthropic은 Opus 5가 Frontier-Bench v0.1에서 다른 모든 모델을 앞서고 작업당 비용은 낮추면서 Opus 4.8의 두 배를 넘어섰다고 밝힙니다. OpenAI는 GPT-5.6 Sol이 명령줄 워크플로에서 계획 수립과 도구 조율을 평가하는 Terminal-Bench 2.1에서 최고 수준을 세웠다고 밝힙니다. Google은 Gemini 3.1 Pro가 ARC-AGI-2에서 검증된 77.1%를 기록했다고 밝힙니다.
짚어둘 구조적 변화가 있습니다. GPT-5.6은 단일 출시가 아니라 세 모델로 이루어진 제품군입니다. Sol이 프런티어 모델이고, Terra는 지능 벤치마크에서 절반 가격에 GPT-5.5 수준을 내며, Luna는 Sol보다 80% 낮은 가격입니다. 비용이 결정적 제약이라면 비교해야 할 대상은 Sol이 아니라 Terra나 Luna 대 경쟁사 플래그십입니다.
| 사용 사례 | 최고의 LLM | 이유 |
|---|---|---|
| 코딩 | Claude Opus 5 | Frontier-Bench v0.1 선두; 작업당 낮은 비용으로 Opus 4.8의 2배 이상 |
| 에이전트 / 명령줄 | GPT-5.6 Sol | Terminal-Bench 2.1 최고 수준 |
| 멀티모달(영상, 이미지, 음성) | Gemini 3.1 Pro | 네이티브 멀티모달; ARC-AGI-2 검증 77.1% |
| 비용 민감 처리량 | GPT-5.6 Luna 또는 Terra | Luna는 Sol보다 80% 저렴; Terra는 절반 가격에 GPT-5.5 수준 |
| 로컬 / 오프라인 범용 | qwen3.5:9b | 다운로드 6.6 GB, Ollama에서 받을 수 있는 최신 Qwen |
| 로컬 / 오프라인 코딩 | qwen2.5-coder:7b | 다운로드 4.7 GB, 8 GB 카드에서 실행 |
리뷰 50개를 읽지 않고 고르는 법
제약에서 출발하세요. 예산, 프라이버시, 지연 시간, 성능 중 무엇입니까? 가장 강한 제약을 먼저 해소하는 모델을 고르십시오. 프라이버시가 제약이라면 어떤 클라우드 플래그십도 해당되지 않으며, 질문은 어떤 로컬 모델이 내 카드에 올라가느냐로 바뀝니다.
실제 작업으로 두 모델을 시험하세요. 공개된 벤치마크는 여러분의 사용 사례를 예측하지 못하며, 이는 1년 전보다 지금 더 그렇습니다. 세 업체가 서로 다른 세 가지 평가로 보고하므로 순위를 매길 동일 기준 수치가 존재하지 않습니다. 클라우드는 무료 API 등급을, 로컬은 Ollama를 쓰십시오.
매월이 아니라 분기별로 재점검하세요. 세 플래그십 모두 2026년 7월, 약 2주 간격으로 나왔습니다. 이 몰림이야말로 계획의 기준이 되어야 할 패턴입니다. 이 분야는 물결처럼 움직이며, 물결 직전에 쓰인 비교는 조금 낡은 것이 아니라 한 세대가 뒤처집니다.
관련 문서
최고의 LLM에 대한 빠른 답변
Claude Opus 5와 GPT-5.6 중 어느 것이 더 낫습니까?▾
GPT-5.6의 Sol, Terra, Luna는 무엇이 다릅니까?▾
VRAM이 8GB뿐이라면 최고의 로컬 LLM은 무엇입니까?▾
Gemini 3.1 Pro는 나머지 둘과 비교하면 어떻습니까?▾
전체 설명이 필요하십니까?
전체 가이드 읽기 →