Was ist die Kontextlänge und warum ist sie für lokale LLMs wichtig?
Die Kontextlänge ist die maximale Zahl an Token, die ein Modell in einer Anfrage verarbeiten kann: Ihr Prompt, alle Dokumente, der bisherige Gesprächsverlauf und die Antwort des Modells zusammengerechnet. Ein Token entspricht etwa 0,75 englischen Wörtern, 128K Token sind also etwa 100.000 Wörter und 256K Token etwa 200.000 Wörter.
Das angegebene Fenster ist das Maximum, das die Modellarchitektur unterstützt. Das nutzbare Fenster ist die Länge, bei der die Antworten für Ihre Aufgabe genau bleiben, und es ist kürzer.
Lange Fenster sind wichtig für ganze Codebasen, Verträge, lange Transkripte, Buchkapitel und Agenten-Sitzungen, in denen sich Tool-Ausgaben ansammeln. Die Ollama-Dokumentation empfiehlt mindestens 64.000 Token für Agenten, Websuche und Coding-Tools.
Drei Dinge bestimmen die Grenze auf Ihrem eigenen Rechner: das Fenster des Modells, der Speicher, den sein KV-Cache bei dieser Länge braucht, und wie zuverlässig es Text bei dieser Länge nutzt. Die folgenden Abschnitte behandeln jeden Punkt der Reihe nach.
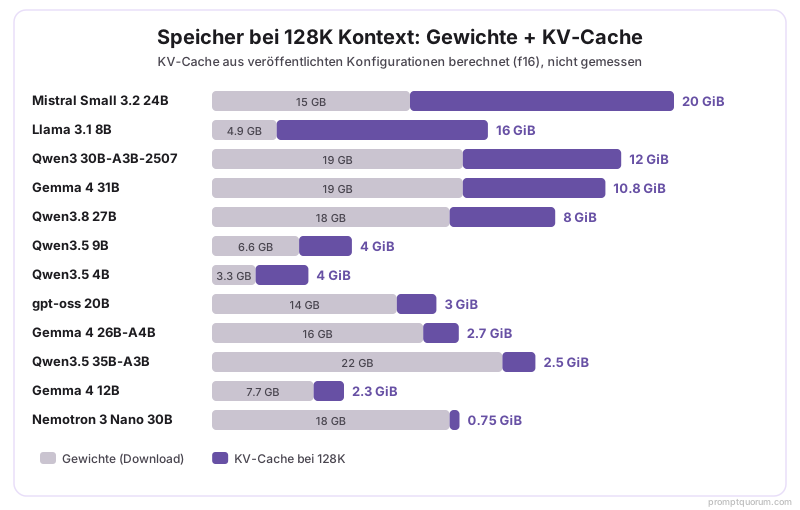
Welche lokalen LLMs unterstützen 2026 mehr als 128K Token?
Mehrere: Qwen3.5, Qwen3.8 und Gemma 4 (ab 12B) nennen in der Ollama-Bibliothek 256K-Fenster, NVIDIA Nemotron 3 Nano 30B nennt 1M und Llama 4 Scout nennt 10M. Vor 2026 veröffentlichte Modelle enden meist bei 128K.
Die Tabelle zeigt das Fenster laut Model Card oder Ollama-Bibliothek. Eine Erweiterung auf längeren Kontext, etwa YaRN, ist eine vom Hersteller dokumentierte Option, die zusätzliche Konfiguration und zusätzlichen Speicher braucht.
Llama 4 Scout nennt 10M Token, doch seine Model Card gibt die Long-Context-Benchmarks bei einem 128K-Fenster an, und der Ollama-Download umfasst 67 GB. Llama 4 Maverick nennt 1M, ist aber ein Download von 245 GB und braucht Server-Hardware.
Ollama-Tags können sich in der Fenstergröße unterscheiden: qwen3:8b und qwen3:14b nennen 40K, qwen3:4b und qwen3:30b dagegen 256K. Lesen Sie die Kontextangabe auf der Ollama-Seite des Modells, bevor Sie planen.
Modell | Angegebenes Fenster | Längerer Kontext | Ollama-Tag |
|---|---|---|---|
| Nemotron 3 Nano 30B-A3B | 1M (Standard 256K) | — | ollama run nemotron-3-nano:30b |
| Qwen3.8 27B | 256K | Bis 1M (YaRN) | ollama run qwen3.8:27b |
| Qwen3.5 9B / 27B | 256K | Bis 1,01M (YaRN) | ollama run qwen3.5:9b |
| Qwen3 30B-A3B-2507 | 256K | 1M (DCA, ~240 GB GPU) | ollama run qwen3:30b |
| Gemma 4 12B / 26B / 31B | 256K | — | ollama run gemma4:26b |
| Gemma 4 E2B / E4B | 128K | — | ollama run gemma4:e4b |
| Llama 4 Scout 109B | 10M angegeben | Benchmarks bei 128K | ollama run llama4:16x17b |
| Mistral Small 3.2 24B | 128K | — | ollama run mistral-small3.2 |
| gpt-oss 20B | 128K | — | ollama run gpt-oss:20b |
| Llama 3.1 8B | 128K | — | ollama run llama3.1:8b |
| Qwen3 8B / 14B | 40K | — | ollama run qwen3:14b |
Wie viel Speicher braucht langer Kontext?
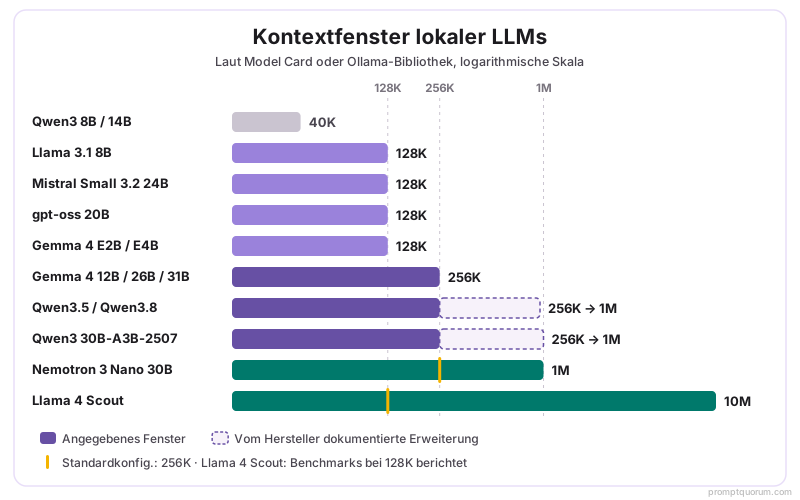
Der Speicher für langen Kontext besteht aus den Modellgewichten plus dem KV-Cache, und der KV-Cache hängt von der Architektur ab, nicht nur vom Fenster. Der KV-Cache speichert die Attention-Keys und -Values jedes Tokens im Kontext und wird zusätzlich zu den Gewichten belegt.
KV-Bytes pro Token = 2 (Keys und Values) × Full-Attention-Schichten × KV-Heads × Head-Dimension × Bytes pro Wert (2 beim Standard-f16-Cache). Llama 3.1 8B: 2 × 32 × 8 × 128 × 2 = 131.072 Bytes (128 KiB) pro Token, das sind 16 GiB bei 128K Token und mehr als das Dreifache seines 4,9-GB-Downloads.
Neuere Architekturen senken diese Kosten. Gemma 4 nutzt in den meisten Schichten Sliding-Window-Attention (ein 1.024-Token-Fenster bei 12B, 26B und 31B), gpt-oss in jeder zweiten Schicht (128 Token), Qwen3.5 und Qwen3.8 nutzen in drei von vier Schichten lineare Gated-DeltaNet-Attention, und Nemotron 3 Nano hat nur 6 Attention-Schichten von 52. Nur Full-Attention-Schichten wachsen mit dem Fenster.
Die folgenden Werte sind aus der veröffentlichten Konfiguration jedes Modells berechnet, nicht gemessen. Laufzeitumgebungen belegen zusätzliche Compute-Puffer und Cache-Implementierungen unterscheiden sich, prüfen Sie die reale Nutzung daher mit ollama ps.
Eine Quantisierung des KV-Cache verkleinert ihn: Laut Ollama-Dokumentation braucht q8_0 etwa halb so viel Speicher wie f16 und q4_0 etwa ein Viertel, bei q4_0 mit geringem bis mittlerem Genauigkeitsverlust.
Modell | Download | KV bei 32K | KV bei 128K | KV bei Maximalfenster |
|---|---|---|---|---|
| Llama 3.1 8B | 4,9 GB | 4 GiB | 16 GiB | 16 GiB (128K) |
| Mistral Small 3.2 24B | 15 GB | 5 GiB | 20 GiB | 20 GiB (128K) |
| gpt-oss 20B | 14 GB | 0,8 GiB | 3 GiB | 3 GiB (128K) |
| Qwen3.5 4B | 3,3 GB | 1 GiB | 4 GiB | 8 GiB (256K) |
| Qwen3.5 9B | 6,6 GB | 1 GiB | 4 GiB | 8 GiB (256K) |
| Gemma 4 12B | 7,7 GB | 0,8 GiB | 2,3 GiB | 4,3 GiB (256K) |
| Gemma 4 26B-A4B | 16 GB | 0,8 GiB | 2,7 GiB | 5,2 GiB (256K) |
| Gemma 4 31B | 19 GB | 3,3 GiB | 10,8 GiB | 20,8 GiB (256K) |
| Qwen3.8 27B | 18 GB | 2 GiB | 8 GiB | 16 GiB (256K) |
| Qwen3.5 35B-A3B | 22 GB | 0,6 GiB | 2,5 GiB | 5 GiB (256K) |
| Qwen3 30B-A3B-2507 | 19 GB | 3 GiB | 12 GiB | 24 GiB (256K) |
| Nemotron 3 Nano 30B-A3B | 18 GB | 0,2 GiB | 0,8 GiB | 6 GiB (1M) |
Welches Long-Context-Modell passt zu Ihrem Rechner?
Wählen Sie zuerst nach Speicher: Gewichte plus KV-Cache beim benötigten Kontext müssen passen, mit 2 bis 3 GB Reserve für Betriebssystem und Laufzeitumgebung. Die folgenden Empfehlungen sind Rechnungen auf Basis der Tabelle oben, keine Qualitätsrankings; wir haben die Genauigkeit bei langem Kontext nicht gebenchmarkt.
- 8 GB: Qwen3.5 4B (3,3 GB Download). Der KV-Cache beträgt 1 GiB bei 32K und 2 GiB bei 64K; 128K brauchen 4 GiB, was auf 8 GB knapp wird.
- 16 GB: Qwen3.5 9B (6,6 GB) passt mit etwa 4 GiB KV-Cache in 128K. Gemma 4 12B (7,7 GB) passt mit etwa 4,3 GiB in sein volles 256K-Fenster.
- 24 bis 32 GB: Gemma 4 26B-A4B (16 GB) braucht bei 256K etwa 5,2 GiB. Qwen3.8 27B (18 GB) braucht bei 128K etwa 8 GiB. gpt-oss 20B (14 GB) braucht bei seinem 128K-Maximum etwa 3 GiB.
- 48 GB und mehr: Gemma 4 31B (19 GB) braucht bei 256K etwa 21 GiB. Mistral Small 3.2 24B (15 GB) braucht bei 128K 20 GiB mit f16-Cache und etwa 10 GiB mit q8_0.
- 1M Token: Laut Konfiguration braucht Nemotron 3 Nano 30B bei 1M etwa 6 GiB KV-Cache zusätzlich zu seinem 18-GB-Download, der Speicher allein schließt es auf einem 32-GB-Rechner also nicht aus. NVIDIA liefert 256K als Standard und nennt H100- und A100-GPUs als unterstützte Hardware, und Unsloth warnt, dass 1M Abstürze durch Speichermangel auslösen kann, behandeln Sie es also als Experiment. Qwen gibt an, dass 1M Token bei Qwen3-30B-A3B-Instruct-2507 etwa 240 GB GPU-Speicher brauchen.
Warum ist der nutzbare Kontext kürzer als das angegebene Maximum?
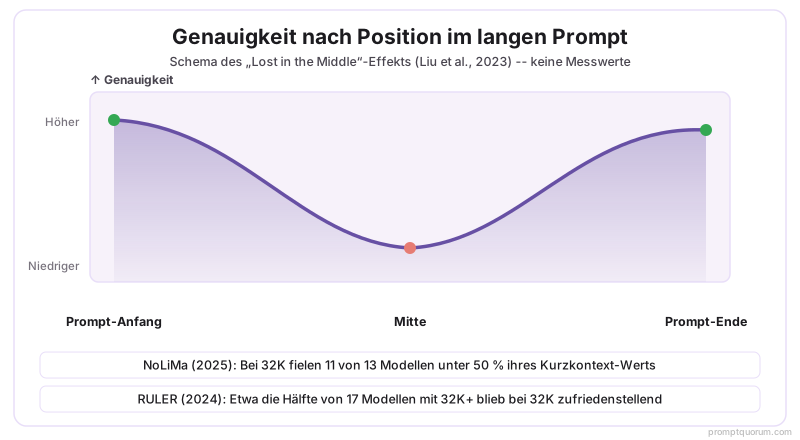
Das angegebene Fenster ist eine architektonische Obergrenze, keine Qualitätsgarantie. Liu et al. (2023) stellten fest, dass Sprachmodelle am genauesten antworten, wenn der relevante Text am Anfang oder Ende der Eingabe steht, und weniger genau, wenn er in der Mitte steht: der „Lost in the Middle“-Effekt.
RULER (Hsieh et al., 2024) testete 17 Modelle, die alle 32K Token oder mehr angeben; nur etwa die Hälfte behielt bei 32K eine zufriedenstellende Leistung. NoLiMa (Modarressi et al., 2025) testete 13 Modelle mit mindestens 128K; bei 32K fielen 11 davon unter 50 % ihres Kurzkontext-Werts, und GPT-4o sank von 99,3 % auf 69,7 %.
Diese Studien sind älter als die meisten Modelle in diesem Leitfaden. Verstehen Sie sie als Beleg für das Muster, nicht als Messwerte für ein hier genanntes Modell. Um ein Modell selbst zu prüfen, verstecken Sie einen Fakt bei 10 %, 50 % und 90 % eines langen Prompts, fragen Sie mit anderen Worten danach und wiederholen Sie das bei 32K, 64K und 128K.
Wenn es auf Genauigkeit ankommt, setzen Sie kritische Anweisungen und Fakten an den Anfang oder das Ende des Prompts, rufen Sie nur die relevanten Passagen ab (siehe RAG-Abschnitt unten) oder verarbeiten Sie lange Dokumente in überlappenden Abschnitten.
Wie stellt man die Kontextlänge in Ollama, LM Studio und llama.cpp ein?
Ollama wählt den Standardkontext nach Ihrem VRAM: 4K Token unter 24 GiB, 32K von 24 bis 48 GiB und 256K ab 48 GiB. Eingaben über den aktiven Kontext hinaus werden abgeschnitten, das Modell sieht den Anfang eines langen Dokuments dann nie.
Sie können den Kontext über den Schieberegler der Ollama-App, die Umgebungsvariable OLLAMA_CONTEXT_LENGTH, /set parameter num_ctx in ollama run, ein Modelfile oder die API-Option num_ctx einstellen. Prüfen Sie das Ergebnis mit ollama ps.
In LM Studio öffnen Sie „My Models“, klicken auf das Zahnrad eines Modells und stellen Kontextgröße und Flash Attention ein. In llama.cpp legt -c die Kontextgröße fest (0 lädt sie aus dem Modell), -fa steuert Flash Attention, und --cache-type-k sowie --cache-type-v quantisieren den KV-Cache.
Ollama quantisiert den KV-Cache nur bei aktivem Flash Attention, und die Einstellung gilt global für alle Modelle. OLLAMA_KV_CACHE_TYPE=q8_0 braucht etwa halb so viel Speicher wie f16 und q4_0 etwa ein Viertel.
# 1. Check what a loaded model really uses (see the CONTEXT column)
ollama ps

# 2. Server-wide default (the Ollama app has a context slider instead)
OLLAMA_CONTEXT_LENGTH=65536 ollama serve

# 3. One interactive session
ollama run qwen3.5:9b
>>> /set parameter num_ctx 65536

# 4. A persistent custom model
cat << EOF > Modelfile
FROM qwen3.5:9b
PARAMETER num_ctx 131072
EOF
ollama create qwen3.5-9b-128k -f Modelfile
ollama run qwen3.5-9b-128k

# 5. Optional: shrink the KV cache (global setting, needs Flash Attention)
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# llama.cpp equivalent
llama-server -m model.gguf -c 131072 -fa on --cache-type-k q8_0 --cache-type-v q8_0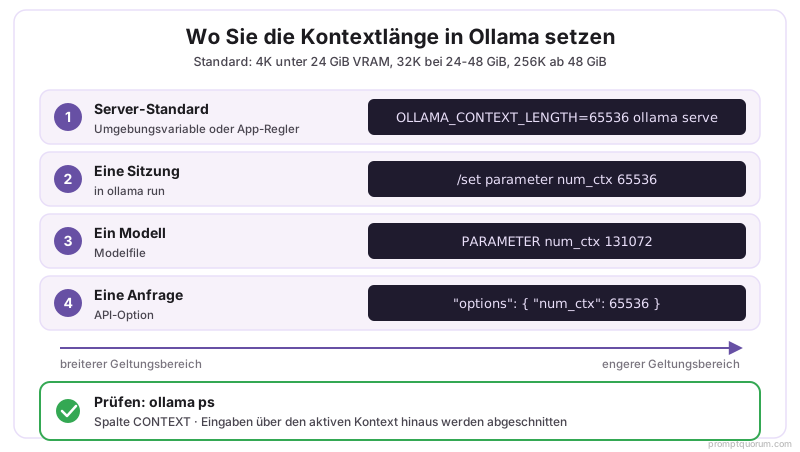
Brauchen nicht-englische Dokumente mehr vom Kontextfenster?
Das kann sein: Petrov et al. (2023) stellten fest, dass derselbe Text je nach Tokenizer in einer Sprache bis zu 15-mal mehr Token brauchen kann als in einer anderen. Ob japanischer, chinesischer, koreanischer oder arabischer Text betroffen ist, hängt vom Tokenizer des Modells ab.
Rechnen Sie Seiten nicht mit der englischen Regel von 0,75 Wörtern pro Token in Token um. Zählen Sie die Token mit dem Modell, das Sie verwenden wollen: ollama run <model> --verbose gibt nach einer Antwort die Token-Anzahl des Prompts aus.
Planen Sie das Fenster pro Sprache und pro Modellfamilie, denn Tokenizer unterscheiden sich zwischen Modellfamilien.
Langer Kontext oder RAG für Dokumente?
Nutzen Sie RAG, wenn die Antwort in wenigen Passagen einer großen Sammlung steht, und langen Kontext, wenn das Modell über ein zusammenhängendes Dokument schlussfolgern muss.
RAG (Retrieval-Augmented Generation) ruft die relevantesten Textabschnitte ab, oft insgesamt nur wenige tausend Token, und hält den Prompt kurz. Langer Kontext erhält Querverweise, etwa Klauseln in einem Vertrag oder Aufrufketten in einer Codebasis, die Chunking zerschneiden kann.
Viele Setups kombinieren beides: ganze Abschnitte statt Fragmente abrufen und in ein 32K- bis 128K-Fenster legen. Siehe Beste lokale RAG-Tools für lokale Optionen und RAG erklärt für die Methode.
Häufige Fehler bei lokalen LLMs mit langem Kontext
- Dem Standardkontext vertrauen: Ollama verwendet unter 24 GiB VRAM standardmäßig 4K Token, egal was das Modell unterstützt, ein 100-seitiges Dokument wird also abgeschnitten, bevor das Modell es liest. Setzen Sie den Kontext ausdrücklich und bestätigen Sie ihn in der Spalte CONTEXT von ollama ps.
- Den Speicher nach der Downloadgröße planen: Der KV-Cache kann größer sein als die Gewichte. Llama 3.1 8B ist ein 4,9-GB-Download, braucht bei 128K aber etwa 16 GiB KV-Cache. Nutzen Sie die Formel oder die Tabelle oben, bevor Sie den Kontext erhöhen.
- Annehmen, dass jedes Tag das lange Fenster hat: In der Ollama-Bibliothek nennt qwen3:14b 40K, qwen3:30b dagegen 256K. Lesen Sie die Kontextangabe auf der Modellseite, bevor Sie planen.
- Das angegebene Fenster mit dem nutzbaren Fenster gleichsetzen: RULER und NoLiMa fanden bei 32K starke Genauigkeitsverluste bei vielen Modellen, die 128K oder mehr angeben. Testen Sie mit eigenen Dokumenten in der Länge, die Sie nutzen wollen.
- Standardmäßig zu 1M Token greifen: Prefill-Zeit und Speicher wachsen mit dem Prompt, und Unsloth warnt, dass 1M bei Nemotron 3 Nano Abstürze durch Speichermangel auslösen kann. Nutzen Sie 1M für gelegentliche Aufgaben und bevorzugen Sie im Alltag RAG oder Chunking.
- q4_0 für den KV-Cache ohne Test setzen: Ollama dokumentiert für q4_0 einen geringen bis mittleren Genauigkeitsverlust, der bei größeren Kontexten deutlicher sein kann, und die Einstellung gilt für jedes Modell. Beginnen Sie mit q8_0.
Häufig gestellte Fragen
Welches ist 2026 das längste Kontextfenster, das ein lokales LLM nutzen kann?
Llama 4 Scout nennt 10M Token, doch seine Model Card gibt Benchmarks bei 128K an, und der Ollama-Download umfasst 67 GB. Unter den Modellen, die auf einem normalen Rechner laufen, unterstützt NVIDIA Nemotron 3 Nano 30B-A3B 1M Token (256K ist die Standardkonfiguration), und Qwen3.8 sowie Qwen3.5 unterstützen nativ 256K, mit YaRN bis etwa 1M. Ob ein langes Fenster nutzbar ist, hängt vom Speicher ab und davon, wie genau das Modell lange Eingaben liest.
Reicht ein 128K-Kontextfenster noch aus?
128K Token sind etwa 100.000 Wörter und genügen für die meisten einzelnen Dokumente. Ein Buch mit 300 Seiten umfasst typischerweise 75.000 bis 100.000 Wörter, grob 100K bis 135K Token, und überschreitet ein 128K-Fenster daher meist oder füllt es fast ganz aus, ohne Platz für Fragen und Antworten. Ein 256K-Fenster fasst das Buch und die Antwort; darüber hinaus nutzen Sie RAG oder Chunking.
Wie viel Speicher braucht ein Kontext von 1M Token?
Das hängt von der Architektur ab. Nach den veröffentlichten Konfigurationen beträgt der f16-KV-Cache bei 1M Token etwa 32 GiB bei Qwen3.5 9B, etwa 64 GiB bei Qwen3.8 27B und etwa 6 GiB bei Nemotron 3 Nano 30B-A3B, zusätzlich zu den Gewichten. Qwen gibt an, dass 1M Token bei Qwen3-30B-A3B-Instruct-2507 etwa 240 GB GPU-Speicher brauchen. Ein q8_0-Cache halbiert die KV-Werte, und die Zeit zum Lesen eines Prompts mit 1M Token wächst mit seiner Länge, reservieren Sie ihn also für gelegentliche Aufgaben.
Warum brauchen Modelle mit gleichem Kontextfenster unterschiedlich viel Speicher?
Der KV-Cache wächst mit Full-Attention-Schichten × KV-Heads × Head-Dimension × Token. Llama 3.1 8B braucht 128 KiB pro Token, Gemma 4 26B-A4B etwa 20 KiB, weil nur 5 seiner 30 Schichten Full Attention nutzen, und Nemotron 3 Nano etwa 6 KiB, weil nur 6 seiner 52 Schichten Attention-Schichten sind. Sliding-Window-, lineare Attention- und Mamba-Schichten halten einen Zustand fester Größe, statt mit dem Fenster zu wachsen.
Was ist der KV-Cache und wie kann ich ihn verkleinern?
Der KV-Cache enthält die Attention-Keys und -Values jedes Tokens im Kontext, damit das Modell sie nicht für jedes neue Token neu berechnen muss. Er wird zusätzlich zu den Gewichten belegt und wächst mit der Kontextlänge. Zum Verkleinern senken Sie num_ctx, aktivieren Flash Attention und setzen OLLAMA_KV_CACHE_TYPE auf q8_0 (etwa halb so viel Speicher wie f16) oder q4_0 (etwa ein Viertel, mit stärkerem Genauigkeitsverlust bei langen Kontexten), oder wählen ein Modell mit kleinerem Cache pro Token. In Ollama gilt der Cache-Typ global für jedes Modell.
Warum vergisst mein lokales Modell den Anfang meines Dokuments?
Wahrscheinlich ist der aktive Kontext kleiner als Ihr Dokument. Ollama verwendet auf GPUs mit unter 24 GiB VRAM standardmäßig 4K Token, von 24 bis 48 GiB 32K und ab 48 GiB 256K, unabhängig davon, was das Modell unterstützt, und Eingaben über den Kontext hinaus werden abgeschnitten. Prüfen Sie die Spalte CONTEXT von ollama ps und erhöhen Sie ihn mit OLLAMA_CONTEXT_LENGTH, /set parameter num_ctx, einem Modelfile oder der API-Option num_ctx.
Wie stelle ich in Ollama einen Kontext von 128K ein?
Erstellen Sie ein Modelfile mit FROM qwen3.5:9b und PARAMETER num_ctx 131072, führen Sie ollama create qwen3.5-9b-128k -f Modelfile aus, dann ollama run qwen3.5-9b-128k, und prüfen Sie mit ollama ps. Alternativ starten Sie den Server mit OLLAMA_CONTEXT_LENGTH=131072 ollama serve. Stellen Sie vorher sicher, dass Gewichte plus KV-Cache in den Speicher passen; bei Qwen3.5 9B sind das etwa 6,6 GB plus 4 GiB.
Macht ein längerer Kontext ein lokales LLM langsamer?
Ja. Das Modell muss den gesamten Prompt lesen (Prefill), bevor es das erste Token schreibt, die Zeit bis zum ersten Token wächst also mit der Prompt-Länge, und Attention über einen größeren Cache senkt auch die Generierungsgeschwindigkeit. Lineare Attention- und Mamba-Schichten verringern das Wachstum, beseitigen es aber nicht. Messen Sie auf Ihrer Hardware mit ollama run <model> --verbose, das Raten für Prompt-Auswertung und Generierung ausgibt.
Was ist das „Lost in the Middle“-Problem und gilt es noch?
Liu et al. (2023) stellten fest, dass Sprachmodelle am genauesten antworten, wenn der relevante Text am Anfang oder Ende der Eingabe steht, und weniger genau, wenn er in der Mitte steht. RULER (2024) und NoLiMa (2025) zeigten später, dass viele Modelle mit 32K- bis 128K-Fenstern weit vor ihrer Grenze an Genauigkeit verlieren. Diese Studien testeten frühere Modelle, führen Sie also Ihre eigene Prüfung durch: Verstecken Sie einen Fakt bei 10 %, 50 % und 90 % eines langen Prompts und fragen Sie danach. Setzen Sie kritische Anweisungen an den Anfang oder das Ende oder rufen Sie nur die relevanten Passagen ab.
Ist langer Kontext oder RAG besser für Fragen zu Dokumenten?
RAG ist meist günstiger bei Speicher und Zeit, wenn die Antwort in wenigen Passagen einer großen Sammlung steht, weil der Prompt auf wenige tausend Token begrenzt bleibt. Langer Kontext ist besser, wenn das Modell über ein zusammenhängendes Dokument schlussfolgern muss, etwa einen Vertrag, eine Codebasis oder ein Buchkapitel, in dem Chunking Querverweise zerschneiden würde. Viele Setups kombinieren beides, indem sie ganze Abschnitte in ein 32K- bis 128K-Fenster abrufen.
Kann ich ein ganzes Buch mit einem lokalen LLM zusammenfassen?
Ein Buch mit 300 Seiten umfasst grob 100K bis 135K Token, passt also in ein 256K-Fenster (Qwen3.5, Qwen3.8, Gemma 4 ab 12B) und passt womöglich nicht in ein 128K-Fenster, sobald die Zusammenfassung mitgezählt wird. Mit einem 128K-Modell oder weniger Speicher fassen Sie kapitelweise zusammen und danach die Zusammenfassungen. Setzen Sie num_ctx ausdrücklich, damit das ganze Buch im aktiven Kontext liegt.
Brauchen nicht-englische Dokumente mehr vom Kontextfenster?
Das kann sein. Petrov et al. (2023) stellten fest, dass derselbe Text je nach Tokenizer in einer Sprache bis zu 15-mal mehr Token brauchen kann als in einer anderen. Zählen Sie die Token mit Ihrem Modell, statt die englische Regel von 0,75 Wörtern pro Token zu verwenden: ollama run <model> --verbose gibt die Token-Anzahl des Prompts aus.
Welche Long-Context-Modelle laufen auf einem Rechner mit 16 GB?
Rechnerisch passen Qwen3.5 9B (6,6 GB Download plus etwa 4 GiB KV-Cache bei 128K) und Gemma 4 12B (7,7 GB plus etwa 4,3 GiB bei vollem 256K-Fenster) mit einigen GB Reserve in 16 GB. Das sind Berechnungen aus veröffentlichten Konfigurationen, keine gemessenen Läufe; prüfen Sie mit ollama ps.
Quellen
- Ollama. (2026). "Context length" documentation. docs.ollama.com -- Standardkontext nach VRAM-Stufe, OLLAMA_CONTEXT_LENGTH, Empfehlung von 64.000 Token für Agenten.
- Ollama. (2026). "FAQ". docs.ollama.com -- /set parameter num_ctx, OLLAMA_FLASH_ATTENTION, OLLAMA_KV_CACHE_TYPE (f16, q8_0, q4_0).
- Ollama. (2026). "qwen3.8" library page. ollama.com -- 27B, 18 GB, 256K Kontext.
- Ollama. (2026). "qwen3.5" library page. ollama.com -- Tags von 0.8B bis 122B, 256K Kontext.
- Ollama. (2026). "qwen3" library page. ollama.com -- 40K für 8B/14B/32B, 256K für 4B/30B.
- Ollama. (2026). "gemma4" library page. ollama.com -- E2B/E4B 128K, 12B/26B/31B 256K.
- Ollama. (2026). "nemotron-3-nano" library page. ollama.com -- Tag 30B nennt 1M Kontext, 18 GB.
- Ollama. (2026). "llama4" library page. ollama.com -- Scout 67 GB und 10M, Maverick 245 GB und 1M.
- Ollama. (2026). "mistral-small3.2", "gpt-oss" und "llama3.1" library pages. ollama.com -- 128K-Fenster, Downloads von 15 GB, 14 GB und 4,9 GB.
- Qwen Team. (2026). "Qwen3.8-27B" model card. huggingface.co -- 262.144 nativ, bis 1.000.000 mit YaRN, Apache-2.0.
- Qwen Team. (2026). "Qwen3.5-9B" model card. huggingface.co -- 262.144 nativ, bis 1.010.000 mit YaRN; hybrides Gated-DeltaNet-Layout.
- Qwen Team. (2025). "Qwen3-30B-A3B-Instruct-2507" model card. huggingface.co -- 262.144 nativ, 1M mit Dual Chunk Attention, etwa 240 GB GPU-Speicher.
- Google. (2026). "Gemma 4 31B" model card. huggingface.co -- 128K für E2B/E4B, 256K für die größeren Varianten.
- NVIDIA. (2025). "NVIDIA-Nemotron-3-Nano-30B-A3B-BF16" model card. huggingface.co -- 23 Mamba-2- und MoE-Schichten plus 6 Attention-Schichten, 1M unterstützt, 256K Standard.
- Meta. (2025). "Llama-4-Scout-17B-16E-Instruct" model card. huggingface.co -- 109B gesamt, 10M angegeben, Long-Context-Benchmarks bei 128K.
- Unsloth. (2026). "NVIDIA Nemotron 3 Nano -- How To Run Guide". unsloth.ai -- 1M Kontext kann den Speicher sprengen, Standard 262.144.
- Liu et al. (2023). "Lost in the Middle: How Language Models Use Long Contexts". arxiv.org -- die Genauigkeit ist am Anfang und Ende der Eingabe am höchsten.
- Hsieh et al. (2024). "RULER: What's the Real Context Size of Your Long-Context Language Models?". arxiv.org -- nur etwa die Hälfte von 17 Modellen mit 32K+ bleibt bei 32K zufriedenstellend.
- Modarressi et al. (2025). "NoLiMa: Long-Context Evaluation Beyond Literal Matching". arxiv.org -- 11 von 13 Modellen fallen bei 32K unter 50 % ihres Kurzkontext-Werts.
- Petrov et al. (2023). "Language Model Tokenizers Introduce Unfairness Between Languages". arxiv.org -- bis zu 15-mal mehr Token für denselben Text.
- llama.cpp. "llama-server" README. github.com -- --ctx-size, --flash-attn, --cache-type-k, --cache-type-v.
- LM Studio. "Per-model default parameters". lmstudio.ai -- Kontextgröße und Flash Attention pro Modell.
- Die KV-Cache-Größen in diesem Leitfaden sind aus der config.json jedes Modell-Repositorys auf Hugging Face berechnet (Schichten, KV-Heads, Head-Dimension, Attention-Schichttypen) und nicht gemessen.