Wichtigste Erkenntnisse
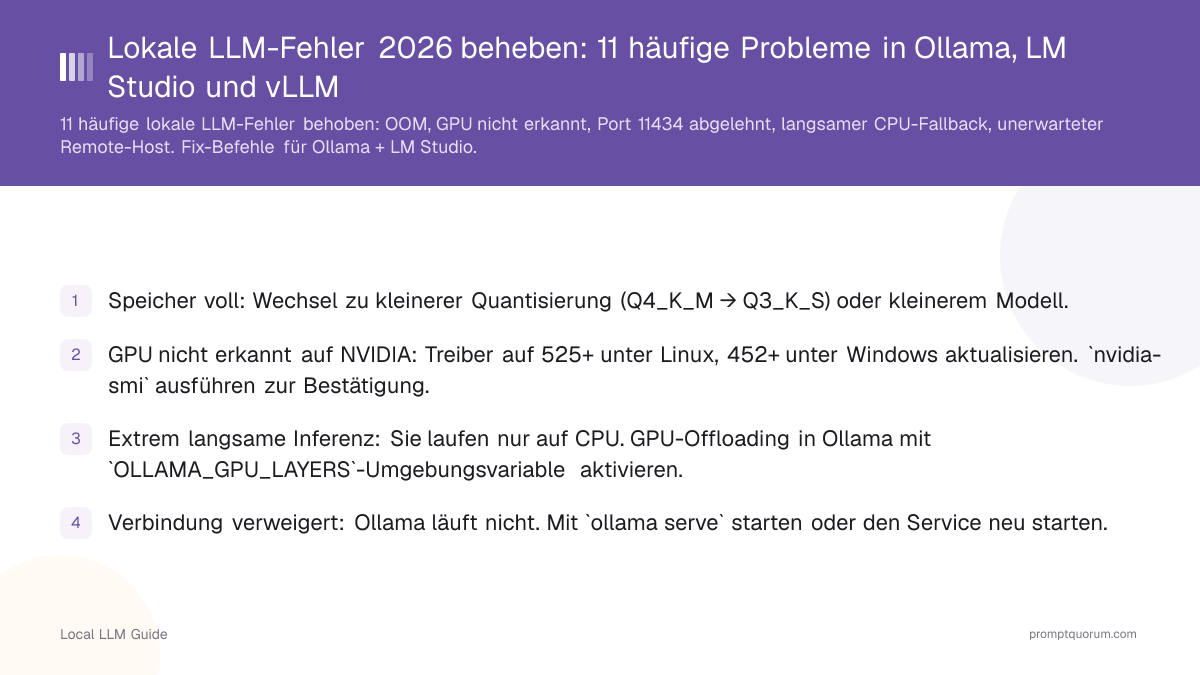
- Speicher voll: Wechsel zu kleinerer Quantisierung (Q4_K_M → Q3_K_S) oder kleinerem Modell.
- GPU nicht erkannt auf NVIDIA: Treiber auf 525+ unter Linux, 452+ unter Windows aktualisieren. `nvidia-smi` ausführen zur Bestätigung.
- Extrem langsame Inferenz: Sie laufen nur auf CPU. GPU-Offloading in Ollama mit `OLLAMA_GPU_LAYERS`-Umgebungsvariable aktivieren.
- Verbindung verweigert: Ollama läuft nicht. Mit `ollama serve` starten oder den Service neu starten.
- Fehlerhafte Ausgabe: falsche Prompt-Vorlage. Verwenden Sie die Instruct-Variante des Modells, nicht die Basis-Variante.
📍 In einem Satz
Die häufigsten lokalen LLM-Fehler -- Out-of-Memory-Abstürze, nicht erkannte GPU, extrem langsame CPU-Inferenz, verweigerte Verbindung und fehlerhafte Ausgabe -- lassen sich alle mit ein bis zwei Terminal-Befehlen in Ollama, LM Studio und vLLM beheben.
💬 In einfachen Worten
Wenn Ihr lokales KI-Setup nicht funktioniert, liegt es fast immer an einem von wenigen bekannten Problemen: zu wenig Speicher, die Grafikkarte wird nicht genutzt, ein Dienst läuft nicht, oder das Modell verwendet das falsche Chat-Format. Für jedes gibt es eine schnelle Lösung -- meist ein einziger Befehl, um einen Treiber zu aktualisieren, einen Dienst neu zu starten oder auf eine kleinere Modelldatei zu wechseln.

Fehler 1: "Nicht genug Speicher" / Out-of-Memory-Absturz
Out-of-Memory-Fehler bedeuten, dass das Modell mehr RAM benötigt als verfügbar ist — kein Hardware-Fehler. Dies ist der häufigste Fehler für Erstbenutzer. Siehe LLM-Quantisierung erklärt für Hintergrund, wie Quantisierung RAM-Anforderungen reduziert.
- Verfügbaren Speicher überprüfen: auf macOS/Linux `free -h` ausführen, auf Windows Task Manager → Performance → Memory öffnen.
- Zu kleinerer Quantisierung wechseln: Ersetzen Sie `Q8_0` oder `Q5_K_M` mit `Q4_K_M`. Für Ollama: `ollama run llama3.2-instruct-q4_K_M`.
- Hintergrundanwendungen schließen vor dem Modellladen — Browser und andere Apps verbrauchen RAM, das dem Modell fehlt.
- Zu kleinerem Modell wechseln: wenn 8B bei 8 GB RAM fehlschlägt, versuchen Sie `llama3.2:3b` (benötigt nur ~2,5 GB).

Verfügbaren RAM unter Linux / macOS überprüfen
# Linux
free -h

# macOS
vm_stat | grep "Pages free"

# Lesbarer unter macOS
top -l 1 | grep "PhysMem"
Fehler 2: GPU wird nicht verwendet (läuft nur auf CPU)
GPU wird nicht verwendet bedeutet, das LLM läuft 5–10× langsamer als erwartet — Treiberinstallation vor allem anderen überprüfen. Überprüfen Sie, dass Ihre GPU für das System sichtbar ist:
# NVIDIA — sollte GPU-Name und Treiberversion anzeigen
nvidia-smi

# AMD unter Linux
rocm-smi

# macOS — überprüfen Sie, ob Metal verfügbar ist
system_profiler SPDisplaysDataType | grep "Metal"
Wie aktivieren Sie GPU in Ollama?
- NVIDIA unter Linux: installieren Sie NVIDIA-Treiber 525+ und CUDA Toolkit 11.3+. Ollama erkennt CUDA beim Neustart automatisch.
- NVIDIA unter Windows: stellen Sie sicher, dass Treiberversion 452.39 oder höher ist. Ollama installiert CUDA-Unterstützung automatisch über den Windows-Installer.
- AMD unter Linux: installieren Sie ROCm 5.7+. Setzen Sie `HSA_OVERRIDE_GFX_VERSION=11.0.0` für RX 6000-Serie-Karten, falls Erkennung fehlschlägt.
- Apple Silicon: Ollama verwendet standardmäßig Metal — keine Konfiguration erforderlich. Bestätigen Sie mit `ollama ps` nach dem Laden eines Modells; GPU-Layer erscheinen in der Ausgabe.
Fehler 3: Inferenz ist extrem langsam (unter 5 Token/Sekunde)
Unter 5 Token/Sekunde bedeutet, dass das Modell nur auf CPU läuft oder das Modell zu groß für verfügbare VRAM ist. Ein 7B-Modell auf GPU generiert 30–80 tok/s; dasselbe Modell auf CPU generiert 3–10 tok/s.
- Bestätigen Sie, ob GPU aktiv ist: führen Sie `ollama ps` aus, während ein Modell geladen ist. Die Ausgabe zeigt, wie viele Layer auf GPU gegen CPU sind.
- Modellgröße reduzieren: ein 13B-Modell auf CPU generiert 3–6 tok/s. Wechsel zu 7B verdoppelt die Geschwindigkeit; Wechsel zu 3B vervierfacht sie.
- GPU-Layer in Ollama erhöhen: setzen Sie `OLLAMA_GPU_LAYERS=999`, um alle Layer auf GPU zu verschieben (Ollama wird auf das begrenzen, was in VRAM passt).
- Schnellere Quantisierung verwenden: Q4_K_M ist die schnellste Quantisierung, die akzeptable Qualität behält. Q8_0 ist höhere Qualität, aber ~30% langsamer.
GPU-Layer in Ollama setzen
# Umgebungsvariable vor dem Starten von Ollama setzen
export OLLAMA_GPU_LAYERS=999
ollama serve

# Oder in einer Modelfile
FROM llama3.1:8b
PARAMETER num_gpu 999
Fehler 4: "Connection Refused" beim API-Aufruf
Connection Refused bedeutet, Ollama läuft nicht — der API bei `localhost:11434` antwortet nur wenn der Service aktiv ist. Starten Sie es vor API-Aufrufen.
# Ollama manuell starten
ollama serve

# Unter Linux — systemd-Service neu starten
systemctl restart ollama

# Überprüfen Sie, dass es läuft
curl http://localhost:11434
# Erwartet: "Ollama is running"
Fehler 5: "Model Not Found"-Fehler
"Modell nicht gefunden" bedeutet, der Modellname in Ihrem Befehl passt zu keinem heruntergeladenen Modell. Modellnamen in Ollama beachten Groß-/Kleinschreibung und umfassen Versions-Tags.
# Alle heruntergeladenen Modelle auflisten
ollama list

# Modell laden, wenn es fehlt
ollama pull llama3.2

# Exakten Modellnamen überprüfen — Tags sind wichtig
# "llama3.2" und "llama3.2:3b" sind unterschiedliche Einträge
Fehler 6: Beschädigte Modelldatei
Eine beschädigte Modelldatei entsteht durch unterbrochene Downloads — löschen und neu laden zum Beheben. Ollama erkennt teilweise Downloads nicht immer selbst.
# Beschädigtes Modell entfernen
ollama rm llama3.2

# Erneut laden
ollama pull llama3.2

# Für LM Studio: Modelldatei manuell löschen
# Standardort: ~/.cache/lm-studio/models/
Fehler 6b: "Failed to Resolve Model" in LM Studio
"Failed to resolve model lmstudio-community/..." bedeutet, LM Studio kann das Modell nicht in seiner Registry finden. Dies tritt typischerweise auf, wenn das Modell von `lmstudio-community` auf Hugging Face heruntergeladen wurde, aber die Registry-Referenz sich geändert hat. LM Studio verwendet einen zwischengespeicherten Registry-Eintrag, der nicht mehr den verfügbaren Modelldateien entspricht.
- Öffnen Sie LM Studio → My Models-Reiter → klicken Sie auf das Drei-Punkte-Menü bei dem fehlerhaften Modell → wählen Sie "Delete model" (behält die Datei, entfernt Registry)
- Suchen Sie im Model-Browser nach demselben Modell und laden Sie es erneut herunter — LM Studio wird es erneut registrieren
- Alternative: Beenden Sie LM Studio, navigieren Sie zu `~/.cache/lm-studio/models/` und löschen Sie den spezifischen Modellordner, laden Sie dann erneut herunter
# LM Studio-Modell-Cache manuell löschen (macOS/Linux)
rm -rf ~/.cache/lm-studio/models/lmstudio-community/<model-name>
Fehler 6c: "No Compatible Options Available for This Format"
Dieser Fehler bedeutet, dass die heruntergeladene Modelldatei kein Format ist, das Ihr installiertes Backend ausführen kann — kein beschädigter Download. Er tritt auf, wenn eine `.safetensors`- oder reine MLX-Datei in ein llama.cpp-basiertes Backend geladen wird, oder wenn eine GGUF-Datei eine neuere Runtime benötigt als die installierte.
- Dateiformat überprüfen: Ollama und das Standard-LM-Studio-Backend führen GGUF-Dateien aus. MLX-Builds laufen nur auf Apple Silicon mit aktiviertem MLX-Backend in den LM-Studio-Einstellungen.
- Korrektes Format erneut herunterladen: wählen Sie auf der Modellseite eine GGUF-Quantisierung (z. B. Q4_K_M) statt eines `.safetensors`-Repositorys.
- LM Studio aktualisieren: neuere GGUF-Quantisierungsschemata erfordern manchmal ein Runtime-Update. Prüfen Sie Einstellungen → Runtime auf verfügbare Updates, bevor Sie das Modell erneut herunterladen.
Fehler 7: CUDA oder ROCm-Fehler
CUDA-Fehler zeigen, dass die GPU erkannt wird, aber die Treiber oder Bibliotheken inkompatibel sind. Dies ist häufiger auf Linux als Windows/macOS.
- NVIDIA-Treiber-Version überprüfen: `nvidia-smi` sollte Treiberversion ≥ 450.80 anzeigen. Outdated Treiber können CUDA nicht starten.
- CUDA-Toolkit überprüfen: Ollama benötigt CUDA 11.3+. Installieren Sie auf Linux: `ubuntu-drivers devices` und `sudo ubuntu-drivers autoinstall`.
- ROCm für AMD konfigurieren: Setzen Sie Umgebungsvariablen vor dem Start. Für RX 6000-Serie: `HSA_OVERRIDE_GFX_VERSION=10.3.0`, für RX 7000: `11.0.0`.
Fehler 8: Fehlerhafte oder repetitive Ausgabe
Fehlerhafte oder wiederholte Ausgabe bedeutet fast immer, dass Sie die falsche Modell-Variante verwenden. Base-Modelle ohne Instruct-Format erzeugen Müll; Instruct-Modelle sind für Gespräche trainiert.
- Verwenden Sie die Instruct-Variante: bei Ollama, ersetzen Sie `llama3.1:8b` mit `llama3.1:8b-instruct`. Die "-instruct"-Variante versteht Befehle und antwortet richtig.
- LM Studio Chat-Vorlage überprüfen: Model-Einstellungen → Chat Format. Wählen Sie das richtige Format für das Modell (z.B. "Llama 3.3 Chat" für Llama-Modelle).
- System-Prompt überprüfen: manchmal hat ein fehlerhafter System-Prompt (z.B. zu lange, zirkulär) Auswirkung auf die Ausgabe. Versuchen Sie einen generischen Prompt: "You are a helpful assistant."
Fehler 9: "Port Already in Use"
"Port bereits in Verwendung" bedeutet, ein anderer Prozess bindet bereits Port 11434 (Ollama) oder Port 1234 (LM Studio). Dies ist häufig ein zweiter Ollama-Prozess oder ein anderer Dienst.
- Alternativer Port für Ollama: setzen Sie `OLLAMA_HOST=0.0.0.0:11435` vor dem Start, um einen anderen Port zu verwenden.
# Port-Nutzer finden (macOS/Linux)
lsof -i :11434

# Windows
netstat -ano | findstr 11434

# Prozess beenden (Note PID)
kill -9 <PID>  # macOS/Linux
taskkill /PID <PID> /F  # Windows
Fehler 10: Modell stoppt mitten im Response
Das Modell produziert keine vorhersehbare Ausgabe mehr, nachdem wenige Sätze generiert wurden. Dies ist normalerweise begrenzte Ausgabe-Token oder ein Speicherproblem.
- Erhöhen Sie max_tokens Limit: die Standard num_predict ist oft 128 Token. In Ollama, setzen Sie `OLLAMA_NUM_PREDICT=2048`. In LM Studio, erhöhen Sie "Max Tokens" im Schieberegler.
- Stop-Sequenzen überprüfen: einige Chat-Vorlagen erzeugen Stop-Sequenzen (z.B. "[INST]") die die Ausgabe vorzeitig beenden. Überprüfen Sie im System-Prompt oder den Chat-Format-Einstellungen.
- RAM-Druck überprüfen: wenn Sie Swap nutzen (Festplatte statt RAM), stoppt die Inferenz. Überprüfen Sie mit `free -h` während das Modell lädt.
Fehler 11: "Failed to Load LLM Client" — Unerwarteter Remote-Host
**Ein Fehler "failed to load LLM client: [host]:443" bedeutet, dass die Anwendung versucht, über HTTPS einen externen Server zu erreichen — nicht Ihre lokale Ollama- oder LM-Studio-Installation.** Ollama und LM Studio kontaktieren standardmäßig nie einen Remote-Server für die Inferenz; wenn ein Client diesen Fehler bei einer unbekannten Domain meldet, handelt es sich bei der App um einen Wrapper oder Fork eines Drittanbieters mit fest codiertem Remote-Endpunkt, der derzeit nicht erreichbar ist.
- Identifizieren Sie, welche App den Fehler auslöst: diese Meldung stammt nicht direkt von Ollama oder LM Studio. Prüfen Sie die Einstellungen, README oder den Quellcode der App auf einen fest codierten API-Endpunkt oder Lizenzprüfserver.
- Prüfen Sie zuerst Ihr Netzwerk: falls die App tatsächlich einen Cloud-Dienst aufrufen soll, stellen Sie sicher, dass Firewall, VPN oder Antivirus ausgehendes HTTPS auf Port 443 zu diesem Host nicht blockiert.
- Wechseln Sie zu einem rein lokalen Client, wenn Sie Offline-Inferenz möchten: nutzen Sie Ollama (`localhost:11434`) oder LM Studio (`localhost:1234`) direkt — keiner von beiden macht ausgehende Aufrufe an einen Server für lokale Modelle.
- Geben Sie keine API-Schlüssel oder Zugangsdaten in einen unbekannten Client ein, bevor Sie bestätigt haben, was der Remote-Endpunkt ist und warum die App ihn benötigt. Deinstallieren Sie die App, wenn Sie ihren Ursprung nicht überprüfen können.
Häufig gestellte Fragen
Was verursacht OOM-Fehler bei lokalen LLMs?
OOM-Fehler (Out of Memory) treten auf, wenn die Modellgröße den verfügbaren RAM oder VRAM übersteigt. Behebung: wechseln Sie zu einem kleineren Modell (`ollama run llama3.2:3b` benötigt ~2,5 GB) oder verwenden Sie eine niedrigere Quantisierungsstufe. Führen Sie `free -h` (Linux/macOS) aus, um den verfügbaren RAM zu überprüfen, bevor Sie Modelle über 7B herunterladen.
Warum wird meine GPU von Ollama nicht erkannt?
NVIDIA: Treiber 525+ und CUDA-Toolkit 11.3+ installieren, dann Ollama neu starten. AMD unter Linux: ROCm 5.7+ installieren. Erkennung überprüfen mit `nvidia-smi` (NVIDIA) oder `rocm-smi` (AMD). Apple Silicon: Ollama nutzt standardmäßig Metal — keine Konfiguration erforderlich. Setzen Sie OLLAMA_GPU_LAYERS=999, um maximale GPU-Auslagerung zu erzwingen.
Warum wird Port 11434 abgelehnt, wenn ich Ollama ausführe?
Port 11434 wird abgelehnt, wenn der Ollama-Server nicht läuft. Starten Sie ihn mit `ollama serve`, überprüfen Sie dann mit `curl http://localhost:11434` — die erwartete Antwort ist "Ollama is running". Unter Linux: systemd-Service neu starten mit `systemctl restart ollama`.
Warum läuft mein lokales LLM auf CPU statt GPU?
Ollama fällt auf CPU zurück, wenn GPU nicht erkannt wird oder VRAM unzureichend ist. Setzen Sie die Umgebungsvariable `OLLAMA_GPU_LAYERS=999` vor dem Start von Ollama, um maximale GPU-Auslagerung zu erzwingen. Überprüfen Sie zuerst die GPU-Sichtbarkeit mit `nvidia-smi`. Wenn VRAM für das gesamte Modell unzureichend ist, teilt Ollama automatisch Layer zwischen GPU und CPU auf.
Was sind die häufigsten Fehler bei lokaler LLM-Bereitstellung?
Die 11 häufigsten lokalen LLM-Fehler sind: (1) OOM/Speicher voll, (2) GPU nicht erkannt, (3) Port 11434 abgelehnt, (4) langsames CPU-Fallback, (5) Modell nicht gefunden, (6) partieller Download beschädigt, (7) Generierung stoppt vorzeitig, (8) CUDA-Versionsfehler, (9) Kontextlänge überschritten, (10) falsches Modell-Tag, (11) Client versucht, einen unerwarteten Remote-Host zu erreichen. Jeder Fehler hat einen spezifischen Fix-Befehl in Ollama und LM Studio.
Wie behebe ich einen beschädigten Ollama-Modell-Download?
Löschen Sie das gecachte Modell und laden Sie es neu: `ollama rm <modellname>` dann `ollama pull <modellname>`. Beschädigte Downloads entstehen durch unterbrochene Zugriffe. Ollama erkennt Teile-Downloads nicht immer automatisch.
Wie prüfe ich, ob Ollama meine GPU verwendet?
Führen Sie `ollama ps` aus, während ein Modell geladen ist — die Ausgabe zeigt, welche Layer auf GPU gegen CPU sind. Alternativ überwachen Sie die GPU-Auslastung mit `nvidia-smi -l 1` (aktualisiert jede Sekunde). Wenn die GPU-Auslastung bei 0% bleibt, läuft Ollama nur auf CPU — überprüfen Sie Treiberinstallation und CUDA-Kompatibilität.
Warum stoppt meine LLM-Generierung vorzeitig?
Vorzeitige Stopps werden normalerweise durch Stop-Tokens in der Modelfile verursacht. Überprüfen Sie die Systemaufforderung und Vorlage auf unerwartete Stopp-Sequenzen. Überprüfen Sie auch den `num_predict`-Parameter — wenn zu niedrig eingestellt, wird die Ausgabe bei dieser Token-Zahl abgeschnitten. Standard ist -1 (unbegrenzt).
Weiterführende Lektüre
- Wie führen Sie lokale LLMs auf einem Laptop aus — Wärmeverwaltung und Batterielebensdauer auf limitierter Hardware
- Lokale LLM-Sicherheits- und Datenschutz-Checkliste — Vollständige Audit-Anleitung
- Beste Anfänger-Lokale-LLM-Modelle — RAM-passende Modellempfehlungen
- LLM-Quantisierung erklärt — warum Q4_K_M Standard ist und Q3_K_M für extreme RAM-Einschränkungen
- Beste LLMs für Coding 2026 — Qwen3-Coder vs DeepSeek Benchmark-Vergleich
Wo finde ich mehr Hilfe
Für Hardware-spezifische Probleme auf Laptops (thermische Drosselung, Batterieabfluss), siehe Wie führen Sie lokale LLMs auf einem Laptop aus. Für Sicherheits- und Datenschutz-Konfigurationsfragen, siehe die Lokale LLM-Sicherheits- und Datenschutz-Checkliste. Die Ollama GitHub-Issues-Seite (github.com/ollama/ollama/issues) und das r/LocalLLaMA-Subreddit sind die aktivsten Community-Ressourcen für modellspezifische Bugs.
Häufige Fehler bei der Fehlersuche lokaler LLMs
- OOM-Fehler mit Hardware-Fehler verwechseln — der Fehler bedeutet, RAM ist zu klein für das Modell, nicht dass Hardware kaputt ist. Behebung: Q4_K_M-Quantisierung oder kleineres Modell verwenden.
- Systemlast nicht überprüfen — Inferenz-Geschwindigkeit verschlechtert sich erheblich, wenn andere Anwendungen CPU/GPU verbrauchen. Browser, Videoplayer und Hintergrundprozesse vor dem Benchmarking schließen.
- Treiberversions-Inkompatibilität ignorieren — NVIDIA CUDA erfordert spezifische Treiberversionen pro CUDA-Version. Überprüfen Sie `nvidia-smi`-Ausgabe; Treiberversion muss ≥450.80 für CUDA 11.x sein.
- Falschen Modellnamen in Ollama verwenden — `llama3.2` und `llama3.2:3b` sind unterschiedliche Ollama-Tags. Führen Sie `ollama list` aus, um exakte Namen heruntergeladener Modelle zu sehen.
- Ollama nach Treiberupdate nicht neu starten — Ollama erkennt GPU beim Start. Nach Update von NVIDIA oder ROCm-Treibern, starten Sie Ollama komplett neu (`ollama serve`), um die GPU erneut zu erkennen.

Quellen
- NVIDIA. (2024). "CUDA Toolkit Release Notes." docs.nvidia.com/cuda/cuda-toolkit-release-notes/ — Offizielle CUDA-Treiberversionsanforderungen pro Version.
- Ollama. (2026). "Ollama Troubleshooting." github.com/ollama/ollama/blob/main/docs/troubleshooting.md — Offizielle Ollama-Dokumentation für häufige Fehler.
- AMD. (2024). "ROCm Installation Guide." rocm.docs.amd.com/projects/install-on-linux/en/latest/ — Offizielle AMD ROCm-Installation und GPU-Unterstützung für Linux.