Wichtigste Erkenntnisse
- Qwen 3.6 27B ist das neue Flagship-Modell: dicht, Apache 2.0, 256K-Kontext, ~17 GB VRAM in Q4_K_M über `ollama run qwen3.6:27b` (veröffentlicht im April 2026).
- Qwen3 8B läuft mit 5,5 GB VRAM — ein einziger `ollama pull qwen2.5:7b`-Befehl genügt; auf einer RTX 3060 erreicht es 57 Tokens/Sek.
- Vier praktische Teilfamilien: Qwen3 (allgemein, Thinking-Mode), Qwen2.5 (allgemein, am besten getestet), Qwen2.5-Coder (Coding, 92,7 % HumanEval bei 32B), Qwen2-VL (Vision, bestes lokales CJK-OCR).
- Dense-Architektur = Consumer-freundlich: Anders als DeepSeeks 236B-MoE-Modell (~130 GB RAM) passt Qwen2.5-72B mit 46 GB VRAM auf zwei RTX 3090.
- Natives Mehrsprachigkeit: Vortrainiert auf Chinesisch, Japanisch, Koreanisch, Arabisch, Deutsch, Französisch und 23 weiteren Sprachen — Qwen3 übertrifft Llama 3.3 bei CJK-Aufgaben.
- Q4_K_M ist die richtige Quantisierung für die meisten Nutzer: ~55 % VRAM-Reduktion, weniger als 1 % Qualitätsverlust.
- Hardware-Entscheidung: 12 GB VRAM → 14B-Modell; 24 GB → 32B; 48 GB+ (zwei GPUs oder Apple Silicon 64 GB) → 72B.
📍 In einem Satz
Qwen3 umfasst drei lokale Deployment-Teilfamilien — Allgemein (7B–72B), Coding (Coder 7B–32B) und Vision (VL 7B–72B) — alle über Ollama oder LM Studio ausführbar.
💬 In einfachen Worten
Ein Modell lokal betreiben bedeutet, dass die KI auf dem eigenen Computer statt auf einem Cloud-Server läuft. Keine Daten verlassen die eigene Hardware, und nach der Anschaffung fallen keine Kosten pro Token an.
Qwen-Modellfamilie im Überblick
Die Qwen-Reihe umfasst inzwischen fünf praktische Optionen: das Flagship Qwen 3.6 27B, die neuere Qwen3-Familie, Qwen2.5 für allgemeines Reasoning, Qwen2.5-Coder und Qwen2-VL für Vision — jeweils in mehreren Größen. Alle sind Open-Weight-Modelle, die vom Qwen-Team bei Alibaba unter der Apache-2.0-Lizenz auf Hugging Face veröffentlicht wurden.
Wählen Sie zunächst die Teilfamilie, dann die Größe, die zum verfügbaren VRAM passt. Die Kombination von Teilfamilien ist üblich: Qwen2.5-Coder 14B für Code-Vervollständigung und Qwen3 8B oder Qwen 3.6 27B für Dokumentenzusammenfassung.
Teilfamilie | Verfügbare Größen | Hauptanwendung | Ollama-Tag-Präfix |
|---|---|---|---|
| Qwen3 | 0,6B, 1,7B, 4B, 8B, 14B, 32B | Allgemeines Reasoning, Thinking-Mode, mehrsprachig, agentische Aufgaben | qwen3: |
| Qwen2.5 | 7B, 14B, 32B, 72B | Allgemeines Reasoning, chinesisch/mehrsprachige Aufgaben, RAG | qwen2.5: |
| Qwen2.5-Coder | 7B, 14B, 32B | Code-Generierung, Debugging, HumanEval, SWE-bench | qwen2.5-coder: |
| Qwen2-VL | 2B, 7B, 72B | Dokument-OCR, Bild-Q&A, CJK-Textextraktion | qwen2-vl: |
Qwen 3.6 27B (veröffentlicht im April 2026) ist das neue Flagship-Modell — ein dichtes Modell mit 256K-Kontextfenster, das mit ~17 GB VRAM in Q4_K_M über `ollama run qwen3.6:27b` läuft. Qwen2.5 bleibt die am besten getestete Familie mit der breitesten Ollama- und GGUF-Abdeckung Mitte 2026. Siehe Beste lokale LLMs 2026 für einen umfassenderen Modellvergleich.
Hardware-Anforderungen nach Modellgröße
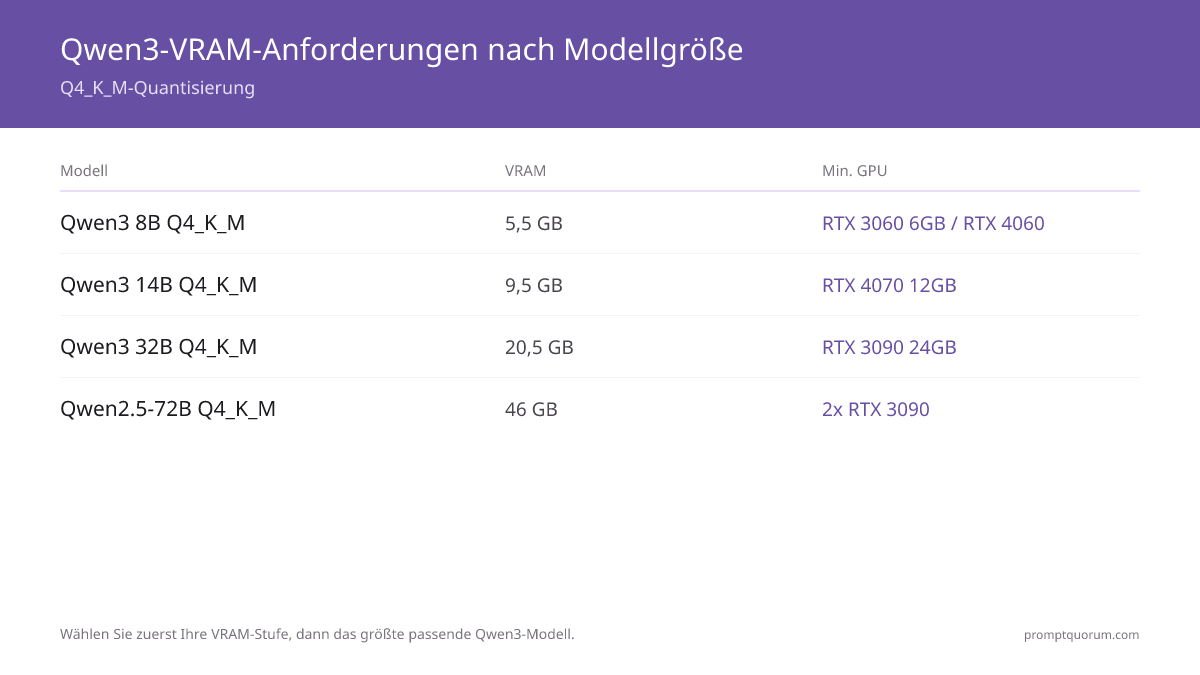
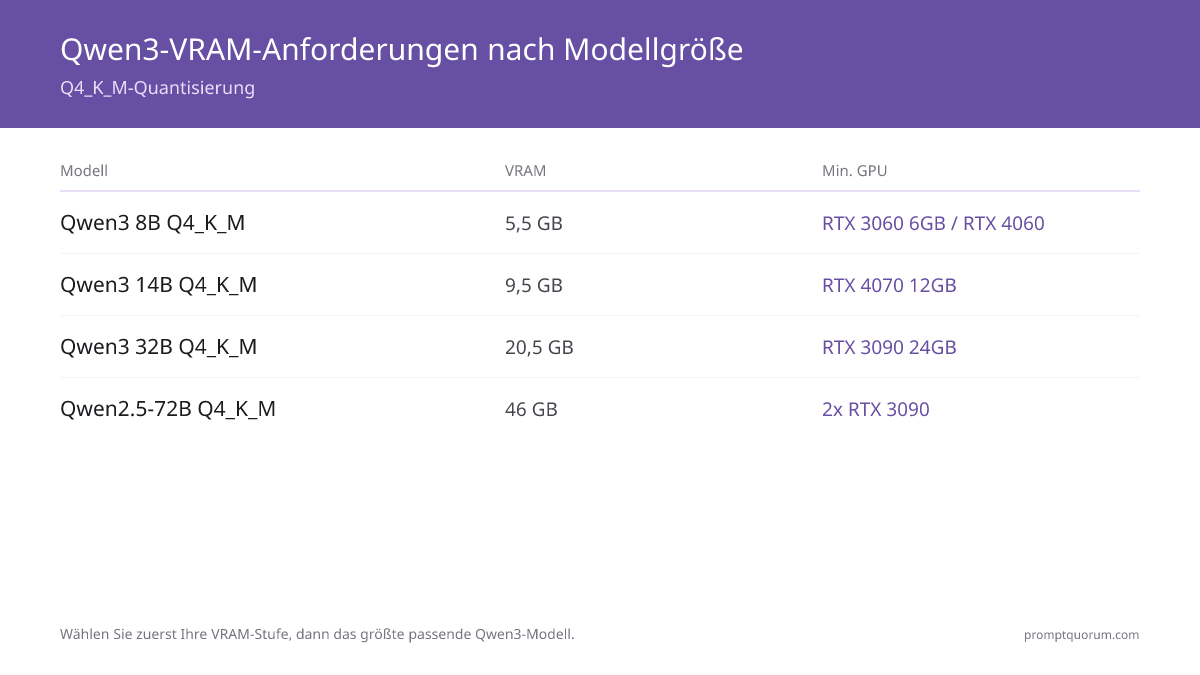
Wählen Sie zunächst Ihre VRAM-Stufe, dann das größte Qwen3-Modell, das hineinpasst. Q4_K_M ist die Standardquantisierung für alle unten aufgeführten Werte — sie bietet das beste Verhältnis von Größe zu Qualität für Ollama und LM Studio.
Modell | VRAM | Mindest-GPU | Apple Silicon | Geschwindigkeit (RTX 3060) |
|---|---|---|---|---|
| Qwen3 8B Q4_K_M | 5,5 GB | RTX 3060 6 GB, RTX 4060 | M1/M2 8 GB | ~57 Tokens/Sek. |
| Qwen2.5-Coder 7B Q4_K_M | 5,5 GB | RTX 3060 6 GB, RTX 4060 | M1/M2 8 GB | ~55 Tokens/Sek. |
| Qwen2-VL 7B Q4_K_M | 6,2 GB | RTX 3060 8 GB, RTX 4060 | M1/M2 16 GB | — |
| Qwen3 14B Q4_K_M | 9,5 GB | RTX 4070 12 GB | M2 Pro 16 GB | — |
| Qwen2.5-Coder 14B Q4_K_M | 9,5 GB | RTX 4070 12 GB | M2 Pro 16 GB | — |
| Qwen3 32B Q4_K_M | 20,5 GB | RTX 3090 24 GB | M3 Max 48 GB | — |
| Qwen2.5-Coder 32B Q4_K_M | 20,5 GB | RTX 3090 24 GB | M3 Max 48 GB | — |
| Qwen 3.6 27B Q4_K_M | ~17 GB | RTX 4090 24 GB | M3 Max 36 GB | — |
| Qwen2.5-72B Q4_K_M | 46 GB | 2× RTX 3090 (48 GB) | M2 Ultra 64 GB | — |
VRAM-Angaben gelten für Q4_K_M-GGUF-Dateien aus der Ollama-Bibliothek. Für den KV-Cache bei 4K-Kontext kommen 1–2 GB hinzu. Wenn die GPU weniger VRAM hat als das Modell benötigt, lagert Ollama automatisch Layer in den System-RAM aus — das funktioniert, reduziert aber die Geschwindigkeit erheblich.
💡Tipp: Ihre VRAM-Stufe steht fest? Sehen Sie sich an, welche GPU oder welchen Mac Sie für diese Stufe genau kaufen sollten — 6 GB → RTX 4060, 12 GB → RTX 4070 Super, 24 GB → RTX 3090/4090, 48 GB+ → Mac mini M5 Pro oder Dual-GPU.
Setup mit Ollama
Ollama ist der schnellste Weg, um ein beliebiges Qwen3-Modell lokal zu betreiben — es übernimmt den Modell-Download, die GGUF-Quantisierung und stellt eine lokale API unter `localhost:11434` bereit, ohne jegliche Konfiguration. Installation unter ollama.com. Falls Sie Ollama noch nicht kennen, lesen Sie zunächst Ollama installieren.
- 1Ollama installieren
Why it matters: Verfügbar für macOS, Linux (Ein-Zeilen-Installation) und Windows. Keine GPU-Treiber-Konfiguration erforderlich — Ollama erkennt CUDA, ROCm und Metal automatisch. - 2Modell mit explizitem Größen-Tag herunterladen
Why it matters: Immer die Größe angeben: `qwen2.5:7b`, `qwen2.5:14b`, `qwen2.5:32b`. Das ungetaggte `qwen2.5` löst standardmäßig das 7B-Modell auf, kann sich aber zwischen Ollama-Releases ändern. - 3Modell ausführen
Why it matters: `ollama run qwen2.5:7b` öffnet einen interaktiven Chat. Eingabe tippen und Enter drücken. Beenden mit `/bye`. - 4Kontextfenster bei Bedarf anpassen
Why it matters: Qwen3 unterstützt standardmäßig 32K-Kontext in Ollama. Für 128K-Kontext bei einem 7B-Modell: `ollama run qwen2.5:7b --num-ctx 131072`. Dies benötigt mehr VRAM. - 5API-Endpunkt testen
Why it matters: Ollama stellt eine OpenAI-kompatible API bereit. Anwendungen wie PromptQuorum, Continue.dev und Open WebUI verbinden sich direkt mit `http://localhost:11434/v1`.
# Ollama installieren (Linux)
curl -fsSL https://ollama.com/install.sh | sh

# macOS: .dmg von ollama.com herunterladen oder:
brew install ollama

# Modelle herunterladen — explizite Tags verwenden
ollama pull qwen3.6:27b          # Flagship, 256K-Kontext (~17 GB)
ollama pull qwen3:8b             # Qwen3 allgemein 8B (~5,5 GB)
ollama pull qwen2.5:7b           # Qwen2.5 allgemein 7B (~5,5 GB)
ollama pull qwen2.5:14b          # Qwen2.5 allgemein 14B (~9,5 GB)
ollama pull qwen2.5:32b          # Qwen2.5 allgemein 32B (~20,5 GB)
ollama pull qwen2.5-coder:32b    # Qwen2.5-Coder 32B (~20,5 GB)
ollama pull qwen2-vl:7b          # Vision 7B (~6,2 GB)

# Interaktiv ausführen
ollama run qwen2.5:7b

# OpenAI-kompatible API testen
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2.5:7b","messages":[{"role":"user","content":"Hallo"}]}'
Setup mit LM Studio
LM Studio bietet eine grafische Oberfläche für Qwen3 ohne Terminal-Befehle. Download unter lmstudio.ai oder siehe LM Studio installieren. Verfügbar für macOS, Windows und Linux.
- 1Modell-Browser öffnen
Why it matters: Nach „Qwen3" oder „Qwen Coder" suchen. Nach Q4_K_M filtern für das empfohlene Qualitäts/Größen-Verhältnis. - 2GGUF-Build herunterladen
Why it matters: Q4_K_M-Variante auswählen. LM Studio zeigt die Dateigröße vor dem Download an — bestätigen, dass sie zum verfügbaren VRAM passt. - 3Modell laden und Chat starten
Why it matters: Modell in der linken Sidebar anklicken, um es in den Speicher zu laden. GPU-Layer-Zuweisung erfolgt automatisch. - 4Lokalen Server starten
Why it matters: "Server starten" öffnet einen OpenAI-kompatiblen Endpunkt unter `localhost:1234`. Anwendungen und Skripte verbinden sich damit wie mit der OpenAI-API.
Quantisierung: Welches Format wählen?
Q4_K_M ist die richtige Standardwahl für Qwen3 auf Consumer-Hardware. Es reduziert den VRAM um ~55–60 % gegenüber FP16 bei weniger als 1 % Benchmark-Verlust auf MMLU und HumanEval. Andere Formate haben spezifische Anwendungsfälle:
📍 In einem Satz
Q4_K_M ist die beste Qwen3-Quantisierung für die meisten Nutzer: 55 % VRAM-Reduktion bei weniger als 1 % Qualitätsverlust gegenüber FP16.
💬 In einfachen Worten
Quantisierung komprimiert die Zahlen des Modells von 16-Bit auf 4-Bit, was die Dateigröße und den VRAM-Bedarf etwa halbiert. Vorstellbar wie TIFF-zu-JPEG: kleinere Datei, nahezu identisches Ergebnis für die meisten Anwendungsfälle.
- Q4_K_M (empfohlen): ~5,5 GB für 7B. Bestes Qualitäts-pro-GB-Verhältnis. Dieser Format sollte zuerst ausprobiert werden.
- Q8_0: ~8,5 GB für 7B. Nahezu FP16-Qualität; verwenden, wenn VRAM vorhanden ist und maximale Genauigkeit gewünscht wird.
- Q5_K_M: ~6,5 GB für 7B. Marginale Verbesserung gegenüber Q4_K_M — nur wählen, wenn Q4_K_M-Ausgabequalität für die Aufgabe sichtbar unzureichend ist.
- Q2_K: ~3 GB für 7B. Kleinste Datei, aber die chinesischsprachige Ausgabequalität verschlechtert sich spürbar — bei Qwen3 für chinesische Anwendungen vermeiden.
- IQ4_XS: ~4,8 GB für 7B. Neuere imatrix-Quantisierung mit besserer Qualität als Q4_K_M bei etwas kleinerer Größe — verfügbar in neueren llama.cpp-Versionen und LM Studio 0.3+.
Benchmark-Performance auf Consumer-Hardware
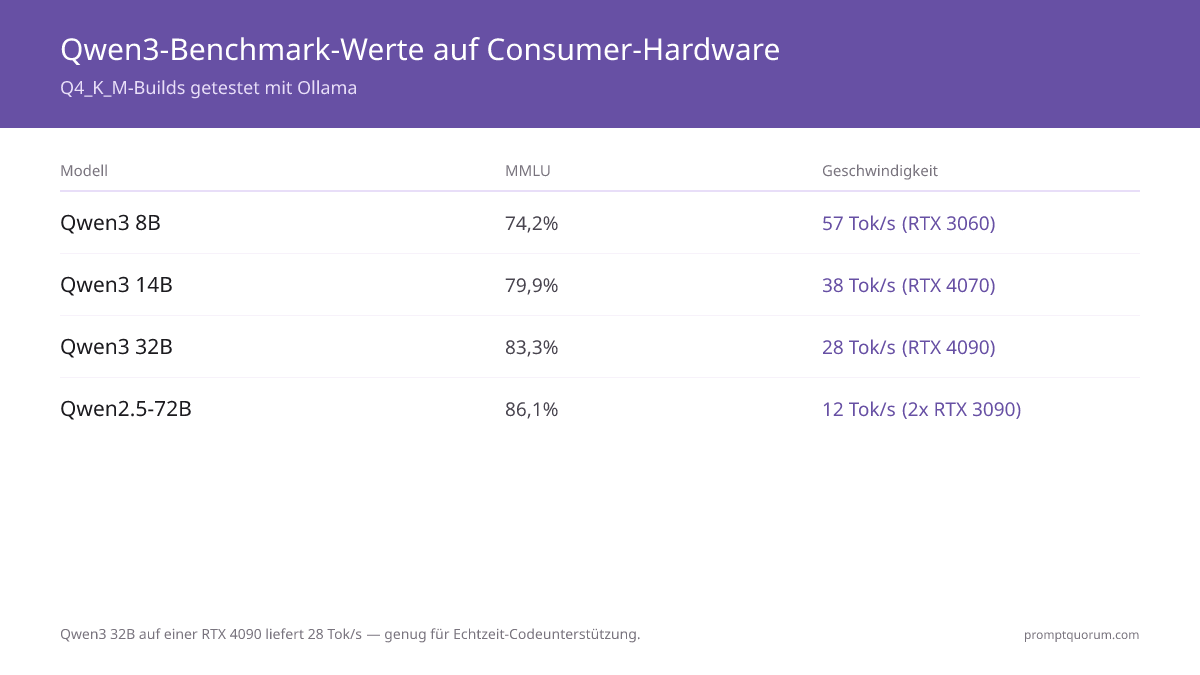
Qwen3 32B Q4_K_M auf einer RTX 4090 liefert 28 Tokens/Sek. — schnell genug für Echtzeit-Coding-Assistenz. Die unten aufgeführten Werte gelten für Q4_K_M-GGUF-Builds, getestet unter Ollama. Full-Precision-FP16-Werte sind um 1–2 % höher.
Modell (Q4_K_M) | MMLU | Math | HumanEval | Geschwindigkeit (RTX 3060 12 GB) |
|---|---|---|---|---|
| Qwen3 8B | 74,2 % | 58,8 % | 57,3 % | 57 Tokens/Sek. |
| Qwen3 14B | 79,9 % | 69,8 % | 64,6 % | — |
| Qwen3 32B | 83,3 % | 79,5 % | 71,3 % | — |
| Qwen2.5-72B | 86,1 % | 83,1 % | 73,2 % | — |
| Qwen2.5-Coder 7B | — | — | 75,6 % | 55 Tokens/Sek. |
| Qwen2.5-Coder 14B | — | — | 85,2 % | — |
| Qwen2.5-Coder 32B | — | — | 92,7 % | — |
💡Tipp: Sie möchten diesen HumanEval-Score von 92,7 % bei 27 Tokens/Sek.? Sehen Sie sich die 24-GB-GPU an, die Qwen2.5-Coder 32B ausführt.
Qwen vs. DeepSeek vs. Llama: Was lokal betreiben?
Qwen3 gewinnt bei chinesischsprachigen Aufgaben und VRAM-Effizienz; DeepSeek-V2.5 gewinnt beim Reasoning im großen Maßstab, ist aber auf Consumer-Hardware kaum praktikabel; Llama 3.3 70B ist die beste Einzel-GPU-Option, wenn Meta's offenes Modell bevorzugt wird. Die folgende Tabelle vergleicht die praktischen Optionen je VRAM-Stufe.
VRAM-Stufe | Bestes Qwen | Bester Konkurrent | Empfehlung |
|---|---|---|---|
| 6 GB | Qwen3 8B | Llama 3.2 3B (passt, aber nur 3B) | Qwen3 8B gewinnt — gleiches VRAM, viel größeres Modell |
| 12 GB | Qwen2.5-Coder 14B | Llama 3.1 8B Instruct | Qwen2.5-Coder 14B für Coding; Llama 3.1 8B für allgemeinen Chat |
| 24 GB | Qwen2.5-Coder 32B | Llama 3.3 70B (ausgelagert) | Qwen2.5-Coder 32B für Code; Llama 3.3 70B wenn Qualität > Geschwindigkeit |
| 48 GB+ | Qwen2.5-72B | DeepSeek-V2.5 236B MoE | DeepSeek benötigt ~130 GB RAM; Qwen2.5-72B ist die praktische 48-GB-Wahl |
Datensouveränität für deutsche und europäische Nutzer
Der lokale Betrieb von Qwen3 bedeutet, dass keine Daten das eigene Gerät verlassen — kein Cloud-API-Aufruf, kein Risiko unter der DSGVO oder dem deutschen IT-Sicherheitsrecht. Cloud-basierte LLM-APIs erfordern die Übermittlung von Prompts an externe Server im Ausland, was DSGVO Art. 28 (Auftragsverarbeitung) und ggf. Art. 44 ff. (Drittlandübermittlung) auslöst.
Qwen3 wurde vom Qwen-Team bei Alibaba auf einem überwiegend chinesisch- und mehrsprachigen Korpus trainiert. Es ist das stärkste lokal einsetzbare Modell für Vereinfachtes Chinesisch, Traditionelles Chinesisch und gemischtsprachige Dokumente (Chinesisch/Englisch/Deutsch).
Für Unternehmensdeployments im DACH-Raum: Ein luftgespaltenes Qwen3-Setup (keine Internetverbindung während der Inferenz) nutzt eine DSGVO-kompatible Architektur (keine Inferenzdaten an externe Anbieter). Das Modell läuft ausschließlich auf lokaler Hardware — kein Drittanbieter erhält Zugriff auf Eingabe- oder Ausgabedaten. Für BSI-Grundschutz-konforme Setups empfiehlt sich Baustein OPS.2.2 (Fremdsoftware). Vollständige Anleitung für luftgespaltene Setups: KI vollständig offline betreiben.
📍 In einem Satz
Qwen3 läuft nach dem Download vollständig offline — keine Daten verlassen Ihr Gerät, wodurch DSGVO-Risiken durch Drittlandübermittlung entfallen.
💬 In einfachen Worten
Beim lokalen Betrieb von Qwen3 verlassen Ihre Prompts und Dokumente niemals den eigenen Computer. Es gibt keinen Cloud-API-Aufruf, keinen externen Server und keine Daten, auf die Behörden oder Dritte zugreifen könnten.
Welche Hardware sollten Sie für Qwen3-Deployment kaufen?
Ordnen Sie zuerst Ihre Ziel-Qwen-Stufe dem passenden VRAM zu und kaufen Sie dann die günstigste Karte, die diese Anforderung erfüllt — mehr VRAM zu bezahlen, als Ihr Modell benötigt, ist der häufigste Fehlkauf auf dieser Liste. Die folgenden Empfehlungen entsprechen direkt der obigen Hardware-Tabelle: Einsteiger → RTX 4060, Mittelklasse → RTX 4070 Super, High-End → RTX 3090/4090, Apple Silicon → Mac mini M5 Pro, Dauerbetrieb → ein Mini-PC. Die Preise unten spiegeln den GPU-Markt 2026 wider — Speicherchip-Engpässe und die KI-Rechenzentrums-Nachfrage haben sowohl neue GPUs als auch Apple-Speicherkonfigurationen deutlich verteuert; prüfen Sie den aktuellen Preis vor dem Kauf.
💡Tipp: Überspringen Sie diesen Abschnitt, wenn Sie bereits eine GPU mit 8 GB+ VRAM besitzen — betreiben Sie zunächst Qwen3 8B auf vorhandener Hardware. Kaufen Sie erst neue Hardware, wenn Sie diese Grenze erreicht haben und ein größeres Modell möchten.
NVIDIA RTX 4060 8 GB
Einsteiger-Empfehlung — Qwen3 8B, Qwen2.5-Coder 7B (5,5 GB VRAM)
Die günstigste Karte auf dieser Liste, die die 5,5-GB-Anforderung von Qwen3 8B mit Spielraum für Kontext erfüllt. Führt Qwen2.5-Coder 7B mit ~55 Tokens/Sek. aus — schnell genug für interaktive Coding-Unterstützung.
Vorteile
- +Erfüllt die 5,5-GB-VRAM-Anforderung mit Puffer für langen Kontext-KV-Cache
- +Niedrigster Preis auf dieser Liste — die richtige erste GPU, wenn Sie noch nie ein lokales LLM betrieben haben
- +50–57 Tokens/Sek. bei 7B/8B-Modellen, gleichauf mit teureren Karten bei dieser Modellgröße
Nachteile
- –Deckelt bei Qwen3 8B / Qwen2.5-Coder 7B — kein Spielraum für 14B ohne KV-Cache-Engpass
NVIDIA RTX 4070 Super 12 GB
Mittelklasse-Empfehlung — Qwen3 14B, Qwen2.5-Coder 14B (9,5 GB VRAM)
Führt Qwen2.5-Coder 14B (85,2 % HumanEval) mit 36–38 Tokens/Sek. aus und lässt dabei noch 2–3 GB VRAM für Kontext übrig — die Stufe, auf der die Coding-Qualität spürbar über die 7B/8B-Modelle hinaus zunimmt.
Vorteile
- +Das 9,5-GB-Modell passt mit 2–3 GB VRAM-Puffer — Raum für längere Kontextfenster
- +HumanEval springt von 75,6 % (7B) auf 85,2 % (14B) — der klarste Preis-Leistungs-Sprung in der Reihe
- +~38 Tokens/Sek. halten interaktiven Chat und Code-Vervollständigung reaktionsschnell
Nachteile
- –Nicht genug VRAM für die 32B-Stufe — planen Sie den Verkauf oder eine Zweitnutzung, falls Sie über 14B hinauswachsen
NVIDIA RTX 4090 24 GB (oder gebrauchte RTX 3090 24 GB)
High-End-Empfehlung — Qwen2.5-Coder 32B, Qwen 3.6 27B (~17–20,5 GB VRAM)
Die 4090 liefert 27–28 Tokens/Sek. bei Qwen2.5-Coder 32B — Echtzeit-Coding-Geschwindigkeit bei 92,7 % HumanEval. Eine gebrauchte RTX 3090 hat dasselbe 24-GB-VRAM und liegt bei der Inferenzgeschwindigkeit rund 15 % hinter der 4090 — bei deutlich geringeren Kosten, sofern Sie ein vertrauenswürdiges Gebrauchtangebot finden.
Vorteile
- +24 GB VRAM deckt jede Qwen3-32B-Variante und Qwen 3.6 27B mit Spielraum ab
- +27–28 Tokens/Sek. bei Qwen2.5-Coder 32B (92,7 % HumanEval) — schnell genug für Echtzeit-Pair-Programming
- +Gebrauchte RTX 3090 ist die preiswerte Alternative: gleiche VRAM-Grenze, ~15 % langsamer, gebraucht deutlich günstiger
Nachteile
- –Höchste Anschaffungskosten auf dieser Liste — nur gerechtfertigt, wenn tatsächlich 32B-Qualität benötigt wird
Apple Mac mini M5 Pro 64 GB
Apple-Silicon-Empfehlung — Qwen3 32B, leise und stromsparend
Bester Wert für den Betrieb von Qwen3 32B mit Unified Memory — leise, geringer Stromverbrauch, keine separate GPU zu verbauen. Für Qwen2.5-72B benötigen Sie stattdessen den M2 Ultra 192 GB.
Vorteile
- +M5-Pro-Konfigurationen reichen bis zu 64 GB Unified Memory — deutlich über der 20,5-GB-Anforderung von Qwen3 32B, mit Spielraum für weitere Anwendungen
- +Lautloser Betrieb und schreibtischfreundlicher Stromverbrauch — kein separates GPU-Kühlmanagement nötig
- +Ein Kauf deckt Betriebssystem, Speicher und Inferenz ab — kein separater GPU/PSU/Gehäuse-Aufbau
Nachteile
- –Für den M5-Pro-Chip liegen noch keine unabhängigen Qwen3-32B-Benchmarks vor — rechnen Sie mit spürbar langsamerer Inferenz als bei einer dedizierten GPU wie der RTX 4090, vergleichbar mit früheren Apple-Silicon-Generationen im Mac mini
MINISFORUM UM890 Pro (oder ähnlicher AMD-Ryzen-AI-Mini-PC)
Dauerbetrieb-Empfehlung — Qwen3 8B auf CPU + iGPU (~8–12 Tokens/Sek., unter 35 W)
Nicht für interaktive Nutzung gedacht — geeignet für eine Qwen3-8B-Instanz, die Sie rund um die Uhr für Hintergrundaufgaben, Hausautomation oder einen wenig frequentierten API-Endpunkt laufen lassen, bei dem Stromkosten wichtiger sind als Geschwindigkeit.
Vorteile
- +Stromverbrauch unter 35 W — günstig im Dauerbetrieb, anders als ein Desktop-GPU-Aufbau
- +Kleiner Formfaktor passt überallhin; keine separate GPU zu beschaffen oder zu kühlen
- +Bewältigt Qwen3 8B ganz ohne dedizierte GPU
Nachteile
- –8–12 Tokens/Sek. sind für interaktiven Chat zu langsam — geeignet nur für Hintergrund-/API-Nutzung
Häufige Fehler beim lokalen Betrieb von Qwen3
- Ungetaggter `ollama pull qwen2.5`-Befehl verwenden. Ohne expliziten Größen-Tag (`:7b`, `:14b` usw.) kann Ollama eine Standardgröße auflösen, die sich zwischen Library-Updates ändert. Immer explizite Tags verwenden: `ollama pull qwen2.5:14b`.
- Kontextfenstergröße ignorieren. Qwen3 unterstützt 128K-Kontext. Die Modelfile-Spezifikation von Ollama setzt `num_ctx` standardmäßig auf 2048, doch die Laufzeitumgebung wählt tatsächlich einen VRAM-gestaffelten Standardwert: 4K unter 24 GiB, 32K zwischen 24 und 48 GiB, 256K über 48 GiB. Verlassen Sie sich auf keinen der beiden Standardwerte: Legen Sie `num_ctx` explizit fest, zum Beispiel mit `--num-ctx 8192` (oder höher) im Run-Befehl — andernfalls kürzt das Modell die Eingabe stillschweigend.
- Q2_K-Quantisierung für chinesischsprachige Nutzung wählen. Bei 2-Bit-Präzision verschlechtert sich Qwen3's chinesische Ausgabe spürbar. Q4_K_M als Minimum für jede chinesischsprachige Arbeit verwenden.
- 32B-Modell mit zu wenig VRAM ausführen. Wenn die GPU 16 GB hat und das Modell 20,5 GB benötigt, lagert Ollama Layer in den System-RAM aus. Das Modell läuft, aber mit 3–5 Tokens/Sek. — für interaktive Nutzung unbrauchbar.
- Falsche Teilfamilie für Coding verwenden. Qwen3 8B (allgemein) erreicht 57,3 % auf HumanEval. Qwen2.5-Coder 7B erreicht 75,6 % auf demselben Benchmark — eine 32 %ige relative Verbesserung. Für Coding immer die Coder-Variante gleicher Größe verwenden.
Nächste Schritte
- Beste CPU-Only-LLMs — Keine GPU? Welche Qwen3-Größen laufen rein auf CPU →
- LLM-Quantisierung erklärt — Q4_K_M vs. Q8 unklar? Quantisierung erklärt →
Häufig gestellte Fragen
Was ist mit Qwen 3.7 oder Qwen 3.8?
Neue Qwen-Versionen erscheinen in kurzen Abständen, und die Tags in der Ollama-Bibliothek ändern sich entsprechend. Dieser Leitfaden beschreibt die Varianten, die zum Redaktionsschluss stabile Ollama-Tags hatten — allen voran Qwen 3.6 27B. Suchen Sie nach einer höheren Versionsnummer, prüfen Sie die aktuelle Tag-Liste auf ollama.com/library oder mit `ollama list`, statt sich auf eine Nummer aus einem Artikel zu verlassen. Wichtig für die Planung: Der Hardware-Bedarf hängt an der Parameterzahl, nicht an der Versionsnummer — was hier für ein 27B-Modell in Q4_K_M steht (~17 GB VRAM), gilt ebenso für ein neueres Modell derselben Größenklasse.
Wie viel VRAM braucht Qwen 3.6 27B?
Rund 17 GB in Q4_K_M-Quantisierung. Damit passt das Modell auf eine Karte mit 24 GB VRAM wie die RTX 4090 oder RTX 3090, mit Spielraum für den 256K-Kontext. Auf 16 GB wird es sehr eng, sobald der Kontext wächst. Wer nur 12 GB hat, greift besser zu einer kleineren Variante der Qwen-Familie statt zum 27B-Modell.
Welcher Ollama-Befehl lädt Qwen 3.6 27B?
`ollama run qwen3.6:27b` lädt das Modell beim ersten Aufruf herunter und startet es direkt. Ollama verwendet standardmäßig eine Q4_K_M-Quantisierung, was hier den ~17 GB VRAM entspricht. Soll das Modell nur geladen, aber noch nicht gestartet werden, nutzen Sie `ollama pull qwen3.6:27b`.
Läuft Qwen 3.6 27B auf 12 GB VRAM?
Nicht sinnvoll. Mit ~17 GB Bedarf in Q4_K_M passt das Modell nicht vollständig auf eine 12-GB-Karte; ein Teil müsste in den System-RAM ausgelagert werden, was die Geschwindigkeit stark einbrechen lässt. Auf 12 GB VRAM fahren Sie mit einem kleineren Qwen-Modell deutlich besser — dort bleibt auch Platz für einen längeren Kontext.
Wie viel VRAM benötige ich für Qwen3 8B lokal?
Qwen3 8B Q4_K_M benötigt 5,5 GB VRAM. Eine RTX 3060 6 GB, RTX 4060 oder ein Apple-M-Chip mit 8 GB Unified Memory reichen aus.
Welches Qwen-Modell eignet sich am besten für Coding lokal?
Qwen2.5-Coder 32B ist das beste lokal ausführbare Coding-Modell — 92,7 % auf HumanEval, benötigt 24 GB GPU. Bei 12 GB VRAM: Qwen2.5-Coder 14B (85,2 %, 9,5 GB VRAM).
Wie schneidet Qwen im Vergleich zu DeepSeek ab?
Qwen3 nutzt Dense-Architektur, die auf Consumer-Hardware passt. DeepSeek-V2.5 ist ein 236B-MoE-Modell und benötigt ~130 GB RAM — ohne Server-GPU nicht praktikabel.
Kann ich Qwen auf einem Mac betreiben?
Ja. M2 Pro 32 GB führt Qwen3 14B mit ~32 Tokens/Sek. aus. M3 Max 64 GB bewältigt Qwen3 32B mit ~22 Tokens/Sek.
Welchen Ollama-Befehl verwende ich für Qwen?
Für das Flagship-Modell: `ollama run qwen3.6:27b` (~17 GB VRAM). Für Qwen3: `ollama pull qwen3:8b`. Für Qwen2.5: `ollama pull qwen2.5:7b` für 7B, `:14b` für 14B, `:32b` für 32B oder `qwen2.5-coder:32b` für die Coding-Variante. Immer explizite Größen-Tags verwenden.
Ist Qwen für chinesischsprachige Aufgaben geeignet?
Ja. Qwen3 wurde auf einem umfangreichen chinesischen Korpus vortrainiert und unterstützt nativ Vereinfachtes Chinesisch, Traditionelles Chinesisch, Japanisch, Koreanisch und 24 weitere Sprachen.
Welche Quantisierung sollte ich für Qwen3 verwenden?
Q4_K_M ist die empfohlene Standardwahl — ~55 % VRAM-Reduktion bei weniger als 1 % Qualitätsverlust. Q8_0 für nahezu FP16-Qualität. Q2_K bei chinesischsprachigen Anwendungen vermeiden.
Funktioniert Qwen2-VL für chinesisches Dokument-OCR?
Ja — Qwen2-VL 7B ist das stärkste lokale Vision-Modell für CJK-OCR. Es läuft mit ~6 GB VRAM via `ollama pull qwen2-vl:7b` und liest bis zu 4096×4096 Pixel.
Muss ich bei der Verwendung von Qwen3 die DSGVO beachten?
Beim lokalen Betrieb verlassen keine Daten den eigenen Server — kein AVV nach DSGVO Art. 28 erforderlich, da kein Drittanbieter Datenzugriff hat. BSI-Grundschutz-konform mit Baustein OPS.2.2.
Ist Qwen3 für den deutschen Mittelstand geeignet?
Ja. Qwen3 14B oder 32B lässt sich auf einem lokalen Server betreiben ohne externe Datenübermittlung — geeignet für datenschutzkritische Branchen wie Recht, Medizin und Finanzen im DACH-Raum.