关键要点
- Qwen 3.6 27B是新旗舰:密集模型,Apache 2.0,256K上下文,Q4_K_M约17GB显存,`ollama run qwen3.6:27b`(2026年4月发布)。
- Qwen3 8B仅需5.5GB显存——执行`ollama pull qwen2.5:7b`即可启动,RTX 3060上达到57 token/秒。
- 四个实用子系列:Qwen3(通用,思考模式)、Qwen2.5(通用,验证最充分)、Qwen2.5-Coder(代码,32B达HumanEval 92.7%)、Qwen2-VL(视觉,本地CJK OCR最强)。
- Dense架构=消费级友好:与DeepSeek 236B MoE(需约130GB内存)不同,Qwen2.5-72B仅需46GB显存,两块RTX 3090即可运行。
- 原生多语言:在中文、日语、韩语、阿拉伯语、德语、法语等29种语言上预训练,CJK任务持续超越Llama 3.3。
- Q4_K_M是正确的量化选择:对大多数用户而言减少约55%显存,质量损失不足1%。
- 硬件决策:12GB显存→14B模型;24GB→32B;48GB+(双卡或Apple Silicon 64GB)→72B。
📍 简单一句话
Qwen 3.6 27B(256K上下文,Q4_K_M约17GB)是新旗舰。Qwen覆盖四个本地部署子系列——通用(7B–72B)、代码(Coder 7B–32B)和视觉(VL 7B–72B),均可通过Ollama或LM Studio运行。
💬 简单来说
本地运行模型意味着AI在你自己的电脑上运行,而非云端服务器。数据不离开本机,购买硬件后也无需按token付费。
Qwen模型家族概览
Qwen产品线现在涵盖五个实用选择:旗舰Qwen 3.6 27B、更新的Qwen3家族、通用推理的Qwen2.5、Qwen2.5-Coder,以及视觉领域的Qwen2-VL——每类均有多种规格。所有模型均为阿里巴巴Qwen团队以Apache 2.0许可证发布的开放权重模型。
先选择子系列,再选择适合显存的规格。混合使用子系列很常见:代码补全用Qwen2.5-Coder 14B,文档摘要用Qwen3 8B或Qwen 3.6 27B。
子系列 | 可用规格 | 主要用途 | Ollama标签前缀 |
|---|---|---|---|
| Qwen3 | 0.6B, 1.7B, 4B, 8B, 14B, 32B | 通用推理、思考模式、多语言、智能体任务 | qwen3: |
| Qwen2.5 | 7B, 14B, 32B, 72B | 通用推理、中文/多语言任务、RAG | qwen2.5: |
| Qwen2.5-Coder | 7B, 14B, 32B | 代码生成、调试、HumanEval、SWE-bench | qwen2.5-coder: |
| Qwen2-VL | 2B, 7B, 72B | 文档OCR、图像问答、CJK文字提取 | qwen2-vl: |
Qwen 3.6 27B(2026年4月发布)是新旗舰——拥有256K上下文窗口的密集模型,通过`ollama run qwen3.6:27b`在Q4_K_M量化下约17GB显存即可运行。截至2026年中,Qwen2.5仍是验证最充分的家族,拥有最广泛的Ollama和GGUF支持。
各模型尺寸的硬件要求
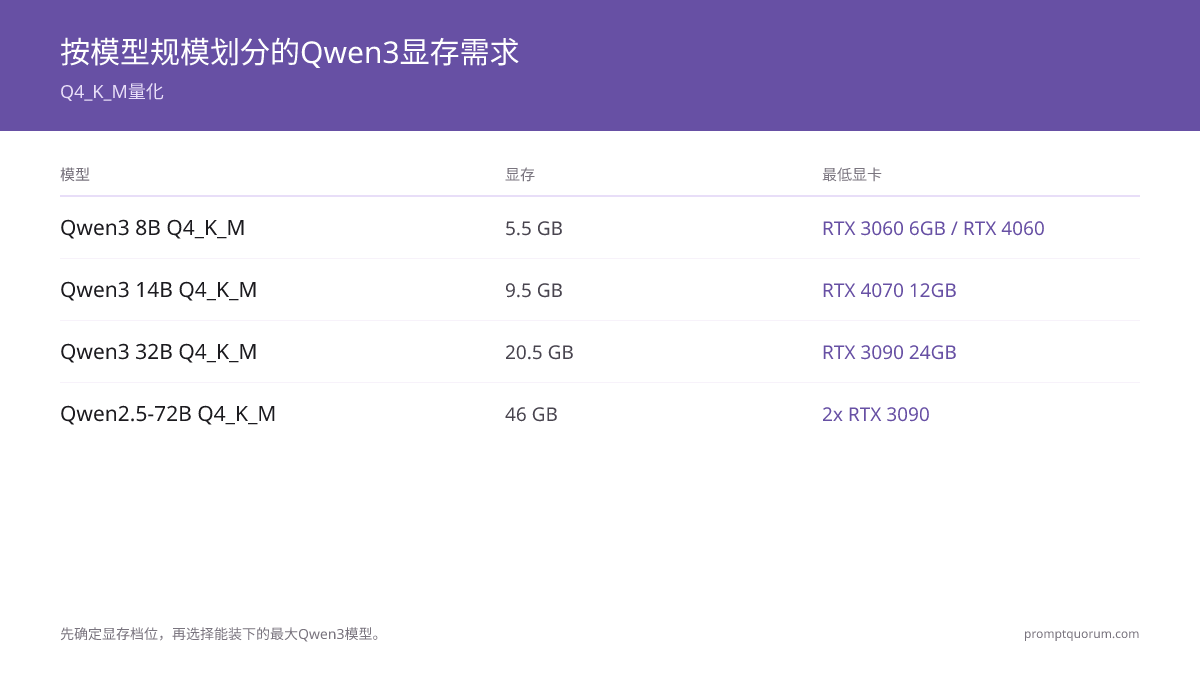
先确定显存档位,再选择可以装入的最大Qwen3模型。 以下所有数值均基于Q4_K_M量化——这是Ollama和LM Studio的最佳尺寸/质量比格式。
模型 | 显存 | 最低GPU | Apple Silicon | 速度(RTX 3060) |
|---|---|---|---|---|
| Qwen3 8B Q4_K_M | 5.5GB | RTX 3060 6GB、RTX 4060 | M1/M2 8GB | 约57 token/秒 |
| Qwen2.5-Coder 7B Q4_K_M | 5.5GB | RTX 3060 6GB、RTX 4060 | M1/M2 8GB | 约55 token/秒 |
| Qwen2-VL 7B Q4_K_M | 6.2GB | RTX 3060 8GB、RTX 4060 | M1/M2 16GB | — |
| Qwen2.5 14B Q4_K_M | 9.5GB | RTX 4070 12GB | M2 Pro 16GB | — |
| Qwen2.5-Coder 14B Q4_K_M | 9.5GB | RTX 4070 12GB | M2 Pro 16GB | — |
| Qwen2.5 32B Q4_K_M | 20.5GB | RTX 3090 24GB | M3 Max 48GB | — |
| Qwen2.5-Coder 32B Q4_K_M | 20.5GB | RTX 3090 24GB | M3 Max 48GB | — |
| Qwen 3.6 27B Q4_K_M | 约17GB | RTX 4090 24GB | M3 Max 36GB | — |
| Qwen2.5-72B Q4_K_M | 46GB | 2× RTX 3090(48GB合计) | M2 Ultra 64GB | — |
显存数值适用于Ollama库中的Q4_K_M GGUF文件。4K上下文的KV缓存需额外增加1–2GB。若GPU显存不足,Ollama会自动将层卸载到系统内存——可以运行但速度会大幅降低。
💡提示: 已经确定自己的显存档位了?查看该档位对应的确切GPU或Mac购买建议——6GB → RTX 4060,12GB → RTX 4070 Super,24GB → RTX 3090/4090,48GB以上 → Mac mini M5 Pro或双卡方案。
Ollama部署方法
Ollama是本地运行任何Qwen3模型的最快方式——自动处理模型下载、GGUF量化,并在`localhost:11434`提供本地API,无需任何配置。从ollama.com安装。Ollama新手请先阅读如何安装Ollama。
- 1安装Ollama
Why it matters: 支持macOS、Linux(一行安装命令)和Windows。无需配置GPU驱动——Ollama自动检测CUDA、ROCm和Metal。 - 2使用明确的尺寸标签拉取模型
Why it matters: 始终指定尺寸:`qwen2.5:7b`、`qwen2.5:14b`、`qwen2.5:32b`。无标签的`qwen2.5`默认解析为7B,但可能随Ollama版本变化。 - 3运行模型
Why it matters: `ollama run qwen2.5:7b`打开交互式对话。输入提示词后按Enter。输入`/bye`退出。 - 4按需设置上下文窗口
Why it matters: Qwen3在Ollama中默认支持32K上下文。使用128K上下文:`ollama run qwen2.5:7b --num-ctx 131072`,但需要更多显存。 - 5测试API端点
Why it matters: Ollama提供OpenAI兼容API。PromptQuorum、Continue.dev和Open WebUI等应用可直接连接`http://localhost:11434/v1`。
# 安装Ollama(Linux)
curl -fsSL https://ollama.com/install.sh | sh

# macOS:从ollama.com下载.dmg,或:
brew install ollama

# 拉取模型 — 使用明确的标签
ollama pull qwen3.6:27b          # 旗舰模型,256K上下文(约17GB)
ollama pull qwen3:8b             # Qwen3通用8B(约5.5GB)
ollama pull qwen2.5:7b           # Qwen2.5通用7B(约5.5GB)
ollama pull qwen2.5:14b          # Qwen2.5通用14B(约9.5GB)
ollama pull qwen2.5:32b          # Qwen2.5通用32B(约20.5GB)
ollama pull qwen2.5-coder:32b    # Qwen2.5-Coder 32B(约20.5GB)
ollama pull qwen2-vl:7b          # 视觉7B(约6.2GB)

# 交互式运行
ollama run qwen2.5:7b

# 测试OpenAI兼容API
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2.5:7b","messages":[{"role":"user","content":"你好"}]}'
LM Studio部署方法
LM Studio提供无需命令行的图形界面运行Qwen3。 从lmstudio.ai下载,或参阅如何安装LM Studio。支持macOS、Windows和Linux。
- 1打开模型浏览器
Why it matters: 搜索"Qwen3"或"Qwen Coder"。按Q4_K_M筛选以获得推荐的质量/尺寸比例。 - 2下载GGUF构建版本
Why it matters: 选择Q4_K_M变体。LM Studio在下载前显示文件大小——确认与可用显存匹配。 - 3加载模型并开始对话
Why it matters: 点击左侧边栏中的模型将其加载到内存。GPU层分配自动完成。 - 4启动本地服务器
Why it matters: "启动服务器"在`localhost:1234`开放OpenAI兼容端点。应用和脚本可像使用OpenAI API一样连接。
量化:如何选择格式
Q4_K_M是Qwen3在消费级硬件上的最佳默认选择。 相比FP16减少约55–60%显存,MMLU和HumanEval的性能损失不足1%。
📍 简单一句话
Q4_K_M是大多数用户的最佳Qwen3量化选择:相比FP16减少55%显存,质量损失不足1%。
💬 简单来说
量化将模型的数值从16位压缩到4位,大约将文件大小和显存需求减半。就像从TIFF转换为高质量JPEG——文件更小,但大多数用途的效果几乎相同。
- Q4_K_M(推荐):7B约5.5GB。最佳质量/GB比。优先选择此格式。
- Q8_0:7B约8.5GB。接近FP16质量;显存充足且需要最高精度时使用。
- Q5_K_M:7B约6.5GB。相比Q4_K_M质量略有提升——仅在Q4_K_M输出质量明显不足时选用。
- Q2_K:7B约3GB。文件最小,但中文输出质量明显下降——中文用途请避免使用Qwen3的Q2_K。
- IQ4_XS:7B约4.8GB。比Q4_K_M质量更高且体积略小的新型imatrix量化——在最新llama.cpp版本和LM Studio 0.3+中可用。
消费级硬件基准测试性能
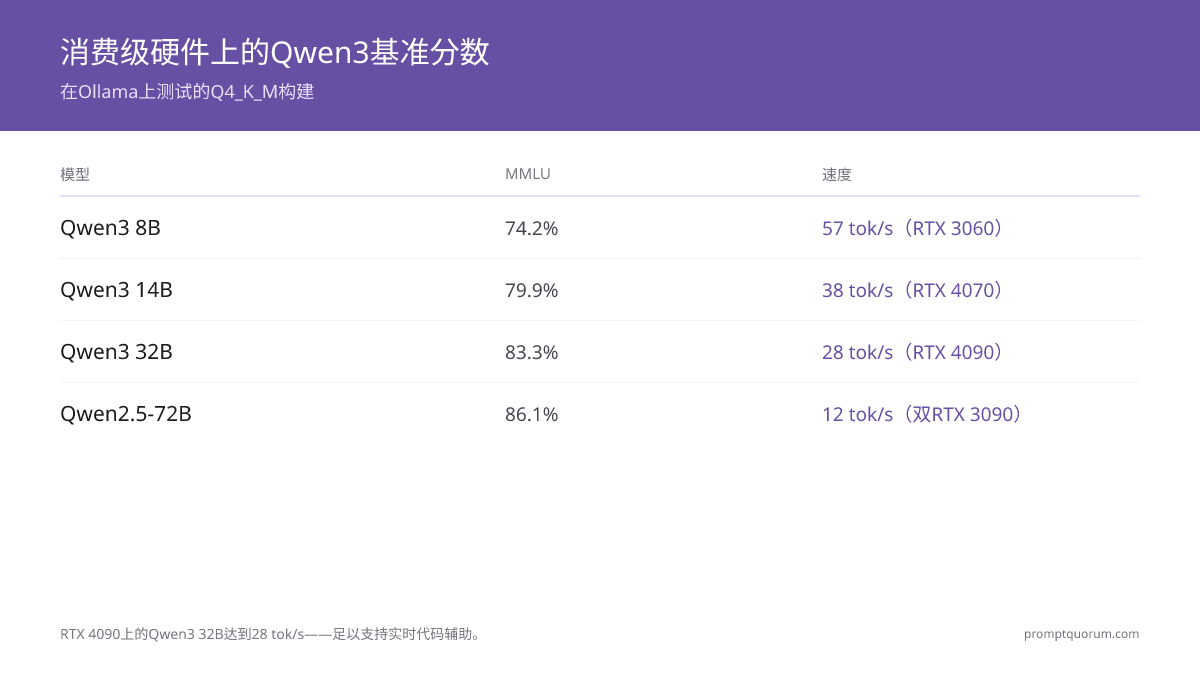
RTX 4090上的Qwen3 32B Q4_K_M达到28 token/秒——完全满足实时代码辅助需求。以下评分适用于Ollama测试的Q4_K_M GGUF构建版本。
模型(Q4_K_M) | MMLU | Math | HumanEval | 速度(RTX 3060 12GB) |
|---|---|---|---|---|
| Qwen3 8B | 74.2% | 58.8% | 57.3% | 57 token/秒 |
| Qwen3 14B | 79.9% | 69.8% | 64.6% | — |
| Qwen3 32B | 83.3% | 79.5% | 71.3% | — |
| Qwen2.5-72B | 86.1% | 83.1% | 73.2% | — |
| Qwen2.5-Coder 7B | — | — | 75.6% | 55 token/秒 |
| Qwen2.5-Coder 14B | — | — | 85.2% | — |
| Qwen2.5-Coder 32B | — | — | 92.7% | — |
💡提示: 想要以27 token/秒的速度获得92.7%的HumanEval评分?查看运行Qwen2.5-Coder 32B所需的24GB显存GPU。
Qwen vs DeepSeek vs Llama:本地应该运行哪个
Qwen3在中文任务和显存效率上胜出;DeepSeek-V2.5在大规模推理上胜出但在消费级硬件上不实用;Llama 3.3 70B是偏好Meta开放模型时的最佳单卡选择。
显存档位 | 最佳Qwen | 最佳竞品 | 建议 |
|---|---|---|---|
| 6GB | Qwen3 8B | Llama 3.2 3B(可装入但仅3B) | Qwen3 8B胜出——相同显存,更大模型 |
| 12GB | Qwen2.5-Coder 14B | Llama 3.1 8B Instruct | 代码用Qwen2.5-Coder 14B;通用对话用Llama 3.1 8B |
| 24GB | Qwen2.5-Coder 32B | Llama 3.3 70B(卸载) | 代码用Qwen2.5-Coder 32B;质量优先于速度则选Llama 3.3 70B |
| 48GB+ | Qwen2.5-72B | DeepSeek-V2.5 236B MoE | DeepSeek需约130GB内存;Qwen2.5-72B是48GB的实际可行选择 |
中国用户:数据安全合规与本地部署
本地运行Qwen3意味着数据完全不离开本地服务器——无需跨境传输,符合《数据安全法》(DSL)第31条和《网络安全法》的相关规定。 基于云端的LLM API需要将提示词发送至境外服务器,可能触发DSL的数据出境安全评估要求。
Qwen3由阿里巴巴Qwen团队在大规模中文及多语言语料库上训练,是简体中文、繁体中文及中英混合文档本地部署的最强选择。在中文阅读理解和文本生成任务上,持续优于Llama 3.3和Mistral。
受监管行业(金融、医疗、法律)的企业部署方案:完全离线的Qwen3部署(推理时无互联网连接)是最稳健的合规选择,符合国家互联网信息办公室(CAC)关于生成式AI服务的管理规定。模型完全在本地算力上运行——监管关注点在于训练数据和输出内容审核,而非在离线硬件上进行的推理过程。亚太地区数据跨境:中国、韩国、新加坡、澳大利亚均已建立数据本地化框架,本地LLM推理可消除跨境传输风险。金融/医疗/法律企业方案:大型银行、医院、律所如需在内网处理敏感数据,搭配防火墙内Qwen3即可满足内部AI合规要求。完整的离线部署指南请参阅完全离线运行AI。
📍 简单一句话
Qwen3下载后可完全离线运行——数据不离开本机,消除了《数据安全法》下的跨境数据传输风险。
💬 简单来说
本地运行Qwen3时,您的提示词和文档永远不会离开您的电脑。没有云API调用,没有境外服务器,也没有监管机构或第三方可以访问的数据。
部署Qwen3应该买哪款硬件?
先根据目标Qwen档位确定所需显存,再购买能满足该需求的最便宜显卡——为超出模型实际需求的显存多花钱,是这份清单里最常见的超支。 以下推荐与上方硬件表格一一对应:入门级 → RTX 4060,中端 → RTX 4070 Super,高端 → RTX 3090/4090,Apple Silicon → Mac mini M5 Pro,全天候方案 → mini PC。以下价格反映2026年显卡市场行情——显存芯片短缺和AI数据中心需求推高了新显卡及Apple内存配置的价格,购买前请核实当前实际报价。
💡提示: 如果你已经拥有一块显存8GB以上的显卡,可以跳过这一节——先在现有硬件上运行Qwen3 8B。只有触及这一上限、需要更大模型时,再考虑购买新硬件。
NVIDIA RTX 4060 8GB
入门级选择——Qwen3 8B、Qwen2.5-Coder 7B(5.5GB显存)
这是清单中能满足Qwen3 8B 5.5GB显存需求、同时仍留有上下文余量的最便宜显卡。运行Qwen2.5-Coder 7B可达约55 token/秒——足以支持交互式编码辅助。
优点
- +5.5GB显存需求可轻松满足,还留有长上下文KV缓存的余量
- +清单中价格最低——如果你从未运行过本地LLM,这是合适的第一块显卡
- +在7B/8B模型上达到50–57 token/秒,与该模型规模下更贵的显卡表现相当
缺点
- –上限为Qwen3 8B/Qwen2.5-Coder 7B——若不压缩KV缓存,无法升级到14B
NVIDIA RTX 4070 Super 12GB
中端选择——Qwen3 14B、Qwen2.5-Coder 14B(9.5GB显存)
以36–38 token/秒运行Qwen2.5-Coder 14B(HumanEval 85.2%),还留有2–3GB显存用于上下文——这是编码质量相比7B/8B模型明显跃升的档位。
优点
- +9.5GB模型可运行,还留有2–3GB显存余量——可支持更长的上下文窗口
- +HumanEval从75.6%(7B)跃升至85.2%(14B)——整条产品线中性价比提升最明显的一档
- +约38 token/秒的速度保证交互式对话和代码补全的流畅响应
缺点
- –显存不足以支撑32B档位——若需求超出14B,需考虑转售或另作他用
NVIDIA RTX 4090 24GB(或二手RTX 3090 24GB)
高端选择——Qwen2.5-Coder 32B、Qwen 3.6 27B(约17–20.5GB显存)
4090在Qwen2.5-Coder 32B上可达27–28 token/秒——以92.7%的HumanEval评分实现实时编码速度。二手RTX 3090同样拥有24GB显存,推理速度约为4090的85%左右,如果能找到可信赖的二手卖家,价格会明显更低。
优点
- +24GB显存可覆盖所有Qwen3 32B变体和Qwen 3.6 27B,还留有余量
- +在Qwen2.5-Coder 32B(HumanEval 92.7%)上达到27–28 token/秒——足以支持实时结对编程
- +二手RTX 3090是高性价比替代方案:显存上限相同,速度约慢15%,但二手价格明显更低
缺点
- –清单中前期成本最高——只有在确实需要32B级别的质量时才值得
Apple Mac mini M5 Pro 64GB
Apple Silicon选择——Qwen3 32B,安静低功耗
在统一内存架构上运行Qwen3 32B性价比最高的选择——安静、低功耗、无需另装显卡。若要运行Qwen2.5-72B,则需要改用M2 Ultra 192GB。
优点
- +M5 Pro配置最高可达64GB统一内存——远超Qwen3 32B所需的20.5GB显存,还能为其他应用留出空间
- +静音运行,功耗适合日常桌面使用——无需额外的显卡散热管理
- +一次性购买即可涵盖系统、存储和推理——无需单独组装GPU/电源/机箱
缺点
- –M5 Pro芯片上运行Qwen3 32B目前尚无独立基准测试数据——预计性能会明显慢于RTX 4090等独立显卡,这与此前几代Mac mini上的Apple Silicon表现一致
MINISFORUM UM890 Pro(或同类AMD Ryzen AI mini PC)
全天候选择——CPU+核显运行Qwen3 8B(约8–12 token/秒,功耗低于35W)
不适合交互式使用——适合用于7×24小时挂机运行Qwen3 8B实例,处理后台任务、家庭自动化,或对功耗成本比速度更敏感的低流量API端点。
优点
- +功耗低于35W——相比桌面显卡装机,长时间运行成本更低
- +体积小巧,几乎能放在任何地方;无需单独配置或散热的独立显卡
- +无需独立显卡即可运行Qwen3 8B
缺点
- –8–12 token/秒的速度太慢,不适合交互式对话——仅适合后台/API场景
常见错误
- 使用无标签的`ollama pull qwen2.5`命令。 没有明确的尺寸标签(`:7b`、`:14b`等),Ollama可能解析到随版本更新变化的默认尺寸。始终使用明确标签:`ollama pull qwen2.5:14b`。
- 忽略上下文窗口大小。 Qwen3支持128K上下文。Ollama的Modelfile规范将`num_ctx`默认设为2048,但实际运行时会根据显存大小分级采用不同默认值:低于24 GiB为4K,24-48 GiB为32K,超过48 GiB为256K。不要依赖这两种默认值中的任何一个,应显式设置`num_ctx`,例如在运行命令中添加`--num-ctx 8192`(或更高)——否则模型会静默截断输入。
- 中文用途选择Q2_K量化。 2位精度下,Qwen3的中文输出质量明显下降——出现字符替换问题。中文任务至少使用Q4_K_M。
- 显存不足时运行32B模型。 若GPU只有16GB而模型需要20.5GB,Ollama会将层卸载到系统内存。模型可运行但速度仅3–5 token/秒,不适合交互使用。
- 代码任务使用错误的子系列。 Qwen3 8B(通用版)在HumanEval上得57.3%。Qwen2.5-Coder 7B得75.6%——相对提升32%。代码任务始终使用同等规格的Coder版本。
下一步
- 仅用CPU运行LLM指南 — 没有GPU?了解哪些Qwen3规格可纯CPU运行 →
- LLM量化详解 — Q4_K_M和Q8搞不清楚?量化原理详解 →
常见问题
本地运行Qwen3 8B需要多少显存?
Qwen3 8B Q4_K_M需要5.5GB显存。RTX 3060 6GB、RTX 4060或Apple M系列芯片8GB统一内存均可。
本地运行最适合代码任务的Qwen模型?
Qwen2.5-Coder 32B——HumanEval 92.7%,需24GB GPU。显存12GB或以下:Qwen2.5-Coder 14B(85.2%,9.5GB显存)。
Qwen与DeepSeek本地部署对比?
Qwen3使用适合消费级硬件的Dense架构。DeepSeek-V2.5是236B MoE,需约130GB内存,没有服务器级GPU无法实现。
可以在Mac上运行Qwen吗?
可以。M2 Pro 32GB可流畅运行Qwen3 14B,约32 token/秒。M3 Max 64GB可处理Qwen3 32B,约22 token/秒。
Qwen的Ollama命令是什么?
旗舰模型使用`ollama run qwen3.6:27b`(约17GB显存)。Qwen3使用`ollama pull qwen3:8b`。Qwen2.5的7B用`ollama pull qwen2.5:7b`,14B用`:14b`,32B用`:32b`,代码版用`qwen2.5-coder:32b`。始终使用明确的尺寸标签。
Qwen适合中文任务吗?
是的。Qwen3在大规模中文语料库上预训练,原生支持简体中文、繁体中文、日语、韩语等29种语言,中文任务持续超越Llama 3.3和Mistral。
Qwen3应该使用哪种量化格式?
Q4_K_M是推荐默认格式——相比FP16减少约55%显存,质量损失不足1%。显存充足时用Q8_0。中文任务避免Q2_K。
Qwen2-VL适合中文文档OCR吗?
是的——`ollama pull qwen2-vl:7b`,约6GB显存,支持最高4096×4096像素中日韩文字识别。
本地部署Qwen3是否符合数据安全法要求?
本地运行时数据不离开本地服务器,无需跨境传输,符合《数据安全法》第31条规定。金融、医疗、法律等受监管行业的最佳合规选择。
Qwen2.5-72B需要什么硬件?
Q4_K_M量化需约46GB显存。两块RTX 3090(合计48GB)或带64GB+统一内存的Apple Silicon(M2 Ultra 192GB可流畅运行)。