重要なポイント
- Qwen 3.6 27Bが新フラッグシップ:密なモデル、Apache 2.0、256Kコンテキスト、Q4_K_M約17GBのVRAM、`ollama run qwen3.6:27b`(2026年4月リリース)。
- Qwen3 8BはVRAM 5.5GBで動作 — `ollama pull qwen2.5:7b`の1コマンドで起動。RTX 3060で57トークン/秒。
- 4つの実用的なサブファミリー:Qwen3(汎用、思考モード)、Qwen2.5(汎用、最も検証済み)、Qwen2.5-Coder(コーディング、32BでHumanEval 92.7%)、Qwen2-VL(ビジョン、ローカルCJK OCR最強)。
- Denseアーキテクチャ = コンシューマー向け:DeepSeekの236B MoE(約130GB RAM必要)と違い、Qwen2.5-72BはVRAM 46GBで2枚のRTX 3090に収まります。
- ネイティブ多言語対応:中国語・日本語・韓国語・アラビア語・ドイツ語・フランス語など29言語でLlama 3.3を上回る性能。
- Q4_K_Mが最適な量子化:FP16比でVRAMを約55%削減し、品質低下は1%未満。
- ハードウェア判断基準:VRAM 12GB → 14Bモデル;24GB → 32B;48GB+(デュアルGPUまたはApple Silicon 64GB)→ 72B。
📍 一文で説明
Qwen 3.6 27B(256Kコンテキスト、Q4_K_M約17GB)が新フラッグシップ。Qwenには4つのローカルデプロイ用サブファミリーがあります:汎用(7B〜72B)、コーディング(Coder 7B〜32B)、ビジョン(VL 7B〜72B)。すべてOllamaまたはLM Studioで実行可能。
💬 簡潔に説明
モデルをローカルで動かすとは、AIがクラウドサーバーではなく自分のコンピュータ上で動作することを意味します。データが外部に出ず、ハードウェア購入後はトークンごとのコストもかかりません。
Qwenモデルファミリー概要
Qwenのラインアップは現在、フラッグシップのQwen 3.6 27B、より新しいQwen3ファミリー、汎用推論のQwen2.5、Qwen2.5-Coder、ビジョン用のQwen2-VLの5つの実用的な選択肢をカバーしています。すべてAlibaba QwenチームがHugging FaceにApache 2.0ライセンスで公開しているオープンウェイトモデルです。
まずサブファミリーを選び、次にVRAMに合ったサイズを選択します。複数サブファミリーの組み合わせも一般的です:コード補完にQwen2.5-Coder 14B、文書要約にQwen3 8BまたはQwen 3.6 27B、という使い方が典型例です。
サブファミリー | 利用可能なサイズ | 主な用途 | Ollamaタグプレフィックス |
|---|---|---|---|
| Qwen3 | 0.6B, 1.7B, 4B, 8B, 14B, 32B | 汎用推論、思考モード、多言語、エージェントタスク | qwen3: |
| Qwen2.5 | 7B, 14B, 32B, 72B | 汎用推論、中国語/多言語タスク、RAG | qwen2.5: |
| Qwen2.5-Coder | 7B, 14B, 32B | コード生成、デバッグ、HumanEval、SWE-bench | qwen2.5-coder: |
| Qwen2-VL | 2B, 7B, 72B | ドキュメントOCR、画像Q&A、CJKテキスト抽出 | qwen2-vl: |
Qwen 3.6 27B(2026年4月リリース)は新フラッグシップです。256Kコンテキストウィンドウを持つ密なモデルで、`ollama run qwen3.6:27b`でQ4_K_M約17GBのVRAMで動作します。Qwen2.5は2026年中頃時点で最も検証済みのファミリーで、OllamaとGGUFのカバレッジが最も広いです。
モデルサイズ別ハードウェア要件
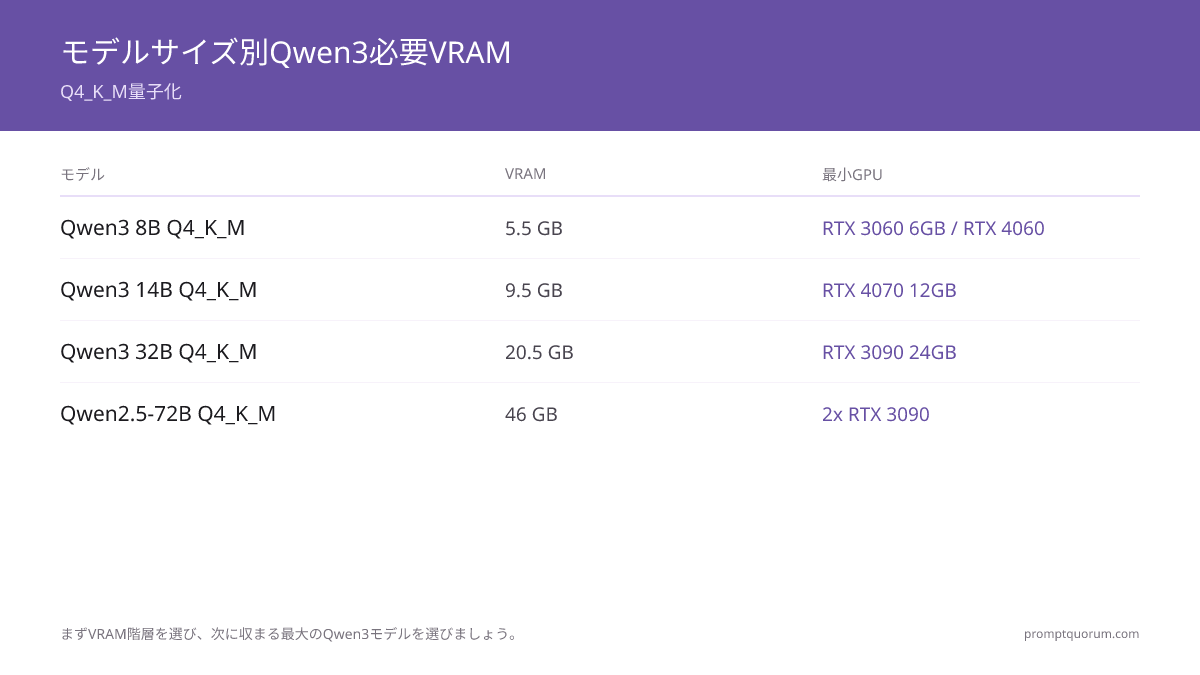
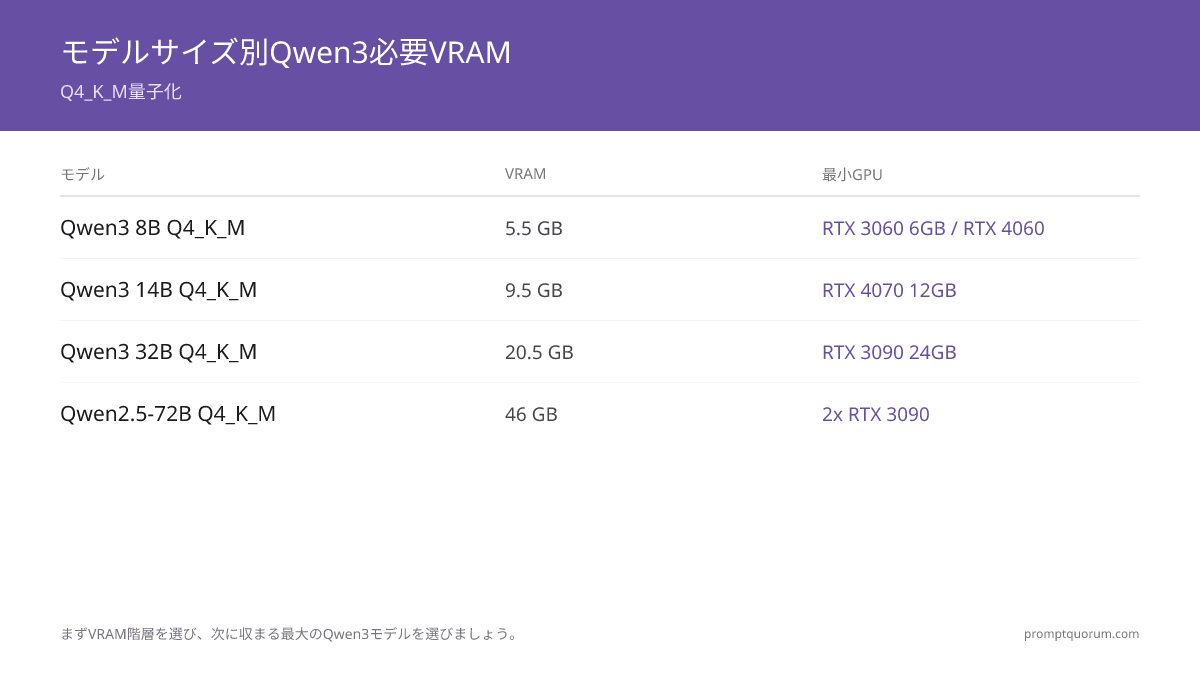
まずVRAM階層を選び、次にそこに収まる最大のQwen3モデルを選択します。 以下の数値はすべてQ4_K_M量子化を基準としています。
モデル | VRAM | 最低GPU | Apple Silicon | 速度(RTX 3060) |
|---|---|---|---|---|
| Qwen3 8B Q4_K_M | 5.5GB | RTX 3060 6GB、RTX 4060 | M1/M2 8GB | 約57トークン/秒 |
| Qwen2.5-Coder 7B Q4_K_M | 5.5GB | RTX 3060 6GB、RTX 4060 | M1/M2 8GB | 約55トークン/秒 |
| Qwen2-VL 7B Q4_K_M | 6.2GB | RTX 3060 8GB、RTX 4060 | M1/M2 16GB | — |
| Qwen2.5 14B Q4_K_M | 9.5GB | RTX 4070 12GB | M2 Pro 16GB | — |
| Qwen2.5-Coder 14B Q4_K_M | 9.5GB | RTX 4070 12GB | M2 Pro 16GB | — |
| Qwen2.5 32B Q4_K_M | 20.5GB | RTX 3090 24GB | M3 Max 48GB | — |
| Qwen2.5-Coder 32B Q4_K_M | 20.5GB | RTX 3090 24GB | M3 Max 48GB | — |
| Qwen 3.6 27B Q4_K_M | 約17GB | RTX 4090 24GB | M3 Max 36GB | — |
| Qwen2.5-72B Q4_K_M | 46GB | 2× RTX 3090(48GB) | M2 Ultra 64GB | — |
VRAMの数値はOllamaライブラリのQ4_K_M GGUFファイルを基準としています。4KコンテキストのKVキャッシュとして1〜2GB追加が必要です。GPUのVRAMがモデルに必要な量より少ない場合、Ollamaは自動的にシステムRAMにレイヤーをオフロードしますが、速度が大幅に低下します。
💡ヒント: ご自身のVRAM階層が決まったら、その階層に最適なGPUまたはMacの選び方をご覧ください — 6GB → RTX 4060、12GB → RTX 4070 Super、24GB → RTX 3090/4090、48GB以上 → Mac mini M5 Proまたはデュアル GPU。
Ollamaでのセットアップ
Ollamaは任意のQwen3モデルをローカルで実行する最速の方法です。 モデルのダウンロード、GGUF量子化の管理、`localhost:11434`へのローカルAPI提供をすべて自動で行います。ollama.comからインストールしてください。Ollamaを初めて使う場合は、まずOllamaのインストール方法をご覧ください。
- 1Ollamaをインストール
Why it matters: macOS、Linux(ワンライナーインストール)、Windowsで利用可能。GPUドライバーの設定は不要 — OllamaはCUDA、ROCm、Metalを自動検出します。 - 2明示的なサイズタグでモデルを取得
Why it matters: 必ずサイズを指定してください:`qwen2.5:7b`、`qwen2.5:14b`、`qwen2.5:32b`。タグなしの`qwen2.5`はデフォルトで7Bに解決されますが、Ollamaのバージョン間で変わる可能性があります。 - 3モデルを実行
Why it matters: `ollama run qwen2.5:7b`でインタラクティブチャットが開きます。プロンプトを入力してEnterキーを押します。終了は`/bye`。 - 4必要に応じてコンテキストウィンドウを設定
Why it matters: Qwen3はOllamaでデフォルト32Kコンテキストをサポートします。128Kコンテキストを使う場合:`ollama run qwen2.5:7b --num-ctx 131072`。追加VRAMが必要になります。 - 5APIエンドポイントをテスト
Why it matters: OllamaはOpenAI互換APIを提供します。PromptQuorum、Continue.dev、Open WebUIなどのアプリが`http://localhost:11434/v1`に直接接続できます。
# Ollamaのインストール(Linux)
curl -fsSL https://ollama.com/install.sh | sh

# macOS: ollama.comから.dmgをダウンロード、または:
brew install ollama

# モデルの取得 — 明示的なタグを使用
ollama pull qwen3.6:27b          # フラッグシップ、256Kコンテキスト(約17GB)
ollama pull qwen3:8b             # Qwen3汎用8B(約5.5GB)
ollama pull qwen2.5:7b           # Qwen2.5汎用7B(約5.5GB)
ollama pull qwen2.5:14b          # Qwen2.5汎用14B(約9.5GB)
ollama pull qwen2.5:32b          # Qwen2.5汎用32B(約20.5GB)
ollama pull qwen2.5-coder:32b    # Qwen2.5-Coder 32B(約20.5GB)
ollama pull qwen2-vl:7b          # ビジョン7B(約6.2GB)

# インタラクティブ実行
ollama run qwen2.5:7b

# OpenAI互換APIのテスト
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2.5:7b","messages":[{"role":"user","content":"こんにちは"}]}'
LM Studioでのセットアップ
LM StudioはターミナルコマンドなしでQwen3を利用できるGUIです。 lmstudio.aiからダウンロード、またはLM Studioのインストール方法を参照。macOS・Windows・Linuxで動作します。
- 1モデルブラウザを開く
Why it matters: 「Qwen3」または「Qwen Coder」で検索。Q4_K_Mでフィルタリングすると推奨品質/サイズ比のビルドが表示されます。 - 2GGUFビルドをダウンロード
Why it matters: Q4_K_Mバリアントを選択。LM Studioはダウンロード前にファイルサイズを表示します。 - 3モデルをロードしてチャット開始
Why it matters: 左サイドバーでモデルをクリックしてメモリにロード。GPUレイヤーの割り当ては自動です。 - 4ローカルサーバーを起動
Why it matters: 「サーバー起動」で`localhost:1234`にOpenAI互換エンドポイントが公開されます。
量子化:どのフォーマットを選ぶか
Q4_K_MはコンシューマーハードウェアでのQwen3に最適なデフォルトです。 FP16比でVRAMを約55〜60%削減し、MMLUとHumanEvalのベンチマーク劣化は1%未満です。
📍 一文で説明
Q4_K_MはほとんどのユーザーにとってQwen3に最適な量子化です:FP16比でVRAMを55%削減し、品質低下は1%未満。
💬 簡潔に説明
量子化とはモデルの数値を16ビットから4ビットに圧縮することで、ファイルサイズとVRAM使用量を約半分にします。TIFFから高品質JPEGへの変換のようなもの — ファイルは小さくなりますが、ほとんどの用途では同じ結果が得られます。
- Q4_K_M(推奨):7Bで約5.5GB。最良の品質/GB比。まずこれを試してください。
- Q8_0:7Bで約8.5GB。ほぼFP16品質。VRAMに余裕があり最大精度が必要な場合に使用。
- Q5_K_M:7Bで約6.5GB。Q4_K_Mからのわずかな改善 — タスクでQ4_K_Mの品質が明らかに不足している場合のみ選択。
- Q2_K:7Bで約3GB。最小ファイルサイズだが、中国語出力品質が著しく低下 — Qwen3で中国語を使う場合は避けること。
- IQ4_XS:7Bで約4.8GB。Q4_K_Mより品質が高くやや小さい新しいimatrix量子化 — 最近のllama.cppリリースとLM Studio 0.3+で利用可能。
コンシューマーハードウェアでのベンチマーク性能
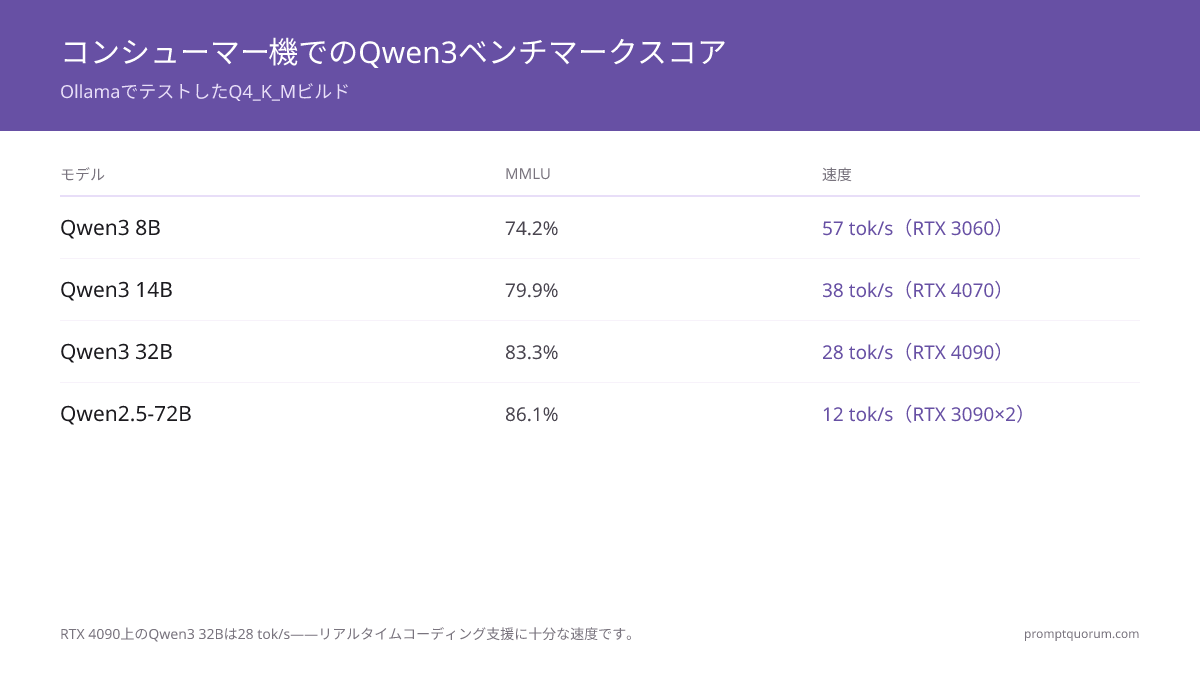
RTX 4090でのQwen3 32B Q4_K_Mは28トークン/秒 — リアルタイムのコーディング支援に十分な速度です。以下のスコアはOllamaでテストしたQ4_K_M GGUFビルドの値です。
モデル(Q4_K_M) | MMLU | Math | HumanEval | 速度(RTX 3060 12GB) |
|---|---|---|---|---|
| Qwen3 8B | 74.2% | 58.8% | 57.3% | 57トークン/秒 |
| Qwen3 14B | 79.9% | 69.8% | 64.6% | — |
| Qwen3 32B | 83.3% | 79.5% | 71.3% | — |
| Qwen2.5-72B | 86.1% | 83.1% | 73.2% | — |
| Qwen2.5-Coder 7B | — | — | 75.6% | 55トークン/秒 |
| Qwen2.5-Coder 14B | — | — | 85.2% | — |
| Qwen2.5-Coder 32B | — | — | 92.7% | — |
💡ヒント: 27トークン/秒でHumanEval 92.7%を狙いたいですか?Qwen2.5-Coder 32Bを動かせる24GB GPUをご覧ください。
Qwen vs DeepSeek vs Llama:何をローカルで動かすか
Qwen3は中国語タスクとVRAM効率で優位。DeepSeek-V2.5は大規模推論で強いがコンシューマーハードウェアでは非現実的。Llama 3.3 70BはMetaのオープンモデルを好む場合のシングルGPU最良選択肢です。
VRAM階層 | 最良Qwen | 最良競合 | 判定 |
|---|---|---|---|
| 6GB | Qwen3 8B | Llama 3.2 3B(収まるが3Bのみ) | Qwen3 8Bが優位 — 同VRAM、より大きなモデル |
| 12GB | Qwen2.5-Coder 14B | Llama 3.1 8B Instruct | コーディングにはQwen2.5-Coder 14B;汎用チャットにはLlama 3.1 8B |
| 24GB | Qwen2.5-Coder 32B | Llama 3.3 70B(オフロード) | コードにはQwen2.5-Coder 32B;品質>速度ならLlama 3.3 70B |
| 48GB+ | Qwen2.5-72B | DeepSeek-V2.5 236B MoE | DeepSeekは約130GB RAM必要;Qwen2.5-72Bが48GBの現実的な選択 |
日本企業でのデータ主権と規制対応
Qwen3をローカルで運用すると、データが社外のサーバーに送信されません — クラウドAPIと異なり、推論時に外部ネットワーク通信が発生しないためです。これは経済産業省(METI)の「AI事業者ガイドライン(2024年)」が求めるデータガバナンスの観点で有利な構成です。
日本語はQwen3の29言語ネイティブサポートに含まれており、医療・法律・金融などの日本語専門文書でも高精度なテキスト処理が可能です。Qwen2-VL 7Bは日本語ドキュメントのOCRにおいて、LLaVAやLlama 3.2 Visionを上回る精度を示しています。
アジア太平洋地域の規制環境 — 日本の個人情報保護法(PIPA改正版)では、個人データの安全管理措置として「技術的安全管理措置」が義務付けられています。ローカルLLMは、個人データをオンプレミスで処理することで、この要件に対応しやすい構成です。中国・韓国・シンガポール・オーストラリアでも同様に、機密データのローカル処理がクロスボーダーデータ転送リスクを排除します。完全オフライン構成のガイドは完全オフラインでAIを動かすをご覧ください。
📍 一文で説明
Qwen3はダウンロード後に完全オフラインで動作し、データが社外に出ないためMETIのAIガバナンスガイドラインへの対応が容易です。
💬 簡潔に説明
ローカルで動かすと、プロンプトや文書がコンピュータから出ません。クラウドAPIコールもなく、外部サーバーもなく、第三者がアクセスできるデータもありません。
Qwen3デプロイにはどのハードウェアを買うべきか?
まず目標とするQwenの階層に必要なVRAMを確認し、それをクリアする最も安いカードを選びましょう。モデルに必要な量以上のVRAMに支払うのが、このリストで最もよくある無駄遣いです。 以下のおすすめは上記のハードウェア表に直接対応しています:エントリー → RTX 4060、ミドルレンジ → RTX 4070 Super、ハイエンド → RTX 3090/4090、Apple Silicon → Mac mini M5 Pro、常時稼働 → mini PC。以下の価格は2026年のGPU市場を反映しています — メモリチップ不足とAIデータセンター需要により、新品GPUとApple製品のメモリ構成の価格がいずれも大きく上昇しています。購入前に最新価格をご確認ください。
💡ヒント: すでにVRAM 8GB以上のGPUをお持ちの場合は、このセクションは読み飛ばして構いません — まずは手持ちのハードウェアでQwen3 8Bを動かしてみてください。その上限に達し、より大きなモデルが必要になってから新しいハードウェアを検討してください。
NVIDIA RTX 4060 8 GB
エントリー向け — Qwen3 8B、Qwen2.5-Coder 7B(5.5GB VRAM)
このリストの中で、5.5GBのQwen3 8B要件をコンテキスト用の余裕を残しつつクリアできる最も安いカードです。Qwen2.5-Coder 7Bは約55トークン/秒で動作し、インタラクティブなコーディング支援に十分な速度です。
長所
- +5.5GBのVRAM要件を、長いコンテキストのKVキャッシュ分の余裕を残してクリア
- +このリストで最も低価格 — ローカルLLMを初めて使うなら最適な最初の1枚
- +7B/8Bモデルで50〜57トークン/秒、より高価なカードと同等の性能をこのモデルサイズで発揮
短所
- –Qwen3 8B / Qwen2.5-Coder 7Bが上限 — KVキャッシュを圧迫せずに14Bへ拡張する余地はない
NVIDIA RTX 4070 Super 12 GB
ミドルレンジ向け — Qwen3 14B、Qwen2.5-Coder 14B(9.5GB VRAM)
Qwen2.5-Coder 14B(HumanEval 85.2%)を36〜38トークン/秒で動作させ、コンテキスト用に2〜3GBのVRAM余裕が残ります — 7B/8Bモデルからコーディング品質が明確に向上する階層です。
長所
- +9.5GBのモデルが2〜3GBのVRAM余裕を残して動作 — より長いコンテキストウィンドウの余地
- +HumanEvalが75.6%(7B)から85.2%(14B)へ上昇 — ラインアップの中で最も分かりやすいコストパフォーマンスの向上
- +約38トークン/秒でインタラクティブなチャットやコード補完の応答性を維持
短所
- –32B階層には十分なVRAMがない — 14Bを超えたくなったら売却や転用を検討する必要がある
NVIDIA RTX 4090 24 GB(または中古のRTX 3090 24 GB)
ハイエンド向け — Qwen2.5-Coder 32B、Qwen 3.6 27B(約17〜20.5GB VRAM)
4090はQwen2.5-Coder 32Bで27〜28トークン/秒を発揮します — HumanEval 92.7%でリアルタイムのコーディング速度です。中古のRTX 3090は同じ24GB VRAMを備え、信頼できる中古品を見つけられれば4090の推論速度の約15%以内で、大幅に安く入手できます。
長所
- +24GBのVRAMですべてのQwen3 32BバリアントとQwen 3.6 27Bを余裕でカバー
- +Qwen2.5-Coder 32B(HumanEval 92.7%)で27〜28トークン/秒 — リアルタイムのペアプログラミングに十分な速度
- +中古のRTX 3090はコスパの高い代替案:VRAMの上限は同じで、速度は約15%遅いが中古価格は大幅に安い
短所
- –このリストで最も初期費用が高い — 実際に32Bクラスの品質が必要な場合にのみ正当化される
Apple Mac mini M5 Pro 64 GB
Apple Silicon向け — Qwen3 32B、静音・低消費電力
統合メモリでQwen3 32Bを動かす上で最もコストパフォーマンスに優れた選択肢です — 静音で消費電力も低く、別途GPUを組み込む必要がありません。Qwen2.5-72Bを動かす場合はM2 Ultra 192GBが代わりに必要です。
長所
- +M5 Pro構成は最大64GBの統合メモリまで選択可能 — Qwen3 32Bの20.5GB要件を大きく上回り、他アプリ用の余裕も確保
- +静音動作とデスクトップに適した消費電力 — 専用のGPU冷却管理が不要
- +OS、ストレージ、推論を一度の購入でまかなえる — 別途GPU/電源/ケースの組み立て不要
短所
- –M5 Proチップでの独立したQwen3 32Bベンチマークはまだ公開されていない — RTX 4090のような専用GPUより明らかに遅い性能が予想され、これは従来のMac mini向けApple Siliconの世代と同様の傾向
MINISFORUM UM890 Pro(または同等のAMD Ryzen AI mini PC)
常時稼働向け — CPU + iGPUでQwen3 8B(約8〜12トークン/秒、35W未満)
インタラクティブな用途には向きません — バックグラウンドタスク、ホームオートメーション、あるいは速度より電力コストが重要な低トラフィックのAPIエンドポイントのために、Qwen3 8Bのインスタンスを24時間365日稼働させ続ける用途に適しています。
長所
- +消費電力35W未満 — デスクトップGPU構成と違い、常時稼働させても安価
- +小型フォームファクターでどこにでも設置可能。別途GPUを調達・冷却する必要もない
- +ディスクリートGPUなしでもQwen3 8Bを処理できる
短所
- –8〜12トークン/秒はインタラクティブなチャットには遅すぎる — バックグラウンド/API専用の選択肢
よくあるミス
- タグなしで`ollama pull qwen2.5`を実行する。 明示的なサイズタグ(`:7b`、`:14b`など)なしでは、OllamaはOllamaのアップデートで変わりうるデフォルトサイズに解決します。常に明示的なタグを使用:`ollama pull qwen2.5:14b`。
- コンテキストウィンドウサイズを無視する。 Qwen3は128Kコンテキストをサポートします。OllamaのModelfile仕様では`num_ctx`のデフォルトは2048ですが、実際のランタイムはVRAM容量に応じた段階的なデフォルト値を採用します(24GiB未満は4K、24〜48GiBは32K、48GiB超は256K)。どちらのデフォルトにも依存せず、`num_ctx`を明示的に設定してください。例えば実行コマンドに`--num-ctx 8192`(またはそれ以上)を追加します。設定しないと、モデルは入力を黙って切り詰めます。
- 中国語用途にQ2_K量子化を選ぶ。 2ビット精度では、Qwen3の中国語出力品質が著しく低下します。中国語作業には最低でもQ4_K_Mを使用してください。
- VRAMが不足した状態で32Bモデルを実行する。 GPUが16GBでモデルが20.5GB必要な場合、Ollamaはシステムメモリにレイヤーをオフロードします。3〜5トークン/秒でインタラクティブ使用には不向きです。
- コーディングに間違ったサブファミリーを使う。 Qwen3 8B(汎用)はHumanEvalで57.3%。Qwen2.5-Coder 7Bは同ベンチマークで75.6% — 相対的に32%の改善。コーディングには必ず同サイズのCoder バリアントを使用してください。
次のステップ
- CPUのみで動くベストLLM — GPUなし?Qwen3のどのサイズがCPUだけで動くか →
- LLM量子化を解説 — Q4_K_MとQ8の違いが分からない?量子化を解説 →
よくある質問
Qwen3 8Bをローカルで動かすのに必要なVRAMは?
Qwen3 8B Q4_K_MにはVRAM 5.5GBが必要です。RTX 3060 6GB、RTX 4060、またはApple M系8GBユニファイドメモリで動作します。
コーディング用途に最適なQwenモデルは?
Qwen2.5-Coder 32B — HumanEval 92.7%、GPU 24GB必要。VRAM 12GB以下ならQwen2.5-Coder 14B(85.2%、9.5GB VRAM)。
QwenとDeepSeekのローカルデプロイ比較は?
Qwen3はコンシューマーハードウェアに収まるDenseアーキテクチャ。DeepSeek-V2.5は236B MoEで約130GB RAM必要 — コンシューマーGPUでは非現実的。
MacでQwenを動かせますか?
はい。M2 Pro 32GBはQwen3 14Bを約32トークン/秒で実行。M3 Max 64GBはQwen3 32Bを約22トークン/秒で処理。
QwenのOllamaコマンドは?
フラッグシップは`ollama run qwen3.6:27b`(VRAM約17GB)。Qwen3は`ollama pull qwen3:8b`。Qwen2.5は`ollama pull qwen2.5:7b`(7B)、`:14b`(14B)、`:32b`(32B)、`qwen2.5-coder:32b`(コーディング版)。常に明示的なサイズタグを使用。
中国語タスクにQwenは適していますか?
はい。Qwen3は大規模な中国語コーパスで学習され、簡体字・繁体字・日本語・韓国語を含む29言語をネイティブサポートしています。
Qwen3に推奨する量子化は?
Q4_K_Mがデフォルト推奨 — FP16比でVRAM約55%削減、品質低下1%未満。Q8_0は品質重視、Q2_Kは中国語には不適。
Qwen2-VLは日本語・中国語OCRに使えますか?
はい。Qwen2-VL 7BはCJK OCRで最強のローカルビジョンモデル。`ollama pull qwen2-vl:7b`でVRAM約6GBで動作、最大4096×4096ピクセルに対応。
METI AIガイドラインへの対応は?
ローカルデプロイでデータが社外に出ないため、METI「AI事業者ガイドライン2024」のデータガバナンス要件に対応しやすい構成です。
Apple M系チップでQwen2.5-72Bを動かせますか?
M2 Ultra 192GBまたはM3 Ultra 192GBで動作します。Q4_K_Mで約46GBのメモリが必要です。
日本の企業でQwen3を使う場合のMETIガイドラインへの対応は?
ローカルデプロイ時はデータが社外に出ないため、経済産業省の「AI事業者ガイドライン(2024年)」が求めるデータガバナンスの観点でも有利です。特に個人情報・秘密情報を扱う業務では、オフライン推論がリスク管理として有効です。