Points clés
- Qwen 3.6 27B est le nouveau modèle phare : dense, Apache 2.0, contexte 256 K, ~17 Go de VRAM en Q4_K_M via `ollama run qwen3.6:27b` (sorti en avril 2026).
- Qwen3 8B tourne avec 5,5 Go de VRAM — une commande `ollama pull qwen2.5:7b` suffit ; 57 tokens/s sur RTX 3060.
- Quatre sous-familles pratiques : Qwen3 (général, mode réflexion), Qwen2.5 (général, le plus testé), Qwen2.5-Coder (code, 92,7 % HumanEval en 32B), Qwen2-VL (vision, meilleur OCR CJK local).
- Architecture dense = compatible matériel grand public : contrairement au modèle MoE 236B de DeepSeek (~130 Go RAM), Qwen2.5-72B tient en 46 Go VRAM sur deux RTX 3090.
- Multilinguisme natif : pré-entraîné sur le chinois, le japonais, le coréen, l'arabe, le français et 24 autres langues.
- Q4_K_M est la bonne quantification pour la plupart des utilisateurs : ~55 % de réduction VRAM, moins de 1 % de perte de qualité.
- Décision matérielle : 12 Go VRAM → modèle 14B ; 24 Go → 32B ; 48 Go+ → 72B.
📍 En une phrase
Qwen3 couvre trois sous-familles de déploiement local — usage général (7B–72B), code (Coder 7B–32B) et vision (VL 7B–72B) — toutes exécutables via Ollama ou LM Studio.
💬 En termes simples
Faire tourner un modèle en local signifie que l'IA s'exécute sur votre propre ordinateur, sans serveur cloud. Aucune donnée ne quitte votre machine, et il n'y a aucun coût par token après l'achat du matériel.
Famille de modèles Qwen
La gamme Qwen compte désormais cinq choix pratiques : le modèle phare Qwen 3.6 27B, la famille Qwen3 plus récente, Qwen2.5 pour le raisonnement général, Qwen2.5-Coder et Qwen2-VL pour la vision — chacun disponible en plusieurs tailles. Tous sont des modèles open-weight publiés par l'équipe Qwen d'Alibaba sous licence Apache 2.0.
Sous-famille | Tailles disponibles | Usage principal | Préfixe tag Ollama |
|---|---|---|---|
| Qwen3 | 0,6B, 1,7B, 4B, 8B, 14B, 32B | Raisonnement général, mode réflexion, multilingue, tâches agentiques | qwen3: |
| Qwen2.5 | 7B, 14B, 32B, 72B | Raisonnement général, tâches chinoises/multilingues, RAG | qwen2.5: |
| Qwen2.5-Coder | 7B, 14B, 32B | Génération de code, débogage, HumanEval, SWE-bench | qwen2.5-coder: |
| Qwen2-VL | 2B, 7B, 72B | OCR de documents, Q&A sur images, extraction de texte CJK | qwen2-vl: |
Qwen 3.6 27B (sorti en avril 2026) est le nouveau modèle phare — un modèle dense avec une fenêtre de contexte de 256 K qui tourne avec ~17 Go de VRAM en Q4_K_M via `ollama run qwen3.6:27b`. Qwen2.5 reste la famille la plus testée, avec la couverture Ollama et GGUF la plus large mi-2026.
Exigences matérielles par taille de modèle
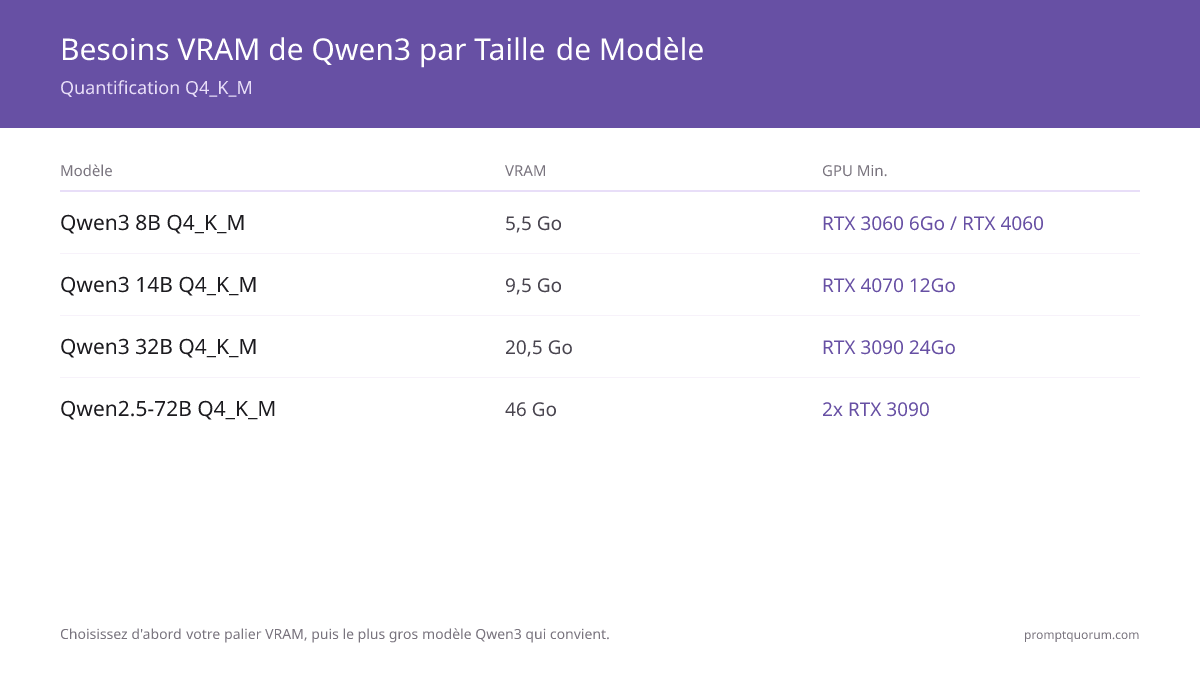
Choisissez d'abord votre niveau VRAM, puis le plus grand modèle Qwen3 qui y tient. Q4_K_M est la quantification standard pour toutes les valeurs ci-dessous.
Modèle | VRAM | GPU minimum | Apple Silicon | Vitesse (RTX 3060) |
|---|---|---|---|---|
| Qwen3 8B Q4_K_M | 5,5 Go | RTX 3060 6 Go, RTX 4060 | M1/M2 8 Go | ~57 tokens/s |
| Qwen3-Coder 7B Q4_K_M | 5,5 Go | RTX 3060 6 Go, RTX 4060 | M1/M2 8 Go | ~55 tokens/s |
| Qwen2-VL 7B Q4_K_M | 6,2 Go | RTX 3060 8 Go, RTX 4060 | M1/M2 16 Go | — |
| Qwen3 14B Q4_K_M | 9,5 Go | RTX 4070 12 Go | M2 Pro 16 Go | — |
| Qwen3-Coder 14B Q4_K_M | 9,5 Go | RTX 4070 12 Go | M2 Pro 16 Go | — |
| Qwen3 32B Q4_K_M | 20,5 Go | RTX 3090 24 Go | M3 Max 48 Go | — |
| Qwen3-Coder 32B Q4_K_M | 20,5 Go | RTX 3090 24 Go | M3 Max 48 Go | — |
| Qwen 3.6 27B Q4_K_M | ~17 Go | RTX 4090 24 Go | M3 Max 36 Go | — |
| Qwen2.5-72B Q4_K_M | 46 Go | 2× RTX 3090 (48 Go) | M2 Ultra 64 Go | — |
Les valeurs VRAM concernent les fichiers GGUF Q4_K_M de la bibliothèque Ollama. Ajoutez 1–2 Go pour le cache KV à 4K de contexte. Si le GPU a moins de VRAM que nécessaire, Ollama décharge automatiquement des couches en RAM système — fonctionnel mais beaucoup plus lent.
💡Astuce: Vous avez identifié votre niveau VRAM ? Consultez exactement quel GPU ou Mac acheter pour ce niveau — 6 Go → RTX 4060, 12 Go → RTX 4070 Super, 24 Go → RTX 3090/4090, 48 Go et plus → Mac mini M5 Pro ou double GPU.
Configuration avec Ollama
Ollama est la solution la plus rapide pour déployer localement n'importe quel modèle Qwen3. Il gère le téléchargement, la quantification GGUF et expose une API à `localhost:11434`. Installez-le depuis ollama.com. Si vous débutez avec Ollama : comment installer Ollama.
- 1Installer Ollama
Why it matters: Disponible pour macOS, Linux (installation en une ligne) et Windows. Ollama détecte automatiquement CUDA, ROCm et Metal. - 2Télécharger le modèle avec un tag de taille explicite
Why it matters: Toujours préciser la taille : `qwen2.5:7b`, `qwen2.5:14b`, `qwen2.5:32b`. Le tag non spécifié `qwen2.5` peut changer entre les versions d'Ollama. - 3Exécuter le modèle
Why it matters: `ollama run qwen2.5:7b` ouvre un chat interactif. Saisir la commande et appuyer sur Entrée. Quitter avec `/bye`. - 4Ajuster la fenêtre de contexte si nécessaire
Why it matters: Qwen3 supporte 32K de contexte par défaut dans Ollama. Pour 128K : `ollama run qwen2.5:7b --num-ctx 131072`. Cela nécessite davantage de VRAM. - 5Tester le point de terminaison API
Why it matters: Ollama expose une API compatible OpenAI. Les applications comme PromptQuorum et Continue.dev se connectent directement à `http://localhost:11434/v1`.
# Installer Ollama (Linux)
curl -fsSL https://ollama.com/install.sh | sh

# macOS : télécharger le .dmg ou :
brew install ollama

# Télécharger les modèles — tags explicites requis
ollama pull qwen3.6:27b          # modèle phare, contexte 256 K (~17 Go)
ollama pull qwen3:8b             # Qwen3 usage général 8B (~5,5 Go)
ollama pull qwen2.5:7b           # Qwen2.5 usage général 7B (~5,5 Go)
ollama pull qwen2.5:14b          # Qwen2.5 14B (~9,5 Go)
ollama pull qwen2.5:32b          # Qwen2.5 32B (~20,5 Go)
ollama pull qwen2.5-coder:32b    # Qwen2.5-Coder 32B (~20,5 Go)
ollama pull qwen2-vl:7b          # vision 7B (~6,2 Go)

# Exécuter en mode interactif
ollama run qwen2.5:7b

# Tester l'API compatible OpenAI
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2.5:7b","messages":[{"role":"user","content":"Bonjour"}]}'
Configuration avec LM Studio
LM Studio offre une interface graphique pour Qwen3 sans commandes terminal. Téléchargement sur lmstudio.ai ou voir comment installer LM Studio. Disponible sur macOS, Windows et Linux.
- 1Ouvrir le navigateur de modèles
Why it matters: Rechercher « Qwen3 » ou « Qwen Coder ». Filtrer sur Q4_K_M pour le meilleur rapport qualité/taille. - 2Télécharger un build GGUF
Why it matters: Sélectionner la variante Q4_K_M. LM Studio affiche la taille du fichier avant le téléchargement. - 3Charger le modèle et démarrer le chat
Why it matters: Cliquer sur le modèle dans la barre latérale gauche. L'allocation des couches GPU est automatique. - 4Démarrer le serveur local
Why it matters: « Démarrer le serveur » expose une API compatible OpenAI sur `localhost:1234`.
Quantification : quel format choisir ?
Q4_K_M est le bon choix par défaut pour Qwen3 sur matériel grand public. Il réduit le VRAM de ~55–60 % par rapport au FP16 avec moins de 1 % de dégradation sur MMLU et HumanEval.
📍 En une phrase
Q4_K_M est la meilleure quantification Qwen3 pour la plupart des utilisateurs : 55 % de réduction VRAM avec moins de 1 % de perte de qualité vs FP16.
💬 En termes simples
La quantification compresse les nombres du modèle de 16 bits à 4 bits, réduisant environ de moitié la taille du fichier et le VRAM nécessaire — comme passer d'un TIFF à un JPEG haute qualité.
- Q4_K_M (recommandé) : ~5,5 Go pour 7B. Meilleur rapport qualité par Go.
- Q8_0 : ~8,5 Go pour 7B. Qualité quasi-FP16 ; utiliser si vous avez du VRAM disponible.
- Q5_K_M : ~6,5 Go pour 7B. Amélioration marginale par rapport à Q4_K_M.
- Q2_K : ~3 Go pour 7B. La qualité en langue chinoise se dégrade notablement — à éviter pour les usages CJK.
- IQ4_XS : ~4,8 Go pour 7B. Meilleure qualité que Q4_K_M à taille légèrement inférieure — disponible dans les versions récentes de llama.cpp et LM Studio 0.3+.
Performances benchmark sur matériel grand public
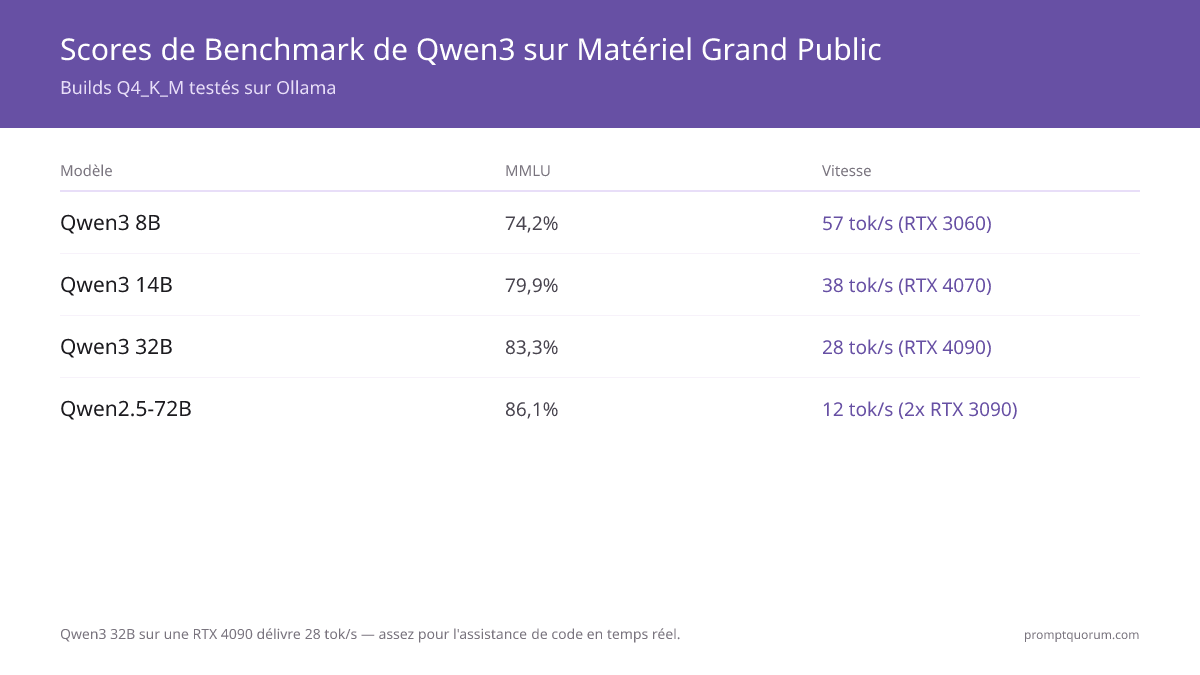
Qwen3 32B Q4_K_M sur RTX 4090 : 28 tokens/s — assez rapide pour l'assistance au code en temps réel. Scores ci-dessous pour les builds GGUF Q4_K_M testés sur Ollama.
Modèle (Q4_K_M) | MMLU | Math | HumanEval | Vitesse (RTX 3060 12 Go) |
|---|---|---|---|---|
| Qwen3 8B | 74,2 % | 58,8 % | 57,3 % | 57 tokens/s |
| Qwen3 14B | 79,9 % | 69,8 % | 64,6 % | — |
| Qwen3 32B | 83,3 % | 79,5 % | 71,3 % | — |
| Qwen2.5-72B | 86,1 % | 83,1 % | 73,2 % | — |
| Qwen3-Coder 7B | — | — | 75,6 % | 55 tokens/s |
| Qwen3-Coder 14B | — | — | 85,2 % | — |
| Qwen3-Coder 32B | — | — | 92,7 % | — |
💡Astuce: Vous voulez ce score HumanEval de 92,7 % à 27 tokens/s ? Consultez le GPU 24 Go qui exécute Qwen3-Coder 32B.
Qwen vs DeepSeek vs Llama : que déployer localement ?
Qwen3 gagne sur les tâches en langue chinoise et l'efficacité VRAM ; DeepSeek-V2.5 gagne sur le raisonnement à grande échelle mais est impraticable sur matériel grand public ; Llama 3.3 70B est la meilleure option monoGPU si vous préférez le modèle ouvert de Meta.
Niveau VRAM | Meilleur Qwen | Meilleur concurrent | Recommandation |
|---|---|---|---|
| 6 Go | Qwen3 8B | Llama 3.2 3B | Qwen3 8B — même VRAM, modèle beaucoup plus grand |
| 12 Go | Qwen3-Coder 14B | Llama 3.1 8B Instruct | Qwen3-Coder 14B pour le code ; Llama 3.1 8B pour le chat |
| 24 Go | Qwen3-Coder 32B | Llama 3.3 70B (déchargé) | Qwen3-Coder 32B pour le code ; Llama 3.3 70B si qualité > vitesse |
| 48 Go+ | Qwen2.5-72B | DeepSeek-V2.5 236B MoE | DeepSeek nécessite ~130 Go RAM ; Qwen2.5-72B est le choix pratique |
Contexte réglementaire : RGPD et CNIL
Déployer Qwen3 en local signifie qu'aucune donnée ne quitte votre machine — aucun transfert vers un serveur cloud étranger. Les API LLM cloud exigent l'envoi de prompts vers des serveurs étrangers, ce qui déclenche l'article 28 du RGPD (sous-traitant) et potentiellement les articles 44 et suivants (transferts hors UE).
Qwen3 a été entraîné par l'équipe Qwen d'Alibaba sur un corpus principalement chinois et multilingue. C'est le modèle localement déployable le plus performant pour le chinois simplifié, le traditionnel et les documents mixtes chinois/anglais/français.
Pour les déploiements professionnels : la CNIL recommande le traitement local des données personnelles sensibles dans les secteurs réglementés (médical, juridique, financier) lorsque cela est techniquement possible. Un déploiement Qwen3 sans connexion internet pendant l'inférence utilise une architecture compatible avec le RGPD (aucune donnée d'inférence envoyée à des tiers). Guide complet pour les setups hors ligne : IA locale entièrement hors ligne.
📍 En une phrase
Qwen3 fonctionne entièrement hors ligne après téléchargement — aucune donnée ne quitte votre appareil, éliminant les risques de transfert transfrontalier sous le RGPD.
💬 En termes simples
En mode local, vos prompts et documents ne quittent jamais votre ordinateur. Aucun appel API cloud, aucun serveur externe, aucune donnée accessible à des tiers ou régulateurs.
Quel matériel acheter pour déployer Qwen3 ?
Faites d'abord correspondre votre niveau Qwen cible à la VRAM nécessaire, puis achetez la carte la moins chère qui atteint ce seuil — payer pour plus de VRAM que ce dont votre modèle a besoin est la dépense excessive la plus fréquente de cette liste. Les choix ci-dessous correspondent directement au tableau matériel ci-dessus : entrée de gamme → RTX 4060, milieu de gamme → RTX 4070 Super, haut de gamme → RTX 3090/4090, Apple Silicon → Mac mini M5 Pro, usage permanent → un mini-PC. Les prix ci-dessous reflètent le marché GPU de 2026 — la pénurie de puces mémoire et la demande des datacenters IA ont fait grimper le prix des GPU neufs et des configurations mémoire Apple ; vérifiez le prix actuel avant d'acheter.
💡Astuce: Passez cette section si vous possédez déjà un GPU avec 8 Go de VRAM ou plus — exécutez d'abord Qwen3 8B sur ce que vous avez. N'achetez du nouveau matériel qu'une fois ce plafond atteint et si vous voulez un modèle plus grand.
NVIDIA RTX 4060 8 Go
Choix entrée de gamme — Qwen3 8B, Qwen3-Coder 7B (5,5 Go de VRAM)
La carte la moins chère de cette liste qui atteint le seuil de 5,5 Go requis par Qwen3 8B tout en laissant de la marge pour le contexte. Exécute Qwen3-Coder 7B à ~55 tokens/s — assez rapide pour une assistance au code interactive.
Avantages
- +Le besoin de 5,5 Go de VRAM est couvert avec de la marge pour un cache KV à contexte long
- +Prix le plus bas de cette liste — le bon premier GPU si vous n'avez jamais exécuté de LLM local
- +50–57 tokens/s sur les modèles 7B/8B, au niveau des cartes plus chères à cette taille de modèle
Inconvénients
- –Plafonne à Qwen3 8B / Qwen3-Coder 7B — aucune marge pour passer à 14B sans compresser le cache KV
NVIDIA RTX 4070 Super 12 Go
Choix milieu de gamme — Qwen3 14B, Qwen3-Coder 14B (9,5 Go de VRAM)
Exécute Qwen3-Coder 14B (85,2 % HumanEval) à 36–38 tokens/s avec 2–3 Go de VRAM restants pour le contexte — le niveau où la qualité du code progresse nettement par rapport aux modèles 7B/8B.
Avantages
- +Le modèle de 9,5 Go tient avec 2–3 Go de VRAM en réserve — de la place pour des fenêtres de contexte plus longues
- +HumanEval passe de 75,6 % (7B) à 85,2 % (14B) — le saut qualité/prix le plus clair de la gamme
- +~38 tokens/s garantissent une réactivité fluide pour le chat interactif et la complétion de code
Inconvénients
- –Pas assez de VRAM pour le niveau 32B — prévoyez de la revendre ou de la réaffecter si vous dépassez le 14B
NVIDIA RTX 4090 24 Go (ou RTX 3090 24 Go d'occasion)
Choix haut de gamme — Qwen3-Coder 32B, Qwen 3.6 27B (~17–20,5 Go de VRAM)
La 4090 délivre 27–28 tokens/s sur Qwen3-Coder 32B — une vitesse de code en temps réel à 92,7 % de HumanEval. Une RTX 3090 d'occasion offre la même VRAM de 24 Go et se situe à environ 15 % de la vitesse d'inférence de la 4090, pour un prix nettement plus bas si vous trouvez une annonce d'occasion fiable.
Avantages
- +24 Go de VRAM couvrent toutes les variantes de Qwen3 32B et Qwen 3.6 27B avec de la marge
- +27–28 tokens/s sur Qwen3-Coder 32B (92,7 % HumanEval) — assez rapide pour du pair programming en temps réel
- +La RTX 3090 d'occasion est l'alternative économique : même plafond de VRAM, environ 15 % plus lente, nettement moins chère d'occasion
Inconvénients
- –Coût initial le plus élevé de cette liste — justifié seulement si vous avez réellement besoin d'une qualité de niveau 32B
Apple Mac mini M5 Pro 64 Go
Choix Apple Silicon — Qwen3 32B, silencieux et basse consommation
Le meilleur rapport qualité/prix pour exécuter Qwen3 32B avec de la mémoire unifiée — silencieux, faible consommation électrique, aucun GPU séparé à installer. Pour Qwen2.5-72B, il faut plutôt le M2 Ultra 192 Go.
Avantages
- +Les configurations M5 Pro montent jusqu'à 64 Go de mémoire unifiée — bien au-delà des 20,5 Go requis par Qwen3 32B, avec de la marge pour d'autres applications
- +Fonctionnement silencieux et consommation adaptée à un bureau — aucune gestion de refroidissement de GPU dédié
- +Un seul achat couvre le système, le stockage et l'inférence — pas de montage GPU/alimentation/boîtier séparé
Inconvénients
- –Aucun benchmark indépendant de Qwen3 32B sur la puce M5 Pro n'est encore publié — attendez-vous à des performances nettement plus lentes qu'un GPU dédié comme la RTX 4090, dans la continuité des générations précédentes d'Apple Silicon sur Mac mini
MINISFORUM UM890 Pro (ou mini-PC AMD Ryzen AI similaire)
Choix usage permanent — Qwen3 8B sur CPU + iGPU (~8–12 tokens/s, moins de 35 W)
Pas conçu pour un usage interactif — il s'agit d'une instance Qwen3 8B laissée en fonctionnement 24 h/24 et 7 j/7 pour des tâches en arrière-plan, la domotique, ou un point de terminaison API à faible trafic où le coût énergétique compte plus que la vitesse.
Avantages
- +Consommation inférieure à 35 W — peu coûteux à faire tourner en continu, contrairement à une configuration de bureau avec GPU
- +Format compact qui se glisse partout ; aucun GPU séparé à trouver ou refroidir
- +Fait tourner Qwen3 8B sans aucun GPU dédié
Inconvénients
- –8–12 tokens/s est trop lent pour un chat interactif — un choix réservé à l'arrière-plan/API
Erreurs courantes avec Qwen3 en local
- Utiliser `ollama pull qwen2.5` sans tag de taille. Sans tag explicite (`:7b`, `:14b`, etc.), Ollama peut résoudre vers une taille par défaut qui change entre les mises à jour. Toujours utiliser des tags explicites.
- Ignorer la taille de la fenêtre de contexte. Qwen3 supporte 128K de contexte. La spécification du Modelfile d'Ollama fixe `num_ctx` à 2048 par défaut, mais le runtime applique en réalité une valeur par défaut échelonnée selon la VRAM : 4K en dessous de 24 Gio, 32K entre 24 et 48 Gio, 256K au-delà de 48 Gio. Ne comptez sur aucun des deux réglages par défaut : définissez `num_ctx` explicitement, par exemple en ajoutant `--num-ctx 8192` (ou plus) à la commande d'exécution — sinon le modèle tronque silencieusement l'entrée.
- Choisir la quantification Q2_K pour du chinois. À 2 bits, la sortie en langue chinoise de Qwen3 se dégrade notablement. Utiliser au minimum Q4_K_M pour tout travail en CJK.
- Exécuter le modèle 32B avec trop peu de VRAM. Si votre GPU a 16 Go et que le modèle en nécessite 20,5 Go, Ollama décharge des couches en RAM — le modèle tourne à 3–5 tokens/s, inutilisable en interactif.
- Utiliser la mauvaise sous-famille pour le code. Qwen3 8B (usage général) : 57,3 % sur HumanEval. Qwen3-Coder 7B : 75,6 % — soit +32 % de performance relative. Toujours utiliser la variante Coder pour le code.
Étapes suivantes
- Meilleurs LLM CPU uniquement — Pas de GPU ? Découvrez quelles tailles Qwen3 tournent sur CPU →
- Quantification LLM expliquée — Q4_K_M vs Q8 vous perturbe ? La quantification expliquée →
Questions fréquentes
Quelle quantité de VRAM est nécessaire pour Qwen3 8B en local ?
Qwen3 8B Q4_K_M nécessite 5,5 Go de VRAM. Une RTX 3060 6 Go, RTX 4060 ou puce Apple M avec 8 Go de mémoire unifiée suffisent.
Quel est le meilleur modèle Qwen pour le code en local ?
Qwen3-Coder 32B — 92,7 % sur HumanEval, GPU 24 Go requis. Avec 12 Go de VRAM : Qwen3-Coder 14B (85,2 %, 9,5 Go VRAM).
Comment Qwen se compare-t-il à DeepSeek ?
Qwen3 utilise une architecture dense compatible matériel grand public. DeepSeek-V2.5 nécessite ~130 Go RAM — inaccessible sans GPU serveur.
Puis-je utiliser Qwen sur un Mac ?
Oui. M2 Pro 32 Go : Qwen3 14B à ~32 tokens/s. M3 Max 64 Go : Qwen3 32B à ~22 tokens/s.
Quelle commande Ollama utiliser pour Qwen ?
Pour le modèle phare, `ollama run qwen3.6:27b` (~17 Go de VRAM). Pour Qwen3, `ollama pull qwen3:8b`. Pour Qwen2.5, `ollama pull qwen2.5:7b` pour 7B, `:14b` pour 14B, `:32b` pour 32B, ou `qwen2.5-coder:32b` pour la variante code. Toujours des tags explicites.
Qwen est-il adapté aux tâches en langue chinoise ?
Oui. Qwen3 supporte nativement le chinois simplifié, traditionnel, le japonais, le coréen et 24 autres langues.
Quelle quantification utiliser pour Qwen3 ?
Q4_K_M par défaut — ~55 % de réduction VRAM, moins de 1 % de perte de qualité vs FP16. Éviter Q2_K pour les usages en langue chinoise.
Qwen2-VL fonctionne-t-il pour l'OCR de documents chinois ?
Oui — `ollama pull qwen2-vl:7b`, ~6 Go VRAM, lectures jusqu'à 4096×4096 pixels en CJK.
Qwen3 est-il compatible avec le RGPD ?
En déploiement local, Qwen3 utilise une architecture compatible avec le RGPD (aucune donnée d'inférence envoyée à des tiers) — pas de DPA requis pour la couche IA selon l'article 28 du RGPD. La CNIL recommande le traitement local pour les données sensibles.
Qwen3 peut-il traiter des documents mixtes français-chinois ?
Oui. Qwen3 gère nativement le français et le chinois dans le même contexte. Pour l'OCR de documents mixtes, Qwen2-VL 7B est plus adapté.