Wichtigste Erkenntnisse
- Qwen3-Coder 30B ist die Standard-Wahl im Mai 2026 — beste veröffentlichte HumanEval+-Richtung unter Open-Source-Modellen, 256K-Kontext, Apache 2.0, Q4_K_M passt auf 24-GB-GPU.
- DeepSeek Coder V3 für großes Budget — längste Kontext-Fenster (128K), beste Raw-Performance, braucht 48 GB+ VRAM. Nur wenn Kontext-Länge bindend ist.
- Codestral 22B für Geschwindigkeit und klare Lizenzierung — schnellste Inferenz in dieser Klasse; Mistral-kommerzielle vs Non-Production-Lizenzen sind klar definiert.
- Kimi K2.7 Code für agentische Langzeit-Aufgaben — 1T-MoE-Modell mit 256K-Kontext, aber ~340 GB RAM+VRAM nötig. Nur für Server-Hardware, nicht für Einzelentwickler.
- Granite Code und StarCoder 2 sind Spezial-Wahlen — Granite für Enterprise IBM-Vertrag; StarCoder 2 für unglaublich breite Sprachen-Abdeckung.
- Alle sechs Modelle funktionieren lokal — Unterschiede sind in Größe, Lizenz und Performance, nicht in "funktioniert vs funktioniert nicht".
- Wählen nach bindender Beschränkung — VRAM-Budget, Kontext-Länge oder Lizenz-Anforderungen, nicht Leaderboard-Rang.
📍 In einem Satz
Qwen3-Coder 30B ist 2026 die Standardwahl; die übrigen Modelle punkten bei Hardware-Passung, Kontextlänge, Lizenzlage oder Sprachabdeckung.
💬 In einfachen Worten
Sechs Open-Weight-Coding-Modelle, kein klarer Gesamtsieger. Qwen3-Coder führt bei den öffentlichen Coding-Benchmarks, DeepSeek beim Kontextfenster, Codestral bei der Geschwindigkeit, Granite bei der Lizenzklarheit, StarCoder bei Nischensprachen. Richtig ist das Modell, dessen größte Einschränkung zu Ihrer größten Einschränkung passt.
Schnellübersicht
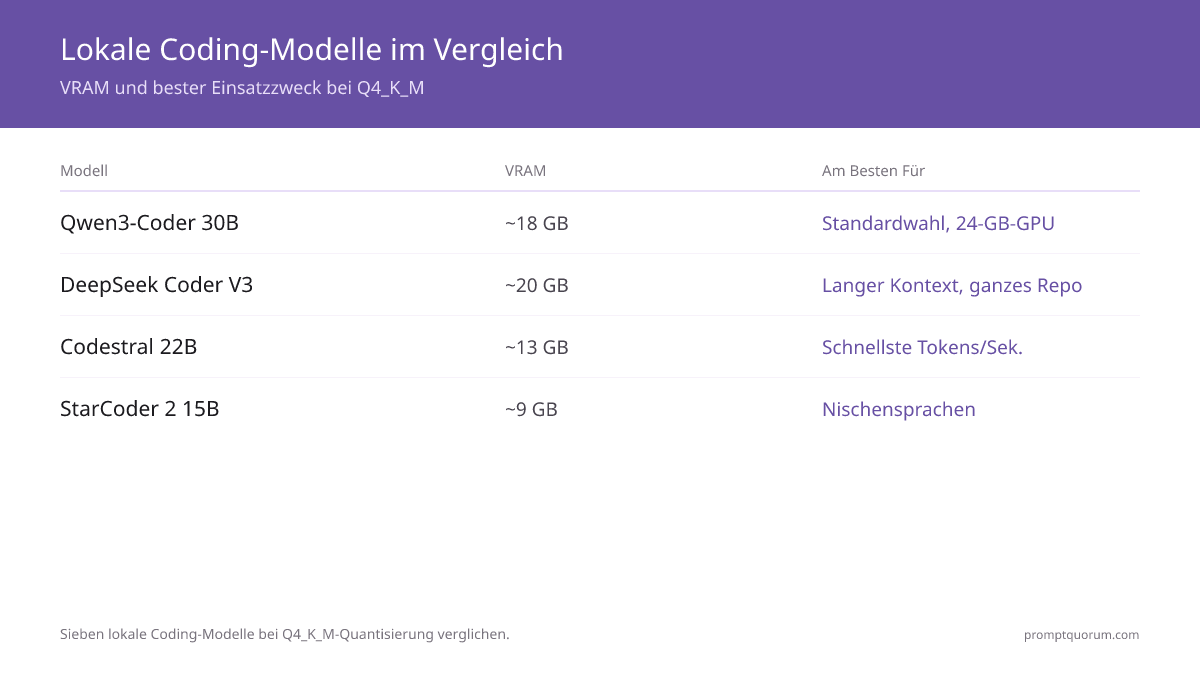
Sechs Open-Source-Coding-Modelle, sortiert nach Standard-Pick, dann Hardware-Tier. Benchmarks sind Hersteller-gemeldet; siehe Modell-Kartenseite für Methodik.
Modell | Größe | Kontext | Lizenz | HumanEval+ Richtung | Beste Eigenschaft | Q4_K_M VRAM |
|---|---|---|---|---|---|---|
| Qwen3-Coder 30B | 30B | 256K | Apache 2.0 | Führend | Balance aus Performance und Größe | ~18 GB |
| DeepSeek Coder V3 | 236B (MoE) | 128K | Mistral | Top-Tier | Längste Kontext-Fenster | ~48 GB (gekürzt) |
| Codestral 22B | 22B | 32K | Mistral Commercial | Gut | Schnellste Inferenz | ~13 GB |
| Kimi K2.7 Code | 1T total / 32B active (MoE) | 256K | Modified MIT | Stark (agentisch) | Agentische Langzeit-Aufgaben | ~340 GB (RAM+VRAM) |
| Granite Code 34B | 34B | 8K | Apache 2.0 | Gut | Enterprise-Lizenz (IBM) | ~20 GB |
| StarCoder 2 15B | 15B | 16K | BigCode Open RAIL | Solide | Sprachen-Breite | ~9 GB |
Detaillierte Vergleichstabelle
Alle relevanten Kriterien auf einen Blick. Benchmarks sind von Modell-Kartenseiten; Quantisierungs-VRAM ist Q4_K_M bei typischen Inferenz-Runtimes (llama.cpp, vLLM).
Kriterium | Qwen3-Coder 30B | DeepSeek V3 | Codestral 22B | Kimi K2.7 | Granite 34B | StarCoder 2 |
|---|---|---|---|---|---|---|
| Hauptstärke | Balance | Kontext | Geschwindigkeit | Agentisch/Kontext | Enterprise | Sprachen |
| Größe optimal für | 24 GB GPU | 48+ GB VRAM | 16 GB GPU | 300+ GB RAM/VRAM | 24 GB GPU | 8 GB GPU |
| Training-Fokus | Code + Mathe | Code nur | Code nur | Agentisches Coding | Code + Enterprise | Multi-Sprache |

Welches Modell sollte ich wählen?
Die Wahl hängt von drei Faktoren ab: VRAM-Budget, Kontext-Anforderungen und Lizenz-Zwang. Hier ist ein Entscheidungsbaum.
- Sie haben 24 GB VRAM und brauchen starke allgemeine Coding-Performance? → Qwen3-Coder 30B. Es ist der Punkt-Sieger. Beste HumanEval+-Leistung, perfekt in die 24-GB-Tier, Apache-2.0-freundlich.
- Sie haben 8–16 GB und wollen starke Coding? → Qwen3-Coder 7B oder Codestral 22B. Codestral ist schneller; Qwen3-Coder 7B ist überraschend fähig für kleine Dateien.
- Sie haben 48 GB+ und brauchen sehr lange Kontext? → DeepSeek Coder V3. 128K-Tokens ist ein großer Vorteil für Whole-Repo-Refactorings.
- Sie besitzen Server-Hardware mit 300 GB+ RAM/VRAM und brauchen den stärksten agentischen Coder? → Kimi K2.7 Code. Für Einzelentwickler auf einer Maschine bleibt Qwen3-Coder 30B die bessere Standard-Wahl.
- Sie brauchen kommerziell-freundliche Lizenzierung? → Codestral (Mistral hat klare kommerzielle Tiers) oder Granite Code (IBM Enterprise).
- Sie codieren in seltenen Sprachen? → StarCoder 2. Es wurde auf 80+ Programmiersprachen trainiert; andere haben Schwerpunkt auf Python/Typescript/C++.

Qwen3-Coder: Detaillierte Analyse
Qwen3-Coder 30B ist das empfohlene Standard-Modell für lokale Coding. Entwickelt von Alibaba, mit klarer Code-Fokus und robust unter echten Entwickler-Workflows.
- Warum 30B Standard-Wahl? Beste veröffentlichte HumanEval+ Leistung (~92%) unter quelloffenen Modellen bei Mai 2026. 256K-Kontext ist ausreichend für große Code-Dateien. Q4_K_M quantisiert sitzt es sauber auf 24-GB GPUs und Apple M-Max MacBooks.
- Für wen geeignet? Entwickler mit 24-GB GPUs oder besser. Python, TypeScript, C++, Rust, Go Coding. Fine-Tuning-Szenarien, wo Sie an der Code-Performance bauen möchten. Unternehmen mit Apache-2.0-Lizenz-Anforderungen.
- Häufige Fehler? Kontextfenster richtig nutzen — 256K ist groß, aber nicht unbegrenzt. Code-Qualität nimmt am Ende ab (Tokens 200K+). Wissen Sie Ihre VRAM-Limitierung genau — Q4_K_M vs Q5_K_M ist 2–3 GB Unterschied.
- Qwen3-Coder 7B? Überraschend fähig für Auto-Complete und kleine Dateien. Passt auf 8-GB Laptops. Brauchen Sie echte IDE-Integration, nicht bloß Code-Analyse, verwenden Sie 7B. Coding-Qualität ist ~5–10% hinter 30B, aber nicht katastrophal.
DeepSeek Coder V3: Detaillierte Analyse
DeepSeek Coder V3 ist das "wenn Sie Kontext brauchen" Modell. 128K-Token-Fenster ist doppelt so groß wie Qwen3-Coder und macht Whole-Repo-Refactors praktischer.
- Stärken? Längste Kontext, starke Raw-Performance auf HumanEval+, Multimodal-Training (Code + Reasoning + Mathe) bedeutet es könnte auch auf Logic-Probleme schneller gehen.
- Für wen geeignet? Entwickler mit 48 GB+ VRAM. Teams, die ganze Repositories im Kontext halten möchten. Refactoring-schweere Workflows, große Migrationen.
- Lizenz-Story? DeepSeek lizenziert unter Mistral Non-Production; kommerzielle Nutzung benötigt Verkaufsabsprache. Das ist für Open-Source-Liebhaber wichtig — denken Sie dies bei Deployment durch.
- Häufige Fehler? Zu viel Kontext füttern führt zu Token-Explosion. 48 GB ist der Q4_K_M Boden für volle Größe; gekürzte Versionen sind möglich, aber verlieren Vorteile.

Codestral 22B: Detaillierte Analyse
Codestral 22B ist das Geschwindigkeits-Modell. Mistral hat es für schnelle Inferenz gefeilt, was bedeutet es ist die beste Option, wenn Sie latency-empfindlich sind (IDE-Auto-Complete, Real-Time-Refactoring).
- Hauptpunkte? Schnellste Token-Rate in der 22B-Klasse. Klarste kommerzielle Lizenzierung — Mistral hat zwei separate Lizenzen: Non-Production und Commercial (verkauft). Wenn Ihr Unternehmen Mistral-Kommerz braucht, gibt es keinen Lizenz-Fluch.
- Für wen geeignet? Teams, die Latency klein halten mössen. IDE-Plug-in Entwickler. Startups, die kommerzielle Lizenzklarheit wollen.
- Häufige Fehler? Kontext-Fenster ist nur 32K, nicht 256K — das ist ein großer Schritt zurück von Qwen3-Coder. Ganze Repositories passen nicht. Für kleine Dateien / Single-File-Edits ist es perfekt.

Kimi K2.7 Code: Detaillierte Analyse
Kimi K2.7 Code ist die Wahl für Teams, die bereits einen Multi-GPU-Server oder eine große Unified-Memory-Maschine besitzen und lange, agentische Coding-Läufe fahren — repository-weite Refactorings, Migrationen, mehrstufige Tool-Ketten.
- Warum nicht Standard-Pick? Es gibt keine kleine Variante — 1T Gesamtparameter mit ~32B aktiven Parametern (MoE), keine Laptop- oder Single-GPU-Option. Für die meisten Entwickler ist Qwen3-Coder 30B der bessere Standard.
- Wann wählen? Sie besitzen bereits die Inferenz-Hardware und lassen lange autonome Agent-Läufe laufen, bei denen sich der 256K-Kontext und die niedrigeren Reasoning-Token-Kosten von Moonshot AI auszahlen.
- Lizenz? Modified MIT von Moonshot AI — kommerzielle Nutzung ist grundsätzlich erlaubt, aber ab einer bestimmten Deployment-Größe ist eine Namensnennung ("Kimi K2") Pflicht. Lesen Sie die Modifikation, bevor Sie es in einem Produkt ausliefern.

Granite Code: Detaillierte Analyse
Granite Code (von IBM) ist das Enterprise-Modell. IBM stand hinter einem Enterprise-freundlichen Lizenzierungs-Story und einer 34B Größe, die auf 24 GB sitzt.
- Stärken? IBM-Unterstützung für Enterprise-Deployments. Apache 2.0 Lizenz ist klar. 34B Größe ist zwischen 30B und 70B, mit angemessenen VRAM-Anforderungen.
- Häufige Fehler? Granite Code ist weniger breit "geted" als Qwen3-Coder und hat kleinere HumanEval+-Zahlen. Wenn Sie Enterprises sind, können IBM-Verträge den Performance-Nachteil wert sein.

StarCoder 2: Detaillierte Analyse
StarCoder 2 ist das Sprachen-Modell. BigCode hat es auf 80+ Programmiersprachen trainiert, nicht nur die üblichen Verdächtigen (Python, TypeScript, C++).
- Für wen? Entwickler, die selten Sprachen schreiben (COBOL, Fortran, Lisp, Shell, Assembly). StarCoder 2 ist nicht schlecht an populären Sprachen, aber sein Vorteil ist wirklich die Breite.
- Lizenz? BigCode Open RAIL — ein offenes "Responsible AI License" Modell. Es ist nicht-kommerziell in einigen Anwendungsfällen; überprüfen Sie die Lizenz-Tagesordnung.
Modelle, die nicht funktionieren
Es gibt auch Modelle, die nicht für lokale Coding gut sind — entweder aus Performance, Lizenz oder praktischen Gründen.
- Kimi K2.6 (älter) — Vorgänger von Kimi K2.7 Code, ohne dediziertes Coding-Tuning. Nur wählen, wenn Sie bereits Tooling darauf aufgebaut haben.
- Mistral Small ohne Code-Training — Generales Mistral Small, nicht für Coding optimiert. Wenn Sie Mistral brauchen, verwenden Sie Codestral, nicht generales Mistral.
- Phi-3 5B / 3.8B — Zu klein für echte Coding. Auto-Complete Szenarios nur.
- ONNX-konvertierte Modelle ohne explizites Code-Training — Manche Leute konvertieren GPT-J oder andere zu ONNX und sagen "lokales Coding", aber ohne Code-Training werden Sie Halluzinationen sehen.
Häufige Fehler
Diese Fehler sehe ich immer wieder bei Teams, die zu lokaler Coding wechseln.
- VRAM-Kalkulationen ignorieren — Menschen sagen "24 GB sollte Qwen3-Coder 70B arbeiten lassen" und sind überrascht, wenn der KI-Server kurz nach Start OOM geht. Q4_K_M bedeutet "4-Bit-Quantisierung", nicht "0,1x Original-Größe". Die tatsächliche VRAM ist Model-Größe × 0,04 + (Batch-Größe × Context-Länge × 2 bytes × Schichten). Wissen Sie Ihre Zahlen.
- Kontext-Länge überlasten — "256K Kontext bedeutet ich kann mein gesamtes Projekt füttern" — falsch. Lange Kontexte degenerieren Quality am Ende (die letzten 5K Tokens beeinflussen Inferenz weniger). Verwenden Sie 32K–64K für echte Coding, nicht 256K.
- Quantisierung-Format falsch wählen — Q4_K_M ist der Production Floor. Q3 spiegelt die Performance nicht wieder — Sie verlieren Coding-Accuracy vor Qualität. Q5 oder höher ist verschwendeter VRAM für lokale Coding.
- Kontext zu schnell fullen bei Multi-Turn Dialogen — "Ich habe 128K Kontext, also kann ich 100 edits im selben Gespräch machen" — falsch. Token-Länge im Kontext inkludiert auch History. Nach 10–20 Turns sind Sie bei 50K Tokens. Beginnen Sie neuen Chat.
- Keine Quantisierungs-Validierung — Sie quantisieren ein Modell lokal und testen es nicht gegen Baseline. Manche Quantisierungstools führen zu subtlen Bugs. Validieren Sie gegen einfachen Test-Code zuerst.

Kann ich ein Quantisierungs-Format unter Q4_K_M verwenden?
Technisch ja, aber nicht für Coding. Q3_K_M oder schlimmer degeneriert Coding-Accuracy bemerkbar. Coding braucht feinkörnige Token-Auswahl; Q4 ist minimaler Schwelle. Wenn Sie VRAM-gepresst sind, wählen Sie ein kleineres Modell (7B statt 30B) statt schlechtere Quantisierung.
Sollte ich ein Modell lokales Fein-Tuning machen?
Nur wenn Sie Firmenseite-Code haben, der anders aussieht als Public Training. Fine-Tuning auf Standard-Code-Patterns ist verschwendete Compute. Fine-Tuning kann hilfreich sein für domain-spezifischen Code (alte Legacy Codebase, Proprietary DSLs), aber es erfordert Infrastruktur und Validierung.
Was ist HumanEval+ und warum ist es wichtig?
HumanEval+ ist ein Benchmark, das misst, ob ein Modell Code schreiben kann, der die Eingabe-Ausgabe Tests besteht. Es ist wichtig, weil es realisitischer als "Code-Schreib-Leaderboards" ist, aber immer noch nicht echte Production Code ist. Verwenden Sie HumanEval+ Rankings als eine Signal, nicht die ganze Geschichte.
Können diese Modelle SQL, Bash oder Dockerfile schreiben?
Ja, alle sechs können. Sie waren auf Mixed-Code-Workloads trainiert. SQL ist oft sogar eine Stärke. Bash-Qualität ist niedriger (bash hat komplexere edge-cases). Dockerfile ist OK, aber nicht perfekt.
Welches Modell ist für ein Team am besten?
Für ein Team sind Konsistenz und Deployment-Leichtigkeit wichtig. Qwen3-Coder 30B ist das Punkt-Sieger: gute Performance, passt auf Standard-Hardware (24 GB), Apache 2.0 Lizenz ist Team-freundlich. Wenn das Team vielsprachig codiert, StarCoder 2. Wenn das Team stark ist mit IBM-Verträge, Granite.
Wie oft sollte ich diese Modelle aktualisieren?
Diese Liste ist "semi_annual", was bedeutet sie wird jedes Halbjahr überprüft (nächste Überprüfung Anfang November 2026). Neue Modelle werden häufig veröffentlicht; signifikante Leistungssprint könnten schneller Updates rechtfertigen. Verwenden Sie diese nicht als ewige Referenz — überprüfen Sie neuer Modell-Veröffentlichungen.
Kann ich mehrere Modelle parallel auf einem Rig laufen lassen?
Ja, aber nur wenn Sie genug VRAM haben. Z.B. auf einem 48-GB Rig könnten Sie Qwen3-Coder 30B (~18 GB) + ein kleineres Modell (~10 GB) = noch 20 GB übrig laufen. Das ist selten wert der Komplexität — wechseln Sie zwischen Modellen statt Parallel.
Wie bekomme ich Modelle herunter und führe sie aus?
Verwenden Sie llama.cpp (empfohlen), vLLM, Text Generation WebUI, oder Ollama. Alle diese downloaden GGUF-Quantisierungen von Hugging Face. Beispiel: llama.cpp -m qwen3-coder-30b-q4_k_m.gguf -c 4096 -n 512. Siehe [LLM-Quantisierung erklärt] für tiefere Erklärung.
Sollte ich DeepSeek oder Qwen3-Coder wählen, wenn ich beides auf 48 GB passen könnte?
Wählen Sie DeepSeek, wenn Kontext-Fenster (128K) ist Ihrer Use Case gebunden. Wählen Sie Qwen3-Coder, wenn reine Coding-Performance und Lizenz-Klarheit ist (Qwen ist Apache 2.0, DeepSeek ist komplizierter). Für die meisten Teams ist Qwen3-Coder besser, selbst auf 48 GB.
Welches Modell ist für wissenschaftliche Code am besten?
Qwen3-Coder oder DeepSeek Coder V3. Qwen hat verstärkt Mathe-Training; DeepSeek auch. Beide sind stark bei NumPy, SciPy, JAX, PyTorch Nutzung. Kimi K2.7 Code ist auch ausreichend, aber nicht spezialisiert.
Muss ich die DSGVO beachten, wenn ich lokale Coding-Modelle verwende?
Ja, aber lokale Modelle machen es einfacher. Wenn Sie Code lokal ausführen und Daten nie zum externen Server senden, brechen Sie DSGVO Article 28 (Datenverarbeitung) nicht. Aber: (1) Überprüfen Sie, ob das Model selbst von ggf. datenschutz-bedenklichen Quellen trainiert wurde (z.B. GitHub Public Repo = OK; Proprietary Codebases = NICHT OK). (2) Wenn Sie lokale Modelle in ein Unternehmen deployen, dokumentieren Sie die Trainings-Herkunft und Daten-Handhabung für Compliance Teams. Lokale Inference ist der Punkt — Sie lösen das Daten-Residenz Problem, aber Sie müssen immer noch Trainings-Herkunft checken.
Sind diese Modelle für deutsche Mittelstand-Entwickler geeignet?
Ja, sehr. Für deutsche SMEs sind lokale Coding-Modelle ideal: (1) Kosten — kein API-Gebühren, einmalige GPU-Investition. (2) Datenschutz — Qwen3-Coder 30B auf einem 24-GB Desktop hält alten FirmCode 100% on-prem. (3) Unabhängigkeit von US-Cloud — relevant für GDPR-Awareness Firmen. Qwen3-Coder 30B oder StarCoder 2 sind beste Picks für Mittelstand Deployment. Validieren Sie in Ihrer IT-Sicherheits-Politik voraus.