빠른 사실
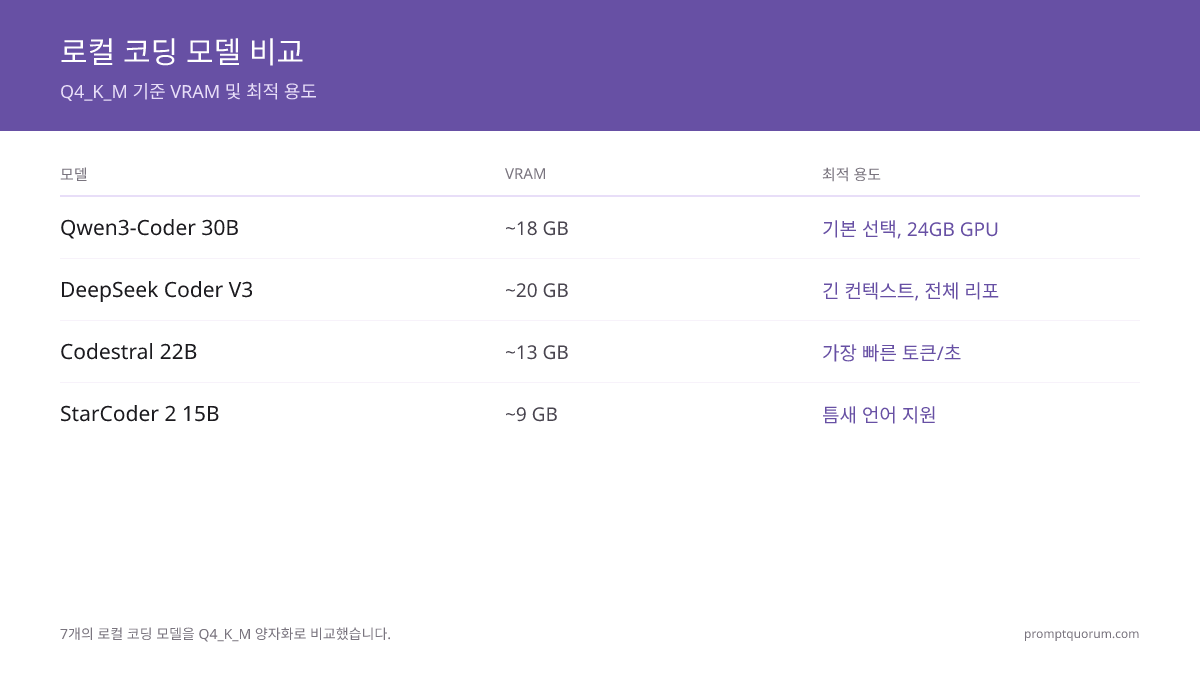
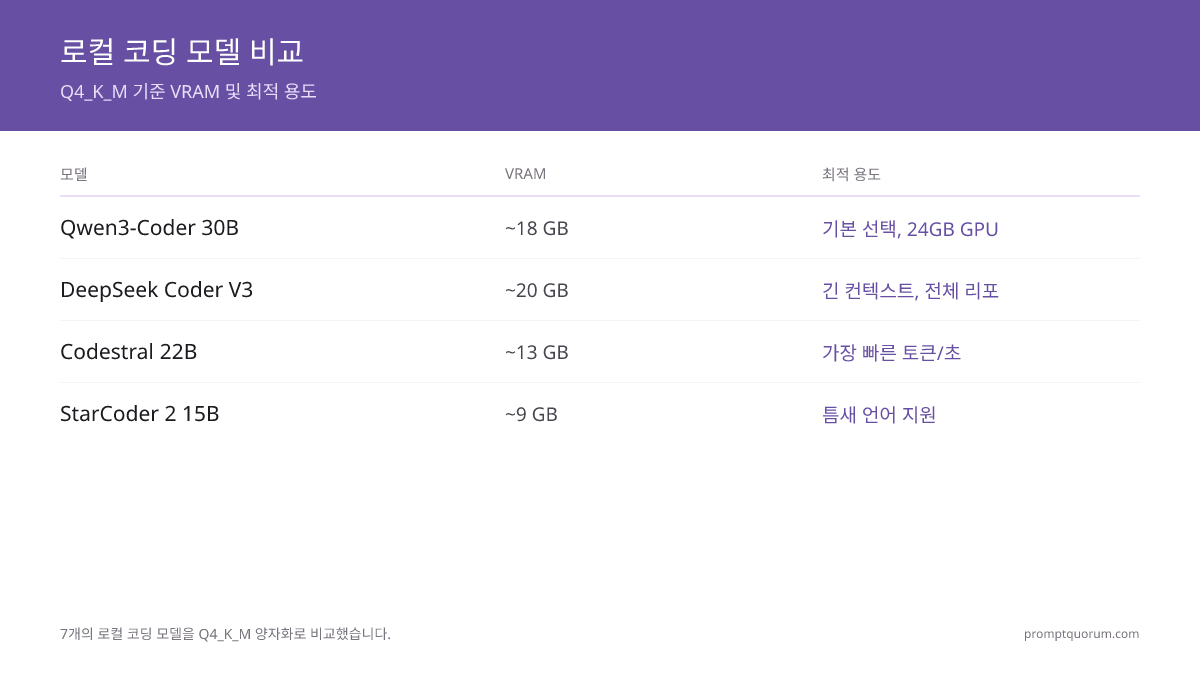
- 최적 선택지(2026년 5월): 24 GB GPU에서 Q4_K_M으로 Qwen3-Coder 30B.
- 노트북/8-10 GB GPU 선택지: Q4_K_M으로 Qwen2.5-Coder 7B (~5 GB).
- 긴 컨텍스트 선택지: VRAM 48 GB 이상에서 Q4_K_M으로 DeepSeek-V3.
- 속도 선택지: Q4_K_M으로 Codestral 22B — 22B+ 수준에서 가장 빠름.
- 엔터프라이즈/감사 적합 선택지: Granite Code 34B(IBM, Apache 2.0).
- 틈새 언어 선택지: StarCoder 2 15B(Rust, Lua, Haskell, Solidity 커버리지).
- Q4_K_M VRAM 계산: 약
(파라미터 수 B) × 0.6 GB더하기 컨텍스트 오버헤드 2-4 GB. - 라이선스는 동일하지 않습니다. Qwen3-Coder, DeepSeek-V3, Granite Code는 Apache 2.0입니다. Codestral은 별도 상업 조건이 있는 Mistral Non-Production 라이선스입니다. Kimi K2.7 Code(Moonshot AI)는 Modified MIT를 사용하며, 대규모 배포 시 출처 표시가 필요합니다. StarCoder 2는 BigCode OpenRAIL-M으로 배포됩니다.
2026년 6개 로컬 코딩 모델 비교
아래 모든 데이터는 인용된 모델 카드에서 공개적으로 검증 가능합니다(출처 섹션 참조). HumanEval+ 방향성은 공급사가 보고한 것입니다. 절대적 정확도가 아닌 순위 신호로 취급하십시오 — 프로덕션 결정 전에 모델 카드를 확인하십시오.
📍 한 문장으로
Qwen3-Coder 30B는 2026년 5월 기본 선택지이며, 나머지 다섯 모델은 각각 하드웨어 적합성, 컨텍스트 길이, 라이선스 포지셔닝, 언어 커버리지에서 고유한 강점을 제공합니다.
💬 쉽게 말하면
오픈 웨이트 코딩 모델 6개, 모든 것에서 명확한 승자는 없습니다. Qwen3-Coder는 공개 코드 벤치마크 방향성에서 선두; DeepSeek는 컨텍스트 창에서 선두; Codestral은 속도에서 선두; Granite는 라이선스 명확성에서 선두; StarCoder는 틈새 언어 커버리지에서 선두. 올바른 선택은 주요 제약에 가장 잘 맞는 것입니다.
모델 | 크기 | VRAM (Q4_K_M) | 컨텍스트 창 | 라이선스 | 최적 사용 사례 |
|---|---|---|---|---|---|
| Qwen3-Coder 30B | ~30B 파라미터 | ~17-18 GB | 256K | Apache 2.0 | 2026년 5월 24 GB GPU의 기본 선택지 |
| Qwen2.5-Coder 7B | ~7B 파라미터 | ~5 GB | 128K | Apache 2.0 | 노트북, 8-10 GB GPU, 자동완성 워크로드 |
| DeepSeek-V3 | MoE, 전체 중 활성 ~36B | ~48 GB+ (전체); 더 작은 변형 ~24 GB | 128K (확장 가능) | Apache 2.0 | 긴 컨텍스트, 멀티파일, 저장소 수준 추론 |
| Codestral 22B | ~22B 파라미터 | ~13 GB | 32K | Mistral Non-Production (Mistral 경유 상업적) | 빠른 추론, EU 팀의 상업 라이선스 경로 |
| Kimi K2.7 Code | 1T 총 파라미터 / 32B 활성 (MoE) | ~340 GB (RAM+VRAM) | 256K | Modified MIT | 서버급 에이전틱 코딩, 장시간 작업 |
| Granite Code 34B | ~34B 파라미터 | ~20 GB | 128K | Apache 2.0 | 엔터프라이즈 감사, 예측 가능한 라이선스 포지셔닝 |
| StarCoder 2 15B | ~15B 파라미터 | ~9 GB | 16K | BigCode OpenRAIL-M | 틈새 언어 포함 광범위한 언어 커버리지 |
어떤 것을 선택해야 합니까
올바른 모델은 리더보드 순위가 아닌 주요 제약 — VRAM, 컨텍스트 창, 라이선스 — 에 의해 결정됩니다. 다음 빠른 참조를 사용하십시오.
상황 | 선택지 |
|---|---|
| 24 GB GPU가 있고 최고의 범용 로컬 코딩 모델을 원합니다 | Qwen3-Coder 30B |
| 12-16 GB GPU가 있고 일상 작업에 견고한 모델을 원합니다 | Qwen2.5-Coder 7B(품질 여유) 또는 Codestral 22B(속도 여유) |
| 8 GB GPU 또는 16 GB MacBook이 있습니다 | Qwen2.5-Coder 7B |
| VRAM이 48 GB 이상이고 전체 저장소 작업을 합니다 | DeepSeek-V3 |
| 상업 제품을 구축하고 있으며 라이선스 명확성이 최우선입니다 | Granite Code 34B(Apache 2.0) 또는 DeepSeek-V3(Apache 2.0) |
| 서버급 하드웨어(300GB 이상 RAM/VRAM)를 보유하고 있으며 가장 강력한 에이전틱 코더를 원합니다 | Kimi K2.7 Code |
| Rust, Lua, Haskell, Solidity 또는 기타 틈새 언어로 코딩합니다 | StarCoder 2 15B |
| 절대적 품질보다 초당 토큰이 우선입니다 | Codestral 22B |

Qwen3-Coder: 기본 로컬 코딩 선택지
Qwen3-Coder는 Alibaba의 오픈 웨이트 코딩 모델 라인이며, 2026년 5월 기준 기본 로컬 코딩 모델입니다. 그룹에서 공개적으로 보고된 가장 견고한 HumanEval+ 방향성, 256K 컨텍스트 창, Apache 2.0 라이선스를 결합합니다 — 단일 모델에서 세 가지 특성이 함께 나타나는 경우는 드뭅니다.
- 크기: 30B(주력 모델)와 7B(노트북 및 8 GB GPU 모델). 둘 다 밀집 트랜스포머(mixture-of-experts 아님).
- 컨텍스트 창: 30B는 256K 토큰; 7B는 128K. MoE 파생 모델 없이 그룹에서 가장 큰 컨텍스트 중 하나.
- 학습 중점: Python, TypeScript/JavaScript, Java, C++, Go, Rust 커버리지가 강한 코드 중심 다국어 학습 코퍼스. 툴 콜링 예제가 사후 학습 믹스의 일부.
- 라이선스: Apache 2.0 — 추가 라이선스 없이 상업적 이용 허용, 귀속 보존 포함.
- Q4_K_M VRAM: 30B는 약 17-18 GB에 적합하여 24 GB 카드에 컨텍스트와 도구를 위한 여유를 남깁니다. 7B는 약 5 GB에 적합.
- 툴 콜링 신뢰성: 엄격한 도구 스키마(Cline, Continue.dev 에이전트 모드)를 사용하는 하네스에서 오픈 웨이트 코딩 모델 중 가장 견고합니다. Cline이 요구하는 XML 형식 신뢰성은 30B에서 높고; 7B에서는 덜 신뢰할 수 있습니다.
- 빛나는 곳: 범용 코드(Python, TypeScript), 대형 컨텍스트 작업(전체 파일 리팩토링), 툴 사용이 있는 에이전트 루프.
- 약한 곳: 7B 변형은 크기 대비 우수하지만 멀티스텝 추론에서 30B와 동등하지 않습니다. 틈새 언어(Lua, Haskell, Solidity)는 StarCoder 2보다 커버리지가 적습니다.
💡팁: 24 GB GPU에서, 채팅/에이전트 역할에는 Q4_K_M으로 Qwen3-Coder 30B를, 별도의 자동완성 프로세스에는 Q4_K_M으로 Qwen3-Coder 1.5B를 실행하십시오. 총 VRAM: ~19 GB. 이 분할은 큰 모델이 채팅에서 사소하지 않은 작업을 처리하는 동안 자동완성 지연 시간을 200ms 미만으로 유지합니다.
DeepSeek-V3: 긴 컨텍스트를 위한 고사양 모델
DeepSeek-V3는 컨텍스트 길이가 주요 제약일 때 선택하는 모델입니다. mixture-of-experts(MoE) 아키텍처를 사용하여 적당한 수의 활성 파라미터로 견고한 추론을 제공하지만, 전체 모델의 무거운 풋프린트가 하드웨어 결정을 조건부로 만듭니다.
- 아키텍처: MoE — 총 파라미터는 추론 시 활성 파라미터보다 훨씬 많습니다. 전체 모델은 활성 카운트가 시사하는 것보다 디스크와 VRAM에서 더 무겁습니다.
- 컨텍스트 창: 128K 토큰으로, 양자화와 추론 엔진에 따라 유용한 컨텍스트를 확장하는 확장 기법 포함.
- 학습 중점: 코드와 추론. Python, TypeScript, C++, Go에서 견고합니다. 멀티스텝 계획과 chain-of-thought 스타일 추론이 강조된 강점입니다.
- 라이선스: Apache 2.0 — 상업적 이용 허용.
- Q4_K_M VRAM: 전체 V3는 편안한 추론을 위해 48 GB 이상이 필요합니다. 24 GB 카드를 겨냥한 더 작은 증류 및 MoE 파생 변형이 존재합니다. 다운로드 전에 모델 카드에서 변형을 확인하십시오.
- 툴 콜링 신뢰성: OpenAI 스타일 툴 콜을 허용하는 하네스에서 견고합니다. 2026년 5월 기준 Cline의 엄격한 XML 스키마에서 Qwen3-Coder보다 약간 약합니다.
- 빛나는 곳: 전체 저장소 수준 추론, 긴 컨텍스트 작업, 멀티스텝 에이전트 계획.
- 약한 곳: 이 가이드의 어떤 모델보다 하드웨어 기준이 가장 높습니다. 24 GB 카드에서는 더 작은 파생 변형만 실행 가능하며, 이는 긴 컨텍스트 작업에서 전체 모델에 뒤처집니다.
⚠️경고: DeepSeek-V3는 이 가이드에서 하드웨어 기준이 가장 높습니다 — 전체 모델의 경우 Q4_K_M으로 VRAM 48 GB 이상. 커뮤니티에서 24 GB를 겨냥한 파생 버전이 존재하고 사용 가능하지만, Qwen3-Coder 대신 DeepSeek를 선택하는 주된 이유인 긴 컨텍스트 추론을 희생합니다. 결정 전에 변형을 하드웨어에 맞추십시오.
Codestral 22B: 명확한 상업적 경로를 가진 속도 선택지
Codestral은 Mistral의 코딩 모델입니다. 공개된 코드 방향성에서 Qwen3-Coder에 약간 뒤처지지만, 초당 토큰과 Mistral을 통한 깔끔한 상업 라이선스 경로에서 승리합니다.
- 크기: 22B(주력 모델). Q4_K_M으로 16 GB GPU에 컨텍스트 여유를 두고 편안하게 맞습니다.
- 컨텍스트 창: 32K 토큰. Qwen3-Coder와 DeepSeek보다 작습니다. 단일 파일 편집과 대부분의 멀티파일 편집에는 충분하지만 전체 저장소 작업에는 제한적입니다.
- 학습 중점: Python, TypeScript, Java, C++, Bash에서 좋은 성능을 내는 광범위한 다국어 코드 커버리지.
- 라이선스: 기본적으로 Mistral Non-Production 라이선스; 상업적 이용은 Mistral 상업 라이선스(유료)가 필요합니다. 이 그룹에서 특이한 점으로, 상업 제품으로 출시하는 팀에게 가장 중요한 데이터입니다.
- Q4_K_M VRAM: ~13 GB — 16 GB GPU에 컨텍스트 여유를 두고 맞으며, 24 GB에서 편안합니다.
- 추론 속도: 같은 양자화에서 Qwen3-Coder 30B보다 빠르고, DeepSeek-V3보다 훨씬 빠릅니다. 6개 중 품질-속도 트레이드오프가 가장 깔끔합니다.
- 빛나는 곳: 16-24 GB 카드에서 실시간 자동완성, Mistral과의 상업적 관계가 중요한 EU 팀 워크플로, 빠른 채팅 반복.
- 약한 곳: 32K 컨텍스트는 StarCoder 2 다음으로 그룹에서 가장 작습니다. 라이선스 이력은 Apache 2.0보다 복잡합니다 — 통합 전에 Mistral Non-Production 조건을 읽으십시오.
📌참고: Codestral 라이선스는 이 그룹의 가장 큰 "주의 사항"입니다. Mistral Non-Production은 개인 사용, 평가, 내부 R&D에 괜찮습니다. 상업 제품의 경우 Mistral 상업 라이선스를 협상하거나 다른 모델을 선택해야 합니다 — Apache 2.0 대안(Qwen3-Coder, DeepSeek-V3, Granite Code)은 라이선스 관리 오버헤드 없이 동일한 사용 사례를 커버합니다.
Kimi K2.7 Code: 서버급 에이전틱 선택지
Kimi K2.7 Code는 이 가이드에서 가장 강력한 에이전틱 코딩 모델입니다 — 그리고 단일 소비자용 GPU에서 실행되지 않는 유일한 모델이기도 합니다. Moonshot AI가 2026년 6월에 Kimi K2.6을 기반으로 한 코딩 특화 빌드로 출시했습니다. 총 1조 파라미터의 Mixture-of-Experts 모델로 활성 파라미터는 약 320억이며, 공개된 최소 양자화 버전도 약 340GB에 달하므로 워크스테이션이 아닌 서버급 하드웨어를 계획해야 합니다.
- 크기: 단일 크기만 존재합니다 — 총 1T 파라미터에 토큰당 약 32B가 활성화(MoE)됩니다. 소형 변형이 없어 노트북 경로가 없습니다.
- 컨텍스트 창: Kimi K2.6에서 이어받은 256K 토큰.
- 학습 중점: 코딩 특화 및 에이전틱 지향. Moonshot은 K2.6 대비 추론 토큰이 약 30% 적고 장시간 작업 성능이 더 강하다고 보고합니다 — 이 차이는 단일 함수 완성이 아니라 멀티스텝 작업에서 드러납니다.
- 라이선스: Modified MIT — 상업적 이용이 허용되지만, 대규모 배포 시 출처 표시가 요구됩니다. 제품에 통합하기 전에 수정 조항을 읽으십시오.
- 메모리 사용량: 동일 아키텍처인 K2.6의 공개된 최소 양자화 버전이 약 340GB이며, 실용적인 속도를 위해서는 RAM+VRAM 합계 약 350GB가 필요합니다. INT4가 실용적인 로컬 포맷입니다. 이는 24GB 카드가 아니라 멀티 GPU 서버나 매우 큰 통합 메모리 머신을 의미합니다.
- 툴 콜링 신뢰성: 설계 초점이 장시간에 걸친 에이전틱 툴 사용에 있으며, 바로 이 지점에서 이 가이드의 밀집형 코딩 모델들과 구분됩니다. 워크로드가 멀티스텝 에이전트 루프가 아니라 인라인 완성이라면, 추가 하드웨어의 이점은 거의 없습니다.
- 빛나는 곳: 이미 추론용 하드웨어를 보유하고 장시간 에이전틱 코딩 작업 — 저장소 전체 리팩토링, 다중 파일 마이그레이션, 지속적인 툴 루프를 실행하는 팀.
- 약한 곳: 하드웨어 장벽 때문에 거의 모든 개인 개발자에게는 선택지가 되지 못합니다. 단일 머신에서 작업한다면 Qwen3-Coder 30B가 더 나은 기본 선택지이며, 일상적인 코딩에서의 격차는 10배에 달하는 하드웨어 비용이 시사하는 것보다 훨씬 작습니다.
💡팁: Kimi K2.7 Code는 여기 소개된 소형 모델과 양자택일 관계가 아닙니다. 이미 하드웨어를 보유한 팀의 현실적인 패턴은 각 개발자 머신에서 인라인 완성과 일상적인 채팅용으로 Qwen3-Coder 30B를 실행하고, 공유 서버의 Kimi K2.7 Code는 저장소 전체 리팩토링이나 마이그레이션처럼 256K 컨텍스트와 낮은 추론 토큰 비용이 하드웨어 투자에 값하는 장시간 에이전트 작업을 위해 남겨두는 것입니다.
Granite Code: 엔터프라이즈 및 감사 적합 선택지
IBM의 Granite Code 라인은 리더보드 순위보다 라이선스 예측 가능성과 감사 포지셔닝이 더 중요한 엔터프라이즈 환경을 위해 설계되었습니다. Apache 2.0, 투명한 학습 데이터 문서화, 측정된 출시 속도로 6개 중 구매 검토에서 가장 방어하기 쉽습니다.
- 크기: 34B(주력 모델)와 8B(노트북/8 GB GPU). 밀집 트랜스포머, MoE 아님.
- 컨텍스트 창: 128K 토큰.
- 학습 중점: 학습 코퍼스의 의도적인 문서화를 갖춘 코드 중심 다국어 — 코드 품질보다 구매에서 더 중요한 포지셔닝 결정.
- 라이선스: Apache 2.0 — Qwen3-Coder와 DeepSeek-V3와 동일한 포지셔닝.
- Q4_K_M VRAM: 34B는 ~20 GB, 8B는 ~5 GB.
- 코드 방향성: 대부분의 공개 벤치마크에서 Qwen3-Coder 30B에 뒤처집니다. Python과 Java에서 Codestral과 경쟁력 있으며, TypeScript에서는 뒤처집니다.
- 빛나는 곳: 구매 주도 선택, 엔터프라이즈 감사 맥락, 모델 데이터 출처 문서화 자체가 산출물인 규제 산업 배포.
- 약한 곳: 절대적인 코드 기능은 선두 아래입니다. 구매가 제약이 아니라면, 동일한 하드웨어 예산에서 Qwen3-Coder가 더 견고한 선택지입니다.
StarCoder 2: 틈새 언어를 위한 선택지
StarCoder 2는 BigCode의 오픈 웨이트 코딩 모델 라인이며, 2026년 5월 기준 틈새 프로그래밍 언어에 가장 견고한 오픈 웨이트 모델입니다. Lua, Haskell, Solidity와 덜 일반적인 언어의 긴 꼬리를 포함하여 그룹의 다른 모델보다 더 많은 언어를 커버합니다.
- 크기: 15B(실용적인 로컬 선택지), 7B, 3B. 밀집 트랜스포머.
- 컨텍스트 창: 16K 토큰 — 그룹에서 가장 작으며 주요 제약.
- 학습 중점: 깊이보다 폭 — 덜 일반적인 언어에 의도적 커버리지를 갖춘 수백 개의 프로그래밍 언어로 훈련. Python과 TypeScript 성능은 선두에 뒤처지지만, Rust, Lua, Haskell, Solidity 커버리지는 오픈 웨이트 모델 중 최고 수준입니다.
- 라이선스: BigCode OpenRAIL-M — 사용 사례 제한이 있는 책임 있는 AI 라이선스. 상업 통합 전에 라이선스를 읽으십시오. Mistral Non-Production보다 더 허용적이지만 Apache 2.0보다 제한적입니다.
- Q4_K_M VRAM: 15B는 ~9 GB — 12 또는 16 GB 카드에 편안하게 맞습니다.
- 빛나는 곳: 틈새 언어 작업(Rust, Lua, Haskell, Solidity, Elm, Julia), 다국어 코드베이스, 다른 모델이 커버하지 않는 언어 커버리지.
- 약한 곳: 16K 컨텍스트 창은 그룹에서 가장 작습니다. Python과 TypeScript에서의 절대적 성능은 Qwen3-Coder와 DeepSeek에 뒤처집니다.
양자화 수준별 VRAM 계산
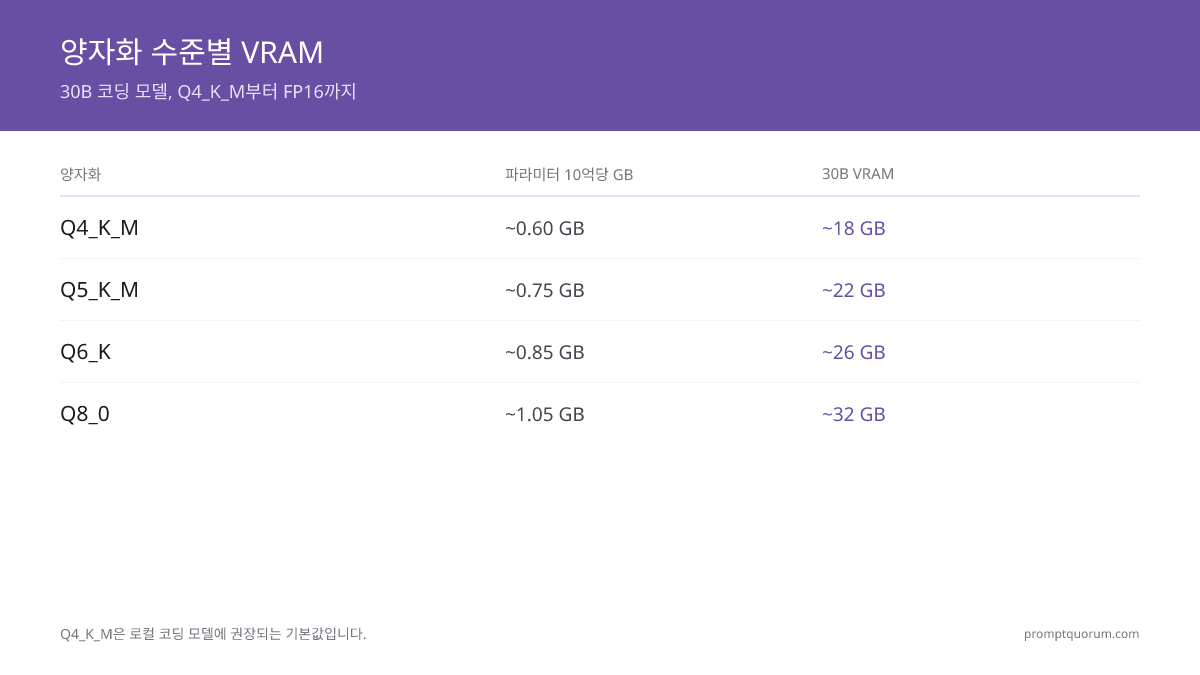
VRAM이 대부분의 로컬 코딩 모델 결정에서 주요 제약입니다. 단순한 규칙: Q4_K_M으로 모델 가중치에 약 (파라미터 수 B) × 0.6 GB를 계산하고, 컨텍스트와 도구를 위해 2-4 GB를 추가합니다. 더 높은 양자화(Q5, Q6, Q8)는 VRAM과 품질 회복을 교환합니다.
- Q4_K_M (표준): 대부분의 코드 작업에서 크기와 품질의 최선 균형. 10억 파라미터당 약 0.6 GB. 30B 모델은 ~18 GB에 맞고; 7B는 ~5 GB.
- Q5_K_M: 10억 파라미터당 약 0.75 GB. 30B 모델은 ~22 GB가 필요. 품질 회복은 멀티스텝 추론에서 작지만 측정 가능합니다.
- Q6_K: 10억 파라미터당 약 0.85 GB. 30B 모델은 ~26 GB가 필요. 32 GB 카드에서 가치 있습니다.
- Q8_0: 10억 파라미터당 약 1.05 GB. 30B 모델은 ~32 GB가 필요. FP16에 가장 가까운 품질로 절반의 VRAM.
- FP16 (양자화 없음): 10억 파라미터당 약 2.0 GB. 30B 모델은 ~60 GB가 필요. 파인튜닝이나 연구에만 사용; 로컬 추론에는 절대 사용하지 않음.
- 컨텍스트 VRAM 비용: 시퀀스 길이에 따라 확장됩니다. 경험칙으로, 코딩 모델에서 활성 컨텍스트 32K 토큰당 ~1 GB를 계산합니다 — DeepSeek-V3와 Qwen3-Coder의 긴 컨텍스트 사용에서 중요합니다.
- 도구 오버헤드: Ollama, LM Studio, llama.cpp는 각각 모델과 컨텍스트 위에 ~500 MB ~ ~1 GB를 추가합니다. 활성 도구를 위해 총 2-4 GB 여유를 확보하십시오.
💡팁: 양자화가 어떻게 작동하는지와 Q4_K_M이 가장 많이 인용되는 표준인 이유에 대한 더 깊은 설명은 LLM 양자화 설명을 참조하십시오. 이 가이드의 나머지는 위의 계산을 가정합니다.
컨텍스트 창 비교
컨텍스트 창은 VRAM 다음의 두 번째 주요 제약이며 마케팅에서 가장 과대평가되는 지표입니다. 코딩 모델은 선언된 전체 창에서 완전한 주의 품질을 유지하지 않습니다 — 실제 작업 부분은 보통 더 작습니다. 아래 인용된 데이터를 상한선으로 사용하고 실용적인 한계로 사용하지 마십시오.
모델 | 선언된 컨텍스트 | 실용적 작업 컨텍스트 (코드) | 비고 |
|---|---|---|---|
| Qwen3-Coder 30B | 256K | ~64K-128K | 2026년 5월 기준 가장 견고한 긴 컨텍스트 코딩 모델 중 하나. |
| Qwen2.5-Coder 7B | 128K | ~32K-64K | 7B 클래스는 항상 긴 컨텍스트 회수 품질이 일부 손실됩니다. |
| DeepSeek-V3 | 128K | ~64K-96K | 창 전반에 걸쳐 견고한 회수; 긴 컨텍스트 선두. |
| Codestral 22B | 32K | ~16K-24K | 22B+ 수준에서 가장 작음; 전체 저장소 작업에 제한적. |
| Kimi K2.7 Code | 256K | ~32K-64K | 긴 컨텍스트 회수는 Qwen3-Coder에 뒤처집니다. |
| Granite Code 34B | 128K | ~32K-64K | 균형 잡힌; 긴 컨텍스트 선두가 아닙니다. |
| StarCoder 2 15B | 16K | ~8K-12K | 그룹의 엄격한 제한. |

💡팁: 실용적 작업 컨텍스트가 모델이 저장소를 염두에 둘 수 있는지 결정합니다 — 헤드라인 숫자가 아닙니다. 멀티파일 리팩토링의 경우 마케팅 열보다 실제 회수 열을 우선시하십시오 — Codestral의 32K는 실제이고, Kimi K2.7 Code가 주장하는 256K는 대부분 이론상의 수치입니다.
라이선스 비교
라이선스 조건이 상업 제품에 통합할 수 있는 모델을 결정합니다. 통합 시점에 라이선스를 확인하십시오 — 오픈 소스 코딩 모델 라이선스는 버전 간에 변경될 수 있으며, 특히 공급사 라이선스 라인(Mistral, Llama)에서 그렇습니다.
모델 | 라이선스 | 별도 라이선스 없이 상업적 이용 가능? | 주요 제한 |
|---|---|---|---|
| Qwen3-Coder | Apache 2.0 | 예 | 표준 귀속; 기타 제한 없음. |
| DeepSeek-V3 | Apache 2.0 | 예 | 표준 귀속; 기타 제한 없음. |
| Codestral | Mistral Non-Production | 아니요 | 상업적 이용은 유료 Mistral 상업 라이선스가 필요합니다. |
| Kimi K2.7 Code | Modified MIT | 예 (조건 포함) | 허용 가능한 사용 정책; 사용량 임계값 이상에서 별도 조건 적용. |
| Granite Code | Apache 2.0 | 예 | 표준 귀속; 기타 제한 없음. |
| StarCoder 2 | BigCode OpenRAIL-M | 예 (사용 사례 제한 포함) | 고위험 응용 프로그램에 대한 제한; 라이선스 텍스트와 대조하여 확인하십시오. |

⚠️경고: Codestral 라이선스는 프로토타입을 만들고 검토 없이 출시하는 팀을 잡습니다. 모델이 유료 사용자에게 닿는다면 — 고객 대면 아티팩트를 생성하는 내부 도구를 통해 간접적으로라도 — Mistral 상업 라이선스가 필요합니다. 라이선스 재협상 주기를 피하려면 통합 전에 Qwen3-Coder나 Granite Code(둘 다 Apache 2.0)로 이전하십시오.
결정 트리: 무엇을 선택해야 합니까
순서대로 6가지 질문이 대부분의 독자를 올바른 선택지로 이끕니다.
📍 한 문장으로
결정은 VRAM 먼저, 라이선스 두 번째, 컨텍스트 세 번째입니다 — Qwen3-Coder는 Apache 2.0으로 24 GB에서 안전한 기본값; 나머지 5개는 각각 Qwen3-Coder가 해결하지 못하는 특정 제약을 커버합니다.
💬 쉽게 말하면
구체적인 이유가 없다면 Qwen3-Coder를 선택하십시오. 이유는: 하드웨어(12 GB 미만 → 7B; 48 GB 이상 → DeepSeek), 언어(틈새 언어 지원 → StarCoder 2), 구매(규제 산업 → Granite Code), 이미 보유한 서버급 하드웨어(300GB 이상 RAM/VRAM → Kimi K2.7 Code). Codestral은 상업 라이선스를 지불할 수 있다면 속도 선택지입니다.
- 1. VRAM이 얼마나 됩니까? 12 GB 미만: Qwen2.5-Coder 7B. 12-16 GB: Qwen2.5-Coder 7B 또는 Codestral 22B. 24 GB: Qwen3-Coder 30B. 48 GB 이상: DeepSeek-V3(전체).
- 2. 상업 제품 내에서 출시할 예정입니까? 예: Apache 2.0(Qwen3-Coder, DeepSeek-V3, Granite Code)을 선호합니다. Mistral 상업 라이선스를 지불하지 않는 한 Codestral을 피하십시오.
- 3. 32K 이상의 컨텍스트 창이 필요합니까? 예: Codestral과 StarCoder 2를 제외합니다. Qwen3-Coder, DeepSeek, Granite Code를 선택합니다(하드웨어가 있다면 Kimi K2.7 Code도).
- 4. 틈새 언어(Rust, Lua, Haskell, Solidity)로 코딩합니까? 예: 16K 컨텍스트 제한에도 불구하고 StarCoder 2 15B.
- 5. 라이선스와 학습 데이터 출처가 구매에서 방어되어야 하는 규제 산업에 있습니까? 예: Granite Code 34B가 가장 쉬운 사례입니다.
- 6. 여전히 확신이 없습니까? 기본적으로 Qwen3-Coder를 사용하십시오 — 24 GB GPU가 있다면 30B, 그렇지 않으면 7B. 이를 초과했을 때 재평가하십시오.

💡팁: 결정 트리는 의도적으로 짧습니다. 대부분의 팀은 모델 선택에서 너무 복잡하게 생각하고 하네스 선택에서 충분히 생각하지 않습니다 — 하네스 측에 대해서는 Continue.dev vs Cline vs Aider를 참조하십시오. 신뢰할 수 있는 모델 간의 차이는 하네스 적합성 차이보다 작습니다.
로컬 코딩 모델 선택 시 자주 하는 실수
- 실수 1: 하드웨어에 관계없이 리더보드에서 가장 높은 점수를 받은 모델을 선택하는 것. Q4_K_M과 2-4 GB 여유로 맞지 않는 모델은 디스크로 넘쳐 대화형 코드에 사용할 수 없게 됩니다. VRAM이 대부분의 독자에게 주요 제약입니다.
- 실수 2: 선언된 컨텍스트 창을 실용적 작업 창으로 신뢰하는 것. 코딩 모델은 선언된 컨텍스트의 약 절반에서 주의 품질이 손실됩니다. 헤드라인 숫자가 아닌 실용적 창으로 계획하십시오.
- 실수 3: 라이선스 읽기를 건너뛰는 것. Mistral 상업 라이선스 없이 상업 제품에 Codestral을 사용하는 것은 구매 실패입니다. Modified MIT는 높은 사용량 응용 프로그램에 대한 필터가 있습니다. 통합 전에 라이선스를 읽으십시오.
- 실수 4: 에이전트 하네스 선택 시 툴 콜링 신뢰성을 무시하는 것. Cline의 엄격한 XML 스키마, Continue.dev 에이전트 모드, MCP 기반 루프는 모델이 깨끗하게 툴 콜을 출력하는 것에 의존합니다. 30B+ 코딩 모델은 신뢰할 수 있습니다; 7B 클래스는 자주 실패합니다.
- 실수 5: 더 큰 채팅 모델과 함께 작은 자동완성 모델을 결합하지 않는 것. 30B 채팅 모델은 200ms 미만 자동완성에 과도합니다. 채팅 모델 옆에 1.5B-7B 자동완성 모델을 실행하십시오 — 총 VRAM은 관리 가능하게 유지되고 지연 시간은 대화형으로 유지됩니다.
- 실수 6: 6개월마다 모델 카드를 검토하지 않는 것. 오픈 웨이트 모델 라인이 업데이트되고; 양자화 레시피가 개선되며; 라이선스가 때때로 강화됩니다. 오늘의 기본 선택지가 반드시 2026년 11월의 선택지는 아닙니다.

출처
- Hugging Face의 Qwen3-Coder 모델 카드 — Qwen3-Coder 30B의 아키텍처, 파라미터 수, 컨텍스트 창, 라이선스, 공급사 보고 벤치마크 방향성.
- DeepSeek-V3 모델 카드 — DeepSeek-V3의 MoE 아키텍처 세부사항, 컨텍스트 창, 라이선스, 벤치마크 방향성.
- Codestral 모델 카드 — Codestral 22B의 아키텍처, 컨텍스트 창, 라이선스 조건.
- Mistral 상업 라이선스 — Codestral 및 기타 Mistral Non-Production 라이선스 모델의 상업적 이용에 필요한 조건.
- Hugging Face의 Kimi K2.7 Code — Moonshot AI의 모델 카드, 양자화 버전, Modified MIT 라이선스 전문.
- Granite Code(IBM) 모델 카드 — Granite Code의 크기, 컨텍스트 창, 학습 데이터 문서화, Apache 2.0 라이선스.
- StarCoder 2(BigCode) 모델 카드 — StarCoder 2의 크기, 컨텍스트 창, 언어 커버리지, BigCode OpenRAIL-M 라이선스.
- Ollama 모델 라이브러리 — 각 모델의 양자화 변형, 파일 크기, 다운로드 명령.
- BigCode OpenRAIL-M 라이선스 전문 — StarCoder 라인 모델의 전문 라이선스 텍스트와 사용 사례 제한.
자주 묻는 질문
코딩에서 GPT-5에 가장 가까운 로컬 코딩 모델은 무엇입니까?
2026년 5월 기준 어떤 오픈 웨이트 모델도 절대적인 코드 기능에서 최전선 폐쇄 모델과 동등하지 않습니다 — GPT-5, Claude 4.x, 최전선 코드 모드의 Gemini와의 격차는 멀티스텝 추론과 드물게 사용되는 라이브러리에서 실제로 존재합니다. 오픈 웨이트 모델 중에서 Qwen3-Coder 30B는 일상적인 코드 작업에 대한 공개 벤치마크 방향성에서 선두이며; DeepSeek-V3는 긴 컨텍스트 멀티파일 추론에서 가장 가깝습니다. 에디터 내 대화형 코드의 경우 격차는 보이는 것보다 덜 중요합니다 — 로컬 모델은 자동완성과 코드 편집 작업의 70-90%에서 "충분히 좋습니다".
Qwen3-Coder가 TypeScript에서 DeepSeek를 능가합니까?
각 공급사가 보고한 HumanEval+ 방향성에서 Qwen3-Coder 30B는 2026년 5월 일반 코드 작업에서 DeepSeek-V3보다 앞섭니다. TypeScript 특화 성능은 모든 공급사가 언어별 분석을 게시하지 않기 때문에 명확하게 비교하기 더 어렵습니다 — TypeScript가 주요 언어라면 현재 언어별 수치를 모델 카드에서 확인하십시오. 대부분의 IDE에서 TypeScript 작업의 경우 두 모델은 교환 가능합니다.
임베디드/Rust 개발에 가장 좋은 모델은 무엇입니까?
VRAM이 24 GB 있다면 범용 Rust에는 Qwen3-Coder 30B를. 틈새 임베디드 언어와 결합된 Rust나 다국어 임베디드 작업에는 StarCoder 2 15B를 — 언어 커버리지는 선두들이 깊이 훈련한 곳을 넘어섭니다. 더 작은 GPU에서 순수 Rust의 경우 Qwen2.5-Coder 7B는 여전히 절대적인 Rust 기능에서 StarCoder 2보다 견고한 선택지입니다.
16 GB VRAM으로 30B 코딩 모델을 실행할 수 있습니까?
Q4_K_M으로는 불가능합니다 — 30B 모델은 Q4_K_M으로 약 17-18 GB 더하기 컨텍스트 오버헤드 2-4 GB가 필요합니다. 옵션: 공격적인 양자화(Q3_K_M은 VRAM을 ~14 GB로 줄이지만 눈에 띄는 품질을 희생), 22B 모델 사용(Codestral은 16 GB에서 Q4_K_M으로 편안하게 맞음), 또는 여유와 함께 Qwen2.5-Coder 7B 변형 사용. 24 GB GPU 구매가 가장 깔끔한 해결책입니다.
Codestral이 2026년에도 여전히 관련이 있습니까?
예 — Codestral 22B는 22B+ 수준에서 속도 선두로 남아 있으며 초당 토큰이 절대적인 리더보드 순위보다 중요할 때 올바른 선택지입니다. 주요 단점은 상업적 배포에 마찰을 추가하는 Mistral Non-Production 라이선스입니다. 비상업적 이용이나 이미 Mistral 상업 라이선스를 지불하는 팀의 경우 Codestral은 대부분의 일상적인 코드 작업에서 Qwen3-Coder와 경쟁력 있습니다.
어떤 모델이 긴 컨텍스트(100K+ 줄)를 가장 잘 처리합니까?
DeepSeek-V3는 이 그룹에서 긴 컨텍스트 코드 작업에서 선두이며, 128K 창 전반에 걸쳐 견고한 회수를 제공합니다. Qwen3-Coder 30B는 256K를 선언하지만 실용적 작업 컨텍스트는 64K-128K에 더 가깝습니다. 진정한 전체 저장소 작업(100K+ 줄 이상)의 경우 어떤 모델도 완전한 주의를 유지하지 않습니다 — 원시 컨텍스트 길이에 의존하는 대신 코드 베이스에 대한 검색 증강 접근 방식을 사용하거나 작업을 더 작은 범위로 분할하십시오.
특화된 코딩 모델이 코딩에서 범용 모델을 능가합니까?
일반적인 코드 작업의 경우 그렇습니다. Qwen3-Coder 30B와 DeepSeek-V3는 코드 벤치마크에서 비슷한 크기의 범용 모델(Llama 3.3 70B, Qwen3 32B 범용)을 능가합니다. 격차는 툴 사용 에이전트 루프와 코드에 대한 멀티스텝 추론에서 더 큽니다. 코드 더하기 추론 혼합 작업(사양 읽기가 필요한 디버깅, 아키텍처 제안)의 경우 견고한 추론을 가진 범용 모델이 때때로 선호됩니다.
이 모델 중 하나를 코드 베이스로 파인튜닝할 수 있습니까?
6개 모두 각각의 라이선스 하에 파인튜닝을 허용하며, 가장 허용적인 것은 Apache 2.0 모델(Qwen3-Coder, DeepSeek-V3, Granite Code)입니다. 30B 모델의 의미 있는 파인튜닝은 추론보다 더 많은 VRAM이 필요합니다 — LoRA에 일반적으로 80 GB 이상, 전체 파인튜닝에는 더 많이. 대부분의 독자에게 파인튜닝보다 코드 베이스 인덱스에 대한 검색 증강 생성이 더 나은 첫 번째 단계입니다.
어떤 모델이 가장 많은 프로그래밍 언어를 지원합니까?
StarCoder 2 — 학습 코퍼스는 틈새 언어(Lua, Haskell, Solidity, Elm, Julia, Nim, Zig)를 포함하여 수백 개의 프로그래밍 언어를 포괄합니다. 다국어 코드 베이스나 일반적이지 않은 언어 작업의 경우 StarCoder 2 15B는 Python과 TypeScript에서의 절대적 품질이 선두에 뒤처지더라도 최선의 오픈 웨이트 선택지입니다.
오픈 소스 코딩 모델이 Claude/GPT를 따라잡고 있습니까?
일상적인 코드 작업(자동완성, 단일 파일 편집, 일반적인 리팩토링)에서 격차는 좁고 계속 줄어들고 있습니다. 어렵고 복잡한 멀티스텝 추론, 큰 컨텍스트 전체 저장소 작업, 드물게 사용되는 라이브러리에서 격차는 여전히 실제입니다. 실용적인 의미: 대부분의 에디터 내 대화형 작업에서 24 GB GPU에서 Qwen3-Coder 30B를 실행하는 것은 작업의 70-90%에서 클라우드 코딩 보조 도구를 대체할 "충분히 좋습니다". 나머지 10-30%는 폐쇄 최전선 모델이 여전히 앞서는 부분입니다.