Wichtigste Erkenntnisse
- GPUStack ist ein Open-Source-GPU-Clustermanager für KI-Modell-Serving; Quellcode unter github.com/gpustack/gpustack, Projektseite gpustack.ai
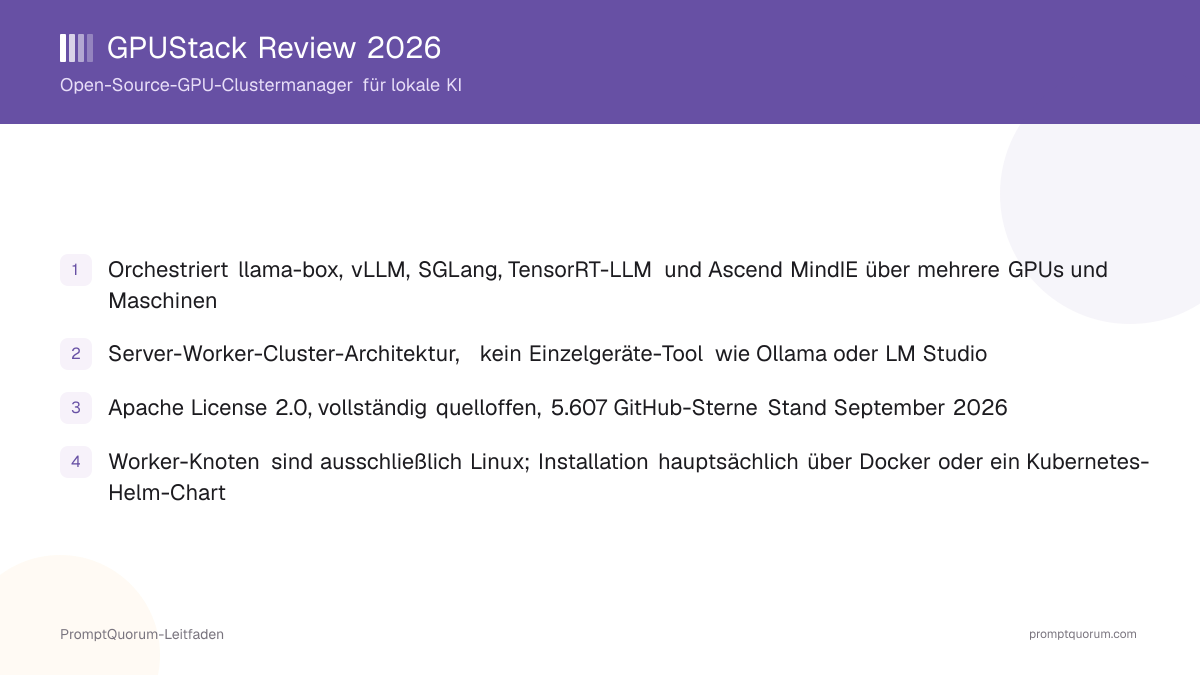
- Server-Worker-Cluster-Architektur: Ein zentraler Server orchestriert einen oder mehrere Worker-Knoten, die jeweils GPU-Kapazität zu einem gemeinsamen Pool beisteuern
- Orchestriert mehrere Inferenz-Backends — llama-box (eigene llama.cpp/stable-diffusion.cpp-Implementierung), vLLM, SGLang, TensorRT-LLM und Ascend MindIE — plus Unterstützung für das Hinzufügen benutzerdefinierter Engines
- Unterstützt heterogene Hardware: NVIDIA- und AMD-GPUs, Huawei-Ascend-NPUs und Hygon-DCUs, laut offizieller Dokumentation
- Lizenz: Apache License 2.0 — vollständig quelloffen; auf der öffentlichen Website des Projekts ist zum Zeitpunkt dieser Review keine separate kostenpflichtige oder "Enterprise"-Stufe dokumentiert
- Installiert hauptsächlich über Docker, mit einem Helm-Chart für Kubernetes und einem Air-Gapped-Pfad für Offline-Umgebungen; ein veraltetes curl-Installationsskript existiert noch, ist aber seit GPUStack v0.7 als veraltet markiert
- Worker-Knoten sind ausschließlich Linux: Der Server läuft über Docker unter Linux, macOS oder Windows, aber laut offizieller Dokumentation können nur Linux-Maschinen als Worker GPU-Kapazität beisteuern
- Bietet eine OpenAI-kompatible API und kann bei Bedarf per SSH erreichbare GPU-Instanzen bereitstellen, nicht nur einen Inferenz-Endpunkt
- GitHub-Repository zeigt 5.607 Sterne, geprüft gegen github.com/gpustack/gpustack am 5. September 2026
📍 In einem Satz
GPUStack ist ein Open-Source-GPU-Clustermanager, der automatisch Inferenz-Engines (llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE) über mehrere GPUs und Maschinen hinweg konfiguriert und orchestriert — im Unterschied zu Einzelgeräte-Tools wie Ollama.
💬 In einfachen Worten
Mit GPUStack kann ein Team mehrere GPUs — auch über verschiedene physische Maschinen verteilt — zu einem verwaltbaren Cluster für KI-Modelle bündeln, statt jede GPU einzeln ungenutzt zu lassen. Es wählt die passende Inferenz-Engine für die jeweilige Aufgabe und lässt Sie bei Bedarf per SSH auf Cluster-Maschinen zugreifen. Es ist keine Chat-App für einen einzelnen Laptop; es löst ein Skalierungsproblem, kein "ein Modell auf meinem Computer ausführen"-Problem.
📌Hinweis: Diese Review ist die vertiefende Ergänzung zum Eintrag von GPUStack im Local LLM Software Directory — dort finden Sie, wie GPUStack im Vergleich zu Dutzenden anderer lokaler KI-Tools abschneidet.
Was ist GPUStack?
GPUStack ist ein Open-Source-GPU-Clustermanager für KI-Modell-Serving und GPU-Instanz-Provisionierung. Das GitHub-Repository beschreibt es als automatische Konfiguration und Orchestrierung von Inferenz-Engines über heterogene GPU-Hardware hinweg, gerichtet an Teams, die mehrere GPUs — möglicherweise verteilt über mehrere physische Maschinen — zu einem verwaltbaren Inferenz-Cluster bündeln müssen, statt ein Modell auf einem einzelnen Gerät auszuführen.
- Kernfunktion: LLM-Inferenz (und Bildgenerierung, über die stable-diffusion.cpp-Unterstützung von llama-box) über einen Cluster aus GPUs und Maschinen orchestrieren, nicht auf einem einzelnen Gerät
- Architektur: Ein zentraler GPUStack-Server koordiniert einen oder mehrere Worker-Knoten, die jeweils GPU-Kapazität zu einem gemeinsamen Pool beisteuern
- Orchestrierte Backends: llama-box (GPUStacks eigene Inferenz-Server-Implementierung, aufgebaut auf llama.cpp und stable-diffusion.cpp), vLLM, SGLang, TensorRT-LLM und Ascend MindIE für Huawei-Ascend-NPU-Hardware, plus Unterstützung für benutzerdefinierte Inferenz-Engines
- Hardware-Unterstützung: heterogene Beschleuniger einschließlich NVIDIA- und AMD-GPUs, Huawei-Ascend-NPUs und Hygon-DCUs, laut offizieller Dokumentation
- On-Demand-GPU-Instanzen: GPUStack kann per SSH erreichbare GPU-Instanzen bereitstellen, sodass ein Nutzer direkt auf einer Cluster-Maschine arbeiten kann statt nur über eine API
- Kanonisches Repository: github.com/gpustack/gpustack; Projektseite: gpustack.ai
Meilensteine von GPUStack
GPUStack wurde als Open-Source-Clustermanager veröffentlicht, um GPU-Kapazität über On-Prem-Hardware hinweg zu bündeln, gerichtet an Teams, die Modelle über mehr Rechenleistung hinweg bereitstellen müssen, als eine einzelne Maschine bietet.
- 1Erste Veröffentlichung — Open-Source-GPU-Clustermanager
Why it matters: GPUStack wurde spezifisch für die Orchestrierung von GPU-Kapazität über einen Cluster hinweg positioniert und schließt eine Lücke zwischen Einzelgeräte-Runtimes wie Ollama und vollständigen Enterprise-Inferenz-Serving-Stacks. - 2Laufend — Multi-Backend-Orchestrierung (llama-box, vLLM, SGLang, TensorRT-LLM)
Why it matters: Die Unterstützung mehrerer Inferenz-Engines statt nur einer erlaubt es GPUStack, eine Arbeitslast an das jeweils passendste Backend für Modell und Hardware weiterzuleiten, statt Nutzer an eine einzelne Engine zu binden. - 3Laufend — Unterstützung für Ascend MindIE und Hygon DCU hinzugefügt
Why it matters: Die Erweiterung der Backend- und Hardware-Unterstützung auf Huawei-Ascend-NPUs und Hygon-DCUs, nicht nur NVIDIA- und AMD-GPUs, erweitert, welche On-Prem-Hardware ein Cluster tatsächlich nutzen kann. - 4Laufend — Docker und Helm als primäre Installationspfade etabliert; veraltetes curl-Skript ab v0.7 als veraltet markiert
Why it matters: Die Konsolidierung auf Docker und ein Helm-Chart für Kubernetes, statt eines Shell-Skript-Installers, spiegelt GPUStacks Positionierung als Infrastruktursoftware wider, die von einem Team administriert wird, nicht als einmalige Entwickler-Installation. - 5Laufend — 5.607 GitHub-Sterne Stand 5. September 2026
Why it matters: Die Sternezahl ist ein grobes Nutzungssignal, kein Qualitätsmaßstab, zeigt aber echte Adoption in einer Cluster-Management-Kategorie, die die meisten Nutzer lokaler KI nie berühren.
Was können Sie mit GPUStack tun?
Der Funktionsumfang von GPUStack konzentriert sich darauf, Multi-GPU-, Multi-Maschinen-Inferenz von einer zentralen Stelle aus verwaltbar zu machen, laut der offiziellen Dokumentation.
- Multi-Backend-Inferenz-Orchestrierung — konfiguriert und betreibt automatisch llama-box, vLLM, SGLang, TensorRT-LLM oder Ascend MindIE, je nach Modell und Hardware, plus Unterstützung für benutzerdefinierte Inferenz-Engines
- Cluster-Scheduling über heterogene Hardware — bündelt NVIDIA- und AMD-GPUs, Huawei-Ascend-NPUs und Hygon-DCUs zu einem gemeinsam planbaren Ressourcenpool, laut offizieller Dokumentation
- On-Demand, per SSH erreichbare GPU-Instanzen — stellt Instanzen bereit, in die sich ein Nutzer direkt per SSH einloggen kann, nicht nur einen Inferenz-API-Endpunkt
- OpenAI-kompatible API — laut offizieller Dokumentation bestätigt; bestehender OpenAI-Client-Code kann mit minimalen Änderungen auf einen von GPUStack verwalteten Endpunkt zeigen
- Integrierte llama-box-Engine — GPUStacks eigene Implementierung auf Basis von llama.cpp und stable-diffusion.cpp, mit CPU-Inferenz, einer OpenAI-Function-Calling-API, Kompatibilität mit der OpenAI-Embeddings-API und spekulativem Dekodieren
- Web-Verwaltungsoberfläche und CLI — der Server bietet laut offizieller Quickstart-Dokumentation eine Weboberfläche (Standardport 80) neben CLI- und API-Zugriff
- Kubernetes-native Bereitstellung über Helm — für Teams, die bereits Kubernetes betreiben, liefert GPUStack ein offizielles Helm-Chart, statt eine maßgeschneiderte Bereitstellung zu erfordern
- Air-Gapped-Installationspfad — dokumentiert für Umgebungen ohne Internetzugang, relevant für On-Prem- oder regulierte Bereitstellungen
Anwendungsbeispiele: Drei Wege, GPUStack zu nutzen
Dies sind Workflows, die auf GPUStacks dokumentierter Docker-Installation, Quickstart und API basieren — keine hypothetischen Anwendungsfälle.
Installation und erste Schritte
GPUStack ist ein selbst gehostetes Server-und-Cluster-Tool, keine Consumer-App mit Download-Button, daher erfolgt die Installation über Docker, ein Helm-Chart oder (veraltet) ein Shell-Skript — nicht über einen signierten Installer von einer Marketingseite.
- 1Docker (aktuell empfohlene Methode laut offizieller Dokumentation): Führen Sie
sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustackauf der Maschine aus, die als GPUStack-Server fungieren soll; der Server selbst läuft unter Linux, macOS oder Windows über Docker Desktop. - 2Kubernetes: Stellen Sie das offizielle Helm-Chart bereit, wenn Ihr Team bereits Kubernetes betreibt, laut den Installationsdokumenten.
- 3Air-Gapped-Umgebungen: Folgen Sie dem dokumentierten Air-Gapped-Installationspfad, wenn die Zielmaschine keinen Internetzugang hat.
- 4Ein Desktop-Installer für macOS und Windows wird auch in GPUStacks Release-Historie erwähnt, um einen Server ohne Docker einzurichten — bestätigen Sie den aktuellen Download-Link direkt auf gpustack.ai, da er zum Zeitpunkt dieser Review nicht Teil der primären Docs-Navigation ist.
- 5Veraltete, eher auf Linux ausgerichtete Alternative:
curl -sfL https://get.gpustack.ai | sh -s -— dieses Installationsskript funktioniert noch, ist aber seit GPUStack v0.7 zugunsten der oben genannten Docker- und Helm-Pfade als veraltet markiert; behandeln Sie es als Rückfalloption, nicht als Standardwahl für eine Neuinstallation. - 6Um über eine Maschine hinaus zu skalieren, fügen Sie dem Cluster weitere Linux-Maschinen als Worker-Knoten hinzu. Worker-Knoten sind ausschließlich Linux — macOS wird für die Worker-Rolle nicht unterstützt, und Windows benötigt WSL2 statt Docker Desktop.
GPUStack Preise und Lizenzierung
GPUStack selbst ist kostenlos und steht unter der Apache License 2.0, bestätigt über das eigene Repository des Projekts — auf der öffentlichen Website oder in der offiziellen Dokumentation des Projekts ist zum Zeitpunkt dieser Review keine separate kostenpflichtige oder "Enterprise"-Stufe von GPUStack dokumentiert. Jede in dieser Review behandelte Funktion, einschließlich Multi-Backend-Orchestrierung und Cluster-Scheduling, ist Teil desselben Open-Source-Projekts.
GPUStack vs. Einzelgeräte-Runtimes
GPUStack wird mit Tools wie Ollama und LM Studio verglichen, weil alle drei offene Modelle lokal ausführen — aber GPUStack löst ein anderes Problem: die Skalierung von Inferenz über mehrere GPUs und Maschinen hinweg, nicht das Ausführen eines Modells auf einem Gerät. Weder Ollama noch LM Studio sind ein echtes Cluster-Orchestrierungs-Pendant zu GPUStack; ehrlich gesagt sind sie die nächstliegenden Einzelgeräte-Alternativen für Leser, die keine Cluster-Orchestrierung benötigen.
Hauptzweck
- GPUStack:
- GPU-Clustermanager — orchestriert Inferenz über mehrere GPUs und Maschinen hinweg
- Ollama / LM Studio:
- Einzelgeräte-Runtime für lokale Modelle und/oder Desktop-Chat-App
Architektur
- GPUStack:
- Zentraler Server plus ein oder mehrere Worker-Knoten, die GPU-Kapazität beisteuern
- Ollama / LM Studio:
- Ein Prozess auf einem Gerät; kein integriertes Multi-Maschinen-Clustering
Backends
- GPUStack:
- Orchestriert llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE oder benutzerdefinierte Engines
- Ollama / LM Studio:
- Integrierte llama.cpp-basierte Engine (Ollama); llama.cpp / MLX (LM Studio)
On-Demand-GPU-Instanzen
- GPUStack:
- Ja — stellt per SSH erreichbare Instanzen innerhalb des Clusters bereit
- Ollama / LM Studio:
- Keine vergleichbare Funktion
Lizenz
- GPUStack:
- Apache-2.0
- Ollama / LM Studio:
- MIT (Ollama); kostenlos proprietär (LM Studio)
Typischer Nutzer
- GPUStack:
- Ein Team mit mehreren GPUs oder Maschinen, die für Serving gebündelt werden sollen
- Ollama / LM Studio:
- Eine Einzelperson, die Modelle auf einem Laptop oder einer Workstation ausführt
Wenn Sie nur eine GPU haben und keine weiteren hinzufügen wollen, ist die Cluster-Maschinerie von GPUStack unnötiger Aufwand — Ollama oder LM Studio bringt ein Modell auf einem einzelnen Gerät schneller zum Laufen. Details in der vollständigen Ollama-Review und LM-Studio-Review.
Für wen eignet sich GPUStack?
Ob sich GPUStack lohnt, hängt fast ausschließlich von einer Frage ab: Haben Sie mehr als eine GPU oder Maschine zu bündeln, oder planen Sie, bald weitere hinzuzufügen?
GPUStack vs. andere lokale KI-Tools
GPUStack ist im Segment Runtimes-und-Manager des Local LLM Software Directory angesiedelt, aber sein Multi-GPU-, Multi-Maschinen-Cluster-Orchestrierungsdesign hebt es von den meisten Tools dieser Kategorie ab, die auf einem einzelnen Gerät laufen. Keine andere FeatureAppPost-Review auf dieser Seite behandelt zum Zeitpunkt der Veröffentlichung dieser Review ein echtes Multi-GPU-Cluster-Pendant zu GPUStack — die folgenden nächstliegenden Vergleiche sind Einzelgeräte-Runtimes, die ehrlich gesagt ein anderes Problem lösen: ein Modell auf einem Gerät auszuführen, nicht über viele hinweg zu skalieren.
- Ollama — eine universelle lokale Modell-Runtime für ein einzelnes Gerät, vollständig MIT-lizenziert, mit einer breiten Modellbibliothek. Die nächstliegende Einzelgeräte-Alternative, wenn Sie keine Cluster-Orchestrierung über mehrere GPUs oder Maschinen benötigen. Vollständige Ollama-Review.
- LM Studio — eine GUI-first-Desktop-App für lokale Inferenz auf einem Gerät, gerichtet an Endnutzer statt Cluster-Administratoren. Eine passendere Wahl als GPUStack, wenn Sie eine ausgereifte Chat-App auf einem einzelnen Laptop möchten. Vollständige LM-Studio-Review.
- Docker Model Runner — eine mit Docker Desktop/Engine gebündelte CLI-und-API-Funktion zum Ausführen von Modellen auf einem einzelnen Gerät; eine weitere Einzelgeräte-Option, die Sie gegen GPUStacks Cluster-Orchestrierungsansatz abwägen können, wenn Ihre Arbeitslast keine gebündelten mehreren GPUs benötigt. Vollständige Docker-Model-Runner-Review.
Häufige Fehler bei der Bewertung von GPUStack
Die meiste Verwirrung um GPUStack entsteht dadurch, es als Einzelgeräte-Tool zu behandeln oder anzunehmen, es konkurriere direkt mit den Inferenz-Engines, die es tatsächlich orchestriert.
Häufig gestellte Fragen
Was ist GPUStack?
GPUStack (github.com/gpustack/gpustack) ist ein Open-Source-GPU-Clustermanager für KI-Modell-Serving — er konfiguriert und orchestriert automatisch Inferenz-Engines über heterogene On-Prem-Hardware hinweg und kann bei Bedarf per SSH erreichbare GPU-Instanzen bereitstellen.
Ist GPUStack dasselbe wie Ollama oder LM Studio?
Nein. Ollama und LM Studio führen Modelle auf einem einzelnen Gerät aus. GPUStack ist ein Clustermanager, dessen Zweck darin besteht, Inferenz über mehrere GPUs und mehrere Maschinen hinweg mittels einer Server-Worker-Architektur zu bündeln und zu verteilen. Ollama und LM Studio sind die nächstliegenden Einzelgeräte-Alternativen für Leser, die keine Cluster-Orchestrierung benötigen.
Ist GPUStack Open Source?
Ja. GPUStack steht unter der Apache License 2.0, bestätigt über das eigene Repository des Projekts. Zum Zeitpunkt dieser Review ist auf der öffentlichen Website des Projekts keine separate kostenpflichtige oder Enterprise-Stufe von GPUStack dokumentiert.
Ist GPUStack kostenlos?
Ja, GPUStack selbst ist unter Apache-2.0 kostenlos. Der Betrieb eines Clusters verursacht weiterhin reale Infrastrukturkosten (GPUs, Maschinen, Netzwerk), die nichts mit GPUStacks eigener Lizenz zu tun haben.
Wie installiere ich GPUStack?
Die aktuell empfohlene Methode ist Docker: sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustack. Für Kubernetes ist ein Helm-Chart verfügbar, und für Offline-Umgebungen ist ein Air-Gapped-Pfad dokumentiert. Ein veraltetes curl-Skript (curl -sfL https://get.gpustack.ai | sh -s -) funktioniert noch, ist aber seit v0.7 als veraltet markiert.
Welche Plattformen unterstützt GPUStack?
Der GPUStack-Server läuft über Docker unter Linux, macOS oder Windows (Docker Desktop). Worker-Knoten — die Maschinen, die GPU-Kapazität beisteuern — sind ausschließlich Linux; macOS kann keinen Worker betreiben, und Windows benötigt laut offizieller Dokumentation für diese Rolle WSL2 statt Docker Desktop.
Welche Inferenz-Engines orchestriert GPUStack?
llama-box (GPUStacks eigene, auf llama.cpp/stable-diffusion.cpp basierende Implementierung), vLLM, SGLang, TensorRT-LLM und Ascend MindIE für Huawei-Ascend-NPU-Hardware, plus Unterstützung für benutzerdefinierte Inferenz-Engines.
Bietet GPUStack eine OpenAI-kompatible API?
Ja, laut offizieller Dokumentation, sodass Anwendungen, die bereits gegen die OpenAI-API-Struktur gebaut sind, mit minimalen Änderungen auf einen von GPUStack verwalteten Endpunkt zeigen können.
Wie viele GitHub-Sterne hat GPUStack?
Das Repository von GPUStack (github.com/gpustack/gpustack) zeigte laut Verzeichnisprüfung dieser Seite Stand 5. September 2026 5.607 Sterne. Prüfen Sie das Repository direkt für eine aktuelle Zahl, da sie sich im Laufe der Zeit ändert.