핵심 요점
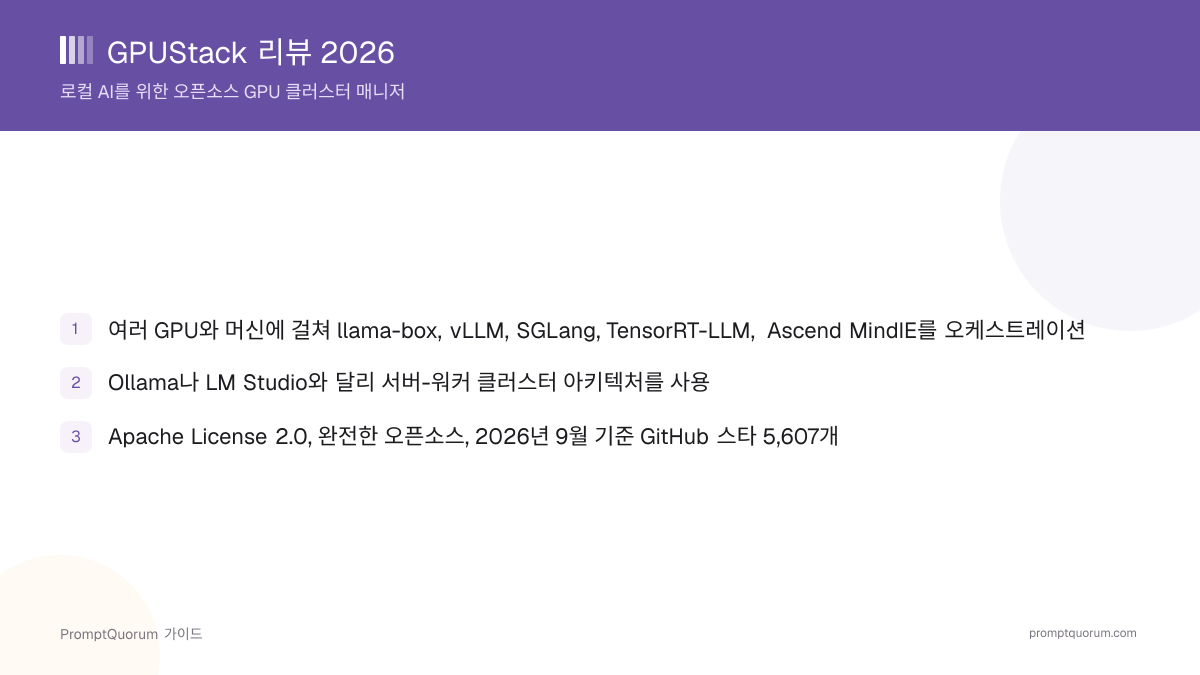
- GPUStack은 AI 모델 서빙을 위한 오픈소스 GPU 클러스터 매니저입니다; 소스코드는 github.com/gpustack/gpustack, 프로젝트 사이트는 gpustack.ai
- 서버-워커 클러스터 아키텍처: 중앙 서버가 하나 이상의 워커 노드를 오케스트레이션하며, 각 노드는 공유 풀에 GPU 용량을 제공
- 여러 추론 백엔드를 오케스트레이션 — llama-box(자체 llama.cpp/stable-diffusion.cpp 구현), vLLM, SGLang, TensorRT-LLM, Ascend MindIE — 그리고 커스텀 엔진 추가 지원
- 공식 문서에 따르면 NVIDIA 및 AMD GPU, 화웨이 Ascend NPU, Hygon DCU 등 이기종 하드웨어 지원
- 라이선스: Apache License 2.0 — 완전한 오픈소스; 이 리뷰 시점 기준 프로젝트의 공개 사이트에 별도의 유료 또는 "엔터프라이즈" 등급은 문서화되어 있지 않음
- 주로 Docker를 통해 설치되며, Kubernetes용 Helm 차트와 오프라인 환경을 위한 에어갭 경로가 있음; 기존 curl 설치 스크립트는 존재하지만 GPUStack v0.7부터 지원 중단
- 워커 노드는 Linux 전용: 서버는 Docker를 통해 Linux, macOS, Windows에서 실행되지만, 공식 문서에 따르면 GPU 용량을 제공하는 워커 역할은 Linux 머신만 가능
- OpenAI 호환 API를 제공하며, 추론 엔드포인트뿐 아니라 필요 시 SSH로 접근 가능한 GPU 인스턴스도 프로비저닝 가능
- GitHub 저장소는 2026년 9월 5일 github.com/gpustack/gpustack 기준으로 검증된 5,607개의 스타를 기록
📍 한 문장으로
GPUStack은 여러 GPU와 머신에 걸쳐 추론 엔진(llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE)을 자동으로 구성하고 오케스트레이션하는 오픈소스 GPU 클러스터 매니저로, Ollama 같은 단일 머신 도구와는 다릅니다.
💬 쉽게 말하면
GPUStack을 사용하면 팀은 서로 다른 물리적 머신에 흩어져 있더라도 여러 GPU를 하나의 관리하기 쉬운 클러스터로 모아 AI 모델을 실행할 수 있습니다. GPU 하나하나를 각자의 상자 안에 방치해 두는 대신 말이죠. 작업에 맞는 추론 엔진을 알아서 고르고, 필요할 때 클러스터 내 머신에 SSH로 접속할 수 있게 해줍니다. 노트북 한 대를 위한 채팅 앱이 아니라, "내 컴퓨터에서 모델 하나 돌리기" 문제가 아니라 확장 문제를 해결하는 도구입니다.
📌참고: 이 리뷰는 로컬 LLM 소프트웨어 디렉터리에 있는 GPUStack 항목을 심층적으로 다루는 글입니다 — GPUStack이 다른 수십 개의 로컬 AI 도구와 한눈에 어떻게 비교되는지는 해당 페이지를 참고하세요.
GPUStack이란 무엇인가
GPUStack은 AI 모델 서빙 및 GPU 인스턴스 프로비저닝을 위한 오픈소스 GPU 클러스터 매니저입니다. GitHub 저장소에서는 이를 이기종 GPU 하드웨어 전반에서 추론 엔진을 자동으로 구성하고 오케스트레이션하는 도구로 설명하며, 단일 기기에서 모델을 실행하는 대신 여러 물리적 머신에 흩어져 있을 수 있는 여러 GPU를 하나의 관리 가능한 추론 클러스터로 모아야 하는 팀을 대상으로 합니다.
- 핵심 기능: 단일 기기가 아니라 GPU와 머신으로 이루어진 클러스터 전체에서 LLM 추론(그리고 llama-box의 stable-diffusion.cpp 지원을 통한 이미지 생성)을 오케스트레이션
- 아키텍처: 중앙 GPUStack 서버가 하나 이상의 워커 노드를 조율하며, 각 노드는 공유 풀에 GPU 용량을 제공
- 오케스트레이션되는 백엔드: llama-box(llama.cpp와 stable-diffusion.cpp를 기반으로 한 GPUStack 자체 추론 서버 구현), vLLM, SGLang, TensorRT-LLM, 화웨이 Ascend NPU 하드웨어용 Ascend MindIE, 그리고 커스텀 추론 엔진 추가 지원
- 하드웨어 지원: 공식 문서에 따르면 NVIDIA 및 AMD GPU, 화웨이 Ascend NPU, Hygon DCU를 포함한 이기종 가속기
- 온디맨드 GPU 인스턴스: GPUStack은 SSH로 접근 가능한 GPU 인스턴스를 프로비저닝할 수 있어, 사용자가 API를 통해서만이 아니라 클러스터 내 머신에서 직접 작업할 수 있음
- 표준 저장소: github.com/gpustack/gpustack; 프로젝트 사이트: gpustack.ai
GPUStack 주요 이정표
GPUStack은 단일 머신이 제공할 수 있는 것 이상의 컴퓨팅 자원으로 모델을 서빙해야 하는 팀을 대상으로, 온프레미스 하드웨어 전반의 GPU 용량을 모으는 오픈소스 클러스터 매니저로 출시되었습니다.
- 1최초 출시 — 오픈소스 GPU 클러스터 매니저
Why it matters: GPUStack은 처음부터 클러스터 전반에서 GPU 용량을 오케스트레이션하는 것에 특화하여 자리매김했으며, Ollama 같은 단일 머신 런타임과 완전한 엔터프라이즈 추론 서빙 스택 사이의 공백을 메웠습니다. - 2지속 진행 — 멀티 백엔드 오케스트레이션(llama-box, vLLM, SGLang, TensorRT-LLM)
Why it matters: 하나가 아닌 여러 추론 엔진을 지원함으로써 GPUStack은 사용자를 단일 엔진에 묶어두는 대신, 워크로드를 모델과 하드웨어에 가장 적합한 백엔드로 라우팅할 수 있습니다. - 3지속 진행 — Ascend MindIE 및 Hygon DCU 지원 추가
Why it matters: NVIDIA 및 AMD GPU뿐 아니라 화웨이 Ascend NPU와 Hygon DCU로 백엔드 및 하드웨어 지원을 확장함으로써, 클러스터가 실제로 활용할 수 있는 온프레미스 하드웨어의 범위가 넓어졌습니다. - 4지속 진행 — Docker와 Helm이 주요 설치 경로로 자리 잡음; v0.7에서 기존 curl 스크립트 지원 중단
Why it matters: 셸 스크립트 설치 프로그램 대신 Docker와 Kubernetes용 Helm 차트로 통합한 것은, GPUStack이 일회성 개발자 설치용이 아니라 팀이 관리하는 인프라 소프트웨어로 자리매김하고 있음을 반영합니다. - 5지속 진행 — 2026년 9월 5일 기준 GitHub 스타 5,607개
Why it matters: 스타 수는 대략적인 사용 지표일 뿐 품질 지표는 아니지만, 대부분의 로컬 AI 사용자가 접해보지 못하는 클러스터 관리 카테고리에서 실제 채택이 이루어지고 있음을 보여줍니다.
GPUStack으로 무엇을 할 수 있나
GPUStack의 기능 세트는 공식 문서에 따르면 멀티 GPU, 멀티 머신 추론을 한 곳에서 관리할 수 있게 만드는 데 초점이 맞춰져 있습니다.
- 멀티 백엔드 추론 오케스트레이션 — 모델과 하드웨어에 따라 llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE를 자동으로 구성하고 실행하며, 커스텀 추론 엔진 추가도 지원
- 이기종 하드웨어 전반의 클러스터 스케줄링 — 공식 문서에 따르면 NVIDIA 및 AMD GPU, 화웨이 Ascend NPU, Hygon DCU를 하나의 스케줄 가능한 리소스 풀로 통합
- 온디맨드 SSH 접근 가능 GPU 인스턴스 — 추론 API 엔드포인트뿐 아니라 사용자가 직접 SSH로 접속할 수 있는 인스턴스를 프로비저닝
- OpenAI 호환 API — 공식 문서로 확인됨; 기존 OpenAI 클라이언트 코드는 최소한의 변경만으로 GPUStack이 관리하는 엔드포인트를 가리킬 수 있음
- 내장 llama-box 엔진 — llama.cpp와 stable-diffusion.cpp를 기반으로 한 GPUStack 자체 구현으로, CPU 추론, OpenAI Function-calling API, OpenAI Embeddings API 호환성, 추측 디코딩(speculative decoding)을 지원
- 웹 관리 UI 및 CLI — 공식 퀵스타트 문서에 따르면 서버는 CLI 및 API 접근과 함께 웹 인터페이스(기본 포트 80)를 제공
- Helm을 통한 Kubernetes 네이티브 배포 — 이미 Kubernetes를 운영 중인 팀을 위해 GPUStack은 맞춤형 배포를 요구하는 대신 공식 Helm 차트를 제공
- 에어갭 설치 경로 — 인터넷 접속이 불가능한 환경을 위해 문서화되어 있으며, 온프레미스 또는 규제 대상 환경 배포에 유용
사용 예시: GPUStack을 활용하는 세 가지 방법
아래는 GPUStack의 공식 Docker 설치, 퀵스타트, API를 바탕으로 한 실제 워크플로우이며, 가상의 사용 사례가 아닙니다.
설치 및 시작하기
GPUStack은 다운로드 버튼이 있는 일반 소비자용 앱이 아니라 셀프 호스팅 서버-클러스터 도구이므로, 마케팅 페이지에서 서명된 설치 프로그램을 받는 대신 Docker, Helm 차트, (기존 방식인) 셸 스크립트를 통해 설치합니다.
- 1Docker(공식 문서 기준 현재 권장 방식): GPUStack 서버 역할을 할 머신에서
sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustack을 실행합니다. 서버 자체는 Linux, macOS, 또는 Docker Desktop을 통해 Windows에서 작동합니다. - 2Kubernetes: 팀이 이미 Kubernetes를 운영 중이라면 설치 문서에 따라 공식 Helm 차트를 배포합니다.
- 3에어갭 환경: 대상 머신에 인터넷 접속이 없다면 문서화된 에어갭 설치 경로를 따릅니다.
- 4Docker 없이 서버를 구성하기 위한 macOS 및 Windows용 데스크톱 설치 프로그램도 GPUStack의 릴리스 이력에서 언급되어 있습니다 — 이 리뷰 발행 시점 기준 주요 문서 내비게이션에 포함되어 있지 않으므로, 현재 다운로드 링크는 gpustack.ai에서 직접 확인하세요.
- 5Linux 위주의 기존 대체 방식:
curl -sfL https://get.gpustack.ai | sh -s -— 이 설치 스크립트는 여전히 작동하지만 GPUStack v0.7부터 위의 Docker 및 Helm 경로를 선호하며 지원 중단되었습니다. 새 설치의 기본 선택지가 아니라 대체 수단으로 취급하세요. - 6한 대의 머신을 넘어 확장하려면 추가 Linux 머신을 워커 노드로 클러스터에 참여시키세요. 워커 노드는 Linux 전용입니다 — macOS는 워커 역할을 지원하지 않으며, Windows는 Docker Desktop이 아닌 WSL2가 필요합니다.
GPUStack 가격 및 라이선스
GPUStack 자체는 무료이며 Apache License 2.0 라이선스로 배포됩니다. 이는 프로젝트 자체 저장소를 통해 확인되었습니다 — 이 리뷰 시점 기준 프로젝트의 공개 사이트나 공식 문서에는 GPUStack의 별도 유료 또는 "엔터프라이즈" 등급이 문서화되어 있지 않습니다. 멀티 백엔드 오케스트레이션과 클러스터 스케줄링을 포함해 이 리뷰에서 다룬 모든 기능은 동일한 오픈소스 프로젝트의 일부입니다.
GPUStack vs. 단일 머신 런타임
GPUStack은 Ollama나 LM Studio 같은 도구와 비교되는 경우가 많습니다. 셋 다 오픈 모델을 로컬에서 실행하기 때문이지만, GPUStack이 해결하는 문제는 다릅니다. 단일 기기에서 모델을 실행하는 것이 아니라 여러 GPU와 머신에 걸쳐 추론을 확장하는 것입니다. Ollama도 LM Studio도 GPUStack의 진정한 클러스터 오케스트레이션 상대는 아닙니다. 솔직히 말하면, 클러스터 오케스트레이션이 필요 없는 독자에게 가장 가까운 단일 머신 대안일 뿐입니다.
주요 목적
- GPUStack:
- GPU 클러스터 매니저 — 여러 GPU와 머신에 걸쳐 추론을 오케스트레이션
- Ollama / LM Studio:
- 단일 머신용 로컬 모델 런타임 및/또는 데스크톱 채팅 앱
아키텍처
- GPUStack:
- 중앙 서버와 GPU 용량을 제공하는 하나 이상의 워커 노드
- Ollama / LM Studio:
- 단일 기기에서 실행되는 단일 프로세스; 내장된 멀티 머신 클러스터링 없음
백엔드
- GPUStack:
- llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE, 또는 커스텀 엔진을 오케스트레이션
- Ollama / LM Studio:
- llama.cpp 기반 내장 엔진(Ollama); llama.cpp / MLX(LM Studio)
온디맨드 GPU 인스턴스
- GPUStack:
- 있음 — 클러스터 내 SSH 접근 가능한 인스턴스를 프로비저닝
- Ollama / LM Studio:
- 동등한 기능 없음
라이선스
- GPUStack:
- Apache-2.0
- Ollama / LM Studio:
- MIT(Ollama); 무료 독점 라이선스(LM Studio)
전형적인 사용자
- GPUStack:
- 서빙을 위해 여러 GPU나 머신을 모으려는 팀
- Ollama / LM Studio:
- 노트북이나 워크스테이션 한 대에서 모델을 실행하는 개인
GPU가 하나뿐이고 늘릴 계획이 없다면 GPUStack의 클러스터 메커니즘은 불필요한 오버헤드입니다 — Ollama나 LM Studio가 단일 머신에서 더 빠르게 모델을 실행해줄 것입니다. 자세한 내용은 전체 Ollama 리뷰와 LM Studio 리뷰를 참고하세요.
GPUStack은 누구에게 적합한가
GPUStack을 도입할 가치가 있는지는 거의 전적으로 하나의 질문에 달려 있습니다: 모아야 할 GPU나 머신이 두 개 이상 있는지, 또는 조만간 늘릴 계획이 있는지입니다.
GPUStack vs. 다른 로컬 AI 도구
GPUStack은 로컬 LLM 소프트웨어 디렉터리의 런타임/매니저 부문에 속하지만, 멀티 GPU·멀티 머신 클러스터 오케스트레이션 설계는 단일 기기에서 실행되는 해당 카테고리의 대다수 도구와 GPUStack을 구분짓습니다. 이 리뷰 발행 시점 기준, 이 사이트의 다른 FeatureAppPost 리뷰 중 GPUStack의 진정한 멀티 GPU 클러스터 상대를 다루는 것은 없습니다 — 아래의 가장 가까운 비교 대상은 단일 머신 런타임이며, 솔직히 말해 이들은 다른 문제, 즉 여러 대에 걸쳐 확장하는 것이 아니라 한 대의 기기에서 모델을 실행하는 문제를 해결합니다.
- Ollama — 단일 머신용 범용 로컬 모델 런타임으로, 완전한 MIT 라이선스이며 방대한 모델 라이브러리를 갖추고 있습니다. 여러 GPU나 머신에 걸친 클러스터 오케스트레이션이 필요 없다면 가장 가까운 단일 머신 대안입니다. 전체 Ollama 리뷰를 참고하세요.
- LM Studio — 단일 기기에서의 로컬 추론을 위한 GUI 우선 데스크톱 앱으로, 클러스터 관리자가 아니라 최종 사용자를 대상으로 합니다. 노트북 한 대에서 세련된 채팅 앱을 원한다면 GPUStack보다 더 적합한 선택입니다. 전체 LM Studio 리뷰를 참고하세요.
- Docker Model Runner — 단일 머신에서 모델을 실행하기 위해 Docker Desktop/Engine에 번들로 제공되는 CLI 및 API 기능입니다. 워크로드가 여러 GPU를 모을 필요가 없다면 GPUStack의 클러스터 오케스트레이션 방식과 비교해볼 만한 또 다른 단일 기기 옵션입니다. 전체 Docker Model Runner 리뷰를 참고하세요.
GPUStack 평가 시 흔한 오해
GPUStack을 둘러싼 혼란은 대부분 이를 단일 머신 도구로 취급하거나, 실제로 오케스트레이션하는 추론 엔진들과 직접 경쟁한다고 오해하는 데서 비롯됩니다.
자주 묻는 질문
GPUStack이란 무엇인가요?
GPUStack(github.com/gpustack/gpustack)은 AI 모델 서빙을 위한 오픈소스 GPU 클러스터 매니저입니다 — 이기종 온프레미스 하드웨어 전반에서 추론 엔진을 자동으로 구성하고 오케스트레이션하며, 필요할 때 SSH로 접근 가능한 GPU 인스턴스를 프로비저닝할 수 있습니다.
GPUStack은 Ollama나 LM Studio와 같은 것인가요?
아닙니다. Ollama와 LM Studio는 단일 머신에서 모델을 실행합니다. GPUStack은 서버-워커 아키텍처를 통해 여러 GPU와 여러 머신에 걸쳐 추론을 모으고 스케줄링하는 것이 목적인 클러스터 매니저입니다. 클러스터 오케스트레이션이 필요 없는 독자에게는 Ollama와 LM Studio가 가장 가까운 단일 머신 대안입니다.
GPUStack은 오픈소스인가요?
예. GPUStack은 Apache License 2.0 라이선스로 배포되며, 이는 프로젝트 자체 저장소를 통해 확인되었습니다. 이 리뷰 시점 기준 프로젝트의 공개 사이트에는 GPUStack의 별도 유료 또는 엔터프라이즈 등급이 문서화되어 있지 않습니다.
GPUStack은 무료인가요?
예, GPUStack 자체는 Apache-2.0 하에서 무료입니다. 클러스터를 운영하는 데는 GPUStack 자체의 라이선스와 무관한 실질적인 인프라 비용(GPU, 머신, 네트워크)이 여전히 발생합니다.
GPUStack은 어떻게 설치하나요?
현재 권장되는 방법은 Docker입니다: sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustack. Kubernetes용 Helm 차트를 사용할 수 있으며, 오프라인 환경을 위한 에어갭 경로도 문서화되어 있습니다. 기존 curl 스크립트(curl -sfL https://get.gpustack.ai | sh -s -)는 여전히 작동하지만 v0.7부터 지원 중단되었습니다.
GPUStack은 어떤 플랫폼을 지원하나요?
GPUStack 서버는 Docker를 통해 Linux, macOS, Windows(Docker Desktop)에서 실행됩니다. GPU 용량을 제공하는 머신인 워커 노드는 Linux 전용입니다. 공식 문서에 따르면 macOS는 워커를 실행할 수 없으며, Windows는 해당 역할에 Docker Desktop이 아닌 WSL2가 필요합니다.
GPUStack은 어떤 추론 엔진을 오케스트레이션하나요?
llama-box(llama.cpp/stable-diffusion.cpp를 기반으로 한 GPUStack 자체 구현), vLLM, SGLang, TensorRT-LLM, 화웨이 Ascend NPU 하드웨어용 Ascend MindIE, 그리고 커스텀 추론 엔진 추가 지원입니다.
GPUStack은 OpenAI 호환 API를 제공하나요?
예, 공식 문서에 따르면 그렇습니다. 이미 OpenAI API 형식에 맞춰 구축된 애플리케이션은 최소한의 변경만으로 GPUStack이 관리하는 엔드포인트를 가리킬 수 있습니다.
GPUStack의 GitHub 스타는 몇 개인가요?
이 사이트 자체 디렉터리 검증에 따르면 GPUStack의 저장소(github.com/gpustack/gpustack)는 2026년 9월 5일 기준 5,607개의 스타를 기록했습니다. 시간이 지나며 수치가 바뀌므로 현재 값은 저장소에서 직접 확인하세요.