Points clés
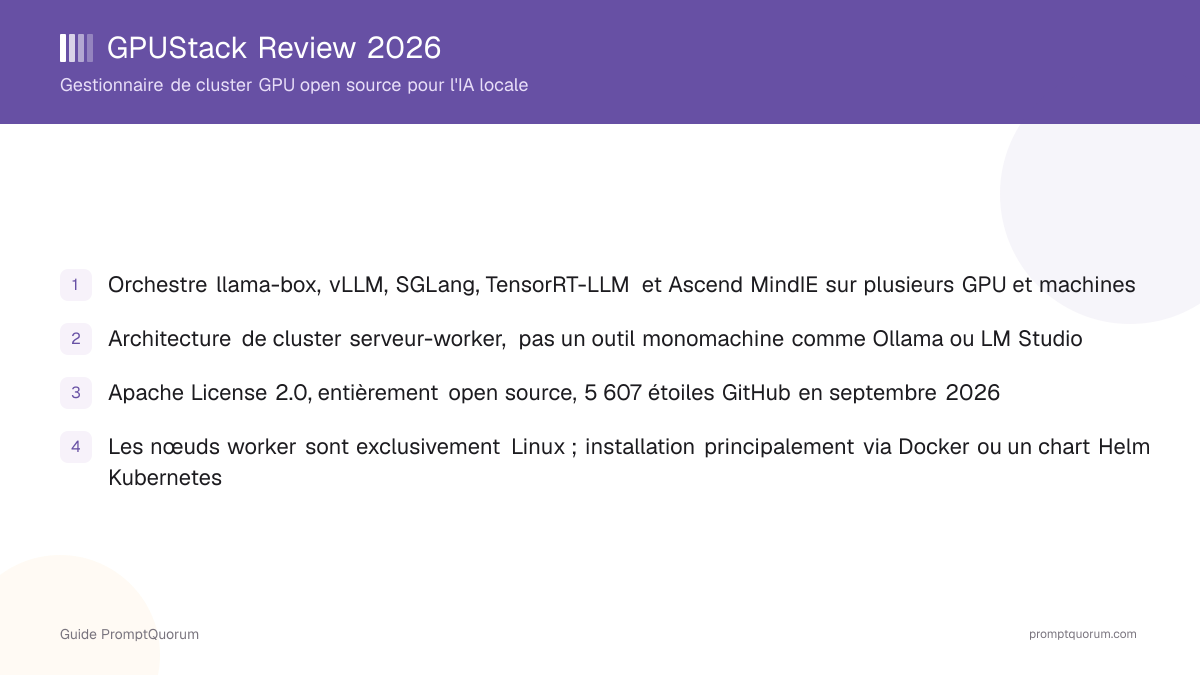
- GPUStack est un gestionnaire de cluster GPU open source pour le service de modèles d'IA ; code source sur github.com/gpustack/gpustack, site du projet gpustack.ai
- Architecture de cluster serveur-worker : un serveur central orchestre un ou plusieurs nœuds worker, chacun apportant de la capacité GPU à un pool partagé
- Orchestre plusieurs moteurs d'inférence — llama-box (implémentation propre basée sur llama.cpp/stable-diffusion.cpp), vLLM, SGLang, TensorRT-LLM et Ascend MindIE — plus la prise en charge de moteurs personnalisés
- Prend en charge du matériel hétérogène : GPU NVIDIA et AMD, NPU Huawei Ascend et DCU Hygon, selon la documentation officielle
- Licence : Apache License 2.0 — entièrement open source ; aucun palier payant ou « entreprise » distinct n'est documenté sur le site public du projet au moment de cette revue
- S'installe principalement via Docker, avec un chart Helm pour Kubernetes et un parcours air-gapped pour les environnements hors ligne ; un script d'installation curl hérité existe encore mais est déprécié depuis GPUStack v0.7
- Les nœuds worker sont exclusivement Linux : le serveur fonctionne via Docker sous Linux, macOS ou Windows, mais seules les machines Linux peuvent servir de worker apportant de la capacité GPU, selon la documentation officielle
- Expose une API compatible OpenAI et peut fournir à la demande des instances GPU accessibles en SSH, pas seulement un point de terminaison d'inférence
- Le dépôt GitHub affiche 5 607 étoiles, vérifié sur github.com/gpustack/gpustack le 5 septembre 2026
📍 En une phrase
GPUStack est un gestionnaire de cluster GPU open source qui configure et orchestre automatiquement des moteurs d'inférence (llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE) sur plusieurs GPU et machines, à la différence d'outils monomachine comme Ollama.
💬 En termes simples
GPUStack permet à une équipe de mutualiser plusieurs GPU — même répartis sur différentes machines physiques — en un cluster gérable pour exécuter des modèles d'IA, plutôt que de laisser chaque GPU inactif dans son propre boîtier. Il choisit le bon moteur d'inférence pour la tâche et permet de se connecter en SSH aux machines du cluster à la demande. Ce n'est pas une application de chat pour un seul ordinateur portable ; il résout un problème de mise à l'échelle, pas un problème « exécuter un modèle sur mon ordinateur ».
📌Remarque: Cette revue est le complément approfondi de l'entrée de GPUStack dans le Local LLM Software Directory — consultez cette page pour voir comment GPUStack se positionne face à des dizaines d'autres outils d'IA locale.
Qu'est-ce que GPUStack ?
GPUStack est un gestionnaire de cluster GPU open source pour le service de modèles d'IA et le provisionnement d'instances GPU. Son dépôt GitHub le décrit comme configurant et orchestrant automatiquement des moteurs d'inférence sur du matériel GPU hétérogène, destiné aux équipes devant mutualiser plusieurs GPU — potentiellement répartis sur plusieurs machines physiques — en un cluster d'inférence gérable, plutôt que d'exécuter un modèle sur un seul appareil.
- Fonction principale : orchestrer l'inférence LLM (et la génération d'images, via la prise en charge de stable-diffusion.cpp par llama-box) sur un cluster de GPU et de machines, pas sur un seul appareil
- Architecture : un serveur GPUStack central coordonne un ou plusieurs nœuds worker, chacun apportant de la capacité GPU à un pool partagé
- Moteurs orchestrés : llama-box (implémentation propre de serveur d'inférence de GPUStack, construite sur llama.cpp et stable-diffusion.cpp), vLLM, SGLang, TensorRT-LLM et Ascend MindIE pour le matériel NPU Huawei Ascend, plus la prise en charge de moteurs d'inférence personnalisés
- Prise en charge matérielle : accélérateurs hétérogènes incluant GPU NVIDIA et AMD, NPU Huawei Ascend et DCU Hygon, selon la documentation officielle
- Instances GPU à la demande : GPUStack peut fournir des instances GPU accessibles en SSH, permettant à un utilisateur de travailler directement sur une machine du cluster plutôt que via une seule API
- Dépôt canonique : github.com/gpustack/gpustack ; site du projet : gpustack.ai
Jalons de GPUStack
GPUStack a été publié comme gestionnaire de cluster open source pour mutualiser la capacité GPU sur du matériel sur site, destiné aux équipes devant servir des modèles sur davantage de puissance de calcul qu'une seule machine ne peut fournir.
- 1Publication initiale — gestionnaire de cluster GPU open source
Why it matters: GPUStack s'est positionné dès son lancement spécifiquement pour orchestrer la capacité GPU sur un cluster, comblant un écart entre les environnements monomachine comme Ollama et les piles complètes de service d'inférence en entreprise. - 2En continu — orchestration multi-moteurs (llama-box, vLLM, SGLang, TensorRT-LLM)
Why it matters: La prise en charge de plusieurs moteurs d'inférence plutôt qu'un seul permet à GPUStack d'orienter une charge de travail vers le moteur le mieux adapté au modèle et au matériel, au lieu d'enfermer les utilisateurs dans un seul moteur. - 3En continu — ajout de la prise en charge d'Ascend MindIE et Hygon DCU
Why it matters: Étendre la prise en charge des moteurs et du matériel aux NPU Huawei Ascend et DCU Hygon, pas seulement aux GPU NVIDIA et AMD, élargit le matériel sur site qu'un cluster peut réellement utiliser. - 4En continu — Docker et Helm établis comme parcours d'installation principaux ; script curl hérité déprécié à la v0.7
Why it matters: Se concentrer sur Docker et un chart Helm pour Kubernetes, plutôt qu'un installateur en script shell, reflète le positionnement de GPUStack comme logiciel d'infrastructure administré par une équipe, pas comme installation ponctuelle pour développeur. - 5En continu — 5 607 étoiles GitHub au 5 septembre 2026
Why it matters: Le nombre d'étoiles est un signal d'usage approximatif, pas une mesure de qualité, mais il indique une adoption réelle pour une catégorie de gestion de cluster que la plupart des utilisateurs d'IA locale ne touchent jamais.
Que pouvez-vous faire avec GPUStack ?
L'ensemble des fonctionnalités de GPUStack vise à rendre l'inférence multi-GPU et multimachine gérable depuis un seul endroit, selon sa documentation officielle.
- Orchestration d'inférence multi-moteurs — configure et exécute automatiquement llama-box, vLLM, SGLang, TensorRT-LLM ou Ascend MindIE selon le modèle et le matériel, plus la prise en charge de moteurs d'inférence personnalisés
- Ordonnancement de cluster sur matériel hétérogène — mutualise les GPU NVIDIA et AMD, les NPU Huawei Ascend et les DCU Hygon en un pool de ressources planifiable commun, selon la documentation officielle
- Instances GPU accessibles en SSH à la demande — fournit des instances dans lesquelles un utilisateur peut se connecter directement en SSH, pas seulement un point de terminaison d'API d'inférence
- API compatible OpenAI — confirmée par la documentation officielle ; le code client OpenAI existant peut pointer vers un point de terminaison géré par GPUStack avec des modifications minimales
- Moteur intégré llama-box — implémentation propre de GPUStack basée sur llama.cpp et stable-diffusion.cpp, prenant en charge l'inférence CPU, une API de function-calling compatible OpenAI, la compatibilité avec l'API Embeddings d'OpenAI, et le décodage spéculatif
- Interface web de gestion et CLI — le serveur expose une interface web (port 80 par défaut) en plus d'un accès CLI et API, selon la documentation officielle de prise en main
- Déploiement natif Kubernetes via Helm — pour les équipes exploitant déjà Kubernetes, GPUStack fournit un chart Helm officiel plutôt que d'exiger un déploiement sur mesure
- Parcours d'installation air-gapped — documenté pour les environnements sans accès internet, pertinent pour les déploiements sur site ou réglementés
Exemples d'utilisation : trois façons d'utiliser GPUStack
Ce sont des flux de travail construits à partir de l'installation Docker documentée, du guide de prise en main et de l'API de GPUStack — pas des cas d'usage hypothétiques.
Installation et prise en main
GPUStack est un outil de serveur et de cluster auto-hébergé, pas une application grand public avec un bouton de téléchargement, donc l'installation passe par Docker, un chart Helm, ou (historiquement) un script shell — pas un installateur signé depuis une page marketing.
- 1Docker (méthode actuellement recommandée, selon la documentation officielle) : exécutez
sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustacksur la machine qui servira de serveur GPUStack ; le serveur lui-même fonctionne sous Linux, macOS ou Windows via Docker Desktop. - 2Kubernetes : déployez le chart Helm officiel si votre équipe exploite déjà Kubernetes, selon la documentation d'installation.
- 3Environnements air-gapped : suivez le parcours d'installation air-gapped documenté si la machine cible n'a pas d'accès internet.
- 4Un installateur de bureau pour macOS et Windows est également mentionné dans l'historique des versions de GPUStack pour configurer un serveur sans Docker — confirmez le lien de téléchargement actuel directement sur gpustack.ai, car il ne fait pas partie de la navigation principale de la documentation à la date de publication de cette revue.
- 5Alternative héritée, plutôt orientée Linux :
curl -sfL https://get.gpustack.ai | sh -s -— ce script d'installation fonctionne encore mais est déprécié depuis GPUStack v0.7 au profit des parcours Docker et Helm ci-dessus ; considérez-le comme un repli, pas comme le choix par défaut pour une nouvelle installation. - 6Pour s'étendre au-delà d'une machine, rattachez des machines Linux supplémentaires au cluster en tant que nœuds worker. Les nœuds worker sont exclusivement Linux — macOS n'est pas pris en charge pour le rôle de worker, et Windows nécessite WSL2 plutôt que Docker Desktop.
Tarifs et licence de GPUStack
GPUStack lui-même est gratuit et sous licence Apache License 2.0, confirmé via le dépôt propre du projet — aucun palier payant ou « entreprise » distinct de GPUStack n'est documenté sur le site public du projet ou sa documentation officielle à la date de cette revue. Chaque fonctionnalité couverte dans cette revue, y compris l'orchestration multi-moteurs et l'ordonnancement de cluster, fait partie du même projet open source.
GPUStack vs. environnements monomachine
GPUStack est comparé à des outils comme Ollama et LM Studio parce que les trois exécutent des modèles ouverts en local — mais GPUStack résout un problème différent : mettre à l'échelle l'inférence sur plusieurs GPU et machines, pas exécuter un modèle sur un seul appareil. Ni Ollama ni LM Studio ne sont un véritable pendant en orchestration de cluster à GPUStack ; ce sont, honnêtement, les alternatives monomachine les plus proches pour les lecteurs qui n'ont pas besoin d'orchestration de cluster.
Objectif principal
- GPUStack:
- Gestionnaire de cluster GPU — orchestre l'inférence sur plusieurs GPU et machines
- Ollama / LM Studio:
- Environnement monomachine pour modèles locaux et/ou application de chat de bureau
Architecture
- GPUStack:
- Serveur central plus un ou plusieurs nœuds worker apportant de la capacité GPU
- Ollama / LM Studio:
- Un processus sur un appareil ; pas de clustering multimachine intégré
Moteurs
- GPUStack:
- Orchestre llama-box, vLLM, SGLang, TensorRT-LLM, Ascend MindIE ou des moteurs personnalisés
- Ollama / LM Studio:
- Moteur intégré basé sur llama.cpp (Ollama) ; llama.cpp / MLX (LM Studio)
Instances GPU à la demande
- GPUStack:
- Oui — fournit des instances accessibles en SSH au sein du cluster
- Ollama / LM Studio:
- Aucune fonctionnalité équivalente
Licence
- GPUStack:
- Apache-2.0
- Ollama / LM Studio:
- MIT (Ollama) ; propriétaire gratuit (LM Studio)
Utilisateur type
- GPUStack:
- Une équipe avec plusieurs GPU ou machines à mutualiser pour le service
- Ollama / LM Studio:
- Un particulier exécutant des modèles sur un seul ordinateur portable ou poste de travail
Si vous n'avez qu'un seul GPU et aucun projet d'en ajouter d'autres, la mécanique de cluster de GPUStack est une surcharge dont vous n'avez pas besoin — Ollama ou LM Studio fera tourner un modèle plus rapidement sur une seule machine. Voir la revue Ollama et la revue LM Studio complètes pour plus de détails.
À qui s'adresse GPUStack ?
La pertinence d'adopter GPUStack dépend presque entièrement d'une seule question : avez-vous plus d'un GPU ou d'une machine à mutualiser, ou prévoyez-vous d'en ajouter bientôt ?
GPUStack vs. autres outils d'IA locale
GPUStack se situe dans le segment gestionnaires-et-environnements-d'exécution du Local LLM Software Directory, mais sa conception d'orchestration de cluster multi-GPU, multimachine le distingue de la plupart des outils de cette catégorie, qui fonctionnent sur un seul appareil. Aucune autre revue FeatureAppPost de ce site ne couvre un véritable pendant multi-GPU en cluster à GPUStack à la date de publication de cette revue — les comparaisons les plus proches ci-dessous sont des environnements monomachine, qui résolvent honnêtement un problème différent : exécuter un modèle sur un appareil, pas le faire évoluer sur plusieurs.
- Ollama — un environnement d'exécution local polyvalent pour une seule machine, entièrement sous licence MIT, avec une large bibliothèque de modèles. L'alternative monomachine la plus proche si vous n'avez pas besoin d'orchestration de cluster sur plusieurs GPU ou machines. Voir la revue Ollama complète.
- LM Studio — une application de bureau GUI-first pour l'inférence locale sur un seul appareil, destinée aux utilisateurs finaux plutôt qu'aux administrateurs de cluster. Un choix plus adapté que GPUStack si vous voulez une application de chat soignée sur un seul ordinateur portable. Voir la revue LM Studio complète.
- Docker Model Runner — une fonctionnalité CLI et API intégrée à Docker Desktop/Engine pour exécuter des modèles sur une seule machine ; une autre option monomachine à comparer à l'approche d'orchestration de cluster de GPUStack si votre charge de travail n'a pas besoin de plusieurs GPU mutualisés. Voir la revue Docker Model Runner complète.
Erreurs courantes lors de l'évaluation de GPUStack
La plupart des confusions autour de GPUStack viennent du fait de le traiter comme un outil monomachine, ou de supposer qu'il fait directement concurrence aux moteurs d'inférence qu'il orchestre réellement.
Questions fréquentes
Qu'est-ce que GPUStack ?
GPUStack (github.com/gpustack/gpustack) est un gestionnaire de cluster GPU open source pour le service de modèles d'IA — il configure et orchestre automatiquement des moteurs d'inférence sur du matériel hétérogène sur site et peut fournir à la demande des instances GPU accessibles en SSH.
GPUStack est-il la même chose qu'Ollama ou LM Studio ?
Non. Ollama et LM Studio exécutent des modèles sur une seule machine. GPUStack est un gestionnaire de cluster dont l'objectif est de mutualiser et répartir l'inférence sur plusieurs GPU et plusieurs machines via une architecture serveur-worker. Ollama et LM Studio sont les alternatives monomachine les plus proches pour les lecteurs qui n'ont pas besoin d'orchestration de cluster.
GPUStack est-il open source ?
Oui. GPUStack est sous licence Apache License 2.0, confirmé via le dépôt propre du projet. Aucun palier payant ou entreprise distinct de GPUStack n'est documenté sur le site public du projet à la date de cette revue.
GPUStack est-il gratuit ?
Oui, GPUStack lui-même est gratuit sous Apache-2.0. Exploiter un cluster entraîne toujours des coûts d'infrastructure réels (GPU, machines, réseau) sans rapport avec la licence propre de GPUStack.
Comment installer GPUStack ?
La méthode actuellement recommandée est Docker : sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustack. Un chart Helm est disponible pour Kubernetes, et un parcours air-gapped est documenté pour les environnements hors ligne. Un script curl hérité (curl -sfL https://get.gpustack.ai | sh -s -) fonctionne encore mais est déprécié depuis la v0.7.
Quelles plateformes GPUStack prend-il en charge ?
Le serveur GPUStack fonctionne via Docker sous Linux, macOS ou Windows (Docker Desktop). Les nœuds worker — les machines qui apportent de la capacité GPU — sont exclusivement Linux ; macOS ne peut pas exécuter de worker, et Windows a besoin de WSL2 plutôt que de Docker Desktop pour ce rôle, selon la documentation officielle.
Quels moteurs d'inférence GPUStack orchestre-t-il ?
llama-box (implémentation propre de GPUStack basée sur llama.cpp/stable-diffusion.cpp), vLLM, SGLang, TensorRT-LLM et Ascend MindIE pour le matériel NPU Huawei Ascend, plus la prise en charge de moteurs d'inférence personnalisés.
GPUStack expose-t-il une API compatible OpenAI ?
Oui, selon la documentation officielle, si bien que les applications déjà construites sur la structure de l'API OpenAI peuvent pointer vers un point de terminaison géré par GPUStack avec des modifications minimales.
Combien d'étoiles GitHub GPUStack a-t-il ?
Le dépôt de GPUStack (github.com/gpustack/gpustack) affichait 5 607 étoiles au 5 septembre 2026, selon la vérification propre à l'annuaire de ce site. Consultez directement le dépôt pour un décompte à jour, car il évolue avec le temps.