重要なポイント
- GPUStackはAIモデルサービング向けのオープンソースGPUクラスターマネージャー。ソースコードはgithub.com/gpustack/gpustack、プロジェクトサイトはgpustack.ai
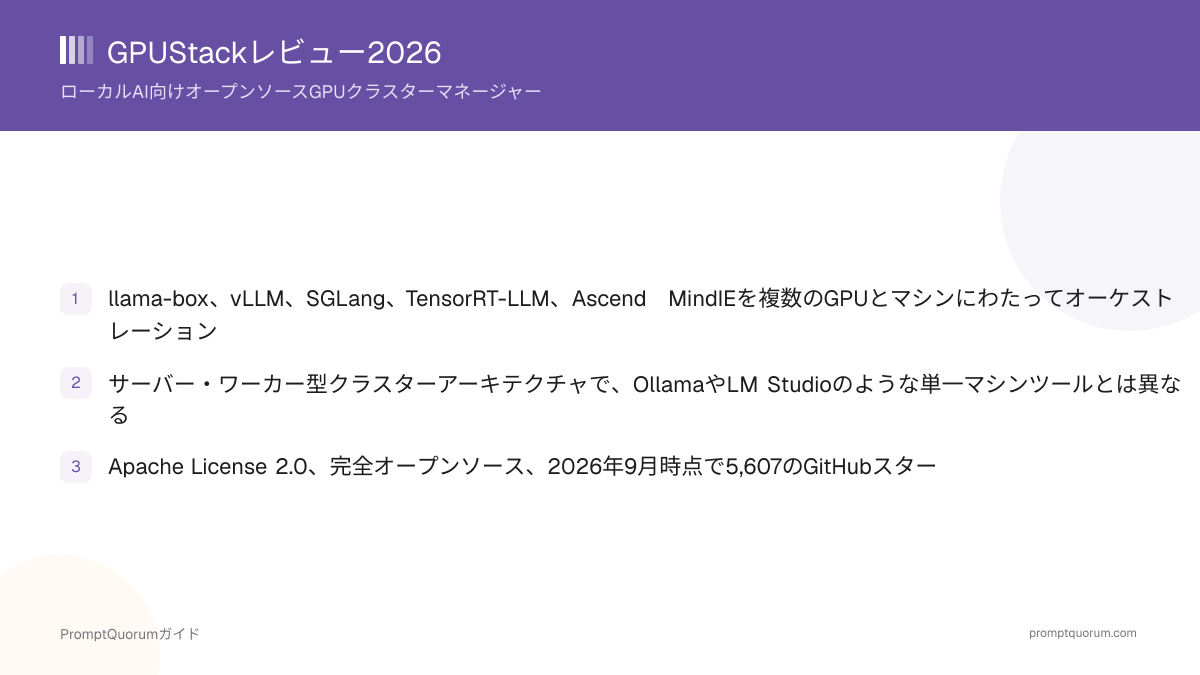
- サーバー・ワーカー型クラスターアーキテクチャ:中央サーバーが1つ以上のワーカーノードをオーケストレーションし、それぞれが共有プールにGPU容量を提供する
- 複数の推論バックエンドをオーケストレーション——llama-box(独自のllama.cpp/stable-diffusion.cpp実装)、vLLM、SGLang、TensorRT-LLM、Ascend MindIE——加えてカスタムエンジン追加のサポート
- 異種混在ハードウェアをサポート:NVIDIAおよびAMD GPU、Huawei Ascend NPU、Hygon DCU(公式ドキュメントによる)
- ライセンス:Apache License 2.0——完全にオープンソース。本レビュー時点でプロジェクトの公開サイトには別途の有料または「エンタープライズ」ティアの記載なし
- 主にDocker経由でインストールし、Kubernetes向けHelmチャートとオフライン環境向けエアギャップ手順あり。従来のcurlインストールスクリプトは存在するがGPUStack v0.7以降非推奨
- ワーカーノードはLinux専用: サーバーはDocker経由でLinux・macOS・Windowsで動作するが、公式ドキュメントによるとGPU容量を提供できるワーカーはLinuxマシンのみ
- OpenAI互換APIを提供し、推論エンドポイントだけでなく、必要に応じてSSHでアクセス可能なGPUインスタンスをプロビジョニング可能
- GitHubリポジトリは2026年9月5日時点でgithub.com/gpustack/gpustackに対して検証済みの5,607スターを記録
📍 一文で説明
GPUStackはオープンソースのGPUクラスターマネージャーで、複数のGPUとマシンにわたって推論エンジン(llama-box、vLLM、SGLang、TensorRT-LLM、Ascend MindIE)を自動的に構成・オーケストレーションし、Ollamaのような単一マシンツールとは異なります。
💬 簡潔に説明
GPUStackを使うと、チームは複数のGPU——異なる物理マシンに分散していても——を、AIモデルを実行するための管理しやすい1つのクラスターにプールできます。それぞれのGPUを個別の箱に眠らせておく代わりです。適切な推論エンジンを自動で選び、必要に応じてクラスター内のマシンにSSHでアクセスできます。1台のノートPC向けのチャットアプリではなく、スケーリングの問題を解決するものであり、「自分のコンピュータでモデルを動かす」問題を解決するものではありません。
📌補足: このレビューはローカルLLMソフトウェアディレクトリにあるGPUStackのエントリーを深掘りした記事です——他の数十のローカルAIツールと比べてGPUStackがどう位置づけられるかは、そちらのページをご覧ください。
GPUStackとは何か
GPUStackはAIモデルサービングとGPUインスタンスプロビジョニング向けのオープンソースGPUクラスターマネージャーです。GitHubリポジトリでは、異種混在のGPUハードウェア上で推論エンジンを自動的に構成・オーケストレーションするツールと説明されており、複数の物理マシンに分散している可能性のある複数のGPUを、単一デバイスでモデルを実行する代わりに、1つの管理しやすい推論クラスターにプールする必要のあるチームを対象としています。
- 中核機能:単一デバイスではなく、GPUとマシンのクラスター全体でLLM推論(llama-boxのstable-diffusion.cppサポートを通じた画像生成も含む)をオーケストレーションする
- アーキテクチャ:中央のGPUStackサーバーが1つ以上のワーカーノードを調整し、それぞれが共有プールにGPU容量を提供する
- オーケストレーションされるバックエンド:llama-box(llama.cppとstable-diffusion.cppをベースにしたGPUStack独自の推論サーバー実装)、vLLM、SGLang、TensorRT-LLM、Huawei Ascend NPUハードウェア向けのAscend MindIE、加えてカスタム推論エンジンのサポート
- ハードウェアサポート:NVIDIAおよびAMD GPU、Huawei Ascend NPU、Hygon DCUを含む異種混在アクセラレーター(公式ドキュメントによる)
- オンデマンドGPUインスタンス:GPUStackはSSHでアクセス可能なGPUインスタンスをプロビジョニングでき、ユーザーはAPI経由だけでなくクラスター内のマシンで直接作業できる
- 正規のリポジトリ:github.com/gpustack/gpustack。プロジェクトサイト:gpustack.ai
GPUStackのマイルストーン
GPUStackは、単一マシンが提供できる以上の計算資源にわたってモデルをサービングする必要のあるチームを対象に、オンプレミスハードウェア全体でGPU容量をプールするオープンソースクラスターマネージャーとしてリリースされました。
- 1初回リリース——オープンソースGPUクラスターマネージャー
Why it matters: GPUStackは当初からクラスター全体でGPU容量をオーケストレーションすることに特化して位置づけられ、Ollamaのような単一マシンランタイムと本格的なエンタープライズ推論サービングスタックの間のギャップを埋めました。 - 2継続中——マルチバックエンドオーケストレーション(llama-box、vLLM、SGLang、TensorRT-LLM)
Why it matters: 単一エンジンではなく複数の推論エンジンをサポートすることで、GPUStackはワークロードをモデルとハードウェアに最も適したバックエンドに振り分けられ、単一エンジンにユーザーを縛り付けません。 - 3継続中——Ascend MindIEとHygon DCUサポートの追加
Why it matters: NVIDIAおよびAMD GPUだけでなく、Huawei Ascend NPUやHygon DCUにバックエンドとハードウェアのサポートを拡張することで、クラスターが実際に利用できるオンプレミスハードウェアの幅が広がります。 - 4継続中——DockerとHelmが主要なインストール手段として確立、従来のcurlスクリプトはv0.7で非推奨に
Why it matters: シェルスクリプトのインストーラーではなくDockerとKubernetes向けHelmチャートに集約することは、GPUStackが単発の開発者向けインストールではなく、チームが運用するインフラソフトウェアとして位置づけられていることを反映しています。 - 5継続中——2026年9月5日時点で5,607のGitHubスター
Why it matters: スター数は大まかな利用状況のシグナルであり品質の指標ではありませんが、ほとんどのローカルAIユーザーが触れることのないクラスター管理というカテゴリーで、実際の採用があることを示しています。
GPUStackでできること
GPUStackの機能セットは、公式ドキュメントによると、マルチGPU・マルチマシンの推論を1か所から管理可能にすることに重点を置いています。
- マルチバックエンド推論オーケストレーション——モデルとハードウェアに応じてllama-box、vLLM、SGLang、TensorRT-LLM、Ascend MindIEを自動的に構成・実行し、カスタム推論エンジンの追加もサポート
- 異種混在ハードウェア全体のクラスタースケジューリング——公式ドキュメントによると、NVIDIAおよびAMD GPU、Huawei Ascend NPU、Hygon DCUを1つのスケジュール可能なリソースプールにプール
- オンデマンドでSSHアクセス可能なGPUインスタンス——推論APIエンドポイントだけでなく、ユーザーが直接SSHできるインスタンスをプロビジョニング
- OpenAI互換API——公式ドキュメントで確認済み。既存のOpenAIクライアントコードは、最小限の変更でGPUStack管理下のエンドポイントを指せる
- 組み込みllama-boxエンジン——llama.cppとstable-diffusion.cppをベースにしたGPUStack独自の実装で、CPU推論、OpenAI Function-calling API、OpenAI Embeddings API互換性、投機的デコーディングをサポート
- Web管理UIとCLI——公式クイックスタートドキュメントによると、サーバーはCLI・APIアクセスに加えてWebインターフェース(デフォルトポート80)を提供
- Helm経由のKubernetesネイティブデプロイ——既にKubernetesを運用しているチーム向けに、GPUStackは独自デプロイを要求する代わりに公式Helmチャートを提供
- エアギャップインストール手順——インターネットアクセスのない環境向けに記載されており、オンプレミスや規制対象の展開に関連
利用例:GPUStackの3つの使い方
これらはGPUStackの公式Dockerインストール、クイックスタート、APIに基づいたワークフローであり、仮定のユースケースではありません。
インストールと始め方
GPUStackはセルフホスト型のサーバー・クラスターツールであり、ダウンロードボタン付きの一般消費者向けアプリではありません。そのため、マーケティングページからの署名済みインストーラーではなく、Docker、Helmチャート、(従来型の)シェルスクリプト経由でインストールします。
- 1Docker(公式ドキュメントによる現在の推奨方法):GPUStackサーバーとして機能させるマシンで
sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustackを実行する。サーバー自体はDocker Desktop経由でLinux・macOS・Windowで動作する。 - 2Kubernetes:チームが既にKubernetesを運用している場合は、インストールドキュメントに従って公式Helmチャートをデプロイする。
- 3エアギャップ環境:対象マシンにインターネットアクセスがない場合は、記載されているエアギャップインストール手順に従う。
- 4macOSとWindows向けのデスクトップインストーラーも、Dockerを使わずにサーバーをセットアップする方法としてGPUStackのリリース履歴で言及されています——本レビュー公開時点では主要なドキュメントナビゲーションの一部ではないため、現在のダウンロードリンクはgpustack.aiで直接確認してください。
- 5従来型でLinux寄りの代替手段:
curl -sfL https://get.gpustack.ai | sh -s -——このインストールスクリプトはまだ動作しますが、GPUStack v0.7以降は上記のDockerおよびHelm手順を優先して非推奨とされています。新規インストールのデフォルトの選択肢ではなく、フォールバックとして扱ってください。 - 61台のマシンを超えてスケールするには、追加のLinuxマシンをワーカーノードとしてクラスターに参加させます。ワーカーノードはLinux専用です——macOSはワーカー役割をサポートせず、WindowsはDocker DesktopではなくWSL2が必要です。
GPUStackの料金とライセンス
GPUStack自体は無料で、Apache License 2.0の下でライセンスされています。これはプロジェクト自身のリポジトリで確認済みです——本レビュー時点で、プロジェクトの公開サイトや公式ドキュメントには、GPUStackの別途の有料または「エンタープライズ」ティアの記載はありません。マルチバックエンドオーケストレーションやクラスタースケジューリングを含め、本レビューで扱ったすべての機能は同じオープンソースプロジェクトの一部です。
GPUStack vs. 単一マシンランタイム
GPUStackはOllamaやLM Studioのようなツールと比較されがちです。3つともオープンモデルをローカルで実行するからですが、GPUStackは異なる問題を解決しています。それは1台のデバイスでモデルを動かすことではなく、複数のGPUとマシンにわたって推論をスケールすることです。OllamaもLM Studioも、GPUStackの真のクラスターオーケストレーション上の対抗馬ではありません。正直に言えば、クラスターオーケストレーションを必要としない読者にとって最も近い単一マシンの代替手段です。
主な目的
- GPUStack:
- GPUクラスターマネージャー——複数のGPUとマシンにわたって推論をオーケストレーション
- Ollama / LM Studio:
- 単一マシン向けのローカルモデルランタイムおよび/またはデスクトップチャットアプリ
アーキテクチャ
- GPUStack:
- 中央サーバーと、GPU容量を提供する1つ以上のワーカーノード
- Ollama / LM Studio:
- 1台のデバイス上の1プロセス。組み込みのマルチマシンクラスタリングなし
バックエンド
- GPUStack:
- llama-box、vLLM、SGLang、TensorRT-LLM、Ascend MindIE、またはカスタムエンジンをオーケストレーション
- Ollama / LM Studio:
- llama.cppベースの組み込みエンジン(Ollama)。llama.cpp / MLX(LM Studio)
オンデマンドGPUインスタンス
- GPUStack:
- あり——クラスター内でSSHアクセス可能なインスタンスをプロビジョニング
- Ollama / LM Studio:
- 同等の機能なし
ライセンス
- GPUStack:
- Apache-2.0
- Ollama / LM Studio:
- MIT(Ollama)。無料のプロプライエタリ(LM Studio)
典型的なユーザー
- GPUStack:
- サービング用に複数のGPUやマシンをプールしたいチーム
- Ollama / LM Studio:
- 1台のノートPCやワークステーションでモデルを実行する個人
GPUが1つしかなく増やす予定がない場合、GPUStackのクラスター機構は不要なオーバーヘッドです——OllamaやLM Studioなら1台のマシンでより速くモデルを動かせます。詳細はOllamaレビューとLM Studioレビューの全文をご覧ください。
GPUStackはどんな人に向いているか
GPUStackを採用する価値があるかどうかは、ほぼ1つの問いにかかっています。プールすべきGPUやマシンが2つ以上あるか、あるいは近いうちに増やす予定があるか、です。
GPUStack vs. 他のローカルAIツール
GPUStackはローカルLLMソフトウェアディレクトリのランタイム・マネージャーセグメントに位置しますが、そのマルチGPU・マルチマシンのクラスターオーケストレーション設計は、単一デバイスで動作するこのカテゴリーのほとんどのツールとは一線を画しています。本レビューの公開時点で、GPUStackの真のマルチGPUクラスター上の対抗馬を扱う他のFeatureAppPostレビューは当サイトにはありません——以下の最も近い比較対象は単一マシンランタイムであり、正直に言えば異なる問題(多数にわたってスケールすることではなく、1台のデバイスでモデルを動かすこと)を解決しています。
- Ollama ——単一マシン向けの汎用ローカルモデルランタイムで、完全にMITライセンス、幅広いモデルライブラリを持つ。複数のGPUやマシンにわたるクラスターオーケストレーションが不要な場合、最も近い単一マシンの代替手段。Ollamaレビュー全文を参照。
- LM Studio ——1台のデバイス上でのローカル推論向けのGUIファーストのデスクトップアプリで、クラスター管理者ではなくエンドユーザーを対象としている。1台のノートPCで洗練されたチャットアプリが欲しい場合、GPUStackよりも適した選択肢。LM Studioレビュー全文を参照。
- Docker Model Runner ——単一マシンでモデルを実行するためにDocker Desktop/Engineにバンドルされたcli・APIの機能。ワークロードが複数GPUのプールを必要としない場合、GPUStackのクラスターオーケストレーションアプローチと比較検討できるもう1つの単一デバイス向け選択肢。Docker Model Runnerレビュー全文を参照。
GPUStack評価でよくある誤解
GPUStackをめぐる混乱の多くは、それを単一マシンツールとして扱うこと、あるいは実際にオーケストレーションしている推論エンジンと直接競合していると誤解することから生じます。
よくある質問
GPUStackとは何ですか。
GPUStack(github.com/gpustack/gpustack)はAIモデルサービング向けのオープンソースGPUクラスターマネージャーです——異種混在のオンプレミスハードウェア上で推論エンジンを自動的に構成・オーケストレーションし、必要に応じてSSHでアクセス可能なGPUインスタンスをプロビジョニングできます。
GPUStackはOllamaやLM Studioと同じものですか。
いいえ。OllamaとLM Studioは1台のマシンでモデルを実行します。GPUStackはサーバー・ワーカーアーキテクチャを通じて複数のGPUと複数のマシンにわたって推論をプールし、スケジューリングすることを目的としたクラスターマネージャーです。クラスターオーケストレーションを必要としない読者にとって、OllamaとLM Studioは最も近い単一マシンの代替手段です。
GPUStackはオープンソースですか。
はい。GPUStackはApache License 2.0の下でライセンスされており、プロジェクト自身のリポジトリで確認済みです。本レビュー時点で、プロジェクトの公開サイトに別途の有料またはエンタープライズティアの記載はありません。
GPUStackは無料ですか。
はい、GPUStack自体はApache-2.0の下で無料です。クラスターの運用には、GPUStack自体のライセンスとは無関係の実際のインフラコスト(GPU、マシン、ネットワーク)がかかります。
GPUStackはどうやってインストールしますか。
現在推奨されている方法はDockerです:sudo docker run -d --name gpustack --restart unless-stopped -p 80:80 --volume gpustack-data:/var/lib/gpustack gpustack/gpustack。Kubernetes向けにHelmチャートが利用可能で、オフライン環境向けにエアギャップ手順が記載されています。従来のcurlスクリプト(curl -sfL https://get.gpustack.ai | sh -s -)はまだ動作しますが、v0.7以降は非推奨です。
GPUStackはどのプラットフォームをサポートしていますか。
GPUStackサーバーはDocker経由でLinux・macOS・Windows(Docker Desktop)で動作します。GPU容量を提供するマシンであるワーカーノードはLinux専用です。公式ドキュメントによると、macOSはワーカーを実行できず、Windowsはその役割にDocker DesktopではなくWSL2が必要です。
GPUStackはどの推論エンジンをオーケストレーションしますか。
llama-box(llama.cpp/stable-diffusion.cppをベースにしたGPUStack独自の実装)、vLLM、SGLang、TensorRT-LLM、Huawei Ascend NPUハードウェア向けのAscend MindIE、加えてカスタム推論エンジンのサポートです。
GPUStackはOpenAI互換APIを提供していますか。
はい、公式ドキュメントによると提供しています。そのため、既にOpenAI API形式向けに構築されたアプリケーションは、最小限の変更でGPUStack管理下のエンドポイントを指すことができます。
GPUStackのGitHubスターはいくつですか。
GPUStackのリポジトリ(github.com/gpustack/gpustack)は、当サイト独自のディレクトリ検証によると2026年9月5日時点で5,607スターを記録していました。時間とともに変化するため、最新の数字はリポジトリで直接確認してください。