Was ist LLaMA-Factory?
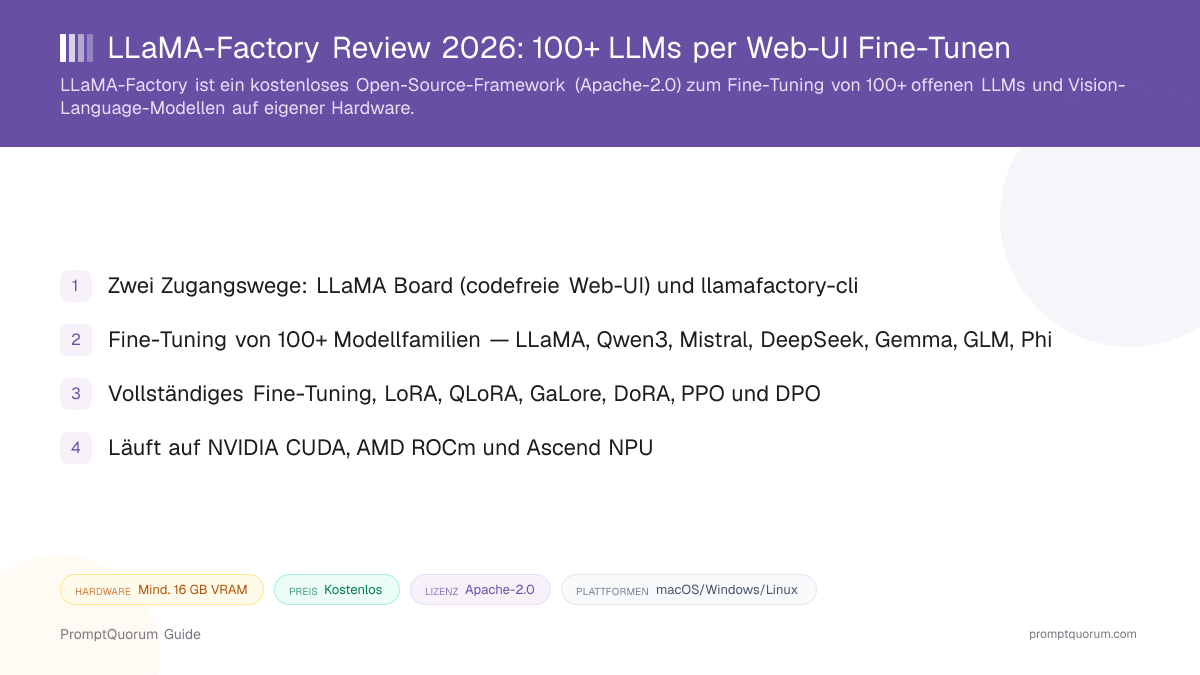
LLaMA-Factory ist ein Framework zum Fine-Tuning offener LLMs und Vision-Language-Modelle auf Hardware, die Sie selbst kontrollieren — über eine Weboberfläche statt ein handgeschriebenes Trainingsskript. Die eigene GitHub-Beschreibung lautet „Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)" und verweist auf ein wissenschaftliches Paper, das auf der ACL-2024-Konferenz (Association for Computational Linguistics) angenommen wurde. Die Projektseite unter llamafactory.readthedocs.io beschreibt es als „eine einfach zu bedienende und effiziente Plattform zum Trainieren und Fine-Tunen von Large Language Models", mit der Nutzer „Hunderte vortrainierter Modelle lokal fine-tunen können, ohne Code zu schreiben".
- Kernfunktion: Basismodell, Datensatz und Fine-Tuning-Methode (LoRA, QLoRA oder vollständig) über die Weboberfläche von LLaMA Board oder eine YAML-Konfigurationsdatei auswählen, dann das Ergebnis ausführen oder exportieren
- Nicht nur Text: Neben Text-LLMs listet das README Unterstützung für Vision-Language-Modelle (VLM), einschließlich Modellen wie LLaVA und Qwen3-VL
- Zwei Produkte, eine Engine: LLaMA Board (die Gradio-Weboberfläche, gestartet mit
llamafactory-cli webui) undllamafactory-cli(das Kommandozeilen-Tool, auf dem sowohl die Oberfläche als auch skriptbasierte Workflows aufbauen) - Namensgebung des Repositorys: Das GitHub-Repository wurde von
LLaMA-FactoryzuLlamaFactoryumbenannt — nur die Schreibweise ändert sich; die alte URL (github.com/hiyouga/LLaMA-Factory) leitet per Redirect auf dasselbe Repository mit denselben Sternen und derselben Commit-Historie weiter - Maintainer: hiyouga, laut GitHub-API als einzelner Nutzer (kein Unternehmen) gelistet, obwohl das README angibt, das Projekt werde unter anderem „von Amazon, NVIDIA, Aliyun" genutzt — eine Angabe aus dem eigenen README des Projekts, die diese Review nicht unabhängig überprüft hat
Release-Historie von LLaMA-Factory
Die überprüfbare Zeitachse von LLaMA-Factory stammt aus zwei offiziellen Quellen: den eigenen Repository-Metadaten von GitHub und den mit Tags versehenen Releases des Projekts auf GitHub.
- Das GitHub-Repository wurde laut Repository-Metadaten von GitHub am 28. Mai 2023 erstellt — ursprünglich unter dem Namen
LLaMA-Factory - Das zugehörige wissenschaftliche Paper des Projekts, „LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models", wurde laut der eigenen Beschreibungszeile des Repositorys auf der ACL 2024 angenommen
- Das Repository wurde später zu
LlamaFactoryumbenannt (nur die Schreibweise); GitHub leitet die alteLLaMA-Factory-URL automatisch weiter und erhält dabei dieselben Sterne, Forks und die Commit-Historie - Das jüngste getaggte Release, v0.9.5 („Qwen3.5/3.6, Gemma 4, Transformers v5"), wurde laut GitHubs Releases-API am 30. Mai 2026 veröffentlicht
- Commits im
main-Branch gingen danach weiter — GitHubs Metadaten zeigen einen Push innerhalb weniger Tage vor dem Recherchedatum dieser Review, was auf aktive tägliche Weiterentwicklung über das letzte formale Release hinaus hindeutet
Was können Sie mit LLaMA-Factory tun?
Der Funktionsumfang von LLaMA-Factory erstreckt sich über Trainingsmethoden, Modellbreite, Hardware-Backends und Deployment. Hier, was jeder Teil laut eigenem GitHub-README und eigener Dokumentation tatsächlich leistet.
- Trainingsmethoden — vollständiges Fine-Tuning, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA und OFT/OFTv2, über Pretraining, überwachtes Fine-Tuning (SFT), Reward Modeling, PPO und DPO hinweg
- Modellbreite — über 100 Modellfamilien, darunter LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM und Phi, von 270M bis 671B Parametern, plus Vision-Language-Modelle wie LLaVA und Qwen3-VL, laut README
- Codefreie Weboberfläche — LLaMA Board, eine Gradio-Oberfläche, deckt Training, Evaluierung und Inferenz ab, ohne ein Trainingsskript zu schreiben
- Kommandozeilen-Tool —
llamafactory-clibietet die Unterbefehletrain,chat,export,webuiundversion, um dieselben Workflows, die LLaMA Board interaktiv abdeckt, zu skripten - Quantisierungsunterstützung — die Formate AQLM, AWQ, GPTQ, LLM.int8, HQQ und EETQ werden unterstützt, ebenso Beschleunigung über FlashAttention-2 und eine optionale Unsloth-Kernel-Integration
- Deployment — trainierte Modelle lassen sich über eine OpenAI-artige lokale API oder einen vLLM-Worker für höheren Durchsatz bereitstellen
- Verteiltes Training — der Advanced-Bereich der Dokumentation behandelt Multi-GPU- und Multi-Node-Training sowie DeepSpeed-Integration für speichereffiziente verteilte Jobs
- Experiment-Tracking — laut Dokumentation Integration mit Wandb und TensorBoard zur Überwachung von Trainingsläufen
Anwendungsbeispiele: Zwei Wege, mit LLaMA-Factory zu fine-tunen
Dies sind konkrete Arbeitsabläufe, aufgebaut auf den oben dokumentierten Befehlen von LLaMA-Factory — keine hypothetischen Anwendungsfälle.
Ein Modell mit der LLaMA-Board-Weboberfläche fine-tunen
Führen Sie nach der Installation von LLaMA-Factory llamafactory-cli webui aus, um LLaMA Board im Browser zu starten. Wählen Sie ein Basismodell aus dem Dropdown, verweisen Sie auf einen Datensatz, wählen Sie LoRA oder QLoRA als Methode und starten Sie den Job — ohne YAML-Datei oder Trainingsskript.
Per Kommandozeile mit einer YAML-Konfiguration fine-tunen
Führen Sie llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml aus (oder eine angepasste Kopie einer der Beispielkonfigurationen), um einen skriptbasierten Trainingslauf zu starten — ein Ansatz, der besser zu CI-Pipelines oder wiederholten Experimenten passt als die interaktive Weboberfläche.
Das fine-getunte Modell exportieren und bereitstellen
Führen Sie nach dem Training llamafactory-cli export aus, um LoRA-Gewichte in ein eigenständiges Modell zusammenzuführen, und stellen Sie es dann über die OpenAI-artige lokale API für jeden OpenAI-kompatiblen Client bereit — oder übergeben Sie es einem separaten lokalen Inferenz-Tool wie Ollama für den täglichen Gebrauch.
LLaMA-Factory installieren: Pip, Git und Docker
LLaMA-Factory ist keine herunterladbare Endnutzer-App — es wird laut eigenem GitHub-README und eigener Installationsdokumentation als Python-Paket installiert. Die untenstehenden Links sind die eigenen dokumentierten Befehle des Projekts; prüfen Sie diese stets direkt anhand der Dokumentation, da sich Extras und Docker-Pfade zwischen Versionen ändern können.
Installationsweg | Befehl oder Link |
|---|---|
| Aus dem Quellcode (von der Doku empfohlen) | git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git && cd LlamaFactory && pip install -e . |
| Optionale Metrics-Extras | pip install -r requirements/metrics.txt |
| Über PyPI | pip install llamafactory — siehe llamafactory auf PyPI |
| Docker — NVIDIA CUDA | cd docker/docker-cuda/ && docker compose up -d |
| Docker — AMD ROCm | cd docker/docker-rocm/ && docker compose up -d (laut Abschnitt „Multi-device Backends" der Doku) |
| Docker — Ascend NPU | cd docker/docker-npu/ && docker compose up -d — siehe NPU-Guide |
| Weboberfläche starten (LLaMA Board) | llamafactory-cli webui |
| Installation prüfen | llamafactory-cli version |
Optionale Extras werden über `pip install -e ".[extra_name]" installiert, wobei extra_name laut Installationsdoku unter anderem torch, metrics, deepspeed, bitsandbytes, hqq, eetq, gptq, awq, aqlm, vllm, galore, badam, qwen, modelscope und swanlab` umfasst. Das Ascend-NPU-Docker-Image gibt es in mehreren Ubuntu- und openEuler-Varianten — aktuelle Liste im NPU-Guide. Windows-QLoRA und FlashAttention-2 benötigen zusätzliche plattformspezifische Wheels — siehe direkt die Installationsanleitung, statt Wheel-URLs zu raten, da diese versionsgebunden sind.
LLaMA-Factory-Preise: Wirklich kostenlos?
Ja — das Framework LLaMA-Factory hat keine bezahlte Stufe. Das GitHub-Repository weist laut GitHub-API eine Apache-2.0-Lizenz aus, die für die Codebasis von LLaMA-Factory selbst gilt, und weder das README noch die Dokumentationsseite verlinken eine Preisseite oder beschreiben eine bezahlte Funktion.
- Kein Abonnement, keine Lizenzgebühr und keine bezahlte Stufe für das Framework in GitHub-Repository, README oder Dokumentationsseite dokumentiert
- Kein Konto oder Anmeldung nötig, um
llamafactory-clizu installieren, LLaMA Board lokal auszuführen oder eines der Docker-Images zu nutzen - Apache-2.0 deckt LLaMA-Factorys eigenen Code ab; es erstreckt sich nicht auf die Basismodelle, die Sie damit fine-tunen — Modelle wie Metas Llama-Familie oder Qwen haben eigene, separate Lizenzen, die weiterhin für die trainierten und weiterverteilten Gewichte gelten
- Cloud-GPU-Kosten (falls Sie statt eigener Hardware Rechenleistung mieten) sind ein separater, realer Kostenfaktor, den diese Review nicht schätzt — sie hängen vollständig vom gewählten Anbieter und Instanztyp ab
LLaMA-Factory vs. Unsloth
LLaMA-Factory und Unsloth sind beide kostenlose Open-Source-Tools für lokales Fine-Tuning, decken aber unterschiedliches Terrain ab. LLaMA-Factory setzt auf Breite bei Modellen und Trainingsmethoden für Text- und Vision-Language-Modelle, mit dokumentiertem Pfad zu Multi-GPU- und Multi-Node-Training; Unsloth deckt mehr Modalitäten ab (LLMs, Diffusionsmodelle, TTS und Embedding-Modelle) plus eine native Desktop-App, dafür ohne dokumentiertes Multi-Node-Training im eigenen README.
Aspekt | LLaMA-Factory | |
|---|---|---|
| Lizenz | Apache-2.0 | Kern: Apache-2.0 / Studio-UI: AGPL-3.0 |
| Oberfläche | Weboberfläche (LLaMA Board) + CLI, keine Desktop-App | Desktop-App, Weboberfläche oder Python-Bibliothek |
| Modelltypen | LLM + Vision-Language (VLM) | LLM, Diffusion, TTS, Embedding |
| Hardware | NVIDIA CUDA, AMD ROCm, Ascend NPU | NVIDIA, AMD, Intel, CPU via Vulkan |
| Multi-Node-Training | In der Advanced-Doku dokumentiert (Multi-GPU/Multi-Node + DeepSpeed) | Nicht im eigenen README dokumentiert |
| Am besten für | Breiteste Modell-/Methodenabdeckung für Text + VLM, inklusive Skalierung über eine Maschine hinaus | Breiteste Modalitätsabdeckung (auch Nicht-Text) in einer Desktop-App |
Die beiden Tools sind keine reinen Rivalen — LLaMA-Factorys eigene Dokumentation listet ein optionales Unsloth-Kernel-Beschleunigungs-Backend, sodass ein LLaMA-Factory-Trainingslauf unter der Haube Unsloths optimierte Kernel nutzen kann, während er weiterhin über LLaMA-Factorys Weboberfläche und Konfigurationsformat läuft. Muss Ihr Job über eine Maschine hinaus skalieren, ist LLaMA-Factorys dokumentierter Multi-Node-Pfad die direktere Wahl; brauchen Sie Fine-Tuning für Diffusion, TTS oder Embedding-Modelle statt nur LLMs und VLMs, sehen Sie stattdessen die Unsloth-Review.
Für wen ist LLaMA-Factory geeignet?
Ob LLaMA-Factory passt, hängt davon ab, ob Sie die breiteste dokumentierte Modell- und Methodenabdeckung für Text- und Vision-Language-Fine-Tuning wollen, inklusive Pfad zu Multi-GPU- oder Multi-Node-Skalierung.
Nutzen Sie LLaMA-Factory, wenn
- Sie eines von über 100 offenen LLM- oder Vision-Language-Modell-Familien fine-tunen möchten, ohne ein Trainingsskript zu schreiben, über eine Weboberfläche
- Sie einen dokumentierten Pfad zu Multi-GPU- oder Multi-Node-Training brauchen, wenn Datensatz oder Modellgröße wachsen
- Sie quantisierungsbewusstes Fine-Tuning (AQLM, AWQ, GPTQ, HQQ, EETQ) und Exportoptionen in einem Tool wollen
- Sie speziell AMD-ROCm- oder Ascend-NPU-Hardware betreiben, nicht nur NVIDIA CUDA
- Sie ein Open-Source-Tool (Apache-2.0) mit wissenschaftlichem Paper (ACL 2024) hinter der Kernmethode bevorzugen
Warten Sie oder schauen Sie anderswo, wenn
- Sie eine native, klickbare Desktop-App statt einer browserbasierten Weboberfläche möchten — siehe die Unsloth-Review für deren Desktop-App-Option
- Sie Diffusionsmodelle (Bild/Video), Text-zu-Sprache- oder Embedding-Modelle statt LLMs/VLMs fine-tunen müssen — LLaMA-Factorys README listet diese Modelltypen nicht
- Sie ausschließlich Apple Silicon nutzen und das schlankstmögliche native Tool statt eines CUDA-/ROCm-/NPU-zentrierten Frameworks wollen — MLX-LM ist hier ein direkter Vergleich wert
- Sie keine GPU besitzen und den reibungslosesten Einstieg ins Fine-Tuning überhaupt suchen — eine kostenlose, Colab-Notebook-basierte Option (siehe die Unsloth-Review) benötigt weniger lokale Einrichtung
LLaMA-Factory vs. andere Fine-Tuning-Tools
LLaMA-Factory ist eines von mehreren Tools zum Fine-Tuning von Modellen auf eigener Hardware. Hier, wie es sich neben anderen Optionen in diesem Bereich einordnet — siehe das Local LLM Software Directory für den vollständigen Katalog, und den dedizierten LLaMA-Factory-vs.-Unsloth-Vergleich oben für das direkteste Duell.
- Unsloth — ein kostenloses Open-Source-Tool (Kern Apache-2.0, Studio-UI AGPL-3.0), das LLM-, Diffusions-, TTS- und Embedding-Fine-Tuning über Desktop-App, Weboberfläche oder Python-Bibliothek abdeckt; siehe den dedizierten Vergleichsabschnitt oben für die Unterschiede.
- Second Me — ein Apache-2.0-Tool zum selbstgesteuerten Training eines persönlichen Modells, mit engerem Fokus (Training eines personalisierten Modells auf eigenen Daten) als LLaMA-Factorys allgemeinem Fine-Tuning-Umfang für über 100 Modelle.
- Axolotl — ein YAML-konfigurationsgesteuertes, Apache-2.0-lizenziertes Fine-Tuning-Framework mit dokumentiertem Multi-Node-Training und breiter Abdeckung von Alignment-Methoden (DPO, ORPO, KTO u. a.); es gibt noch keine dedizierte PromptQuorum-Review, aber es ist eine direkte Alternative für Leser, die konfigurationsgesteuerte Fine-Tuning-Frameworks ohne UI vergleichen.
- Ollama und LM Studio — lokale Inferenz-Tools zum *Ausführen* von Modellen statt sie zu trainieren; ein gängiges Muster ist Fine-Tuning mit LLaMA-Factory, Export des Ergebnisses und anschließendes Ausführen in Ollama oder LM Studio für den täglichen Gebrauch. Siehe die Ollama-Review und die LM-Studio-Review.
Häufige Fehler bei der Bewertung von LLaMA-Factory
Die meiste Verwirrung um LLaMA-Factory kommt vom alten Repository-Namen, dem Fehlen eines herunterladbaren Installationsprogramms oder der Annahme, die Hardware-Tabelle sei ein garantiertes Ergebnis statt eines dokumentierten Ausgangspunkts.
Fehler 1: Annahme, „LLaMA-Factory" fine-tune nur Metas Llama-Modelle
Der Name ist ein Relikt des ursprünglichen Projektumfangs. Das aktuelle README listet über 100 unterstützte Modellfamilien — darunter Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM und Phi, plus Vision-Language-Modelle — nicht nur Llama.
Fehler 2: Suche nach einem herunterladbaren Installationsprogramm oder App-Icon
LLaMA-Factory hat kein paketiertes Desktop-Installationsprogramm. Es wird als Python-Paket über pip/git und einen pip install -e .-Schritt installiert, oder als Docker-Image; die Weboberfläche (LLaMA Board) läuft dann im Browser, sobald das Paket installiert ist und llamafactory-cli webui ausgeführt wurde.
Fehler 3: Die VRAM-Hardware-Tabelle als Garantie für jeden Datensatz behandeln
Die dokumentierten VRAM-Werte (zum Beispiel ~16 GB für LoRA-Fine-Tuning eines 7B-Modells) stammen aus der eigenen Dokumentation des Projekts, nicht aus unabhängigen PromptQuorum-Benchmarks. Der tatsächliche Verbrauch hängt von Sequenzlänge, Batch-Größe und der gewählten Quantisierungsmethode ab.
Fehler 4: Die zwei Schreibweisen des Repository-Namens für zwei verschiedene Projekte halten
Die GitHub-Organisation hat das Repository von LLaMA-Factory zu LlamaFactory umbenannt — nur die Schreibweise ändert sich. Die alte URL funktioniert weiterhin über einen GitHub-Redirect, und beide Namen verweisen auf dieselbe Codebasis, dieselben Sterne und dieselbe Commit-Historie.
Häufig gestellte Fragen
Was ist LLaMA-Factory?
LLaMA-Factory (github.com/hiyouga/LlamaFactory, Doku unter llamafactory.readthedocs.io) ist ein kostenloses Open-Source-Framework (Apache-2.0) zum Fine-Tuning von über 100 offenen LLMs und Vision-Language-Modellen, per Gradio-Weboberfläche (LLaMA Board) oder Kommandozeilen-Tool (llamafactory-cli).
Ist LLaMA-Factory kostenlos?
Ja, laut GitHubs Repository-Metadaten und der eigenen Dokumentation des Projekts — das Framework trägt eine Apache-2.0-Lizenz und keine dokumentierte bezahlte Stufe. Die Apache-2.0-Lizenz deckt LLaMA-Factorys Code ab, nicht die Lizenz des jeweils damit fine-getunten Basismodells.
Warum steht in der URL „LLaMA-Factory", das Repository heißt aber „LlamaFactory"?
Die GitHub-Organisation hat das Repository von LLaMA-Factory zu LlamaFactory umbenannt — nur die Schreibweise ändert sich. Die alte URL (github.com/hiyouga/LLaMA-Factory) leitet per 301-Redirect auf die aktuelle weiter, mit denselben Sternen, Forks und der Commit-Historie.
Braucht LLaMA-Factory eine GPU?
Eine GPU wird dringend empfohlen, ist aber nicht zwingend erforderlich. Laut Dokumentation des Projekts ist reines CPU-Training technisch unterstützt, aber für reale Fine-Tuning-Jobs unpraktikabel; LoRA-Fine-Tuning eines 7B-Modells ist mit rund 16 GB VRAM dokumentiert, mit 2-Bit-QLoRA bis zu ~4 GB.
Wie viel VRAM braucht vollständiges Fine-Tuning?
Laut LLaMA-Factorys eigener Dokumentation benötigt vollständiges (bf16/fp16) Fine-Tuning eines 7B-Modells rund 60 GB VRAM, und vollständiges fp32-Fine-Tuning desselben Modells rund 120 GB — dies sind die dokumentierten Werte des Projekts, keine von dieser Review unabhängig gemessenen Zahlen.
Welche Modelle unterstützt LLaMA-Factory?
Laut eigenem GitHub-README über 100 offene Modellfamilien von 270M bis 671B Parametern, darunter LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi sowie Vision-Language-Modelle wie LLaVA und Qwen3-VL.
Hat LLaMA-Factory eine Desktop-App?
Nein. Es gibt eine Weboberfläche (LLaMA Board), die im Browser läuft, nachdem das Python-Paket installiert und llamafactory-cli webui ausgeführt wurde, aber kein paketiertes, installierbares Desktop-Programm. Siehe die Unsloth-Review für ein Fine-Tuning-Tool mit nativer Desktop-App.
Wie schneidet LLaMA-Factory im Vergleich zu Unsloth ab?
LLaMA-Factory deckt mehr Modellbreite für Text- und Vision-Language-Modelle plus dokumentiertes Multi-Node-Training ab; Unsloth deckt mehr Modalitäten ab (einschließlich Diffusion, TTS und Embedding-Modelle) plus eine native Desktop-App. LLaMA-Factory kann optional Unsloths Kernel als Beschleunigungs-Backend nutzen. Siehe den dedizierten Vergleichsabschnitt oben.
Läuft LLaMA-Factory auf AMD- oder Ascend-NPU-Hardware?
Ja — neben dem Standard-NVIDIA-CUDA-Image existieren laut der Multi-device-Backends-Dokumentation des Projekts separate Docker-Images für AMD ROCm und Ascend NPU.
Wer pflegt LLaMA-Factory?
hiyouga, laut GitHub-API als einzelner Nutzer (kein Unternehmen) gelistet. Das README des Projekts gibt an, es werde unter anderem von Amazon, NVIDIA und Aliyun genutzt — eine Angabe aus dem eigenen README des Projekts, die diese Review nicht unabhängig überprüft hat.