Conclusiones clave
- Gratuito y de código abierto; el repositorio de GitHub indica licencia Apache-2.0, y esta review no encontró una página de precios independiente para el framework en sí
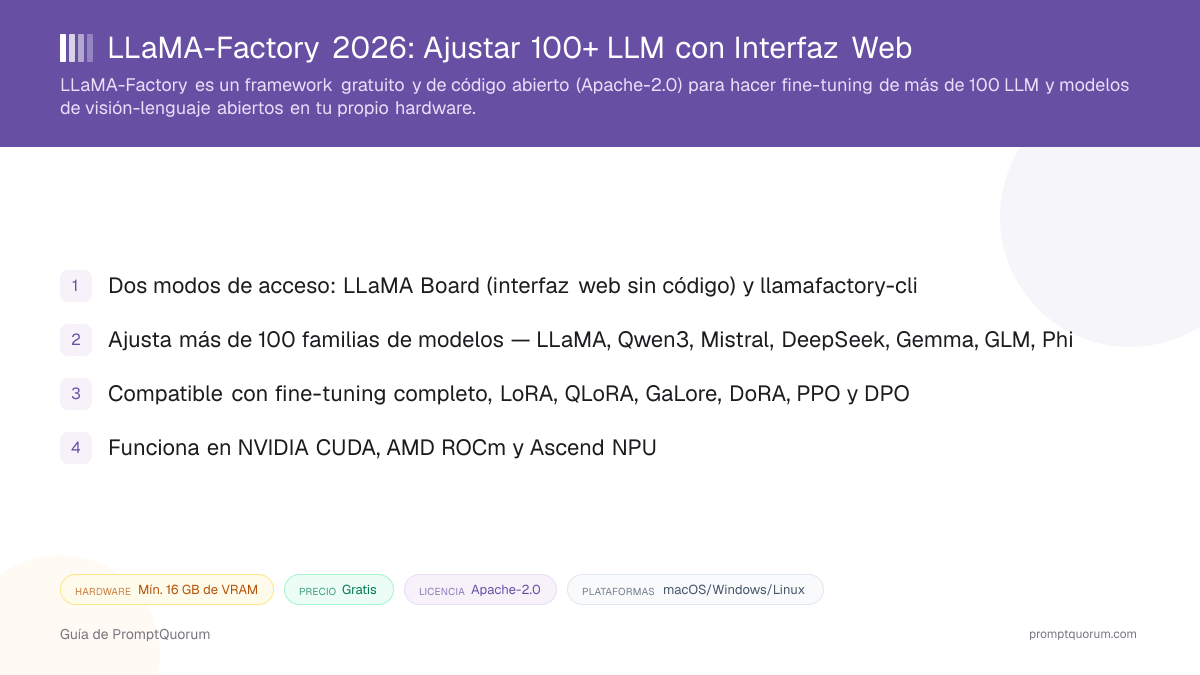
- Dos formas de usarlo: LLaMA Board (una interfaz web Gradio para entrenamiento, evaluación e inferencia sin código) y
llamafactory-cli(una herramienta de línea de comandos para flujos de entrenamiento/chat/exportación mediante scripts) - Permite hacer fine-tuning de LLM y modelos de visión-lenguaje en más de 100 familias de modelos — LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi, LLaVA, Qwen3-VL y más, entre 270M y 671B de parámetros según el README
- Compatible con fine-tuning completo, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA y OFT/OFTv2, en pre-entrenamiento, fine-tuning supervisado, reward modeling, PPO y DPO
- Soporte de hardware multi-backend: NVIDIA CUDA, AMD ROCm y Ascend NPU, cada uno con su propia imagen de Docker, además de instalación nativa en Linux, Windows y macOS
- Despliega modelos entrenados mediante una API local de estilo OpenAI o un worker de vLLM, y puede acelerar opcionalmente el entrenamiento usando los kernels de Unsloth como una de varias opciones de backend
- Mantenido por hiyouga (un mantenedor individual en GitHub, según la API de GitHub); repositorio creado el 28 de mayo de 2023, con commits publicados a pocos días de la fecha de investigación de esta review, 9.153 forks y 1.152 issues abiertas
📍 En una frase
LLaMA-Factory es un framework gratuito y de código abierto (Apache-2.0) que permite hacer fine-tuning de más de 100 LLM y modelos de visión-lenguaje abiertos mediante una interfaz web sin código (LLaMA Board) o una línea de comandos de Python, en hardware NVIDIA, AMD o Ascend NPU.
💬 En términos simples
Si quieres enseñarle tus propios datos a un modelo de IA abierto ya existente — sin escribir un script de entrenamiento desde cero — LLaMA-Factory te da una página web con menús desplegables y controles deslizantes para elegir el modelo, el dataset y el método de entrenamiento, y luego ejecuta el trabajo en tu propia GPU. También existe una versión de línea de comandos para automatizar los mismos pasos.
📌Nota: Esta review es el complemento en profundidad de la ficha de LLaMA-Factory en el Directorio de Software LLM Local — consulta esa página para ver de un vistazo cómo se compara LLaMA-Factory con docenas de otras herramientas de IA local.
¿Qué es LLaMA-Factory?
LLaMA-Factory es un framework para hacer fine-tuning de LLM y modelos de visión-lenguaje de pesos abiertos en hardware que tú controlas, mediante una interfaz web en lugar de un script de entrenamiento escrito a mano. Su propia descripción en GitHub dice "Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)", en referencia a un artículo académico aceptado en la conferencia ACL 2024 (Association for Computational Linguistics). La página del proyecto en llamafactory.readthedocs.io lo describe como "una plataforma fácil de usar y eficiente para entrenar y ajustar grandes modelos de lenguaje", diseñada para que los usuarios puedan "hacer fine-tuning de cientos de modelos preentrenados localmente sin escribir código".
- Función principal: elegir un modelo base, un dataset y un método de fine-tuning (LoRA, QLoRA o completo) mediante la interfaz web de LLaMA Board o un archivo de configuración YAML, y luego ejecutar o exportar el resultado
- No solo texto: además de los LLM de texto, el README menciona soporte para fine-tuning de modelos de visión-lenguaje (VLM), incluyendo modelos como LLaVA y Qwen3-VL
- Dos productos, un solo motor: LLaMA Board (la interfaz web Gradio, iniciada con
llamafactory-cli webui) yllamafactory-cli(la herramienta de línea de comandos sobre la que se construyen tanto la interfaz como los flujos con scripts) - Nombre del repositorio: el repositorio de GitHub fue renombrado de
LLaMA-FactoryaLlamaFactory— solo un cambio de mayúsculas/minúsculas; la URL antigua (github.com/hiyouga/LLaMA-Factory) redirige al mismo repositorio, con las mismas estrellas e historial de commits - Mantenedor: hiyouga, listado como usuario individual (no una organización) según la API de GitHub, aunque el README afirma que el proyecto es "usado por Amazon, NVIDIA, Aliyun" entre otros — una afirmación del propio README del proyecto, no verificada de forma independiente por esta review
Historial de versiones de LLaMA-Factory
La cronología verificable de LLaMA-Factory proviene de dos fuentes oficiales: los propios metadatos del repositorio de GitHub y las versiones etiquetadas del proyecto en GitHub.
- El repositorio de GitHub fue creado el 28 de mayo de 2023, según los metadatos del repositorio de GitHub — originalmente bajo el nombre
LLaMA-Factory - El artículo académico asociado al proyecto, "LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models", fue aceptado en ACL 2024, según la propia línea de descripción del repositorio
- El repositorio fue renombrado más tarde a
LlamaFactory(solo cambio de mayúsculas/minúsculas); GitHub redirige automáticamente la URL antiguaLLaMA-Factorya la actual, conservando las mismas estrellas, forks e historial de commits - La versión etiquetada más reciente, v0.9.5 ("Qwen3.5/3.6, Gemma 4, Transformers v5"), se publicó el 30 de mayo de 2026, según la API de releases de GitHub
- Los commits en la rama
maincontinuaron después de esa etiqueta — los metadatos de GitHub muestran un push a pocos días de la fecha de investigación de esta review, lo que indica desarrollo diario activo más allá de la última versión formal
¿Qué puedes hacer con LLaMA-Factory?
El conjunto de funciones de LLaMA-Factory abarca métodos de entrenamiento, amplitud de modelos, backends de hardware y despliegue. Esto es lo que hace realmente cada parte, según el propio README de GitHub y la documentación del proyecto.
- Métodos de entrenamiento — fine-tuning completo, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA y OFT/OFTv2, en pre-entrenamiento, fine-tuning supervisado (SFT), reward modeling, PPO y DPO
- Amplitud de modelos — más de 100 familias de modelos, incluyendo LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM y Phi, de 270M a 671B de parámetros, más modelos de visión-lenguaje como LLaVA y Qwen3-VL, según el README
- Interfaz web sin código — LLaMA Board, una interfaz Gradio, cubre entrenamiento, evaluación e inferencia sin escribir un script de entrenamiento
- Herramienta de línea de comandos —
llamafactory-cliexpone los subcomandostrain,chat,export,webuiyversionpara automatizar mediante scripts los mismos flujos que LLaMA Board cubre de forma interactiva - Soporte de cuantización — son compatibles los formatos AQLM, AWQ, GPTQ, LLM.int8, HQQ y EETQ, junto con aceleración vía FlashAttention-2 y una integración opcional con los kernels de Unsloth
- Despliegue — los modelos entrenados pueden servirse mediante una API local de estilo OpenAI o un worker de vLLM para mayor rendimiento de inferencia
- Entrenamiento distribuido — la sección Advanced de la documentación cubre entrenamiento multi-GPU y multi-nodo, junto con integración con DeepSpeed para tareas distribuidas eficientes en memoria
- Seguimiento de experimentos — se integra con Wandb y TensorBoard para monitorizar los entrenamientos, según la documentación
Ejemplos de uso: dos formas de hacer fine-tuning con LLaMA-Factory
Estos son flujos de trabajo concretos construidos a partir de los comandos documentados de LLaMA-Factory anteriores — no casos de uso hipotéticos.
Instalar LLaMA-Factory: Pip, Git y Docker
LLaMA-Factory no es una aplicación descargable para el usuario final — se instala como un paquete de Python, según su propio README de GitHub y su documentación de instalación. Los enlaces siguientes son los comandos que el propio proyecto documenta; verifícalos siempre directamente en la documentación, ya que los extras y las rutas de Docker pueden cambiar entre versiones.
Método de instalación | Comando o enlace |
|---|---|
| Desde el código fuente (recomendado por la doc) | git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git && cd LlamaFactory && pip install -e . |
| Extras opcionales de métricas | pip install -r requirements/metrics.txt |
| Desde PyPI | pip install llamafactory — ver llamafactory en PyPI |
| Docker — NVIDIA CUDA | cd docker/docker-cuda/ && docker compose up -d |
| Docker — AMD ROCm | cd docker/docker-rocm/ && docker compose up -d (según la sección "Multi-device Backends" de la doc) |
| Docker — Ascend NPU | cd docker/docker-npu/ && docker compose up -d — ver guía NPU |
| Iniciar la interfaz web (LLaMA Board) | llamafactory-cli webui |
| Verificar la instalación | llamafactory-cli version |
Los extras opcionales se instalan con `pip install -e ".[extra_name]", donde extra_name incluye, según la doc de instalación, torch, metrics, deepspeed, bitsandbytes, hqq, eetq, gptq, awq, aqlm, vllm, galore, badam, qwen, modelscope y swanlab`. La imagen Docker de Ascend NPU existe en varias variantes Ubuntu y openEuler — lista actual en la guía NPU. QLoRA en Windows y FlashAttention-2 requieren wheels adicionales específicos de la plataforma — consulta directamente la guía de instalación en lugar de adivinar las URL de los wheels, ya que están vinculadas a versiones específicas.
Precio de LLaMA-Factory: ¿es realmente gratis?
Sí — el framework LLaMA-Factory no tiene ningún nivel de pago. El repositorio de GitHub indica licencia Apache-2.0 mediante la propia API de GitHub, que se aplica al código base de LLaMA-Factory en sí, y ni el README ni el sitio de documentación enlazan a una página de precios ni describen ninguna función de pago.
- Ninguna suscripción, tarifa de licencia o nivel de pago documentado para el framework en el repositorio de GitHub, su README o su sitio de documentación
- No se requiere cuenta ni registro para instalar
llamafactory-cli, ejecutar LLaMA Board localmente, o usar ninguna de las imágenes de Docker - Apache-2.0 cubre el código propio de LLaMA-Factory; no se extiende a los modelos base que ajustas con él — modelos como la familia Llama de Meta o Qwen tienen sus propias licencias separadas, que siguen aplicándose a los pesos que entrenas y redistribuyes
- Los costes de GPU en la nube (si alquilas hardware en lugar de usar el tuyo) son un coste real aparte que esta review no estima — dependen por completo del proveedor y el tipo de instancia que elijas
LLaMA-Factory vs. Unsloth
LLaMA-Factory y Unsloth son ambas herramientas gratuitas y Apache-2.0 para fine-tuning local, pero cubren terrenos distintos. LLaMA-Factory apuesta por la amplitud de modelos y métodos de entrenamiento para modelos de texto y visión-lenguaje, con una ruta documentada hacia el entrenamiento multi-GPU y multi-nodo; Unsloth cubre una gama más amplia de modalidades (LLM, difusión, TTS y modelos de embedding) además de una aplicación de escritorio nativa, a costa de no documentar el entrenamiento multi-nodo en su propio README.
Aspecto | LLaMA-Factory | Unsloth |
|---|---|---|
| Licencia | Apache-2.0 | Apache-2.0 |
| Interfaz | Interfaz web (LLaMA Board) + CLI, sin app de escritorio | App de escritorio, interfaz web o biblioteca de Python |
| Tipos de modelo | LLM + visión-lenguaje (VLM) | LLM, difusión, TTS, embedding |
| Hardware | NVIDIA CUDA, AMD ROCm, Ascend NPU | NVIDIA, AMD, Intel, CPU vía Vulkan |
| Entrenamiento multi-nodo | Documentado en la doc Advanced (multi-GPU/multi-nodo + DeepSpeed) | No documentado en su README |
| Mejor para | La cobertura más amplia de modelos/métodos para texto + VLM, incluyendo escalar más allá de una máquina | La cobertura de modalidades más amplia (incluyendo no-texto) en una app de escritorio |
Las dos herramientas no son puramente rivales — la propia documentación de LLaMA-Factory menciona un backend de aceleración opcional con los kernels de Unsloth, lo que significa que un trabajo de entrenamiento de LLaMA-Factory puede usar los kernels optimizados de Unsloth por debajo mientras sigue ejecutándose a través de la interfaz web y el formato de configuración de LLaMA-Factory. Si tu trabajo necesita escalar más allá de una sola máquina, la ruta multi-nodo documentada de LLaMA-Factory es la opción más directa; si necesitas fine-tuning de difusión, TTS o modelos de embedding en lugar de solo LLM y VLM, consulta en su lugar la review de Unsloth.
¿Quién debería usar LLaMA-Factory?
Que LLaMA-Factory encaje depende de si quieres la cobertura de modelos y métodos documentada más amplia para fine-tuning de texto y visión-lenguaje, incluyendo una ruta hacia el escalado multi-GPU o multi-nodo.
LLaMA-Factory vs. otras herramientas de fine-tuning
LLaMA-Factory es una de varias herramientas para hacer fine-tuning de modelos en tu propio hardware. Así se posiciona junto a otras opciones en ese espacio — consulta el Directorio de Software LLM Local para el catálogo completo, y la comparación dedicada LLaMA-Factory vs. Unsloth arriba para el enfrentamiento más directo.
- Unsloth — una herramienta gratuita Apache-2.0 que cubre fine-tuning de LLM, difusión, TTS y embedding mediante una app de escritorio, interfaz web o biblioteca de Python; consulta la sección de comparación dedicada arriba para ver las diferencias.
- Second Me — una herramienta Apache-2.0 de entrenamiento autodirigido de un modelo personal, con un enfoque más estrecho (entrenar un modelo personalizado con tus propios datos) que el alcance general de fine-tuning de más de 100 modelos de LLaMA-Factory.
- Axolotl — un framework de fine-tuning Apache-2.0 dirigido por configuración YAML, con entrenamiento multi-nodo documentado y una amplia cobertura de métodos de alineación (DPO, ORPO, KTO, y más); todavía no existe una review dedicada de PromptQuorum, pero es una alternativa directa para lectores que comparan frameworks de fine-tuning dirigidos por configuración, sin interfaz.
- Ollama y LM Studio — herramientas de inferencia local para *ejecutar* modelos en lugar de entrenarlos; un patrón habitual es hacer fine-tuning con LLaMA-Factory, exportar el resultado, y luego ejecutarlo en Ollama o LM Studio para el uso diario. Ver la review de Ollama y la review de LM Studio.
Errores comunes al evaluar LLaMA-Factory
La mayor parte de la confusión sobre LLaMA-Factory viene de su antiguo nombre de repositorio, la falta de un instalador descargable, o asumir que su tabla de hardware es un resultado garantizado en lugar de un punto de partida documentado.
Preguntas frecuentes
¿Qué es LLaMA-Factory?
LLaMA-Factory (github.com/hiyouga/LlamaFactory, documentación en llamafactory.readthedocs.io) es un framework gratuito y de código abierto (Apache-2.0) para hacer fine-tuning de más de 100 LLM y modelos de visión-lenguaje abiertos, mediante una interfaz web Gradio (LLaMA Board) o una herramienta de línea de comandos (llamafactory-cli).
¿Es gratis LLaMA-Factory?
Sí, según los metadatos del repositorio de GitHub y la propia documentación del proyecto — el framework tiene licencia Apache-2.0 y ningún nivel de pago documentado. La licencia Apache-2.0 cubre el código de LLaMA-Factory, no la licencia del modelo base con el que hagas fine-tuning.
¿Por qué la URL dice "LLaMA-Factory" pero el repositorio se llama "LlamaFactory"?
La organización de GitHub renombró el repositorio de LLaMA-Factory a LlamaFactory — solo un cambio de mayúsculas/minúsculas. La URL antigua (github.com/hiyouga/LLaMA-Factory) redirige (301) a la actual, conservando las mismas estrellas, forks e historial de commits.
¿LLaMA-Factory necesita una GPU?
Se recomienda fuertemente una GPU, aunque no es estrictamente obligatoria. Según la documentación del proyecto, el entrenamiento solo con CPU es técnicamente compatible pero poco práctico para trabajos reales de fine-tuning; el fine-tuning LoRA de un modelo de 7B está documentado en aproximadamente 16 GB de VRAM, hasta ~4 GB con QLoRA de 2 bits.
¿Cuánta VRAM necesita el fine-tuning completo?
Según la propia documentación de LLaMA-Factory, el fine-tuning completo (bf16/fp16) de un modelo de 7B necesita aproximadamente 60 GB de VRAM, y el fine-tuning completo en fp32 del mismo modelo necesita aproximadamente 120 GB — estas son las cifras documentadas del proyecto, no números medidos de forma independiente por esta review.
¿Qué modelos admite LLaMA-Factory?
Según su README de GitHub, más de 100 familias de modelos abiertos de entre 270M y 671B de parámetros, incluyendo LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi, y modelos de visión-lenguaje como LLaVA y Qwen3-VL.
¿LLaMA-Factory tiene una app de escritorio?
No. Tiene una interfaz web (LLaMA Board) que se ejecuta en tu navegador tras instalar el paquete de Python y ejecutar llamafactory-cli webui, pero no una aplicación de escritorio empaquetada e instalable. Consulta la review de Unsloth para una herramienta de fine-tuning que sí incluye una app de escritorio nativa.
¿Cómo se compara LLaMA-Factory con Unsloth?
LLaMA-Factory cubre más amplitud de modelos para texto y visión-lenguaje además de entrenamiento multi-nodo documentado; Unsloth cubre más modalidades (incluyendo difusión, TTS y modelos de embedding) además de una app de escritorio nativa. LLaMA-Factory puede usar opcionalmente los kernels de Unsloth como backend de aceleración. Ver la sección de comparación dedicada arriba.
¿Puede LLaMA-Factory funcionar en hardware AMD o Ascend NPU?
Sí — existen imágenes de Docker independientes para AMD ROCm y Ascend NPU, además de la imagen predeterminada de NVIDIA CUDA, según la documentación de Multi-device Backends del proyecto.
¿Quién mantiene LLaMA-Factory?
hiyouga, listado como usuario individual de GitHub (no una organización) mediante la API de GitHub. El README del proyecto afirma que es usado por organizaciones como Amazon, NVIDIA y Aliyun — una afirmación del propio README del proyecto que esta review no verificó de forma independiente.