Principais conclusões
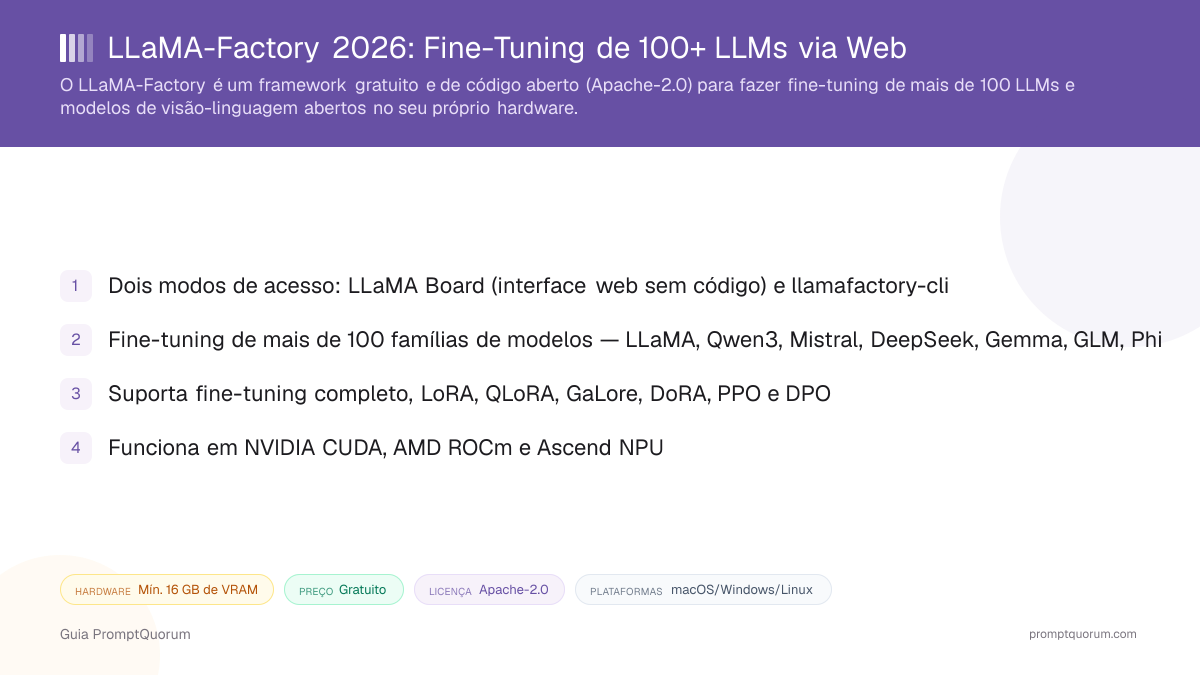
- Gratuito e de código aberto; o repositório no GitHub indica licença Apache-2.0, e esta análise não encontrou uma página de preços separada para o framework em si
- Duas formas de uso: LLaMA Board (uma interface web Gradio para treinamento, avaliação e inferência sem código) e
llamafactory-cli(uma ferramenta de linha de comando para fluxos de treino/chat/exportação via scripts) - Faz fine-tuning de LLMs e modelos de visão-linguagem em mais de 100 famílias de modelos — LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi, LLaVA, Qwen3-VL e outros, de 270M a 671B de parâmetros segundo o README
- Suporta fine-tuning completo, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA e OFT/OFTv2, em pré-treinamento, fine-tuning supervisionado, reward modeling, PPO e DPO
- Suporte de hardware multi-backend: NVIDIA CUDA, AMD ROCm e Ascend NPU, cada um com imagem Docker própria, além de instalação nativa em Linux, Windows e macOS
- Implanta modelos treinados via uma API local no estilo OpenAI ou um worker vLLM, e pode acelerar opcionalmente o treinamento usando os kernels do Unsloth como uma das várias opções de backend
- Mantido por hiyouga (um mantenedor individual no GitHub, segundo a API do GitHub); repositório criado em 28 de maio de 2023, com commits enviados a poucos dias da data de pesquisa desta análise, 9.153 forks e 1.152 issues abertas
📍 Em uma frase
O LLaMA-Factory é um framework gratuito e de código aberto (Apache-2.0) que faz fine-tuning de mais de 100 LLMs e modelos de visão-linguagem abertos via interface web sem código (LLaMA Board) ou linha de comando Python, em hardware NVIDIA, AMD ou Ascend NPU.
💬 Em termos simples
Se você quer ensinar seus próprios dados a um modelo de IA aberto já existente — sem escrever um script de treinamento do zero — o LLaMA-Factory oferece uma página web com menus suspensos e controles deslizantes para escolher o modelo, o conjunto de dados e o método de treinamento, e então executa a tarefa na sua própria GPU. Também existe uma versão de linha de comando para automatizar as mesmas etapas.
📌Nota: Esta análise é o complemento aprofundado da ficha do LLaMA-Factory no Diretório de Software de LLM Local — veja essa página para comparar rapidamente o LLaMA-Factory com dezenas de outras ferramentas de IA local.
O que é o LLaMA-Factory?
O LLaMA-Factory é um framework para fazer fine-tuning de LLMs e modelos de visão-linguagem de pesos abertos em hardware que você controla, por meio de uma interface web em vez de um script de treinamento escrito à mão. Sua própria descrição no GitHub diz "Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)", referindo-se a um artigo acadêmico aceito na conferência ACL 2024 (Association for Computational Linguistics). A página do projeto em llamafactory.readthedocs.io o descreve como "uma plataforma fácil de usar e eficiente para treinar e fazer fine-tuning de grandes modelos de linguagem", criada para que os usuários possam "fazer fine-tuning de centenas de modelos pré-treinados localmente sem escrever código".
- Função principal: escolher um modelo base, um conjunto de dados e um método de fine-tuning (LoRA, QLoRA ou completo) pela interface web do LLaMA Board ou por um arquivo de configuração YAML, e então executar ou exportar o resultado
- Não é só texto: além dos LLMs de texto, o README menciona suporte a fine-tuning de modelos de visão-linguagem (VLM), incluindo modelos como LLaVA e Qwen3-VL
- Dois produtos, um só motor: LLaMA Board (a interface web Gradio, iniciada com
llamafactory-cli webui) ellamafactory-cli(a ferramenta de linha de comando sobre a qual tanto a interface quanto os fluxos via scripts são construídos) - Nome do repositório: o repositório no GitHub foi renomeado de
LLaMA-FactoryparaLlamaFactory— apenas uma mudança de maiúsculas/minúsculas; a URL antiga (github.com/hiyouga/LLaMA-Factory) redireciona para o mesmo repositório, com as mesmas estrelas e o mesmo histórico de commits - Mantenedor: hiyouga, listado como usuário individual (não uma organização) segundo a API do GitHub, embora o README afirme que o projeto é "usado pela Amazon, NVIDIA, Aliyun" entre outras — uma afirmação do próprio README do projeto, não verificada de forma independente por esta análise
Histórico de versões do LLaMA-Factory
A cronologia verificável do LLaMA-Factory vem de duas fontes oficiais: os próprios metadados do repositório no GitHub e as versões marcadas (tags) do projeto no GitHub.
- O repositório no GitHub foi criado em 28 de maio de 2023, segundo os metadados do repositório no GitHub — originalmente sob o nome
LLaMA-Factory - O artigo acadêmico associado ao projeto, "LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models", foi aceito na ACL 2024, segundo a própria linha de descrição do repositório
- O repositório foi renomeado depois para
LlamaFactory(apenas mudança de maiúsculas/minúsculas); o GitHub redireciona automaticamente a URL antigaLLaMA-Factorypara a atual, preservando as mesmas estrelas, forks e histórico de commits - A versão marcada (tag) mais recente, v0.9.5 ("Qwen3.5/3.6, Gemma 4, Transformers v5"), foi publicada em 30 de maio de 2026, segundo a API de releases do GitHub
- Os commits na branch
maincontinuaram após essa tag — os metadados do GitHub mostram um push a poucos dias da data de pesquisa desta análise, indicando desenvolvimento diário ativo além da última versão formal
O que você pode fazer com o LLaMA-Factory?
O conjunto de recursos do LLaMA-Factory abrange métodos de treinamento, abrangência de modelos, backends de hardware e implantação. Veja o que cada parte realmente faz, segundo o próprio README no GitHub e a documentação do projeto.
- Métodos de treinamento — fine-tuning completo, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA e OFT/OFTv2, em pré-treinamento, fine-tuning supervisionado (SFT), reward modeling, PPO e DPO
- Abrangência de modelos — mais de 100 famílias de modelos, incluindo LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM e Phi, de 270M a 671B de parâmetros, além de modelos de visão-linguagem como LLaVA e Qwen3-VL, segundo o README
- Interface web sem código — o LLaMA Board, uma interface Gradio, cobre treinamento, avaliação e inferência sem escrever um script de treinamento
- Ferramenta de linha de comando —
llamafactory-cliexpõe os subcomandostrain,chat,export,webuieversionpara automatizar via scripts os mesmos fluxos que o LLaMA Board cobre de forma interativa - Suporte a quantização — os formatos AQLM, AWQ, GPTQ, LLM.int8, HQQ e EETQ são suportados, junto com aceleração via FlashAttention-2 e uma integração opcional com os kernels do Unsloth
- Implantação — modelos treinados podem ser servidos via uma API local no estilo OpenAI ou um worker vLLM para maior throughput de inferência
- Treinamento distribuído — a seção Advanced da documentação cobre treinamento multi-GPU e multi-nó, além de integração com DeepSpeed para tarefas distribuídas eficientes em memória
- Acompanhamento de experimentos — integra-se com Wandb e TensorBoard para monitorar execuções de treinamento, segundo a documentação
Exemplos de uso: duas formas de fazer fine-tuning com o LLaMA-Factory
Estes são fluxos de trabalho concretos construídos a partir dos comandos documentados do LLaMA-Factory acima — não casos de uso hipotéticos.
Instalar o LLaMA-Factory: Pip, Git e Docker
O LLaMA-Factory não é um aplicativo baixável para o usuário final — ele é instalado como um pacote Python, segundo o próprio README no GitHub e a documentação de instalação. Os links abaixo são os comandos documentados pelo próprio projeto; sempre confira diretamente na documentação, pois extras e caminhos do Docker podem mudar entre versões.
Método de instalação | Comando ou link |
|---|---|
| A partir do código-fonte (recomendado pela doc) | git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git && cd LlamaFactory && pip install -e . |
| Extras opcionais de métricas | pip install -r requirements/metrics.txt |
| Via PyPI | pip install llamafactory — veja llamafactory no PyPI |
| Docker — NVIDIA CUDA | cd docker/docker-cuda/ && docker compose up -d |
| Docker — AMD ROCm | cd docker/docker-rocm/ && docker compose up -d (segundo a seção "Multi-device Backends" da doc) |
| Docker — Ascend NPU | cd docker/docker-npu/ && docker compose up -d — ver guia NPU |
| Iniciar a interface web (LLaMA Board) | llamafactory-cli webui |
| Verificar a instalação | llamafactory-cli version |
Extras opcionais são instalados via `pip install -e ".[extra_name]", com extra_name incluindo, segundo a doc de instalação, torch, metrics, deepspeed, bitsandbytes, hqq, eetq, gptq, awq, aqlm, vllm, galore, badam, qwen, modelscope e swanlab`. A imagem Docker Ascend NPU existe em várias variantes Ubuntu e openEuler — lista atual no guia NPU. QLoRA no Windows e o FlashAttention-2 precisam de wheels extras específicos da plataforma — consulte diretamente o guia de instalação em vez de adivinhar as URLs dos wheels, já que elas são vinculadas a versões específicas.
Preço do LLaMA-Factory: é realmente gratuito?
Sim — o framework LLaMA-Factory não tem nenhum nível pago. O repositório no GitHub indica licença Apache-2.0 pela própria API do GitHub, que se aplica ao código-base do LLaMA-Factory em si, e nem o README nem o site de documentação apontam para uma página de preços ou descrevem qualquer recurso pago.
- Nenhuma assinatura, taxa de licença ou nível pago documentado para o framework no repositório do GitHub, no README ou no site de documentação
- Nenhuma conta ou cadastro é necessário para instalar o
llamafactory-cli, rodar o LLaMA Board localmente, ou usar qualquer uma das imagens Docker - A Apache-2.0 cobre o código do próprio LLaMA-Factory; ela não se estende aos modelos base que você ajusta com ele — modelos como a família Llama da Meta ou o Qwen têm suas próprias licenças separadas, que continuam se aplicando aos pesos que você treina e redistribui
- Custos de GPU em nuvem (caso você alugue hardware em vez de usar o seu) são um custo real separado que esta análise não estima — dependem totalmente do provedor e do tipo de instância escolhidos
LLaMA-Factory vs. Unsloth
O LLaMA-Factory e o Unsloth são ambos ferramentas gratuitas e Apache-2.0 para fine-tuning local, mas cobrem terrenos diferentes. O LLaMA-Factory aposta na abrangência de modelos e métodos de treinamento para modelos de texto e visão-linguagem, com um caminho documentado para treinamento multi-GPU e multi-nó; o Unsloth cobre uma gama mais ampla de modalidades (LLMs, difusão, TTS e modelos de embedding) além de um aplicativo de desktop nativo, ao custo de não documentar treinamento multi-nó no próprio README.
Aspecto | LLaMA-Factory | Unsloth |
|---|---|---|
| Licença | Apache-2.0 | Apache-2.0 |
| Interface | Interface web (LLaMA Board) + CLI, sem app de desktop | App de desktop, interface web ou biblioteca Python |
| Tipos de modelo | LLM + visão-linguagem (VLM) | LLM, difusão, TTS, embedding |
| Hardware | NVIDIA CUDA, AMD ROCm, Ascend NPU | NVIDIA, AMD, Intel, CPU via Vulkan |
| Treinamento multi-nó | Documentado na doc Advanced (multi-GPU/multi-nó + DeepSpeed) | Não documentado no próprio README |
| Melhor para | A abrangência mais ampla de modelos/métodos para texto + VLM, incluindo escalar além de uma máquina | A abrangência de modalidades mais ampla (incluindo não-texto) em um app de desktop |
As duas ferramentas não são puramente rivais — a própria documentação do LLaMA-Factory lista um backend de aceleração opcional via kernels do Unsloth, o que significa que uma tarefa de treinamento do LLaMA-Factory pode usar os kernels otimizados do Unsloth por baixo dos panos enquanto ainda roda pela interface web e pelo formato de configuração do LLaMA-Factory. Se sua tarefa precisa escalar além de uma única máquina, o caminho multi-nó documentado do LLaMA-Factory é a opção mais direta; se você precisa de fine-tuning de difusão, TTS ou modelos de embedding em vez de apenas LLMs e VLMs, veja em vez disso a análise do Unsloth.
Quem deve usar o LLaMA-Factory?
Se o LLaMA-Factory é adequado depende de você querer a abrangência de modelos e métodos documentada mais ampla para fine-tuning de texto e visão-linguagem, incluindo um caminho para escalar em multi-GPU ou multi-nó.
LLaMA-Factory vs. outras ferramentas de fine-tuning
O LLaMA-Factory é uma entre várias ferramentas para fazer fine-tuning de modelos no seu próprio hardware. Veja como ele se posiciona ao lado de outras opções nesse espaço — consulte o Diretório de Software de LLM Local para o catálogo completo, e a comparação dedicada LLaMA-Factory vs. Unsloth acima para o confronto mais direto.
- Unsloth — uma ferramenta gratuita Apache-2.0 que cobre fine-tuning de LLM, difusão, TTS e embedding via app de desktop, interface web ou biblioteca Python; veja a seção de comparação dedicada acima para as diferenças.
- Second Me — uma ferramenta Apache-2.0 de treinamento autodirigido de um modelo pessoal, com foco mais estreito (treinar um modelo personalizado com seus próprios dados) do que o escopo genérico de fine-tuning de mais de 100 modelos do LLaMA-Factory.
- Axolotl — um framework de fine-tuning Apache-2.0 orientado por configuração YAML, com treinamento multi-nó documentado e ampla cobertura de métodos de alinhamento (DPO, ORPO, KTO, e mais); ainda não existe uma análise dedicada da PromptQuorum, mas é uma alternativa direta para leitores comparando frameworks de fine-tuning orientados por configuração, sem interface.
- Ollama e LM Studio — ferramentas de inferência local para *executar* modelos em vez de treiná-los; um padrão comum é fazer fine-tuning com o LLaMA-Factory, exportar o resultado, e então executá-lo no Ollama ou no LM Studio para uso diário. Veja a análise do Ollama e a análise do LM Studio.
Erros comuns ao avaliar o LLaMA-Factory
A maior parte da confusão sobre o LLaMA-Factory vem do seu antigo nome de repositório, da falta de um instalador baixável, ou de assumir que sua tabela de hardware é um resultado garantido em vez de um ponto de partida documentado.
Perguntas frequentes
O que é o LLaMA-Factory?
O LLaMA-Factory (github.com/hiyouga/LlamaFactory, documentação em llamafactory.readthedocs.io) é um framework gratuito e de código aberto (Apache-2.0) para fazer fine-tuning de mais de 100 LLMs e modelos de visão-linguagem abertos, via interface web Gradio (LLaMA Board) ou ferramenta de linha de comando (llamafactory-cli).
O LLaMA-Factory é gratuito?
Sim, segundo os metadados do repositório no GitHub e a própria documentação do projeto — o framework tem licença Apache-2.0 e nenhum nível pago documentado. A licença Apache-2.0 cobre o código do LLaMA-Factory, não a licença do modelo base com o qual você faz fine-tuning.
Por que a URL diz "LLaMA-Factory", mas o repositório se chama "LlamaFactory"?
A organização no GitHub renomeou o repositório de LLaMA-Factory para LlamaFactory — apenas uma mudança de maiúsculas/minúsculas. A URL antiga (github.com/hiyouga/LLaMA-Factory) redireciona (301) para a atual, preservando as mesmas estrelas, forks e histórico de commits.
O LLaMA-Factory precisa de GPU?
Uma GPU é fortemente recomendada, mas não é estritamente obrigatória. Segundo a documentação do projeto, o treinamento apenas em CPU é tecnicamente suportado, mas pouco prático para tarefas reais de fine-tuning; o fine-tuning LoRA de um modelo de 7B é documentado em cerca de 16 GB de VRAM, chegando a ~4 GB com QLoRA de 2 bits.
Quanta VRAM o fine-tuning completo precisa?
Segundo a própria documentação do LLaMA-Factory, o fine-tuning completo (bf16/fp16) de um modelo de 7B precisa de cerca de 60 GB de VRAM, e o fine-tuning completo em fp32 do mesmo modelo precisa de cerca de 120 GB — esses são os números documentados pelo projeto, não valores medidos de forma independente por esta análise.
Quais modelos o LLaMA-Factory suporta?
Segundo seu README no GitHub, mais de 100 famílias de modelos abertos, de 270M a 671B de parâmetros, incluindo LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi, e modelos de visão-linguagem como LLaVA e Qwen3-VL.
O LLaMA-Factory tem um app de desktop?
Não. Ele tem uma interface web (LLaMA Board) que roda no navegador depois de instalar o pacote Python e executar llamafactory-cli webui, mas nenhum aplicativo de desktop empacotado e instalável. Veja a análise do Unsloth para uma ferramenta de fine-tuning que traz um app de desktop nativo.
Como o LLaMA-Factory se compara ao Unsloth?
O LLaMA-Factory cobre mais abrangência de modelos para texto e visão-linguagem, além de treinamento multi-nó documentado; o Unsloth cobre mais modalidades (incluindo difusão, TTS e modelos de embedding), além de um app de desktop nativo. O LLaMA-Factory pode usar opcionalmente os kernels do Unsloth como backend de aceleração. Veja a seção de comparação dedicada acima.
O LLaMA-Factory funciona em hardware AMD ou Ascend NPU?
Sim — existem imagens Docker separadas para AMD ROCm e Ascend NPU, além da imagem padrão NVIDIA CUDA, segundo a documentação de Multi-device Backends do projeto.
Quem mantém o LLaMA-Factory?
hiyouga, listado como usuário individual do GitHub (não uma organização) pela API do GitHub. O README do projeto afirma que ele é usado por organizações como Amazon, NVIDIA e Aliyun — uma afirmação do próprio README do projeto, que esta análise não verificou de forma independente.