关键要点
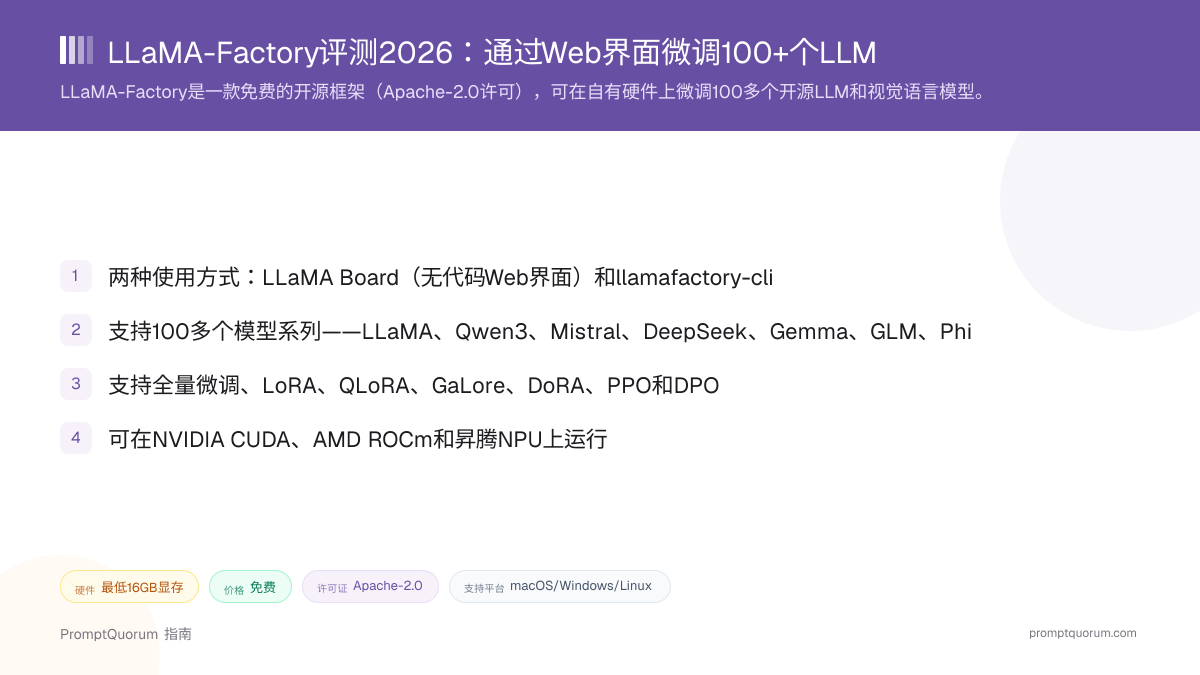
- 免费且开源;GitHub仓库显示为Apache-2.0许可,本评测未找到该框架本身有独立的定价页面
- 两种使用方式:LLaMA Board(用于无代码训练、评估和推理的Gradio Web界面)和
llamafactory-cli(用于脚本化训练/对话/导出工作流的命令行工具) - 可对LLM和视觉语言模型进行微调,覆盖100多个模型系列——LLaMA、Qwen3、Mistral、Mixtral-MoE、DeepSeek、Gemma、GLM、Phi、LLaVA、Qwen3-VL等,据README参数量从2.7亿到6710亿不等
- 支持全量微调、LoRA、QLoRA、Freeze、GaLore、BAdam、DoRA、PiSSA以及OFT/OFTv2,涵盖预训练、有监督微调、奖励建模、PPO和DPO
- 多后端硬件支持:NVIDIA CUDA、AMD ROCm和昇腾NPU,各自配有专属Docker镜像,同时支持在Linux、Windows和macOS上原生安装
- 可通过类OpenAI风格的本地API服务器或vLLM工作进程部署训练好的模型,并可选择将Unsloth的内核作为多个加速后端之一,用于加速训练
- 由hiyouga维护(根据GitHub API,为个人维护者而非组织);仓库创建于2023年5月28日,在本评测调研日期前数天内仍有提交推送,拥有9,153次复刻和1,152个未关闭issue
📍 简单一句话
LLaMA-Factory是一款免费的开源框架(Apache-2.0许可),可通过无代码Web界面(LLaMA Board)或Python命令行,在NVIDIA、AMD或昇腾NPU硬件上微调100多个开源LLM和视觉语言模型。
💬 简单来说
如果你想让一个现成的开源权重AI模型学习你自己的数据,又不想从零编写训练脚本,LLaMA-Factory会给你一个带下拉菜单和滑块的网页,用来选择模型、数据集和训练方法,然后在你自己的GPU上运行任务。它也有命令行版本,可用来自动化同样的步骤。
📌注: 本评测是本地LLM软件目录中LLaMA-Factory词条的深度延伸——该页面可让你一目了然地对比LLaMA-Factory与其他数十款本地AI工具。
LLaMA-Factory是什么?
LLaMA-Factory是一个框架,用于在你自己掌控的硬件上微调开源权重的LLM和视觉语言模型,通过Web界面而非手写训练脚本来完成。 它的GitHub项目描述写道"Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)",引用了一篇被计算语言学协会(ACL)2024年会议接收的学术论文。项目文档首页llamafactory.readthedocs.io将其描述为"一个易用且高效的大语言模型训练与微调平台",旨在让用户"无需编写代码即可在本地微调数百个预训练模型"。
- 核心功能:通过LLaMA Board的Web界面或YAML配置文件选择基础模型、数据集和微调方法(LoRA、QLoRA或全量),然后运行或导出结果
- 不仅限于文本:除文本LLM外,README还列出了对视觉语言模型(VLM)微调的支持,包括LLaVA和Qwen3-VL等模型
- 两个产品,一个引擎:LLaMA Board(通过
llamafactory-cli webui启动的Gradio Web界面)和llamafactory-cli(Web界面和脚本化工作流所共同依赖的命令行工具) - 仓库命名:GitHub仓库已从
LLaMA-Factory更名为LlamaFactory——仅大小写变化;旧网址(github.com/hiyouga/LLaMA-Factory)会重定向到同一仓库,保留相同的星标数和提交历史 - 维护者:根据GitHub API,hiyouga被列为个人用户(而非组织),不过README中提到该项目"被Amazon、NVIDIA、阿里云等使用"——这是项目自己README中的说法,本评测未独立核实
LLaMA-Factory的发布历史
LLaMA-Factory可核实的时间线来自两个官方来源:GitHub自己的仓库元数据,以及项目在GitHub上打标签的发布版本。
- 根据GitHub仓库元数据,GitHub仓库创建于2023年5月28日——最初名为
LLaMA-Factory - 据仓库自己的描述行,该项目相关的学术论文《LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models》被ACL 2024接收
- 仓库随后更名为
LlamaFactory(仅大小写变化);GitHub会自动将旧的LLaMA-Factory网址重定向到当前网址,同时保留相同的星标数、复刻数和提交历史 - 根据GitHub的发布版本API,最新打标签的版本v0.9.5("Qwen3.5/3.6、Gemma 4、Transformers v5")于2026年5月30日发布
- 该标签之后,
main分支上的提交仍在继续——GitHub元数据显示,在本评测调研日期前数天内仍有推送,表明在最新正式版本之后仍有活跃的日常开发
用LLaMA-Factory能做什么?
LLaMA-Factory的功能涵盖训练方法覆盖面、模型广度、硬件后端和部署。以下是根据项目自己的GitHub README和文档,各部分实际提供的功能。
- 训练方法 — 全量微调、LoRA、QLoRA、Freeze、GaLore、BAdam、DoRA、PiSSA以及OFT/OFTv2,涵盖预训练、有监督微调(SFT)、奖励建模、PPO和DPO训练范式
- 模型广度 — 据README介绍,支持100多个模型系列,包括LLaMA、Qwen3、Mistral、Mixtral-MoE、DeepSeek、Gemma、GLM和Phi,参数量从2.7亿到6710亿不等,另加LLaVA、Qwen3-VL等视觉语言模型
- 无代码Web界面 — LLaMA Board是一个Gradio界面,涵盖训练、评估和推理,无需编写训练脚本
- 命令行工具 —
llamafactory-cli提供train、chat、export、webui和version子命令,可将LLaMA Board以交互方式覆盖的同一工作流脚本化 - 量化支持 — 支持AQLM、AWQ、GPTQ、LLM.int8、HQQ和EETQ格式,并可通过FlashAttention-2加速,以及可选的Unsloth内核集成
- 部署 — 训练好的模型可通过类OpenAI风格的本地API或vLLM工作进程提供服务,以获得更高的推理吞吐量
- 分布式训练 — 文档中的进阶部分涵盖多GPU和多节点训练,以及用于内存高效分布式任务的DeepSpeed集成
- 实验跟踪 — 据文档介绍,可与Wandb和TensorBoard集成,用于监控训练运行
使用示例:用LLaMA-Factory微调的两种方式
以下是基于上述LLaMA-Factory官方命令构建的具体工作流程,并非假设性用例。
安装LLaMA-Factory:Pip、Git与Docker
LLaMA-Factory不是可供终端用户下载的应用程序——根据其官方GitHub README和安装文档,它以Python包的形式安装。 以下链接是项目自己文档记录的命令;由于附加组件和Docker路径可能随版本变化,请始终以官方文档为准进行核实。
安装方式 | 命令或链接 |
|---|---|
| 从源码安装(文档推荐方式) | git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git && cd LlamaFactory && pip install -e . |
| 可选的metrics附加组件 | pip install -r requirements/metrics.txt |
| 通过PyPI安装 | pip install llamafactory — 参见PyPI上的llamafactory |
| Docker — NVIDIA CUDA | cd docker/docker-cuda/ && docker compose up -d |
| Docker — AMD ROCm | cd docker/docker-rocm/ && docker compose up -d(据文档"多设备后端"部分) |
| Docker — 昇腾NPU | cd docker/docker-npu/ && docker compose up -d — 参见NPU指南 |
| 启动Web界面(LLaMA Board) | llamafactory-cli webui |
| 验证安装 | llamafactory-cli version |
可选附加组件可通过`pip install -e ".[extra_name]"安装,据安装文档,extra_name选项包括torch、metrics、deepspeed、bitsandbytes、hqq、eetq、gptq、awq、aqlm、vllm、galore、badam、qwen、modelscope和swanlab`。昇腾NPU的Docker镜像有多个Ubuntu和openEuler版本——最新列表见NPU指南。Windows上的QLoRA和FlashAttention-2需要额外的平台专属wheel包——请直接查阅安装指南,而不要猜测wheel包链接,因为这些链接与具体版本绑定。
LLaMA-Factory价格:真的免费吗?
是的——作为一个框架,LLaMA-Factory没有付费层级。 GitHub仓库通过GitHub自己的API显示为Apache-2.0许可,适用于LLaMA-Factory本身的代码库,README和文档网站均未链接定价页面或描述任何付费功能。
- GitHub仓库、README或文档网站中均未记录该框架的订阅、许可费用或付费层级
- 安装
llamafactory-cli、本地运行LLaMA Board或使用任何Docker镜像均无需账号或注册 - Apache-2.0许可涵盖LLaMA-Factory自身的代码;不适用于你用它微调的基础模型——例如Meta的Llama系列或Qwen等模型各自拥有独立的许可,你训练和再分发的权重仍需遵守这些许可
- 云端GPU费用(如果你租用硬件而非使用自有硬件)是本评测未估算的另一项真实成本——完全取决于你选择的提供商和实例类型
LLaMA-Factory 对比 Unsloth
LLaMA-Factory和Unsloth都是免费的Apache-2.0本地微调工具,但覆盖的范围不同。 LLaMA-Factory专注于文本和视觉语言模型的模型与训练方法广度,并有文档记录的多GPU与多节点训练路径;Unsloth覆盖更广的模态(LLM、扩散模型、TTS和嵌入模型)以及原生桌面应用,代价是其自身README并未记录多节点训练。
方面 | LLaMA-Factory | Unsloth |
|---|---|---|
| 许可证 | Apache-2.0 | Apache-2.0 |
| 界面 | Web界面(LLaMA Board)+ CLI,无桌面应用 | 桌面应用、Web界面或Python库 |
| 模型类型 | LLM + 视觉语言(VLM) | LLM、扩散模型、TTS、嵌入模型 |
| 硬件 | NVIDIA CUDA、AMD ROCm、昇腾NPU | NVIDIA、AMD、Intel,通过Vulkan支持CPU |
| 多节点训练 | 进阶文档中有记录(多GPU/多节点 + DeepSpeed) | 其README中未记录 |
| 最适合 | 针对文本+VLM的最广泛模型/方法覆盖,包括扩展到多台机器 | 在一个桌面应用中覆盖最广泛的模态(包括非文本) |
这两款工具并非纯粹的竞争对手——LLaMA-Factory自己的文档列出了一个可选的Unsloth内核加速后端,这意味着LLaMA-Factory的训练任务可以在底层使用Unsloth的优化内核,同时仍通过LLaMA-Factory的Web界面和配置格式运行。如果你的任务需要扩展到多台机器,LLaMA-Factory有文档记录的多节点路径是更直接的选择;如果你需要的是扩散模型、TTS或嵌入模型的微调而非仅仅是LLM和VLM,请改为参阅Unsloth评测。
谁适合使用LLaMA-Factory?
LLaMA-Factory是否适合你,取决于你是否需要文本和视觉语言微调方面最广泛的文档化模型与方法覆盖,包括扩展到多GPU或多节点的路径。
LLaMA-Factory对比其他微调工具
LLaMA-Factory是众多可在自有硬件上微调模型的工具之一。以下是它在该领域相对于其他选项的定位——完整目录请见本地LLM软件目录,最直接的正面对比请见上方专门的LLaMA-Factory对比Unsloth部分。
- Unsloth — 一款免费的Apache-2.0工具,通过桌面应用、Web界面或Python库覆盖LLM、扩散模型、TTS和嵌入模型的微调;两者的差异请见上方专门的对比部分。
- Second Me — 一款Apache-2.0的自主个人模型训练工具,专注于在自己的数据上训练一个个性化模型,其范围比LLaMA-Factory面向100多个模型的通用微调范围更窄。
- Axolotl — 一款由YAML配置驱动、Apache-2.0许可的微调框架,有文档记录的多节点训练,并覆盖广泛的对齐方法(DPO、ORPO、KTO等);目前还没有专门的PromptQuorum评测,但对于比较配置驱动、无界面微调框架的读者而言,它是一个直接的替代选择。
- Ollama和LM Studio — 用于*运行*模型而非训练模型的本地推理工具;一种常见模式是用LLaMA-Factory微调,导出结果,然后在Ollama或LM Studio中运行以供日常使用。参见Ollama评测和LM Studio评测。
评估LLaMA-Factory时的常见误区
关于LLaMA-Factory的大多数困惑,源于其旧的仓库名称、没有可下载的安装程序,或者把硬件表当作保证结果而非文档记录的起点。
常见问题
LLaMA-Factory是什么?
LLaMA-Factory(github.com/hiyouga/LlamaFactory,文档见llamafactory.readthedocs.io)是一款免费的开源框架(Apache-2.0许可),可通过Gradio Web界面(LLaMA Board)或命令行工具(llamafactory-cli)微调100多个开源LLM和视觉语言模型。
LLaMA-Factory免费吗?
是的,根据GitHub仓库元数据和项目自己的文档,该框架采用Apache-2.0许可,没有记录任何付费层级。Apache-2.0许可涵盖LLaMA-Factory的代码,并不涉及你用它微调的基础模型的许可。
为什么网址写的是"LLaMA-Factory",仓库名却是"LlamaFactory"?
GitHub组织已将仓库从LLaMA-Factory更名为LlamaFactory——仅大小写发生变化。旧网址(github.com/hiyouga/LLaMA-Factory)会以301重定向指向当前网址,并保留相同的星标数、复刻数和提交历史。
LLaMA-Factory需要GPU吗?
强烈建议使用GPU,但并非严格必需。根据项目文档,仅用CPU训练虽然技术上可行,但对实际微调任务并不实用;对7B模型进行LoRA微调据文档约需16GB显存,使用2比特QLoRA最低可降至约4GB。
全量微调需要多少显存?
根据LLaMA-Factory自己的文档,对7B模型进行全量(bf16/fp16)微调大约需要60GB显存,而同一模型的fp32全量微调大约需要120GB——这些是项目记录的数值,并非本评测独立测得的基准数据。
LLaMA-Factory支持哪些模型?
根据其GitHub README,支持100多个开源模型系列,参数量从2.7亿到6710亿不等,包括LLaMA、Qwen3、Mistral、Mixtral-MoE、DeepSeek、Gemma、GLM、Phi,以及LLaVA、Qwen3-VL等视觉语言模型。
LLaMA-Factory有桌面应用吗?
没有。它有一个Web界面(LLaMA Board),在安装Python包并运行llamafactory-cli webui后可在浏览器中运行,但没有打包好、可安装的桌面应用程序。关于确实提供原生桌面应用的微调工具,请参见Unsloth评测。
LLaMA-Factory与Unsloth相比如何?
LLaMA-Factory在文本和视觉语言模型方面覆盖更广的模型范围,并有文档记录的多节点训练;Unsloth覆盖更多模态(包括扩散模型、TTS和嵌入模型),并提供原生桌面应用。LLaMA-Factory可以选择将Unsloth的内核用作加速后端。详见上方专门的对比部分。
LLaMA-Factory能在AMD或昇腾NPU硬件上运行吗?
可以——根据项目的多设备后端文档,除默认的NVIDIA CUDA镜像外,还存在针对AMD ROCm和昇腾NPU的独立Docker镜像。
LLaMA-Factory由谁维护?
根据GitHub API,hiyouga被列为个人GitHub用户(而非组织)。项目的README中提到,该项目被包括Amazon、NVIDIA和阿里云在内的组织使用——这是项目自己README中的说法,本评测未独立核实。