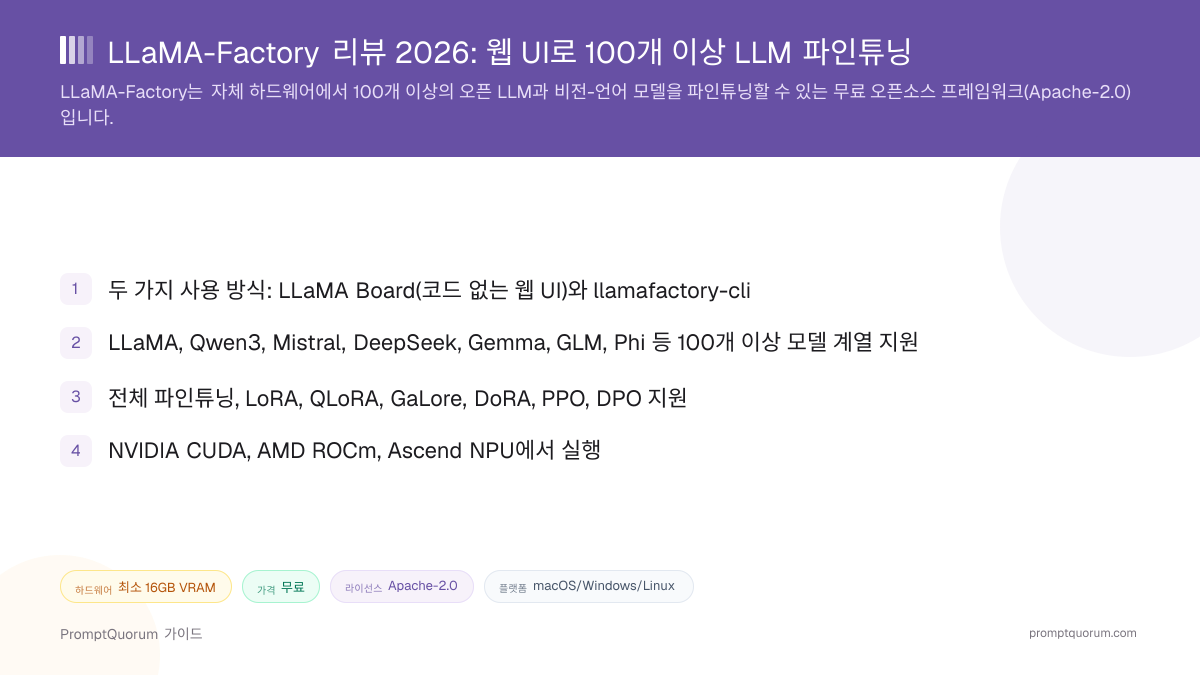
핵심 요점
- 무료이며 오픈소스; GitHub 저장소는 Apache-2.0 라이선스를 명시하고 있으며, 이 리뷰에서는 프레임워크 자체의 별도 가격 페이지를 찾을 수 없었음
- 두 가지 사용 방식: LLaMA Board(코드 없이 학습·평가·추론을 할 수 있는 Gradio 웹 UI)와
llamafactory-cli(학습·대화·내보내기 워크플로를 스크립트화할 수 있는 명령줄 도구) - LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi, LLaVA, Qwen3-VL 등 100개 이상의 모델 계열에 걸쳐 LLM과 비전-언어 모델을 파인튜닝하며, README에 따르면 파라미터 규모는 2억 7천만에서 6,710억까지 다양함
- 전체 파인튜닝, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA, OFT/OFTv2를 지원하며, 사전학습·지도 파인튜닝·보상 모델링·PPO·DPO를 아우름
- 멀티 백엔드 하드웨어 지원: NVIDIA CUDA, AMD ROCm, Ascend NPU 각각에 전용 Docker 이미지가 있으며, Linux·Windows·macOS 네이티브 설치도 가능
- OpenAI 스타일의 로컬 API 서버 또는 vLLM 워커를 통해 학습된 모델을 배포할 수 있으며, 여러 백엔드 옵션 중 하나로 Unsloth의 커널을 사용해 학습을 선택적으로 가속할 수 있음
- hiyouga(GitHub API 기준 개인 관리자)가 유지 관리; 저장소는 2023년 5월 28일에 생성되었으며, 이 리뷰의 조사일로부터 며칠 이내에 커밋이 푸시되었고, 포크 9,153개, 열린 이슈 1,152개를 기록
📍 한 문장으로
LLaMA-Factory는 코드 없는 웹 UI(LLaMA Board) 또는 Python 명령줄을 통해 NVIDIA, AMD, Ascend NPU 하드웨어에서 100개 이상의 오픈 LLM과 비전-언어 모델을 파인튜닝할 수 있는 무료 오픈소스 프레임워크(Apache-2.0)입니다.
💬 쉽게 말하면
기존의 오픈 웨이트 AI 모델에 자신의 데이터를 학습시키고 싶지만 학습 스크립트를 처음부터 작성하고 싶지 않다면, LLaMA-Factory는 모델·데이터셋·학습 방법을 드롭다운과 슬라이더로 선택할 수 있는 웹페이지를 제공하고, 해당 작업을 자체 GPU에서 실행해 줍니다. 동일한 단계를 자동화할 수 있는 명령줄 버전도 존재합니다.
📌참고: 이 리뷰는 로컬 LLM 소프트웨어 디렉터리에 실린 LLaMA-Factory 항목을 심층적으로 다루는 보완 글입니다——다른 수십 개 로컬 AI 도구와의 비교는 해당 페이지에서 한눈에 확인할 수 있습니다.
LLaMA-Factory란?
LLaMA-Factory는 직접 작성한 학습 스크립트 대신 웹 인터페이스를 통해, 본인이 관리하는 하드웨어에서 오픈 웨이트 LLM과 비전-언어 모델을 파인튜닝하기 위한 프레임워크입니다. 프로젝트 자체의 GitHub 설명에는 "Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)"라고 적혀 있으며, 이는 전산언어학회(ACL) 2024 학회에서 채택된 학술 논문을 가리킵니다. 프로젝트 랜딩 페이지인 llamafactory.readthedocs.io는 이를 "대규모 언어 모델의 학습과 파인튜닝을 위한 사용하기 쉽고 효율적인 플랫폼"이라고 설명하며, 사용자가 "코드를 작성하지 않고도 수백 개의 사전학습된 모델을 로컬에서 파인튜닝"할 수 있도록 만들어졌다고 밝히고 있습니다.
- 핵심 기능: LLaMA Board의 웹 인터페이스 또는 YAML 설정 파일을 통해 기본 모델·데이터셋·파인튜닝 방법(LoRA, QLoRA, 또는 전체)을 선택한 뒤 결과를 실행하거나 내보내기
- 텍스트 전용이 아님: 텍스트 LLM 외에도 README는 LLaVA, Qwen3-VL 같은 모델을 포함한 비전-언어 모델(VLM) 파인튜닝 지원을 명시하고 있음
- 두 개의 제품, 하나의 엔진: LLaMA Board(
llamafactory-cli webui로 실행하는 Gradio 웹 UI)와llamafactory-cli(UI와 스크립트 기반 워크플로 모두가 기반으로 삼는 명령줄 도구) - 저장소 이름: GitHub 저장소는
LLaMA-Factory에서LlamaFactory로 이름이 변경되었습니다——대소문자 표기만 변경된 것으로, 기존 URL(github.com/hiyouga/LLaMA-Factory)은 동일한 스타 수와 커밋 기록을 가진 같은 저장소로 리다이렉트됨 - 관리자: GitHub API에 따르면 hiyouga는 조직이 아닌 개인 사용자로 등록되어 있으며, README에는 이 프로젝트가 Amazon, NVIDIA, Aliyun 등에서 "사용된다"고 적혀 있지만——이는 프로젝트 자체 README의 주장으로, 이 리뷰에서 독립적으로 검증하지는 않았음
LLaMA-Factory의 릴리스 히스토리
LLaMA-Factory의 검증 가능한 연혁은 두 가지 공식 출처에서 나옵니다——GitHub 자체 저장소 메타데이터와, GitHub상의 태그가 지정된 릴리스입니다.
- GitHub 저장소는 GitHub 저장소 메타데이터에 따르면 2023년 5월 28일에 생성되었습니다——처음에는
LLaMA-Factory라는 이름이었습니다 - 프로젝트와 관련된 학술 논문 "LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models"는 저장소 자체 설명에 따르면 ACL 2024에서 채택되었습니다
- 이후 저장소 이름은
LlamaFactory로 변경되었습니다(대소문자 표기만 변경); GitHub는 기존LLaMA-FactoryURL을 자동으로 현재 URL로 리다이렉트하며 동일한 스타 수, 포크 수, 커밋 기록을 유지합니다 - 가장 최근 태그 릴리스인 v0.9.5("Qwen3.5/3.6, Gemma 4, Transformers v5")는 GitHub 릴리스 API에 따르면 2026년 5월 30일에 게시되었습니다
- 해당 태그 이후에도
main브랜치에 대한 커밋은 계속되었습니다——GitHub 메타데이터는 이 리뷰의 조사일로부터 며칠 이내의 푸시를 보여주며, 이는 마지막 정식 릴리스 이후에도 활발한 일상적 개발이 이어지고 있음을 나타냅니다
LLaMA-Factory로 무엇을 할 수 있나?
LLaMA-Factory의 기능은 학습 방법 범위, 모델 폭, 하드웨어 백엔드, 배포에 걸쳐 있습니다. 다음은 프로젝트 자체의 GitHub README와 문서에 따라 각 부분이 실제로 하는 일입니다.
- 학습 방법 — 전체 파인튜닝, LoRA, QLoRA, Freeze, GaLore, BAdam, DoRA, PiSSA, OFT/OFTv2를 지원하며, 사전학습·지도 파인튜닝(SFT)·보상 모델링·PPO·DPO를 아우름
- 모델 폭 — README에 따르면 LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi를 포함해 100개 이상의 모델 계열을 지원하며, 파라미터 규모는 2억 7천만에서 6,710억까지, 여기에 LLaVA, Qwen3-VL 같은 비전-언어 모델도 포함
- 코드 없는 웹 UI — Gradio 인터페이스인 LLaMA Board는 학습 스크립트를 작성하지 않고도 학습·평가·추론을 다룸
- 명령줄 도구 —
llamafactory-cli는train,chat,export,webui,version하위 명령을 제공하여 LLaMA Board가 대화형으로 다루는 것과 동일한 워크플로를 스크립트화할 수 있게 함 - 양자화 지원 — AQLM, AWQ, GPTQ, LLM.int8, HQQ, EETQ 형식을 지원하며, FlashAttention-2를 통한 가속과 선택적인 Unsloth 커널 통합도 가능
- 배포 — 학습된 모델은 OpenAI 스타일의 로컬 API 또는 vLLM 워커를 통해 더 높은 처리량으로 서비스할 수 있음
- 분산 학습 — 문서의 Advanced 섹션은 멀티 GPU 및 멀티 노드 학습을 다루며, 메모리 효율적인 분산 작업을 위한 DeepSpeed 통합도 포함
- 실험 추적 — 문서에 따르면 학습 실행을 모니터링하기 위해 Wandb 및 TensorBoard와 통합됨
사용 예시: LLaMA-Factory로 파인튜닝하는 두 가지 방법
이는 위에서 소개한 LLaMA-Factory의 공식 명령을 기반으로 한 구체적인 워크플로이며, 가상의 사용 사례가 아닙니다.
LLaMA-Factory 설치: Pip, Git, Docker
LLaMA-Factory는 최종 사용자가 다운로드하는 애플리케이션이 아니라, 프로젝트 자체의 GitHub README와 설치 문서에 따라 Python 패키지로 설치됩니다. 아래 링크는 프로젝트가 직접 문서화한 명령입니다; 부가 옵션과 Docker 경로는 버전마다 달라질 수 있으므로 항상 문서에서 직접 확인하시기 바랍니다.
설치 방법 | 명령어 또는 링크 |
|---|---|
| 소스에서 설치(문서 권장 방식) | git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git && cd LlamaFactory && pip install -e . |
| 선택적 metrics 부가 기능 | pip install -r requirements/metrics.txt |
| PyPI를 통해 | pip install llamafactory — PyPI의 llamafactory 참고 |
| Docker — NVIDIA CUDA | cd docker/docker-cuda/ && docker compose up -d |
| Docker — AMD ROCm | cd docker/docker-rocm/ && docker compose up -d(문서의 "Multi-device Backends" 섹션 기준) |
| Docker — Ascend NPU | cd docker/docker-npu/ && docker compose up -d — NPU 가이드 참고 |
| 웹 UI(LLaMA Board) 실행 | llamafactory-cli webui |
| 설치 확인 | llamafactory-cli version |
선택적 부가 기능은 `pip install -e ".[extra_name]"으로 설치할 수 있으며, 설치 문서에 따르면 extra_name 옵션에는 torch, metrics, deepspeed, bitsandbytes, hqq, eetq, gptq, awq, aqlm, vllm, galore, badam, qwen, modelscope, swanlab` 등이 있습니다. Ascend NPU용 Docker 이미지는 여러 Ubuntu·openEuler 버전으로 제공됩니다——최신 목록은 NPU 가이드 참고. Windows의 QLoRA와 FlashAttention-2는 플랫폼별 추가 wheel이 필요합니다——wheel URL은 버전에 고정되어 있으므로 추측하지 말고 설치 가이드를 직접 확인하시기 바랍니다.
LLaMA-Factory 가격: 정말 무료인가?
네——프레임워크로서의 LLaMA-Factory에는 유료 등급이 없습니다. GitHub 저장소는 GitHub 자체 API를 통해 Apache-2.0 라이선스를 명시하고 있으며, 이는 LLaMA-Factory 자체 코드베이스에 적용됩니다. README와 문서 사이트 모두 가격 페이지로 연결되지 않으며 유료 기능을 설명하지도 않습니다.
- GitHub 저장소, README, 문서 사이트 어디에도 프레임워크에 대한 구독, 라이선스 비용, 또는 유료 등급이 문서화되어 있지 않음
llamafactory-cli설치, LLaMA Board 로컬 실행, 또는 Docker 이미지 사용 모두 계정이나 가입이 필요하지 않음- Apache-2.0은 LLaMA-Factory 자체 코드를 포괄하지만, 이를 사용해 파인튜닝하는 기본 모델까지 확장되지는 않음——Meta의 Llama 계열이나 Qwen 같은 모델은 각자 별도의 라이선스를 가지고 있으며, 학습하고 재배포하는 가중치에는 여전히 해당 라이선스가 적용됨
- 클라우드 GPU 비용(자체 하드웨어 대신 대여하는 경우)은 이 리뷰가 추산하지 않은 별도의 실제 비용이며——선택하는 제공업체와 인스턴스 유형에 전적으로 달려 있음
LLaMA-Factory vs. Unsloth
LLaMA-Factory와 Unsloth는 모두 무료 Apache-2.0 로컬 파인튜닝 도구이지만, 다루는 영역이 다릅니다. LLaMA-Factory는 텍스트 및 비전-언어 모델에 대한 모델·학습 방법의 폭을 중시하며, 멀티 GPU 및 멀티 노드 학습으로 이어지는 경로가 문서화되어 있습니다. Unsloth는 더 넓은 범위의 모달리티(LLM, 디퓨전, TTS, 임베딩 모델)와 네이티브 데스크톱 앱을 다루지만, 대신 자체 README에는 멀티 노드 학습이 문서화되어 있지 않습니다.
항목 | LLaMA-Factory | Unsloth |
|---|---|---|
| 라이선스 | Apache-2.0 | Apache-2.0 |
| 인터페이스 | 웹 UI(LLaMA Board) + CLI, 데스크톱 앱 없음 | 데스크톱 앱, 웹 UI, 또는 Python 라이브러리 |
| 모델 유형 | LLM + 비전-언어(VLM) | LLM, 디퓨전, TTS, 임베딩 |
| 하드웨어 | NVIDIA CUDA, AMD ROCm, Ascend NPU | NVIDIA, AMD, Intel, Vulkan을 통한 CPU |
| 멀티 노드 학습 | Advanced 문서에 기재(멀티 GPU/멀티 노드 + DeepSpeed) | 자체 README에는 기재되어 있지 않음 |
| 가장 적합한 경우 | 텍스트+VLM에 대한 가장 폭넓은 모델/방법 범위, 단일 머신을 넘어선 확장 포함 | 하나의 데스크톱 앱에서 가장 폭넓은 모달리티(텍스트 이외 포함) 지원 |
두 도구는 순수한 경쟁 관계가 아닙니다——LLaMA-Factory 자체 문서에는 선택적인 Unsloth 커널 가속 백엔드가 기재되어 있어, LLaMA-Factory의 학습 작업이 LLaMA-Factory의 웹 UI와 설정 형식을 그대로 사용하면서도 내부적으로는 Unsloth의 최적화된 커널을 활용할 수 있습니다. 작업이 단일 머신을 넘어 확장되어야 한다면 LLaMA-Factory의 문서화된 멀티 노드 경로가 더 직접적인 선택이며, LLM과 VLM뿐 아니라 디퓨전·TTS·임베딩 모델의 파인튜닝이 필요하다면 대신 Unsloth 리뷰를 참고하시기 바랍니다.
LLaMA-Factory는 누구에게 적합한가?
LLaMA-Factory가 적합한지는 멀티 GPU 또는 멀티 노드 확장 경로를 포함해, 텍스트 및 비전-언어 파인튜닝에 대해 가장 폭넓게 문서화된 모델·방법 범위를 원하는지에 달려 있습니다.
LLaMA-Factory vs. 다른 파인튜닝 도구
LLaMA-Factory는 자체 하드웨어에서 모델을 파인튜닝할 수 있는 여러 도구 중 하나입니다. 이 분야의 다른 선택지와 비교하면 다음과 같이 자리매김합니다——전체 카탈로그는 로컬 LLM 소프트웨어 디렉터리를, 가장 직접적인 비교는 위의 LLaMA-Factory vs. Unsloth 전용 비교 섹션을 참고하시기 바랍니다.
- Unsloth — 데스크톱 앱, 웹 UI, 또는 Python 라이브러리를 통해 LLM·디퓨전·TTS·임베딩 파인튜닝을 다루는 무료 Apache-2.0 도구; 두 도구의 차이는 위의 전용 비교 섹션을 참고하세요.
- Second Me — 자신의 데이터로 개인화된 모델을 학습시키는 것에 초점을 맞춘, Apache-2.0 기반의 자기 주도형 개인 모델 학습 도구로, 100개 이상의 모델을 다루는 LLaMA-Factory의 범용 파인튜닝 범위보다 초점이 좁음.
- Axolotl — YAML 설정 기반의 Apache-2.0 파인튜닝 프레임워크로, 멀티 노드 학습이 문서화되어 있고 DPO, ORPO, KTO 등 폭넓은 정렬(alignment) 방법을 다룸; 아직 전용 PromptQuorum 리뷰는 없지만, 설정 기반이면서 UI가 없는 파인튜닝 프레임워크를 비교하는 독자에게는 직접적인 대안임.
- Ollama와 LM Studio — 모델을 학습시키는 대신 *실행*하기 위한 로컬 추론 도구; 흔한 패턴은 LLaMA-Factory로 파인튜닝한 뒤 결과를 내보내고, 일상 사용을 위해 Ollama나 LM Studio에서 실행하는 것입니다. Ollama 리뷰와 LM Studio 리뷰를 참고하세요.
LLaMA-Factory 평가 시 흔한 오해
LLaMA-Factory에 대한 대부분의 혼란은 이전 저장소 이름, 다운로드 가능한 설치 프로그램의 부재, 또는 하드웨어 표를 문서화된 출발점이 아니라 보장된 결과로 취급하는 데서 비롯됩니다.
자주 묻는 질문
LLaMA-Factory란 무엇인가요?
LLaMA-Factory(github.com/hiyouga/LlamaFactory, 문서: llamafactory.readthedocs.io)는 Gradio 웹 UI(LLaMA Board) 또는 명령줄 도구(llamafactory-cli)를 통해 100개 이상의 오픈 LLM과 비전-언어 모델을 파인튜닝할 수 있는 무료 오픈소스 프레임워크(Apache-2.0)입니다.
LLaMA-Factory는 무료인가요?
네, GitHub 저장소 메타데이터와 프로젝트 자체 문서에 따르면 이 프레임워크는 Apache-2.0 라이선스를 사용하며 문서화된 유료 등급이 없습니다. Apache-2.0 라이선스는 LLaMA-Factory의 코드를 포괄하는 것이며, 이를 사용해 파인튜닝하는 기본 모델의 라이선스는 아닙니다.
URL에는 "LLaMA-Factory"라고 적혀 있는데 저장소 이름은 왜 "LlamaFactory"인가요?
GitHub 조직은 저장소 이름을 LLaMA-Factory에서 LlamaFactory로 변경했습니다——대소문자 표기만 변경된 것입니다. 기존 URL(github.com/hiyouga/LLaMA-Factory)은 동일한 스타 수, 포크 수, 커밋 기록을 유지한 채 현재 URL로 301 리다이렉트됩니다.
LLaMA-Factory는 GPU가 필요한가요?
GPU를 강력히 권장하지만 엄밀히 필수는 아닙니다. 프로젝트 문서에 따르면 CPU만으로 학습하는 것은 기술적으로 지원되지만 실제 파인튜닝 작업에는 비실용적입니다. 7B 모델의 LoRA 파인튜닝은 약 16GB의 VRAM으로 문서화되어 있으며, 2비트 QLoRA 사용 시 최소 약 4GB까지 낮아질 수 있습니다.
전체 파인튜닝에는 VRAM이 얼마나 필요한가요?
LLaMA-Factory 자체 문서에 따르면 7B 모델의 전체(bf16/fp16) 파인튜닝에는 약 60GB의 VRAM이 필요하며, 같은 모델의 fp32 전체 파인튜닝에는 약 120GB가 필요합니다——이는 프로젝트가 문서화한 수치이며, 이 리뷰가 독립적으로 벤치마크한 수치가 아닙니다.
LLaMA-Factory는 어떤 모델을 지원하나요?
GitHub README에 따르면 LLaMA, Qwen3, Mistral, Mixtral-MoE, DeepSeek, Gemma, GLM, Phi를 비롯해 LLaVA, Qwen3-VL 같은 비전-언어 모델까지, 파라미터 규모 2억 7천만에서 6,710억에 이르는 100개 이상의 오픈 모델 계열을 지원합니다.
LLaMA-Factory에는 데스크톱 앱이 있나요?
없습니다. Python 패키지를 설치하고 llamafactory-cli webui를 실행하면 브라우저에서 실행되는 웹 UI(LLaMA Board)는 있지만, 패키지화되어 설치 가능한 데스크톱 애플리케이션은 없습니다. 네이티브 데스크톱 앱을 실제로 제공하는 파인튜닝 도구는 Unsloth 리뷰를 참고하세요.
LLaMA-Factory는 Unsloth와 비교하면 어떤가요?
LLaMA-Factory는 텍스트 및 비전-언어 모델에 대해 더 넓은 모델 범위와 문서화된 멀티 노드 학습을 다룹니다. Unsloth는 더 많은 모달리티(디퓨전, TTS, 임베딩 모델 포함)와 네이티브 데스크톱 앱을 다룹니다. LLaMA-Factory는 선택적으로 Unsloth의 커널을 가속 백엔드로 사용할 수 있습니다. 위의 전용 비교 섹션을 참고하세요.
LLaMA-Factory는 AMD나 Ascend NPU 하드웨어에서 실행되나요?
네——프로젝트의 Multi-device Backends 문서에 따르면 기본 NVIDIA CUDA 이미지 외에도 AMD ROCm과 Ascend NPU용 별도 Docker 이미지가 존재합니다.
LLaMA-Factory는 누가 관리하나요?
GitHub API에 따르면 hiyouga가 조직이 아닌 개인 GitHub 사용자로 등록되어 있습니다. 프로젝트의 README에는 Amazon, NVIDIA, Aliyun 등의 조직에서 사용된다고 적혀 있지만——이는 프로젝트 자체 README의 주장이며, 이 리뷰에서 독립적으로 검증하지는 않았습니다.