Points clés
- Foundry Local est l'outil d'inférence IA sur l'appareil de Microsoft ; code source sur github.com/microsoft/Foundry-Local, site du projet foundrylocal.ai
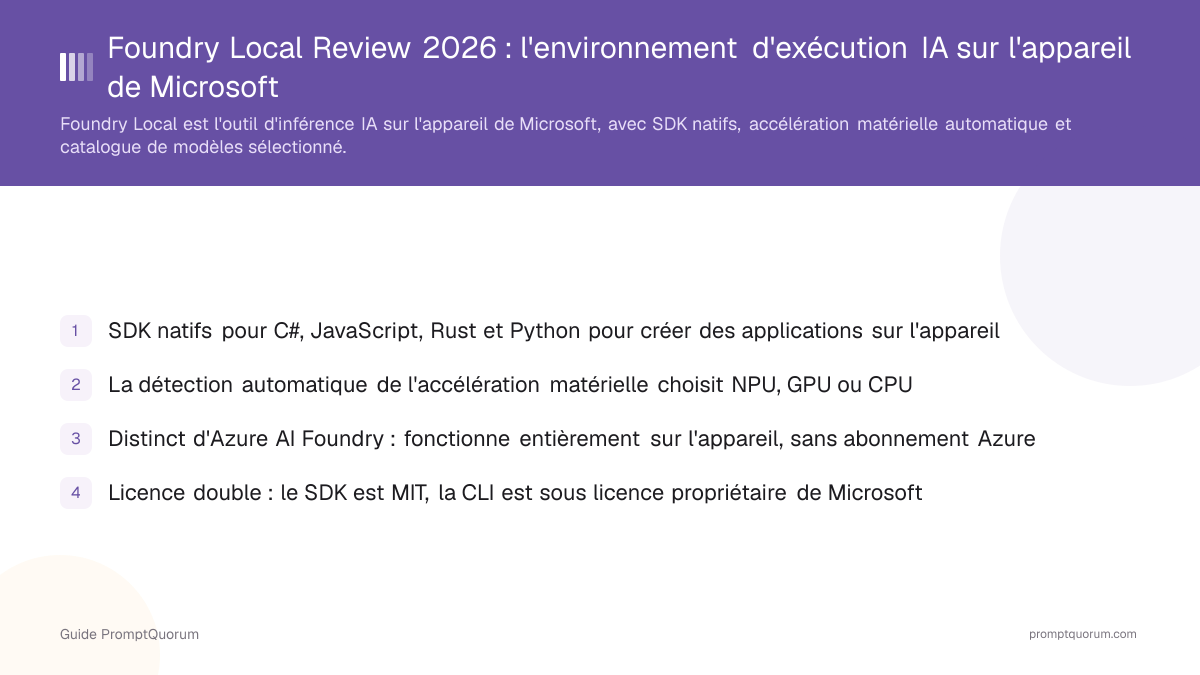
- SDK natifs pour C#, JavaScript, Rust et Python, plus une détection automatique de l'accélération matérielle qui choisit le fournisseur d'exécution optimal — NPU, GPU ou CPU — selon l'appareil
- Fonctionne sous Windows, macOS (Apple Silicon) et Linux, selon le README officiel ; les lecteurs doivent vérifier directement le dépôt officiel pour la couverture complète des plateformes sur une classe d'appareil précise
- Package léger, environ 20 Mo
- La licence est scindée : le SDK est sous licence MIT, tandis que la CLI est distribuée sous les propres conditions de licence logicielle propriétaires de Microsoft — un produit pas entièrement open source
- Distinct d'Azure AI Foundry : Foundry Local fonctionne sur l'appareil et ne nécessite pas d'abonnement Azure pour un usage local uniquement, tandis qu'Azure AI Foundry est la plateforme cloud distincte de Microsoft pour créer et déployer de l'IA à grande échelle ; les deux sont conçus pour fonctionner ensemble dans des workflows hybrides
- Le catalogue de modèles sélectionné inclut des familles telles que Qwen, DeepSeek, Mistral, Phi et GPT-OSS, ainsi que Whisper pour la transcription audio — chaque modèle téléchargé a ses propres conditions de licence distinctes
- Expose une API compatible OpenAI (y compris les formats de requête/réponse de l'OpenAI Responses API) via un serveur web local, et utilise ONNX Runtime pour l'inférence
- Le dépôt GitHub affiche 2 541 étoiles, vérifié sur github.com/microsoft/Foundry-Local le 5 septembre 2026
📍 En une phrase
Foundry Local est l'outil d'inférence IA sur l'appareil de Microsoft — SDK natifs pour C#, JavaScript, Rust et Python, détection automatique de l'accélération matérielle et catalogue de modèles sélectionné — et c'est un produit distinct d'Azure AI Foundry, la plateforme cloud.
💬 En termes simples
Foundry Local permet à un développeur de créer une application qui exécute des modèles IA directement sur la machine Windows, Mac ou Linux d'un utilisateur, en choisissant automatiquement la puce (NPU, GPU ou CPU) la plus rapide sur cet appareil précis, sans besoin de compte cloud pour un usage local. Ce n'est pas la même chose qu'Azure AI Foundry, la plateforme cloud de Microsoft — les deux peuvent fonctionner ensemble, mais l'objectif entier de Foundry Local est de fonctionner hors ligne, sur l'appareil.
📌Remarque: Cette review est le complément approfondi de l'entrée de Foundry Local dans le Local LLM Software Directory — voir cette page pour comparer Foundry Local en un coup d'œil à des dizaines d'autres outils d'IA locale.
Qu'est-ce que Foundry Local ?
Foundry Local est l'outil d'inférence IA sur l'appareil de Microsoft — une solution d'IA locale de bout en bout pour créer des applications qui s'exécutent entièrement sur l'appareil de l'utilisateur. Son dépôt GitHub le décrit comme réunissant des SDK natifs, une accélération matérielle automatique et un catalogue de modèles sélectionné dans un package léger destiné aux développeurs dont l'inférence doit s'exécuter sur l'appareil lui-même, pas sur un serveur distant.
- Fonction principale : exécuter l'inférence de modèles IA localement sur un appareil, le runtime détectant et utilisant automatiquement la meilleure accélération matérielle disponible
- SDK natifs : C#, JavaScript, Rust et Python, permettant aux développeurs d'intégrer l'inférence locale dans des applications écrites dans chacun de ces langages sans wrapper séparé
- Détection automatique de l'accélération matérielle : le runtime choisit le fournisseur d'exécution optimal — NPU, GPU ou CPU — pour l'appareil sur lequel il tourne, plutôt que d'exiger que le développeur code ce choix en dur
- Catalogue de modèles : un ensemble sélectionné de modèles, et non un système de téléversement ouvert et illimité
- Développeur : Microsoft ; l'organisation GitHub hébergeant le code est microsoft
- Dépôt canonique : github.com/microsoft/Foundry-Local ; site du projet : foundrylocal.ai
Foundry Local vs. Azure AI Foundry
C'est la distinction la plus importante à bien comprendre concernant Foundry Local : Foundry Local n'est pas le même produit qu'Azure AI Foundry, la plateforme cloud de Microsoft pour créer et déployer de l'IA à grande échelle. Selon le positionnement de Microsoft, Foundry Local est « la pile d'exécution IA locale haute performance qui apporte la puissance d'Azure AI Foundry aux appareils clients » — une formulation qui signale une relation délibérée entre les deux, pas des produits identiques.
Où l'inférence s'exécute
- Foundry Local:
- Entièrement sur l'appareil de l'utilisateur
- Azure AI Foundry:
- L'infrastructure cloud de Microsoft
Compte Azure requis
- Foundry Local:
- Non, pour un usage local uniquement
- Azure AI Foundry:
- Oui, c'est un service cloud Azure
Capacité hors ligne
- Foundry Local:
- Oui, une fois les modèles téléchargés
- Azure AI Foundry:
- Non, c'est une plateforme cloud hébergée
Objectif principal
- Foundry Local:
- Inférence sur l'appareil pour applications clientes
- Azure AI Foundry:
- Créer et déployer des solutions IA à l'échelle du cloud
Les deux produits sont conçus pour fonctionner ensemble dans des workflows hybrides — un développeur peut prototyper et tester localement avec Foundry Local, puis faire évoluer une charge de travail vers les points de terminaison cloud d'Azure AI Foundry quand elle nécessite plus de capacité qu'un seul appareil ne peut fournir — mais ils restent des produits distincts, et Foundry Local ne nécessite pas d'abonnement Azure pour un usage local uniquement. Ne supposez pas que les deux noms désignent la même chose, ni qu'installer Foundry Local crée une quelconque dépendance à un compte Azure.
Étapes clés de Foundry Local
Microsoft a lancé Foundry Local comme pendant sur l'appareil de sa plateforme plus large Azure AI Foundry, destiné aux développeurs dont l'inférence doit s'exécuter sur du matériel client plutôt que dans le cloud.
- 1Lancement initial — outil d'inférence sur l'appareil
Why it matters: Foundry Local a été lancé spécifiquement positionné comme le pendant local, sur appareil client, d'Azure AI Foundry, plutôt que comme un produit autonome sans lien avec la stratégie IA cloud de Microsoft. - 2En continu — extension des SDK natifs (C#, JavaScript, Rust, Python)
Why it matters: Plusieurs SDK natifs signifient que les développeurs travaillant dans différents écosystèmes de langages peuvent intégrer l'inférence sur l'appareil sans écrire leurs propres bindings autour d'une implémentation de référence unique. - 3En continu — ONNX Runtime comme moteur d'inférence
Why it matters: S'appuyer sur ONNX Runtime plutôt que sur un moteur d'inférence spécifique au projet permet à Foundry Local de bénéficier de l'écosystème d'accélération matérielle et de fournisseurs d'exécution propre à ONNX Runtime. - 4En continu — extension du catalogue de modèles sélectionné
Why it matters: Le catalogue s'est enrichi de familles de modèles telles que Qwen, DeepSeek, Mistral, Phi et GPT-OSS, ainsi que Whisper pour la transcription audio, élargissant ce qu'un développeur peut exécuter localement via la même surface SDK. - 5En continu — surface API compatible OpenAI
Why it matters: Exposer une API compatible OpenAI, y compris les formats de requête/réponse de l'OpenAI Responses API, réduit le coût d'intégration pour les applications déjà construites autour de cette forme d'API.
Que pouvez-vous faire avec Foundry Local ?
L'ensemble de fonctionnalités de Foundry Local se concentre sur la facilité d'intégration de l'inférence sur l'appareil pour un développeur, selon son README GitHub.
- SDK natifs — SDK C#, JavaScript, Rust et Python pour intégrer l'inférence locale directement dans des applications écrites dans chaque langage
- Détection automatique de l'accélération matérielle — le runtime choisit le fournisseur d'exécution optimal (NPU, GPU ou CPU) selon l'appareil, sans exiger que le développeur détecte et configure cela manuellement
- Catalogue de modèles sélectionné — des familles de modèles telles que Qwen, DeepSeek, Mistral, Phi et GPT-OSS, ainsi que Whisper pour la transcription audio ; le catalogue est sélectionné plutôt qu'un système de téléversement ouvert, et chaque modèle a ses propres conditions de licence distinctes
- API compatible OpenAI — un serveur web local prenant en charge les formats de requête et réponse OpenAI, y compris le format de l'OpenAI Responses API, pour les applications déjà intégrées à cette forme d'API
- Inférence via ONNX Runtime — les modèles s'exécutent via ONNX Runtime, qui gère l'exécution réelle sur le chemin d'accélération matérielle détecté
- Empreinte légère — une installation d'environ 20 Mo pour le runtime lui-même, les modèles étant téléchargés séparément depuis le catalogue
- CLI pour la gestion des modèles — des commandes comme
foundry model run <model-name>etfoundry model listpour exécuter et lister des modèles depuis un terminal - Support multiplateforme — Windows, macOS (Apple Silicon) et Linux, selon le README officiel
Exemples d'utilisation : trois façons d'utiliser Foundry Local
Ces workflows sont construits à partir de la CLI et des SDK documentés de Foundry Local ci-dessus — pas des cas d'usage hypothétiques.
Installation et prise en main
Foundry Local est un outil de développement CLI et SDK, pas une application grand public unique avec des boutons de téléchargement par OS, donc l'installation passe par GitHub Releases et les gestionnaires de paquets de langage plutôt que par un installateur signé depuis une page marketing.
- 1Téléchargez l'installateur CLI pour votre plateforme depuis GitHub Releases — les tags de version suivent un motif tel que
cli-preview-0.10.0; consultez directement la page Releases pour la version actuelle plutôt que de supposer un numéro précis. - 2Pour le développement Python, installez le SDK depuis PyPI :
pip install foundry-local-sdk. - 3Pour le développement JavaScript/Node, installez le SDK depuis npm :
npm install foundry-local-sdk. - 4Exécutez un modèle du catalogue pour confirmer que l'installation fonctionne :
foundry model run qwen2.5-0.5b. - 5Listez les modèles disponibles à tout moment avec
foundry model list. - 6Sur du matériel pris en charge, la détection automatique de l'accélération matérielle de Foundry Local choisit le NPU, le GPU ou le CPU pour vous ; aucune configuration manuelle du fournisseur d'exécution n'est requise pour le chemin par défaut.
Tarifs et licence de Foundry Local
Foundry Local est gratuit à installer et à utiliser, sans abonnement requis pour une inférence locale uniquement. La licence est cependant plus nuancée qu'un terme unique et global : le SDK est sous licence MIT, tandis que la CLI est distribuée sous les propres conditions de licence logicielle propriétaires de Microsoft — confirmé par le fichier LICENSE du projet. Il n'est pas exact de décrire l'ensemble du produit comme « open source » ou entièrement « sous licence MIT ».
Foundry Local vs. Ollama
Foundry Local et Ollama sont comparés parce que les deux permettent à un développeur d'exécuter des modèles localement via une CLI et une API — la vraie différence pour un lecteur qui hésite entre les deux réside dans le moteur d'inférence sous-jacent et dans l'écosystème (les SDK de Microsoft contre un runtime agnostique du matériel basé sur llama.cpp) adapté à l'application cible.
Objectif principal
- Foundry Local:
- Outil d'inférence sur l'appareil avec SDK natifs pour créer des applications
- Ollama:
- Runtime local de modèles et API à usage général
Moteur d'inférence
- Foundry Local:
- ONNX Runtime, avec sélection automatique NPU/GPU/CPU selon l'appareil
- Ollama:
- Moteur intégré basé sur llama.cpp
SDK natifs
- Foundry Local:
- C#, JavaScript, Rust, Python
- Ollama:
- Aucun SDK officiel ; bibliothèques communautaires pour plusieurs langages
Catalogue de modèles
- Foundry Local:
- Catalogue sélectionné (Qwen, DeepSeek, Mistral, Phi, GPT-OSS, Whisper)
- Ollama:
- Bibliothèque de modèles vaste et largement ouverte
Licence
- Foundry Local:
- Double : SDK sous MIT, CLI sous conditions de licence propriétaires Microsoft
- Ollama:
- MIT (open source)
Plateformes
- Foundry Local:
- Windows, macOS (Apple Silicon), Linux, selon le README officiel
- Ollama:
- Fonctionne sur toute machine Mac, Windows ou Linux
Si un développeur veut spécifiquement une sélection automatique de l'accélération matérielle entre NPU, GPU et CPU avec des SDK natifs C#, JavaScript, Rust ou Python — par exemple pour créer une application cliente Windows ou multiplateforme — la conception de Foundry Local correspond directement à cet usage. Si un développeur veut la bibliothèque de modèles la plus large et un runtime entièrement open source, le workflow d'Ollama est le choix le plus direct. Voir la review complète d'Ollama pour les détails.
À qui s'adresse Foundry Local ?
L'intérêt d'adopter Foundry Local dépend surtout du fait que vous créez une application (plutôt que de simplement vouloir une interface de chat) et si les langages SDK de Microsoft et son approche de l'accélération matérielle correspondent à votre projet.
Foundry Local vs. autres outils d'IA locale
Foundry Local se situe dans le segment des runtimes et gestionnaires, aux côtés d'autres outils qui exécutent des modèles localement via une CLI ou une API. Voir le Local LLM Software Directory pour le catalogue complet.
- Ollama — un runtime local de modèles et API à usage général basé sur llama.cpp, entièrement sous licence MIT, avec une bibliothèque de modèles plus large et plus ouverte et sans exigence de SDK spécifique à Microsoft. Le choix le plus direct si vous voulez la compatibilité matérielle et le choix de modèles les plus larges plutôt que des SDK natifs C#/JavaScript/Rust/Python. Voir la review complète d'Ollama.
- LM Studio — une application de bureau axée sur l'interface graphique pour l'inférence locale, avec un navigateur de modèles intégré et une fonction de chat avec documents, destinée aux utilisateurs finaux plutôt qu'aux développeurs intégrant un SDK. Un choix plus proche que Foundry Local si vous voulez une application graphique aboutie plutôt qu'un outil de développement CLI et SDK. Voir la review complète de LM Studio.
- Docker Model Runner — une fonctionnalité CLI et API intégrée à Docker Desktop/Engine pour les développeurs déjà dans un workflow basé sur Docker, une autre option à comparer à l'approche SDK natif de Foundry Local si votre pile est centrée sur les conteneurs. Voir la review complète de Docker Model Runner.
Erreurs courantes en évaluant Foundry Local
La plupart des confusions autour de Foundry Local viennent de le confondre avec Azure AI Foundry, ou de supposer que l'ensemble du produit est open source.
Questions fréquentes
Qu'est-ce que Foundry Local ?
Foundry Local (github.com/microsoft/Foundry-Local) est l'outil d'inférence IA sur l'appareil de Microsoft — une solution d'IA locale de bout en bout pour créer des applications qui s'exécutent entièrement sur l'appareil de l'utilisateur, avec des SDK natifs pour C#, JavaScript, Rust et Python.
Foundry Local est-il la même chose qu'Azure AI Foundry ?
Non. Foundry Local est un produit distinct, sur l'appareil, qui s'exécute entièrement sur l'appareil d'un utilisateur sans nécessiter d'abonnement Azure pour un usage local uniquement. Azure AI Foundry est la plateforme cloud de Microsoft pour créer et déployer de l'IA à grande échelle. Les deux sont conçus pour interagir dans des workflows hybrides mais ne sont pas le même produit.
Foundry Local est-il open source ?
Partiellement. Le SDK est sous licence MIT, mais la CLI est distribuée sous les propres conditions de licence logicielle propriétaires de Microsoft, selon le fichier LICENSE du projet. Il n'est pas exact de qualifier l'ensemble du produit d'open source.
Foundry Local est-il gratuit ?
Oui, Foundry Local lui-même est gratuit à installer et à utiliser pour une inférence purement locale, sans abonnement requis. Les modèles individuels téléchargés ont leurs propres conditions de licence distinctes, et tout usage d'Azure AI Foundry en parallèle dans un workflow hybride entraîne la facturation distincte d'Azure.
Comment installer Foundry Local ?
Téléchargez l'installateur CLI depuis GitHub Releases, installez le SDK Python avec pip install foundry-local-sdk, ou installez le SDK JavaScript/Node avec npm install foundry-local-sdk.
Quelles plateformes Foundry Local prend-il en charge ?
Windows, macOS (Apple Silicon) et Linux, selon le README officiel. Vérifiez directement le dépôt officiel pour la couverture complète des plateformes et appareils avant de supposer qu'une classe d'appareil précise est prise en charge.
Quels modèles sont disponibles dans le catalogue de Foundry Local ?
Le catalogue est sélectionné et inclut des familles de modèles telles que Qwen, DeepSeek, Mistral, Phi et GPT-OSS, ainsi que Whisper pour la transcription audio. Chaque modèle a ses propres conditions de licence distinctes.
Foundry Local expose-t-il une API compatible OpenAI ?
Oui. Foundry Local fournit un serveur web local prenant en charge les formats de requête et réponse OpenAI, y compris le format de l'OpenAI Responses API, afin que les applications construites autour de cette forme d'API puissent s'intégrer avec un minimum de changements.
Quel moteur d'inférence Foundry Local utilise-t-il ?
Foundry Local utilise ONNX Runtime pour l'inférence, avec une détection automatique de l'accélération matérielle qui choisit le fournisseur d'exécution optimal — NPU, GPU ou CPU — selon l'appareil.
Combien d'étoiles GitHub Foundry Local a-t-il ?
Le dépôt de Foundry Local (github.com/microsoft/Foundry-Local) affichait 2 541 étoiles au 5 septembre 2026, selon la vérification du répertoire de ce site. Consultez directement le dépôt pour un décompte actuel, car il évolue dans le temps.