重要なポイント
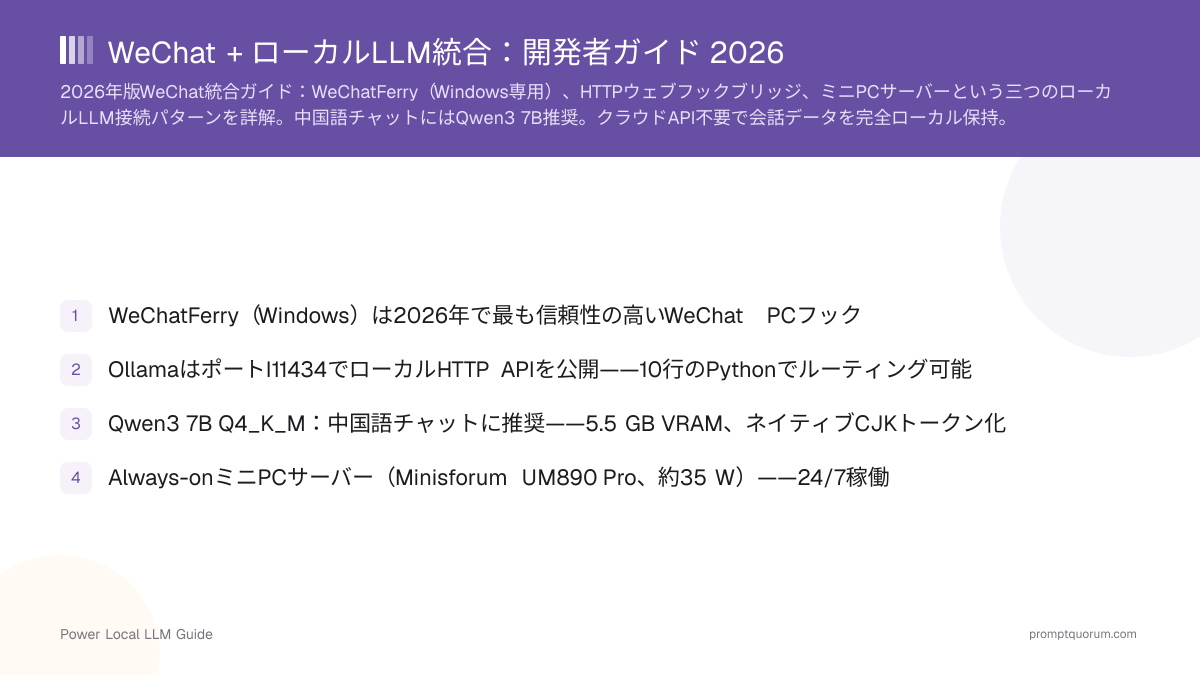
- WeChatFerry(Windows)は2026年で最も信頼性の高いWeChat PCフック
- Ollamaはポート11434でローカルHTTP APIを公開——10行のPythonでルーティング可能
- Qwen3 8B Q4_K_M:中国語チャットに推奨——6 GB VRAM、ネイティブCJKトークン化
- Always-onミニPCサーバー(Minisforum UM890 Pro、約35 W)——24/7稼働
- ローカル推論:個人情報保護法対応——データは自分のデバイスから出ない
WeChat + LLM 3つの統合パターン
パターン1 — WeChatFerry + Ollama(Windows): 最も安定。WeChatFerryがWeChat PCクライアントにフックし、Python SDKを公開。個人チャットとグループチャット両方に対応。
パターン2 — HTTPウェブフックブリッジ: クロスプラットフォーム対応だがセットアップが複雑。WeChat公式アカウントインフラを持つ企業向け。
パターン3 — Ollama + Open WebUI: 最もシンプルな一方向通知オプション。フック不要。

WeChatFerryセットアップ:ステップバイステップ
- 1WeChatFerryのリリースに対応するWeChat PC 3.9.12.xビルドをWindowsにインストール——WeChatFerryは特定の3.9.x系ビルドのみをフックし、現行のWeChat 4.x系クライアントには非対応
- 2WeChatFerryをインストール:
pip install wcferry(Python 3.10+) - 3WeChatFerryデーモン起動:
python -m wcferry.daemon - 4メッセージハンドラーを作成:
from wcferry import Wcf; wcf = Wcf(); wcf.enable_receiving_msg() - 5メッセージループ内でOllamaへPOST:
requests.post("http://localhost:11434/api/generate", json={"model":"qwen3:8b","prompt":msg.content}) - 6返信送信:`wcf.send_text(response["response"], msg.roomid or msg.sender)`
- 7個人メッセージでテストし、2〜5秒以内にWeChatに応答が表示されることを確認
import requests
from wcferry import Wcf

wcf = Wcf()
wcf.enable_receiving_msg()

while True:
    msg = wcf.get_msg()
    if msg and msg.from_self() is False:
        resp = requests.post(
            "http://localhost:11434/api/generate",
            json={"model": "qwen3:8b", "prompt": msg.content, "stream": False}
        ).json()
        wcf.send_text(resp["response"], msg.roomid or msg.sender)
Ollama HTTP API:主要エンドポイント
Ollamaはollama serve後にhttp://localhost:11434でローカルRESTサーバーを起動。ローカル接続に認証不要。
生成(シングルターン): POST /api/generate — ボディ:{model, prompt, stream: false}
チャット(マルチターン): POST /api/chat — ボディ:`{model, messages: [{role, content}]}` — 呼び出し間で会話コンテキストを維持
モデル一覧: GET /api/tags — インストール済みモデルとサイズを返します
WeChat統合では、コンテキスト維持のためローリング履歴(直近10件)付きで/api/chatの使用を推奨します。
ミニPCをWeChat LLMサーバーとして常時稼働
常時稼働の専用ミニPCがあれば、ノートPCやワークステーションを占有せずにWeChatボットを稼働し続けられます。
Minisforum UM890 Pro(推奨): AMD Ryzen 9 8945HS、32–64 GB DDR5。Qwen3 8Bで~8 tok/s。消費電力:~35 W。価格:約4.5〜6万円。
Mac Mini M6: Apple Silicon M6、16–32 GBユニファイドメモリ、本本未ベンチマーク。消費電力:アイドル時 5W未満。価格:¥149,800〜。
自動起動: systemd(Linux)またはWindowsタスクスケジューラーでollama serveとWeChatFerryブリッジを自動起動。
中国語WeChat会話向け最適モデル
Qwen3 8B Q4_K_M(第1推奨): Alibabaがネイティブ中国語処理に特化して開発。6 GB VRAM、8–15 tok/s。インストール:ollama pull qwen3:8b。
Qwen3 14B Q4_K_M: 12–16 GB RAM環境での充実した会話向け。
DeepSeek-R1-0528-Qwen3-8B: 中国語の質問応答やステップバイステップの説明に適しています。カジュアルな会話ではQwen3 8Bにやや劣ります。
避けるべき: Llama 3とMistral——中国語テキストに2〜3倍多くのトークンを使用。

グループチャット対応
WeChatグループチャットでは@メンション処理が必要。WeChatFerryはmsg.is_atを公開。
ベストプラクティス:msg.is_atがTrueの時のみ返信。送信者別(msg.sender)で会話履歴を管理。
レート制限:WeChatは毎分約30件を超えるメッセージ送信でアカウントを制限する場合があります。グループでのボット返信間に2〜3秒の遅延を入れてください。
プライバシーと個人情報保護法対応
ローカル推論により、プロンプト・応答・会話履歴はハードウェア外に出ません。
個人情報保護法(APPI): ローカルLLMはクラウドプロバイダーとの個人情報処理委託契約を不要にします。
METIガイドライン: AI製品・サービスの安全・信頼性向上に関するガイドラインにおいて、オンプレミス推論は推奨されるアプローチです。
カバーされない点: WeChat メッセージのメタデータはTencent ToSによりTencent サーバーに保存されます。
よくある質問
WeChatFerryはWeChat for Macで動きますか?
いいえ。WeChatFerryはWindowsのWeChat PCクライアントDLLをフックするため、Mac版WeChat非対応です。
Tencentにアカウントがバンされますか?
人間的な返信レート(1〜5メッセージ/分)のパーソナルボットはほとんどバンされません。大量送信は避けてください。
中国語向け最適Ollamaモデルは?
Qwen3 8B Q4_K_M。Alibabaがネイティブ中国語処理向けに開発、6 GB VRAM。
ノートパソコンで使えますか?
はい。16 GBのRAMでQwen3 8BをCPU-onlyで8〜15 tok/sで実行可能。応答遅延3〜8秒。
個人情報保護法への対応は?
ローカルLLMはクラウドプロバイダーへのデータ転送を回避。WeChatメタデータはTencentサーバーに残ります。
マルチターン会話の管理方法は?
送信者別に{role, content}辞書のリストを保持し、最新10〜15メッセージを/api/chatに渡します。
WeChatFerryはWeChat 4.xに対応していますか?
いいえ。WeChatFerryがフックするのは特定のWeChat PC 3.9.12.xビルドのみです。WeChat 4.x系はアーキテクチャが刷新され安定したフックがないため、ボット用PCでは対応する3.9.12.xビルドを維持し、自動アップデートを無効化してください。
関連記事
- WeChat + ローカルLLM:パーソナルアシスタントガイド
- ローカルLLM向けベストミニPC
- MCP対応ローカルAIエージェント 2026
- ZapierをローカルAIエージェントで置き換える — WeChatイベントでトリガーする自動化ワークフロー
- ファイアウォール内・オフラインのローカルAI 2026 — エアギャップOllama:ネットワーク分離、監査ログ、インターネット不要のセットアップ
- コーディングに最適なQwenモデル — WeChatボット統合に適したQwen3-Coderサイズの選び方