코딩에 가장 좋은 Qwen 모델은?
빠른 답변
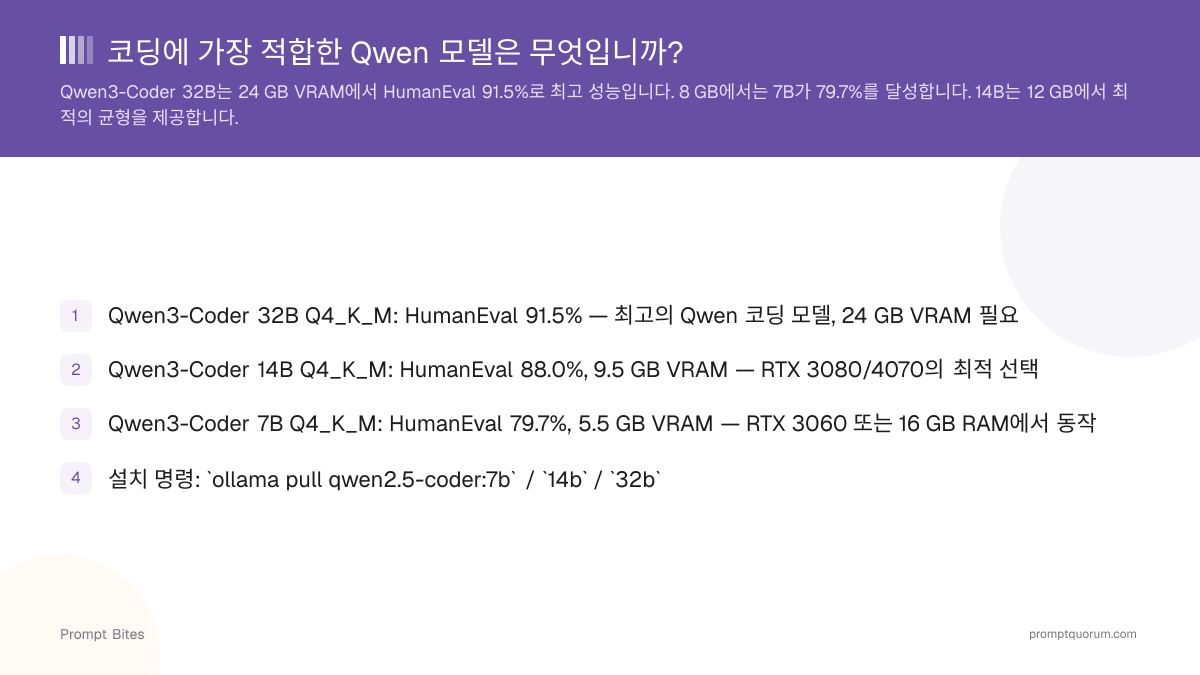
24 GB GPU나 Mac에서는 Qwen3.8-27B가 코딩에 가장 좋은 Qwen 모델입니다(다운로드 18 GB, Apache 2.0, 256K 컨텍스트). 12 GB에서 들어가는 코딩 전용 Qwen은 Qwen2.5-Coder 14B(9.0 GB)이고, 8 GB에서는 Qwen2.5-Coder 7B(4.7 GB)입니다. Qwen3-Coder 14B는 없습니다. Qwen3-Coder는 30B 전문가 혼합 모델(19 GB)부터 시작합니다. 이 순위는 Qwen이 직접 보고한 벤치마크에 근거하며 우리가 재현하지 않았습니다.
- ▸24 GB: Qwen3.8-27B(18 GB), 또는 코드 특화 Qwen3-Coder-30B-A3B(19 GB, 활성 3.3B)
- ▸12 GB: Qwen2.5-Coder 14B(9.0 GB, HumanEval 89.6)
- ▸8 GB: Qwen2.5-Coder 7B(4.7 GB, HumanEval 88.4)
- ▸Qwen3-Coder에는 7B, 14B, 32B 크기가 없습니다. 이 크기들은 Qwen2.5-Coder의 것입니다
핵심 요점
- ✓Qwen3.8-27B(18 GB, Apache 2.0, 256K 컨텍스트)는 24 GB 카드용 최신 Qwen 선택지이며, Qwen은 SWE-bench Pro 61.7(Qwen3.6 27B는 53.5)을 보고합니다
- ✓Qwen3-Coder는 30B-A3B(19 GB)부터 시작해 Coder-Next 80B-A3B(52 GB)와 480B-A35B(290 GB)로 이어지며, Qwen3-Coder 7B, 14B, 32B는 존재하지 않습니다
- ✓12 GB와 8 GB GPU에서는 Qwen2.5-Coder 14B(9.0 GB)와 7B(4.7 GB)가 여전히 코딩 전용 Qwen입니다
- ✓HumanEval은 크기에 따른 차이가 작습니다. Qwen2.5-Coder Instruct는 7B 88.4, 14B 89.6, 32B 92.7입니다
- ✓설치: `ollama pull qwen3.8:27b`, `qwen3-coder:30b`, `qwen2.5-coder:14b` 또는 `qwen2.5-coder:7b`
GPU별로 들어가는 Qwen 모델
대부분의 독자가 비교해야 할 Qwen 모델은 Qwen3.8-27B, Qwen3-Coder-30B-A3B, Qwen2.5-Coder 14B 세 가지입니다. 아래 다운로드 크기는 Ollama 라이브러리(Qwen3.8, Qwen3-Coder, Qwen2.5-Coder)에서 가져왔으며, 긴 컨텍스트에서는 KV 캐시용으로 몇 GB를 더해야 합니다.
Qwen3-Coder는 많은 가이드가 나열하는 7B/14B/32B와는 다른 부류입니다. Ollama에서는 30B 전문가 혼합 모델(총 30.5B, 활성 3.3B, 모델 카드 기준)과 Qwen3-Coder-Next(80B, 활성 3B, 52 GB), 480B 플래그십이 있고, 30B보다 작은 크기는 없습니다.
최신 범용 Qwen도 코딩을 다룹니다. Qwen3.6 35B-A3B(활성 3B)와 Qwen3.8-27B(Dense, 텍스트·이미지 입력)이며 둘 다 Apache 2.0입니다. Qwen3.8 저장소에는 14B 이하의 Qwen3.8 모델이 없으며, 가장 새로운 소형 Qwen은 Qwen3.5의 0.8B~9B입니다(Ollama).
| 모델 | Ollama 다운로드 | 컨텍스트 | 적합한 환경 |
|---|---|---|---|
| Qwen3.8-27B | 18 GB | 256K | 24 GB GPU/Mac: 최신, 범용 |
| Qwen3.6 35B-A3B | 23–24 GB | 256K | 32 GB 메모리: MoE, 활성 3B |
| Qwen3-Coder-30B-A3B | 19 GB | 256K | 24 GB GPU: 코드 특화 MoE |
| Qwen2.5-Coder 14B | 9.0 GB | 32K | 12 GB GPU(RTX 3060 / 4070) |
| Qwen2.5-Coder 7B | 4.7 GB | 32K | 8 GB GPU: 자동 완성 |
| Qwen3.5 9B | 6.6–7.6 GB | 256K | 8 GB GPU: 범용+이미지 |
VRAM 구간별 Qwen 코딩 모델 선택
24 GB(RTX 3090, RTX 4090, 24 GB 이상 Mac): Qwen3.8-27B(qwen3.8:27b, 18 GB). Unsloth는 4비트에 16~19 GB 메모리를 제시하므로 컨텍스트 공간을 남겨 두십시오. 코드 특화 모델을 원하면 Qwen3-Coder-30B-A3B(19 GB)를 고르십시오. 토큰당 활성 파라미터는 3.3B뿐이며, 모델 카드에는 코딩 에이전트용 도구 호출 형식이 문서화되어 있습니다.
12~16 GB(RTX 3060 12 GB, RTX 4070): Qwen2.5-Coder 14B(9.0 GB). 2024년 11월 모델로 Ollama에서는 32K 컨텍스트이지만, 이 크기에서는 여전히 가장 새로운 코딩 전용 Qwen입니다.
8 GB(RTX 3060 8 GB, RTX 4060): 자동 완성과 짧은 함수에는 Qwen2.5-Coder 7B(4.7 GB). 채팅과 이미지 입력도 원하면 Qwen3.5 9B(6.6~7.6 GB)가 대안입니다.
GPU 없음: 7B 이하 모델을 시스템 RAM에서 돌리면 가끔 생성하는 용도로는 충분합니다. 속도는 메모리 대역폭에 좌우되므로 실시간 자동 완성에 쓰기 전에 직접 테스트하십시오.
HumanEval에서는 파라미터를 늘려도 이득이 작습니다
Qwen2.5-Coder에서 7B에서 14B로 가면 HumanEval이 1.2점, 14B에서 32B로 가면 3.1점 오릅니다. Qwen2.5-Coder 기술 보고서(표 16, Instruct 모델)는 88.4, 89.6, 92.7을 제시합니다. HumanEval은 짧은 함수를 측정하며 상위 모델은 거의 포화 상태여서 여러 파일에 걸친 작업에 대해서는 거의 알려주지 않습니다.
최신 Qwen은 대신 에이전트형 벤치마크를 보고합니다. Qwen3.8-27B 모델 카드는 SWE-bench Pro 61.7, Terminal Bench 2.1 73.0, LiveCodeBench v6 90.3을 제시하며, Qwen3.6 27B는 각각 53.5, 63.4, 83.9입니다. 이는 벤더 보고 수치로 우리가 재현하지 않았으며 위의 HumanEval 수치와 비교할 수 없습니다.
70B 크기의 Qwen 코딩 모델은 없습니다. Qwen2.5-Coder는 32B까지이고, Qwen3-Coder는 30B 다음이 80B(52 GB), 그다음이 480B(290 GB)입니다.
관련 글
Qwen 코딩 모델 빠른 답변
Qwen3-Coder 14B가 있나요?▾
qwen3-coder:30b(19 GB)입니다.VRAM 8 GB에서 코딩에 가장 좋은 Qwen 모델은?▾
ollama pull qwen2.5-coder:7b. 채팅과 코드를 하나의 모델로 쓰고 싶다면 이미지 입력을 지원하는 범용 모델 Qwen3.5 9B(6.6~7.6 GB)도 있습니다.VRAM 12~16 GB에서 코딩에 가장 좋은 Qwen 모델은?▾
ollama pull qwen2.5-coder:14b. 이 크기에서 더 새로운 코딩 전용 Qwen은 찾지 못했습니다.VRAM 24 GB에서 코딩에 가장 좋은 Qwen 모델은?▾
qwen3.8:27b)가 가장 최신입니다. 코드 특화 대안은 Qwen3-Coder-30B-A3B(19 GB, qwen3-coder:30b)로 활성 파라미터가 3.3B뿐입니다. 자신의 저장소에서 둘 다 시험해 보십시오.Qwen2.5-Coder 32B는 여전히 쓸 만한가요?▾
어떤 양자화 수준을 써야 하나요?▾
Continue.dev나 Cline에서 사용할 수 있나요?▾
qwen3-coder:30b, qwen2.5-coder:14b 또는 선택한 크기로 지정하십시오.Qwen Coder와 DeepSeek Coder 중 무엇이 나은가요?▾
전체 설명이 필요하십니까?
전체 가이드 읽기 →