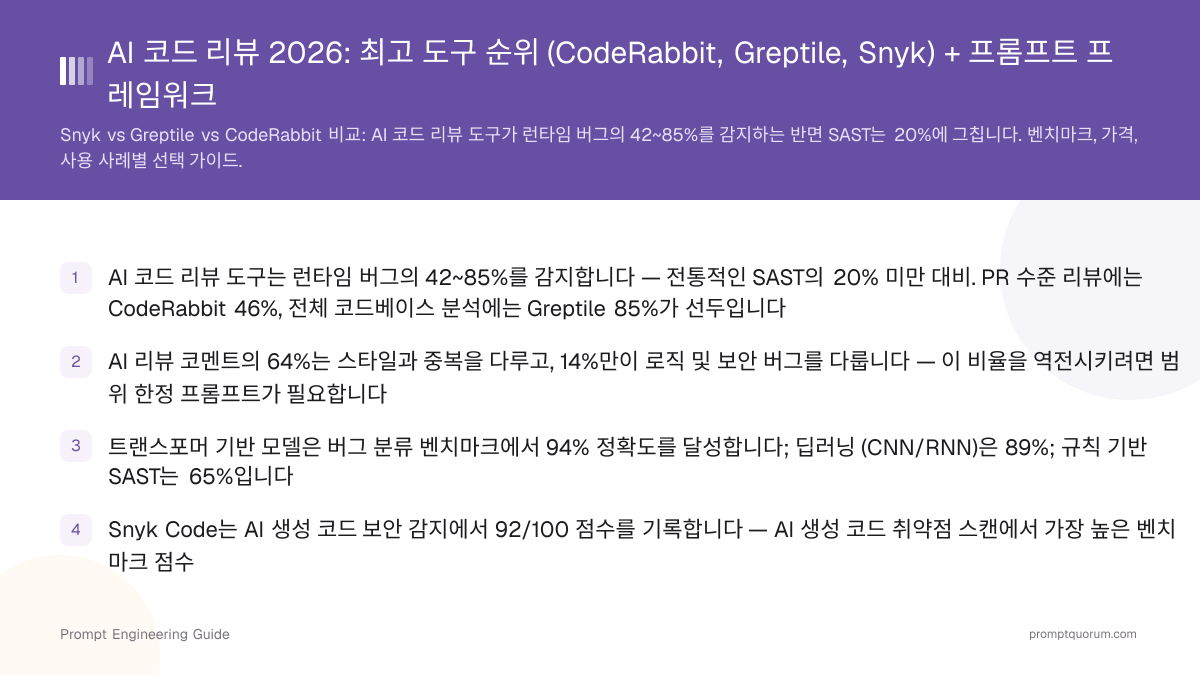
AI 코드 리뷰가 실제로 하는 일
📍 In One Sentence
AI 코드 리뷰는 pull request가 열리는 즉시 로직 버그, 보안 문제, 규약 위반을 드러내는 1차 필터이며, 사람 리뷰어는 변수명 대신 로직과 아키텍처에 시간을 쓸 수 있습니다.
💬 In Plain Terms
코드용 맞춤법 검사기라고 생각하시면 됩니다. 동료가 pull request를 열어 보기도 전에 명백한 문제를 걸러 내므로, 사람의 리뷰는 null 검사를 빠뜨렸는지가 아니라 접근 방식이 타당한지에 집중할 수 있습니다.
AI 코드 리뷰 도구는 pull request를 분석하고, 로직 버그를 탐지하고, 보안 취약점을 표시하고, 코딩 표준을 적용하며, 실행 가능한 수정 제안을 생성합니다 — 사람이 직접 하는 동료 리뷰에 필요한 수 시간이 아니라 수 초 안에 동작합니다.
전통적인 동료 코드 리뷰는 소프트웨어 개발 워크플로우에서 가장 시간이 많이 드는 작업으로, 시니어 엔지니어가 자신의 작업과 다른 사람의 코드를 평가하는 일 사이에서 컨텍스트를 전환해야 합니다. AI 코드 리뷰 도구는 GitHub, GitLab, Bitbucket, Azure DevOps 등 CI/CD 파이프라인과 pull request 워크플로우에 직접 통합되며, PR이 열리는 순간 사람 리뷰어가 시간이 날 때까지 기다리지 않고 코드를 분석하기 시작합니다.
AI 코드 리뷰 도구: 어떤 것을 사용할까
Greptile이 2025년 7월에 실행한 벤치마크에서 Greptile은 심어 둔 버그 50개 중 82%, Cursor Bugbot은 58%, GitHub Copilot은 54%, CodeRabbit은 44%를 잡아냈습니다(기본 설정, 호스팅 플랜). Greptile은 테스트 대상 도구 중 하나를 판매하며 독립적인 결과는 다를 수 있으므로, 이 수치는 결론이 아닌 방향성으로 읽으십시오.
CodeRabbit은 공개 저장소를 무료로 리뷰합니다. 비공개 저장소에는 Essentials(연간 결제 시 사용자당 월 $24, 월 결제 시 $30), Team(연간 $48, 월 $60) 또는 Advanced($72)가 필요하며 Enterprise는 견적 기반입니다. 자체 호스팅은 Enterprise 전용이고, 자체 호스팅 문서에는 500석 이상 고객에게 제공된다고 명시되어 있습니다.
Greptile Starter는 활성 개발자 1명에게 무료입니다(월 50 크레딧). Pro에는 좌석 요금이 없습니다: 크레딧은 개당 $1이며 Base 리뷰는 1 크레딧, Plus 리뷰는 3, Apex 리뷰는 10을 사용합니다. Qodo Pro Team은 최대 30명 사용자용 공유 크레딧을 포함해 $30로 표시되어 있으며 영구 무료 플랜은 없습니다. GitHub Copilot 코드 리뷰는 Copilot Pro, Pro+, Max, Business, Enterprise에서 정식 제공되며(Copilot Free 제외) AI 크레딧을 소비합니다 — GitHub은 리뷰당 평균 약 $0.25(Lite), $1.50(Balanced), $10(Max)로 문서화하고 있습니다.
도구 | 탐지율 (벤더 테스트) | Git 플랫폼 | 자체 호스팅 | 정가 |
|---|---|---|---|---|
| Greptile | 82% | GitHub, GitLab; Bitbucket DC (Enterprise) | Enterprise | 무료 Starter; Pro 크레딧당 $1 |
| Cursor Bugbot | 58% | GitHub, GitLab, Bitbucket, Azure DevOps | 자체 호스팅 Git 지원 | 사용량 기반 과금 |
| GitHub Copilot | 54% | GitHub | 아니요 | 유료 플랜에 포함; AI 크레딧 과금 |
| CodeRabbit | 44% | GitHub, GitLab | Enterprise (500석 이상) | 사용자당 월 $24 (연간 결제) |
| Qodo | 테스트 안 됨 | GitHub, GitLab, Bitbucket, Azure | Enterprise (온프레미스) | Pro Team $30부터 (공유 크레딧) |
| Snyk Code | 테스트 안 됨 | SCM 연동을 통해 | 명시되어 있지 않음 | 무료; Team $25부터 (개발자 10명) |
| 전통적인 SAST | 테스트 안 됨 | 다양함 | 다양함 | 다양함 |
🔍 출처 표기
탐지율: Greptile 실행 벤치마크, 2025년 7월, PromptQuorum이 측정한 것이 아닙니다. 정가는 각 벤더의 가격 페이지 기준이며 플랜은 자주 바뀌므로 구매 전에 확인하십시오.
CodeRabbit vs Greptile: 가격, 플랫폼, 탐지율 비교
CodeRabbit은 좌석 단위로 과금하고 공개 저장소를 무료로 리뷰하며, Greptile Pro는 선불 크레딧으로 리뷰 단위 과금을 하고 좌석 요금이 없습니다. Greptile 자체의 2025년 7월 벤치마크에서 Greptile은 심어 둔 버그의 82%, CodeRabbit은 44%를 잡아냈습니다.
이 격차는 기본 설정으로 벤더가 직접 실행한 테스트에서 나온 것이므로 사용자의 코드에서의 결과를 예측하지 않습니다. 비용 모델도 그만큼 중요합니다. 개발자당 pull request를 적게 여는 팀은 대체로 크레딧 방식이, 많이 여는 팀은 대체로 좌석 방식이 비용이 덜 듭니다.
Qodo는 둘 사이에 있습니다: Pro Team은 최대 30명 사용자용 공유 크레딧을 포함해 $30로 표시되어 있고(가격 페이지에는 좌석당인지 명시되어 있지 않습니다), 14일 체험판이 있으며 영구 무료 플랜은 없습니다. 가격 페이지에는 GitHub, GitLab, Bitbucket, Azure 로고가 표시되어 있습니다.
항목 | CodeRabbit | Greptile |
|---|---|---|
| 탐지율 (Greptile 테스트) | 44% | 82% |
| 무료 플랜 | 공개 저장소 무료 | Starter: 개발자 1명, 월 50 크레딧 |
| 유료 시작 가격 | 사용자당 월 $24 (연간 결제) | 크레딧당 $1, 좌석 요금 없음 |
| 체험판 | 14일 (유료 플랜) | 14일 (Pro) |
| Git 플랫폼 | GitHub, GitLab | GitHub, GitLab; Bitbucket DC (Enterprise) |
| 자체 호스팅 | Enterprise (500석 이상) | Enterprise |
| 자체 LLM 제공업체 | 문서화됨 (자체 호스팅) | 명시되어 있지 않음 |
Greptile 대안: CodeRabbit, Qodo, Cursor Bugbot, Copilot, Graphite
Greptile에 가장 가까운 대안은 CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot 코드 리뷰, Graphite Agent입니다. 하나의 벤치마크가 아니라 Git 플랫폼, 가격 모델(좌석, 크레딧, 사용량), 배포 방식(클라우드 또는 자체 호스팅)을 기준으로 선택하십시오.
- CodeRabbit — 좌석 단위 가격, 공개 저장소 무료, Enterprise에서 자체 호스팅. Greptile 테스트에서 44%를 잡아냈습니다.
- Qodo — 공유 크레딧 포함 Pro Team $30부터, 14일 체험판. GitHub, GitLab, Bitbucket, Azure를 지원하며 Enterprise는 단일 테넌트와 온프레미스 또는 에어갭 배포를 추가합니다. Greptile 테스트에는 포함되지 않았습니다.
- Cursor Bugbot — 사용량 기반 과금. 자체 호스팅 GitHub, GitLab, Bitbucket Data Center를 포함해 GitHub, GitLab, Bitbucket, Azure DevOps Services를 지원합니다. Greptile 테스트에서 58%를 잡아냈습니다.
- GitHub Copilot 코드 리뷰 — Copilot Pro, Pro+, Max, Business, Enterprise에 포함되며 AI 크레딧으로 과금됩니다(노력 수준에 따라 리뷰당 약 $0.25에서 $10). Greptile 테스트에서 54%를 잡아냈습니다.
- Graphite Agent — Graphite의 AI 리뷰어입니다(Diamond라는 이름은 더 이상 사용되지 않습니다). Cursor는 2025년 12월 19일에 Graphite 인수를 발표했습니다.
Snyk와 SonarQube는 취약점을 스캔하고, AI 리뷰어는 pull request를 읽습니다
Snyk Code는 일반 pull request 리뷰어가 아니라 보안 스캐너입니다. IDE, pull request, CI에서 인젝션과 하드코딩된 자격 증명 같은 취약점을 표시하는 반면, CodeRabbit, Greptile, Qodo는 diff의 로직, 엣지 케이스, 설계에 대해 코멘트합니다. 대부분의 팀은 각각 하나씩 함께 사용합니다.
Snyk Code 플랜(snyk.io/plans): Free는 월 100회의 Snyk Code 테스트를 포함하고, Team은 개발자 최대 10명 기준 월 $25부터(월 1,000회 테스트, 정액)이며, Enterprise는 활성 기여자 1인당 1일 1 크레딧의 크레딧 기반입니다. 플랜 페이지는 AI pull request 요약이나 AI 코드 리뷰를 플랜 기능으로 나열하지 않습니다.
SonarQube는 주로 규칙 기반 정적 분석입니다. 고정된 품질 및 보안 규칙을 적용하고 품질 게이트를 강제하므로 결정적이고 반복 가능합니다. LLM 리뷰어는 맥락에 맞는 코멘트를 추가하지만 출력이 실행마다 달라질 수 있으므로, 규칙 엔진을 머지 게이트로 사용하고 AI 리뷰어는 추가 독자로 사용하십시오.
자체 호스팅, 온프레미스, 자체 LLM 연결 옵션
자체 호스팅은 이를 문서화한 세 벤더 — CodeRabbit, Greptile, Qodo — 모두에서 Enterprise 플랜 기능이며, 셀프 서비스 플랜에 포함된 곳은 없습니다. 코드가 인프라 밖으로 나가서는 안 되는 경우 오픈 웨이트 모델을 로컬에서 실행하십시오 — 코드 리뷰를 위한 최고의 로컬 LLM을 참조하십시오.
- CodeRabbit — Enterprise 전용입니다. 문서에 따르면 500석 이상 고객에게 제공되며, GitHub Enterprise Server, GitLab 자체 관리형, Azure DevOps 또는 Bitbucket Data Center를 대상으로 컨테이너 이미지로 실행됩니다. 자체 호스팅 CodeRabbit도 리뷰 프롬프트와 소스 코드를 사용자가 설정한 LLM 제공업체로 보내며, 문서에는 자체 LLM 제공업체 또는 계정을 연결할 수 있다고 되어 있습니다.
- Greptile — Enterprise 전용입니다("자체 인프라에서 직접 호스팅"). GitHub Enterprise, GitLab Self-Managed, Bitbucket Data Center, Gitea, Perforce를 지원합니다.
- Qodo — Enterprise는 단일 테넌트 SaaS와 온프레미스 또는 에어갭 배포를 추가합니다.
- CodeRabbit CLI — pull request가 만들어지기 전에 커밋하지 않은 로컬 변경 사항을 리뷰합니다. CodeRabbit 백엔드에 인증하며, 확인한 문서 페이지에는 분석된 코드가 사용자 컴퓨터에 남는지 명시되어 있지 않으므로 완전한 로컬 리뷰를 대체하지 못합니다.
AI 코드 리뷰에서 신호 대 잡음이 문제인 이유는 무엇입니까?
AI 코드 리뷰 도구는 치명적인 런타임 버그를 잡아내는 것(위의 벤더 실행 테스트에서 44–82%)보다 스타일 문제에 대해 훨씬 안정적으로 코멘트합니다 — 이로 인해 코멘트 양 문제가 생기고 개발자 채택률 붕괴로 이어질 수 있습니다.
업계 가이드들은 대체로 AI 리뷰어가 로직 및 보안 발견 사항에 비해 스타일, 중복, 테스트 커버리지 코멘트를 많이 만든다고 보고합니다. 그 비율을 정량화한 공개 데이터셋은 확인하지 못했으므로 직접 측정하십시오. 중요한 숫자는 개발자가 실행에 옮기는 AI 코멘트의 비율입니다. 코멘트 대부분이 무시되는 도구는 엔지니어가 치명적인 발견 사항을 포함한 모든 피드백을 무시하도록 가르칩니다.
가능한 원인은 학습 데이터입니다. 모델은 학습하는 코드베이스에서 로직 오류보다 스타일 변형을 훨씬 많이 보기 때문에, 가장 중요한 것이 아니라 가장 자주 나타나는 것을 드러냅니다.
스타일보다 로직과 보안을 우선하도록 모델에 지시하는 프롬프트 엔지니어링이 코멘트 구성을 바꾸는 가장 큰 수단입니다. 프롬프트를 조정한 뒤 실행률을 다시 측정하십시오.
한 문장으로: AI 코드 리뷰 도구는 대부분 스타일 코멘트를 만들어 낼 수 있으며, 범위를 한정한 프롬프트와 추적하는 실행률이 로직과 보안 발견 사항을 눈에 띄게 유지합니다.
⚠️ 경고
프롬프트 범위를 한정하지 않고 AI 코드 리뷰를 배포하는 팀은 개발자 채택률 붕괴 위험이 있습니다. 대부분의 코멘트가 잡음이면 엔지니어들은 중요한 보안 발견 사항을 포함한 모든 코멘트를 무시하기 시작합니다. 팀에 배포하기 전에 항상 명시적인 리뷰 우선순위를 구성하십시오.
AI 코드 리뷰를 위한 프롬프트 작성법
언어, 프레임워크, 리뷰 우선순위, 출력 형식을 지정한 범위 한정형의 맥락이 풍부한 프롬프트는 오탐을 줄이고 신호 품질을 높입니다. "이 코드를 리뷰해 주세요" 같은 모호한 프롬프트는 일반적이고 잡음이 많은 출력을 만듭니다.
프롬프트 엔지니어링은 모델 출력을 제약하고 이끌도록 AI 지시를 구조화하는 방법입니다. 코드 리뷰에서 가장 영향력이 큰 변수는 명시적인 범위입니다. 모델에게 어떤 종류의 문제를 우선할지 정확히 알려 주면 스타일 코멘트는 줄고 로직 및 보안 발견 사항은 늘어납니다.

코드 리뷰 프롬프트 프레임워크란 무엇입니까?
모든 AI 코드 리뷰 요청에 이 구조를 사용하십시오.
쉽게 말해: 이 프레임워크는 역할, 범위, 컨텍스트, 출력 형식, 잡음 지시로 이루어진 5단계 템플릿으로, AI가 무엇에 집중해야 하는지 명시적으로 제한하여 모호한 코드 리뷰 요청을 더 집중된 결과를 내는 구조화된 프롬프트로 바꿉니다.
- 역할 — "당신은 언어/프레임워크 보안에 전문성을 갖춘 시니어 소프트웨어 엔지니어입니다."
- 범위 — "다음 항목만 리뷰하십시오: (1) 로직 버그, (2) 누락된 엣지 케이스, (3) 보안 취약점, (4) 성능 저하. 스타일, 이름, 형식에 대해서는 코멘트하지 마십시오."
- 컨텍스트 — "언어: TypeScript. 프레임워크: Next.js 14. 이 엔드포인트는 인증된 사용자 데이터를 처리합니다 — 모든 입력을 신뢰할 수 없는 것으로 취급하십시오."
- 출력 형식 — "각 문제마다 심각도(Critical / High / Medium)를 명시하고, 해당 줄을 인용하고, 위험을 설명하고, 수정된 코드 스니펫을 제공하십시오."
- 잡음 지시 — "어떤 범주에서 아무것도 발견하지 못했다면 '발견 없음'이라고 명시하고, 채우기용 코멘트를 추가하지 마십시오."
🔍 전문가 팁
AI 코드 리뷰 프롬프트에 추가할 수 있는 가장 영향력 있는 한 줄은 "스타일, 이름, 형식에 대해서는 코멘트하지 마십시오."입니다. 이 제약 하나가 코멘트 잡음을 줄이고 모델이 로직 버그와 보안 문제에 집중하도록 합니다 — 프로덕션 인시던트를 실제로 막는 발견 사항들입니다.
나쁜 코드 리뷰 프롬프트와 좋은 코드 리뷰 프롬프트의 차이는 무엇입니까?
나쁜 프롬프트
이 코드를 리뷰해 주세요.
좋은 코드 리뷰 프롬프트는 어떤 모습입니까?
좋은 프롬프트
당신은 보안을 전문으로 하는 시니어 TypeScript 엔지니어입니다. 다음 Next.js API 라우트를 리뷰하십시오: (1) 인증 우회 위험, (2) SQL 인젝션 또는 NoSQL 인젝션 경로, (3) 누락된 입력 검증, (4) 처리되지 않은 promise 거부. 스타일이나 변수 이름에 대해서는 코멘트하지 마십시오. 발견한 각 문제마다 심각도(Critical / High / Medium)를 명시하고, 해당 줄을 인용하고, 왜 악용 가능한지 설명하고, 수정된 버전을 제공하십시오. 어떤 범주에 문제가 없으면 '발견 없음'이라고 쓰십시오.
구조화된 프롬프트는 바로 분류할 수 있는 보안 보고서를 만듭니다. 예를 들어 범위가 열려 있는 프롬프트는 변수 이름에 대한 코멘트 십여 개와, 엔지니어가 읽지 않는 묻혀 버린 보안 발견 사항 하나를 만듭니다.
Chain-of-Thought는 복잡한 로직 리뷰를 어떻게 개선합니까?
Chain-of-Thought(CoT) 프롬프팅은 모델에게 발견 사항을 생성하기 전에 각 함수를 통과하는 데이터 흐름을 추적하도록 요청하는 방식입니다. 모델이 일반적인 오류 패턴과 대조하는 대신 실행 경로를 명시적으로 모델링해야 하므로, 단일 단계 리뷰가 놓치는 로직 버그를 드러냅니다.
복잡한 조건부 로직이 있는 모든 함수에 이 확장을 사용하십시오: "버그를 식별하기 전에: 이 함수의 각 분기를 통해 입력 데이터를 단계별로 추적하십시오. null, 빈 문자열 또는 예상치 못한 타입이 전파될 수 있는 모든 경로를 식별하십시오. 그런 다음 처리되지 않은 상태에 도달하는 모든 경로를 나열하십시오."
보안 중심 AI 코드 리뷰는 어떻게 수행합니까?
실제 취약점 데이터셋으로 학습한 AI 기반 SAST(Static Application Security Testing) 도구는 2025년 서드파티 비교에서 AI 생성 코드에 대해 100점 만점에 84–92점을 받았습니다(PromptQuorum이 측정한 것이 아님).
규칙 기반 정적 분석은 고정된 패턴을 적용하는 반면, AI 지원 도구는 코드 경로가 서로 어떻게 상호작용하는지도 추론합니다. 두 방식은 서로 보완적이며, 그래서 많은 팀이 규칙 엔진을 머지 게이트로 실행하고 AI 리뷰어나 스캐너를 함께 사용합니다.
AI 생성 코드를 대상으로 한 2025년 서드파티 비교(sanj.dev; PromptQuorum이 측정한 것이 아님)에서 점수를 받은 세 가지 보안 도구입니다.
도구 | 점수 (서드파티) | 오탐 | 적합한 용도 |
|---|---|---|---|
| Snyk Code + DeepCode AI | 92/100 | 가장 적은 양 | IDE 통합으로 매일 배포하는 팀 |
| Semgrep Enterprise | 87/100 | 낮음 | Policy-as-code; 커스텀 YAML 규칙 팩 |
| GitHub Advanced Security (CodeQL) | 84/100 | 중간 | GitHub 우선 조직; 깊은 시맨틱 커버리지 |

Snyk Code는 개발자가 코드를 작성하는 동안 실시간으로, 즉 PR이 열리기 전에 SQL 인젝션, 크로스 사이트 스크립팅(XSS), 취약한 암호화 기본값, 하드코딩된 자격 증명을 탐지합니다. CodeQL은 추상 구문 트리(AST)를 사용해 시맨틱 분석을 수행하므로, 패턴 매칭 도구가 놓치는 복잡한 다단계 취약점 체인을 탐지할 수 있습니다.
AI 버그 트리아지란 무엇입니까?
AI 기반 버그 트리아지는 버그를 심각도별로 분류하고, 프로덕션 영향을 예측하고, 이슈를 적절한 엔지니어에게 배정하여 엔지니어가 우선순위를 논의하는 데 쓰는 시간을 줄입니다.
AI 버그 트리아지는 탐지 이후의 단계입니다. Khaleefulla, Sudeep, Savithri의 논문(IJERT)에서 저자들은 자신들의 시스템이 버그 분류에서 85% 이상의 정확도, 우선순위 예측에서 82%의 정밀도, 평균 트리아지 시간 65% 감소를 달성했다고 보고합니다. 이는 저자들 자신의 결과이며 PromptQuorum이 측정한 것이 아닙니다.
이득은 수정 속도가 아니라 주로 더 빠른 분류와 배정에서 나옵니다. 심각도 기준은 프로젝트마다 다르므로 한 시스템에서 보고된 정확도가 여러분의 프로젝트에 그대로 적용되지 않을 수 있습니다. 의존하기 전에 자신의 백로그로 시범 운영해 보십시오.
🔍 알고 계셨나요?
AI 트리아지에서 시간 절약은 더 빠른 수정에서 오는 것이 아니라 더 빠른 분류와 라우팅에서 옵니다. 엔지니어들은 우선순위를 논의하는 시간을 줄이고 중요한 문제를 해결하는 시간을 더 많이 사용합니다.
컨텍스트 윈도우 크기가 코드베이스 커버리지를 결정하는 이유는 무엇입니까?
모델의 컨텍스트 윈도우는 코드베이스의 얼마만큼을 동시에 분석할 수 있는지를 결정합니다. 단일 파일, 전체 PR diff, 전체 저장소 중 무엇을 리뷰하느냐의 차이가 어떤 버그를 탐지할 수 있는지를 결정합니다.
클라우드 프론티어 모델의 컨텍스트 윈도우는 이제 약 1M 토큰이며, Llama 4 Scout 같은 오픈 웨이트 모델은 코드가 인프라 밖으로 나가지 않은 채 로컬에서 10M 토큰에 도달합니다. 코드 줄 수는 줄당 대략 10–13 토큰을 기준으로 한 추정치이므로, 현재 한도는 각 벤더의 문서에서 확인하십시오.
모델 유형 | 컨텍스트 윈도우 | 코드 줄 수 (추정) | 사용 사례 |
|---|---|---|---|
| 클라우드 프론티어 모델 | 약 1M 토큰 | ~75,000–100,000줄 | 프로젝트 전체 PR 리뷰 |
| Llama 4 Scout (로컬, Meta) | 10M 토큰 | ~750,000–1,000,000줄 | 가장 큰 컨텍스트, 완전한 프라이버시 |
지역별 규정은 AI 코드 리뷰에 어떤 영향을 줍니까?
소스 코드를 외부 AI API로 보내는 유럽 기업은, 특히 코드나 그것이 다루는 데이터가 개인 데이터 처리와 관련된 경우, 도입 전에 GDPR 제35조에 따른 데이터 보호 영향 평가(DPIA)가 필요할 수 있습니다. 개인 데이터가 처리되는 경우 GDPR과 EU AI법이 AI 지원 코드 리뷰에 동시에 적용될 수 있으므로, 도입 전에 데이터 보호 책임자를 참여시키십시오. 이는 일반적인 정보이며 법률 자문이 아닙니다. 요건은 데이터 보호 책임자 또는 법률 전문가와 확인하십시오.
EU 팀의 경우 CodeRabbit은 Enterprise 플랜에서 자체 호스팅 배포를 제공하지만(문서 기준 500석 이상), 자체 호스팅 에이전트도 프롬프트와 코드를 사용자가 설정한 LLM 제공업체로 보냅니다. Mistral AI(프랑스) 모델을 포함한 오픈 웨이트 모델은 코드를 서드파티 클라우드 밖에 두어야 하는 팀을 위해 Ollama로 로컬에서 실행할 수 있습니다.
중국의 팀은 Qwen3(Alibaba)와 DeepSeek 같은 오픈 웨이트 모델을 로컬 배포 가능한 코드 리뷰 모델로 사용할 수 있으며, 두 모델 모두 중국어 코드 주석과 문서를 지원하므로 다국어 코드베이스에 중요합니다. METI 데이터 거버넌스 지침을 따르는 일본의 팀은 Llama 4 Scout 또는 Llama 3.3 기반 리뷰 워크플로우를 Ollama로 로컬 실행할 수 있으며 — Llama 4 Scout는 추론에 대략 55 GB의 VRAM이 필요합니다 — 이 경우 코드가 외부 API에 전달되지 않습니다.
관련 읽을거리
- AI로 더 나은 코드 작성하기 — 리뷰하기 쉬운 출력을 만드는 코드 생성 프롬프트 구조화 방법
- 프롬프트 엔지니어링이란? — 구조화된 AI 지시를 작성하는 기본 기법
- AI의 한계 — LLM이 할 수 없는 일 — AI 코드 리뷰가 오탐을 만들고 컨텍스트에 의존하는 버그를 놓치는 구조적 이유
- Chain-of-Thought 프롬프팅 — 복잡한 로직 버그 탐지를 위해 실행 경로를 추적하는 추론 기법
- 프롬프트 인젝션과 보안 — 코드 리뷰 조작을 포함한 AI 지원 개발 워크플로우의 보안 취약점
- RAG 설명 — Greptile 같은 전체 코드베이스 인덱싱 도구가 검색으로 모델 한계를 넘어 컨텍스트를 확장하는 방법
- 코드 리뷰를 위한 최고의 로컬 LLM — 비공개 코드 리뷰를 위한 로컬 모델 대안
- 코딩을 위한 최고의 로컬 LLM — 코딩 작업 기준으로 순위를 매긴 Kimi K2.6, Qwen 3.6, Devstral
- 제약 프롬프팅 — "스타일에 대해 코멘트하지 마십시오" 지시의 배경이 되는 기법
AI를 코드 리뷰에 활용하는 방법
- 1코드를 리뷰하도록 요청하기 전에 코드베이스 아키텍처, 네이밍 규칙, 제약 조건을 AI에게 알립니다. 짧은 컨텍스트 문서를 제공하십시오: '이것은 Next.js 앱입니다. TypeScript strict 모드를 사용하고, `any` 타입은 쓰지 않으며, 모든 컴포넌트에 JSDoc이 있어야 하고, 모든 API 엔드포인트에 rate limiting이 있어야 합니다.' 이것이 없으면 AI는 프로젝트별 문제를 놓치는 일반적인 코멘트를 합니다.
- 2AI에게 보안, 성능, 로직, 일관성 같은 특정 버그 범주를 확인하도록 요청합니다. '이 코드를 리뷰해 주세요' 대신 이렇게 요청하십시오: '보안 취약점(입력, 인증, 데이터 노출)을 리뷰한 다음, 이 패턴이 우리가 정립한 오류 처리 방식과 일치하는지 확인해 주세요.' 구체적인 질문이 더 집중되고 유용한 피드백을 만듭니다.
- 3Chain-of-Thought(CoT) 프롬프팅을 사용합니다: 피드백을 내기 전에 모델에게 실행을 추적하도록 요청합니다. 복잡한 함수에는 '입력 X에 대한 실행을 추적한 다음 로직 오류를 식별해 주세요'라고 요청하십시오. 이렇게 하면 AI의 추론이 투명해지고 사람이 놓칠 수 있는 미묘한 버그를 잡아냅니다.
- 4고위험 변경(인증, 결제, 인프라)에는 다중 모델 코드 리뷰를 사용합니다. 같은 코드를 서로 다른 벤더의 모델 세 개에 실행하십시오. 세 모델이 모두 같은 문제를 지적하면 강한 신호입니다. 한 모델만 발견한 것은 신중하게 조사하십시오.
- 5AI를 최종 중재자가 아닌 1차 필터로 취급합니다. AI는 명백한 버그(누락된 return, 타입 불일치, SQL 인젝션 패턴)를 잡는 데 뛰어나지만 컨텍스트별 문제(성능 영향, 확장 문제, 팀 규칙)는 놓칠 수 있습니다. AI 기반 피드백은 항상 사람이 검토하게 하십시오.
AI 코드 리뷰에서 흔한 실수
❌ 프롬프트 커스터마이징 없이 기본 설정으로 AI 리뷰를 배포하는 것.
Why it hurts: 기본 AI 리뷰는 대부분 스타일 코멘트를 만들 수 있습니다. 개발자들이 모든 코멘트를 무시하기 시작합니다. 중요한 보안 발견 사항이 묻힙니다.
Fix: 5단계 프롬프트 프레임워크를 사용하십시오. 스타일/이름을 명시적으로 제외하십시오. 로직, 보안, 성능으로 범위를 한정하십시오.
❌ AI 코드 리뷰를 유일한 리뷰 계층으로 사용하는 것.
Why it hurts: Greptile의 2025년 7월 벤치마크에서 AI 리뷰어는 심어 둔 버그의 44–82%를 잡아냈습니다 — 100%가 아닙니다. 컨텍스트별 문제(확장 영향, 팀 규칙, 비즈니스 로직 오류)에는 사람의 판단이 필요합니다.
Fix: AI는 1차 필터입니다. 사람 리뷰어는 아키텍처, 비즈니스 로직, AI가 놓치는 버그에 집중하십시오.
❌ 코드베이스 컨텍스트 없이 PR diff만 리뷰하는 것.
Why it hurts: 파일 간 상호작용으로 생기는 버그는 변경된 줄만 보는 도구에는 보이지 않습니다. 다른 파일의 호출자를 깨뜨리는 함수 변경은 잡히지 않습니다.
Fix: 각 벤더가 저장소 컨텍스트를 얼마나 사용하는지 문서에서 확인하십시오. 고위험 변경에는 저장소 전체를 인덱싱하는 도구를 선호하고, diff 중심 리뷰는 저위험 PR에 한정하십시오.
❌ AI 코멘트에 대한 개발자 실행률을 측정하지 않는 것.
Why it hurts: 개발자가 실행에 옮기는 AI 코멘트의 비율을 추적하지 않으면 도구가 가치를 만드는지 잡음을 만드는지 알 수 없습니다. 팀은 AI 리뷰가 잘 동작한다고 가정하지만 이미 붕괴했을 수 있습니다.
Fix: 실행률을 매월 추적하십시오. 40% 미만이면 프롬프트 범위를 좁히십시오. 20% 미만이면 도구가 순수한 잡음을 만드는 것이므로 재구성하거나 교체하십시오.
AI 코드 리뷰 FAQ
2026년에 가장 정확한 AI 코드 리뷰 도구는 무엇입니까?
모든 테스트에서 가장 정확한 도구는 없습니다. Greptile이 2025년 7월에 다섯 개의 오픈소스 저장소에서 가져온 50개 버그로 실행한 벤치마크에서 Greptile은 82%, Cursor Bugbot은 58%, GitHub Copilot은 54%, CodeRabbit은 44%를 잡아냈습니다(기본 설정, 호스팅 플랜). Greptile이 테스트 대상 도구 중 하나를 판매하고 독립적인 결과는 다를 수 있으므로, 이 수치는 출발점으로 사용하고 자신의 pull request로 2주간 시험해 보십시오. 보안 스캔의 경우 Snyk Code는 별도 범주로, pull request 리뷰어를 보완하는 스캐너입니다.
CodeRabbit vs Greptile: 어느 쪽을 선택해야 하며 CodeRabbit은 쓸 만한 가치가 있습니까?
심어 둔 버그의 최고 탐지율이 가장 중요하고 리뷰 단위로 예산을 잡을 수 있다면 Greptile을 선택하십시오. Greptile 자체의 2025년 7월 테스트에서 CodeRabbit의 44%에 대해 82%를 잡아냈고, Pro에는 좌석 요금이 없습니다(선불 크레딧 개당 $1, Base 리뷰는 1 크레딧 사용). 좌석 단위 가격(Essentials 연간 결제 시 사용자당 월 $24, 월 결제 시 $30)과 공개 저장소 무료 리뷰를 원한다면 CodeRabbit을 선택하십시오. 두 도구 모두 14일 체험판을 제공하며 자체 호스팅은 Enterprise에만 제공합니다. CodeRabbit이 가치가 있는지는 리뷰 물량에 달려 있습니다. 정액 좌석 가격은 pull request를 많이 여는 팀이 예측하기 쉽고, 물량이 적은 팀은 리뷰 단위로 내는 비용이 더 적을 수 있습니다.
CodeRabbit과 Greptile은 무료입니까?
일부만 그렇습니다. CodeRabbit은 공개 저장소를 무료로 리뷰하며, 비공개 저장소에는 14일 체험판이 있는 유료 플랜(연간 결제 시 사용자당 월 $24부터의 Essentials)이 필요합니다. Greptile Starter는 활성 개발자 1명에게 월 50 크레딧으로 무료이며, Pro는 개당 $1의 선불 크레딧을 사용하고 14일 체험판이 있습니다. 조건을 충족하는 비상업 오픈소스 프로젝트는 무료 이용을 신청할 수 있습니다.
Greptile은 Bitbucket을 지원합니까?
Greptile의 가격 페이지는 자체 호스팅 Enterprise 배포 플랫폼으로 GitHub Enterprise, GitLab Self-Managed, Gitea와 함께 Bitbucket Data Center를 나열합니다. Bitbucket Cloud는 명시적으로 나열하지 않으며 서드파티 출처들의 내용이 엇갈리므로, 도입을 결정하기 전에 Greptile에 Bitbucket Cloud 지원 여부를 확인하십시오. Qodo(가격 페이지에 GitHub, GitLab, Bitbucket, Azure 로고 표시)와 Cursor Bugbot(Cursor 문서 기준 GitHub, GitLab, Bitbucket, Azure DevOps Services)은 Bitbucket 지원을 나열합니다.
Greptile의 가장 좋은 대안은 무엇입니까?
가장 가까운 대안은 CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot 코드 리뷰, Graphite Agent입니다(Cursor는 2025년 12월 19일에 Graphite 인수를 발표했습니다). Greptile의 2025년 7월 테스트에서 Bugbot은 58%, Copilot은 54%, CodeRabbit은 44%를 잡아냈으며 Qodo는 테스트되지 않았습니다. Git 플랫폼(Bitbucket: Qodo 또는 Bugbot), 가격 모델(좌석, 크레딧, 사용량), 배포 방식(자체 호스팅은 CodeRabbit, Greptile, Qodo에서 Enterprise 기능)으로 선택하십시오.
자체 호스팅이나 온프레미스 배포를 지원하는 AI 코드 리뷰 도구는 무엇이며, 자체 LLM 키를 사용할 수 있습니까?
CodeRabbit(Enterprise 플랜. 문서에 따르면 500석 이상 고객에게 제공되며 GitHub Enterprise Server, GitLab 자체 관리형, Azure DevOps, Bitbucket Data Center를 지원), Greptile(Enterprise), Qodo(Enterprise: 단일 테넌트 SaaS, 온프레미스, 에어갭)가 자체 호스팅을 문서화하고 있습니다. 자체 호스팅 CodeRabbit도 프롬프트와 소스 코드를 사용자가 설정한 LLM 제공업체로 보내며, 문서에는 자체 LLM 제공업체 또는 계정을 연결할 수 있다고 되어 있습니다. CodeRabbit의 CLI는 pull request 전에 로컬 변경 사항을 리뷰하지만 CodeRabbit 백엔드에 인증합니다. 코드가 인프라 밖으로 나가서는 안 되는 경우 오픈 웨이트 모델을 로컬에서 실행하십시오.
Snyk는 AI 코드 리뷰 도구입니까?
Snyk Code는 IDE, pull request, CI에서 코드를 검사하는 AI 지원 보안 스캐너입니다. Snyk의 플랜 페이지는 실시간 스캔과 소스 코드 관리자 연동은 나열하지만 AI pull request 요약이나 일반 코드 리뷰는 나열하지 않습니다. Free 플랜은 월 100회의 Snyk Code 테스트를 포함하고, Team은 개발자 최대 10명 기준 월 $25부터이며, Enterprise는 크레딧 기반입니다. CodeRabbit이나 Greptile 같은 pull request 리뷰어와 함께 사용하십시오. SonarQube 역시 LLM 리뷰어가 아니라 주로 규칙 기반 정적 분석입니다.
AI 코드 리뷰는 리뷰 시간을 얼마나 줄여줍니까?
서드파티 업계 가이드(DigitalApplied, 2025)는 리뷰 시간 40% 감소와 프로덕션 버그 62% 감소를 보고하며, PromptQuorum은 이를 측정하지 않았습니다. Khaleefulla 외의 논문(IJERT)에서 저자들은 자신들의 AI 트리아지 시스템이 평균 트리아지 시간을 65% 줄였다고 보고합니다. 어떤 도구를 쓰든, 프롬프트 범위를 조정하기 전후에 개발자가 실행에 옮기는 AI 코멘트의 비율을 측정하십시오.
AI 코드 리뷰는 전통적인 정적 분석(SAST)과 어떻게 비교됩니까?
규칙 기반 SAST는 고정된 취약점 시그니처를 적용하며 오탐이 많이 나오는 경향이 있는 반면, AI 기반 도구는 맥락적 추론을 더합니다. 시그니처를 매칭하는 대신 코드 경로가 서로 어떻게 상호작용하는지 평가합니다. 2025년 서드파티 비교에서 Snyk Code, Semgrep Enterprise, CodeQL은 AI 생성 코드에 대해 84–92/100점을 받았습니다(PromptQuorum이 측정한 것이 아님). 두 방식은 서로 보완적입니다.
AI 코드 리뷰는 유럽 팀에게 GDPR을 준수합니까?
자동으로는 아닙니다. 개인 데이터 처리와 관련된 소스 코드를 외부 AI API로 보내는 것은 GDPR 제35조에 따른 데이터 보호 영향 평가(DPIA)가 필요할 수 있으므로 데이터 보호 책임자에게 문의하십시오. GDPR과 EU AI법이 동시에 적용될 수 있습니다. 엄격한 요건이 있는 경우 자체 호스팅(CodeRabbit Enterprise는 500석 이상 고객에게 제공되며, 여전히 코드를 사용자가 설정한 LLM 제공업체로 보냄)을 사용하거나, Ollama로 오픈 웨이트 모델을 로컬에서 실행하여 코드가 인프라 밖으로 나가지 않도록 하십시오.
Chain-of-Thought 프롬프팅이 AI 코드 리뷰 품질을 향상시킵니까?
예 — 여러 조건부 분기가 있는 복잡한 로직의 경우 Chain-of-Thought(CoT) 프롬프팅은 모델에게 발견 사항을 생성하기 전에 각 실행 경로를 통해 데이터 흐름을 추적하도록 요청합니다. 이는 패턴 매칭이 놓치는 로직 버그를 드러냅니다. 모델이 코드를 일반적인 오류 템플릿과 대조하는 대신, null 값이나 예상치 못한 입력 타입이 함수를 통해 취할 수 있는 모든 경로를 명시적으로 모델링해야 하기 때문입니다. CoT는 보안에 민감한 함수와 복잡한 상태 관리에서 가장 가치가 크며, 지연 시간을 늘리고 단순한 유틸리티 함수에는 불필요합니다.
AI 코드 리뷰 코멘트 중 실제로 유용한 비중은 얼마입니까?
검증된 공개 수치는 확인하지 못했으며, 그 비중은 도구, 프롬프트, 코드베이스에 따라 달라지므로 직접 측정하십시오. 한 달 동안 개발자가 실행에 옮기는 AI 코멘트의 비율을 세어 보십시오. 대부분의 코멘트가 무시된다면 범위를 좁히고 — 스타일 코멘트를 명시적으로 제외하고 로직, 보안, 성능 발견 사항만 요청하십시오 — 다시 측정하십시오.
코드 리뷰에 가장 좋은 AI 모델은 무엇입니까?
단 하나의 최고 모델은 없습니다. 같은 고위험 변경을 서로 다른 벤더의 모델 두세 개에 실행하고, 둘 이상이 지적한 문제를 신뢰도가 높은 것으로 취급하십시오. 모델은 컨텍스트 윈도우(클라우드 프론티어 모델은 약 1M 토큰, 대략 75,000–100,000줄의 코드를 제공하고 Llama 4 Scout는 로컬에서 10M 토큰을 지원), 범위 지시를 따르는 정도, 리뷰당 비용에서 차이가 있습니다. 표준으로 정하기 전에 알려진 버그가 있는 자신의 과거 pull request로 후보를 테스트하십시오.
AI 코드 리뷰에서 오탐을 줄이려면 어떻게 해야 합니까?
세 가지 기법이 있습니다. (1) 프롬프트 범위를 명시적으로 한정합니다 — "로직 버그, 보안 취약점, 성능 저하만 리뷰하고 스타일이나 이름에 대해서는 코멘트하지 마십시오". (2) 잡음 지시를 추가합니다 — "어떤 범주에서 아무것도 발견하지 못했다면 발견 없음이라고 쓰고 채우기용 코멘트를 추가하지 마십시오". (3) 복잡한 함수에는 Chain-of-Thought를 사용합니다 — 발견 사항을 내기 전에 모델에게 실행 경로를 추적하도록 요청합니다. 개발자가 실행에 옮기는 코멘트의 비율을 추적하고 40% 아래로 떨어지면 범위를 좁히십시오.
AI 코드 리뷰를 CI/CD 파이프라인에 어떻게 통합해야 합니까?
대부분의 도구는 모든 pull request를 자동으로 리뷰하는 GitHub 또는 GitLab 앱이나 봇으로 설치됩니다. 플랫폼 지원은 다르므로 위의 비교 표를 확인하십시오. AI 리뷰를 다른 검사(린팅, 단위 테스트)와 병렬로 실행하고, 치명적인 보안 발견 사항에 대해서만 머지를 차단하며, 나머지 발견 사항은 개발자의 재량에 맡기는 참고용 코멘트로 남겨 두십시오.
AI 코드 리뷰가 전용 SAST 도구보다 보안 취약점을 더 잘 탐지할 수 있습니까?
서드파티 비교에서 AI 기반 SAST 도구(Snyk Code, Semgrep Enterprise, CodeQL)는 2025년 서드파티 비교에서 AI 생성 코드에 대해 84–92/100점을 받았으며(PromptQuorum이 측정한 것이 아님), 규칙 기반 정적 분석은 빠른 머지 게이트로 여전히 유용합니다. AI는 PR당 더 많은 연산이 필요하므로 대규모 코드베이스를 대량으로 검사하는 데는 전통적인 SAST가 여전히 더 빠릅니다. 모범 사례: 속도를 위해 가벼운 SAST와 린팅을 사용하고, 고위험 변경(인증, 결제, 인프라)에는 심층 보안 분석을 위해 AI 리뷰로 보완하십시오.
코드를 완전히 비공개로 유지하면서 AI 코드 리뷰를 로컬에서 실행할 수 있습니까?
예. Devstral Small 24B(Mistral AI, 16 GB RAM)와 Llama 4 Scout(~55 GB VRAM, 10M 컨텍스트)는 Ollama로 완전히 온프레미스에서 실행됩니다. 추론이 사용자의 하드웨어에서 실행되므로 코드가 클라우드 리뷰어로 전송되지 않습니다. 이는 DPIA가 별도로 다뤄야 할 서드파티 처리 단계를 없앨 수 있지만, 모델 다운로드와 업데이트 동작은 보안 팀과 함께 확인하십시오. 복잡한 보안 분석에서는 품질이 프론티어 클라우드 모델보다 낮지만 대부분의 PR 수준 리뷰에는 충분합니다.
소규모 팀(개발자 10명 미만)에게 가장 좋은 AI 코드 리뷰 도구는 무엇입니까?
팀이 이미 코드 리뷰가 포함된 Copilot 플랜(Pro, Pro+, Max, Business 또는 Enterprise)을 사용 중이라면 GitHub Copilot 코드 리뷰가 가장 부담이 적은 옵션입니다. 사용량은 AI 크레딧으로 과금됩니다. CodeRabbit은 공개 저장소를 무료로 리뷰하고, Greptile Starter는 활성 개발자 1명에게 무료이며, Snyk Code Free는 월 100회 테스트를 포함하고, Qodo는 14일 체험판이 있지만 영구 무료 플랜은 없습니다. Promptfoo(무료, 오픈소스)는 CI/CD에서 코드 리뷰 검증을 자동화할 수 있습니다. 10명 미만의 팀은 리뷰 물량이 비용을 정당화할 때까지 연간 플랜 약정을 피하십시오.
참고 자료 및 추가 읽을거리
- Greptile, 2025. "AI code review bug catch benchmark" — 다섯 개의 오픈소스 저장소에서 가져온 심어 둔 버그 50개로 도구 5종을 평가한 벤더 자체 실행 평가(2025년 7월); 82% / 58% / 54% / 44% 탐지율의 출처
- CodeRabbit 가격 — 플랜, 사용자당 가격, 공개 저장소 무료 리뷰
- CodeRabbit 자체 호스팅 문서 — Enterprise 자체 호스팅, 지원 플랫폼, 500석 이상 제공 조건, 자체 LLM 제공업체 옵션
- CodeRabbit CLI 문서 — 커밋하지 않은 변경 사항의 로컬 리뷰
- Greptile 가격 — Starter, Pro 크레딧, Enterprise 자체 호스팅, 지원 플랫폼
- Qodo 가격 — Pro Team 및 Enterprise 플랜, 체험판, 온프레미스 옵션
- Snyk 플랜 — Snyk Code Free, Team, Enterprise 한도
- Cursor Bugbot 문서 — 사용량 기반 과금 및 지원 Git 플랫폼
- GitHub Docs: Copilot 코드 리뷰 — 코드 리뷰가 포함된 플랜과 AI 크레딧 과금
- Graphite, 2025. "Effective prompt engineering for AI code reviews" — 오탐을 줄이고 신호를 개선하기 위한 범위 한정 프롬프트 기술 가이드
- Sanjay, 2025. "Best AI Code Security Tools 2025: Snyk vs Semgrep vs CodeQL" — AI 생성 코드에서 SAST 도구 3종을 비교한 서드파티 벤치마크(92 / 87 / 84 점수의 출처)
- Khaleefulla, Sudeep and Savithri. "Automated Bug Categorization and Task Assignment System Using Artificial Intelligence" (IJERT) — 저자들 자신의 결과: 분류 정확도 85% 이상, 우선순위 정밀도 82%, 트리아지 시간 65% 단축
- DigitalApplied, 2025. "AI Code Review Automation: Complete Guide" — 업계 수치: 시간 40% 절감, 프로덕션 버그 62% 감소
- 참고: 탐지율은 벤더가 보고한 수치이며 PromptQuorum이 측정한 것이 아닙니다. 가격은 위 벤더 페이지의 정가입니다. AI 코드 리뷰는 빠르게 변하는 시장이므로 구매 전에 벤더 웹사이트에서 최신 가격과 플랫폼 지원을 확인하십시오.