Melhores modelos MoE para programação local?
Por Hans Kuepper · Fundador do PromptQuorum · Mecanismo de descoberta de IA de pesos abertos e código aberto
Principais conclusões
- ✓Modelos MoE carregam todos os especialistas na memória, mas calculam só 3–5B de parâmetros ativos por token: são mais rápidos que modelos densos de mesmo tamanho de arquivo, não ocupam menos memória
- ✓O gpt-oss-20b (14 GB no Ollama) é a escolha MoE para 16 GB; Qwen3-Coder-30B-A3B e GLM-4.7-Flash (19 GB cada) cabem em uma GPU de 24 GB
- ✓O Qwen3.6-35B-A3B (~24 GB) informa 73,4 no SWE-bench Verified em sua ficha do modelo, o maior número entre os modelos comparados, e serve para 32 GB de memória
- ✓Qwen3-Coder-Next (52 GB) e gpt-oss-120b (65 GB) exigem 64–80 GB de memória unificada ou VRAM
Resposta rápida
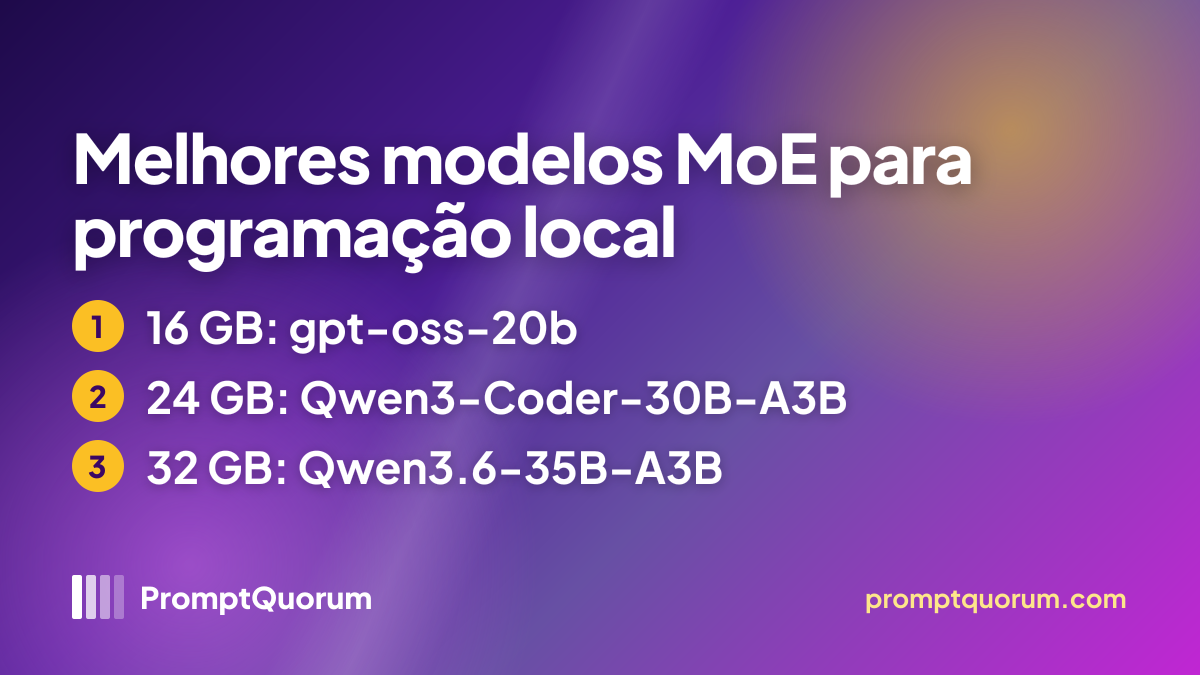
O Qwen3.6-35B-A3B tem a maior pontuação SWE-bench Verified divulgada pelo fabricante entre os modelos comparados e serve para 32 GB de memória, o Qwen3-Coder-30B-A3B cabe em uma GPU de 24 GB e o gpt-oss-20b em 16 GB. Modelos MoE calculam só 3–5B de parâmetros ativos por token, então são rápidos, mas ainda precisam de memória para todos os especialistas.
- ▸16 GB: gpt-oss-20b (21B no total, 3,6B ativos, 14 GB no Ollama)
- ▸24 GB: Qwen3-Coder-30B-A3B ou GLM-4.7-Flash (19 GB cada)
- ▸32 GB ou mais: Qwen3.6-35B-A3B (~24 GB); 64–80 GB: Qwen3-Coder-Next, gpt-oss-120b
Modelos MoE precisam de memória para os parâmetros totais, não só os ativos
Um modelo Mixture of Experts (MoE) encaminha cada token por poucas sub-redes especialistas: a velocidade acompanha os parâmetros ativos e a memória acompanha os parâmetros totais. Segundo a ficha no Hugging Face, o Qwen3.6-35B-A3B tem 256 especialistas e ativa 8 roteados mais 1 compartilhado por token (3B dos seus 35B parâmetros).
Um MoE com 3B ativos gera tokens, portanto, a um custo próximo ao de um modelo denso pequeno, mas seu download de 14–24 GB ainda precisa caber em VRAM ou em memória unificada rápida. Os tamanhos da tabela são downloads do Ollama; reserve folga para o cache de contexto.
As pontuações das fichas de modelo são divulgadas pelos próprios fabricantes, com configurações de agente diferentes: o SWE-bench Verified é 73,4 para o Qwen3.6-35B-A3B, 70,6 para o Qwen3-Coder-Next e 59,2 para o GLM-4.7-Flash. Use-as como referência, não como comparação direta; a PromptQuorum não as refez.
| Modelo | Total / ativos | Tamanho Ollama | Faixa de memória |
|---|---|---|---|
| Qwen3.6-35B-A3B | 35B / 3B | ~24 GB | 32 GB |
| Qwen3-Coder-30B-A3B | 30B / 3.3B | 19 GB | 24 GB |
| GLM-4.7-Flash | 30B / 3B | 19 GB | 24 GB |
| gpt-oss-20b | 21B / 3.6B | 14 GB | 16 GB |
| Qwen3-Coder-Next | 80B / 3B | 52 GB | 64 GB |
| gpt-oss-120b | 117B / 5.1B | 65 GB | 80 GB |
Escolha o modelo MoE que cabe na sua memória
Com 16 GB de VRAM, use o gpt-oss-20b: 21B no total, 3,6B ativos, 14 GB no Ollama. Sobram cerca de 2 GB para o contexto em uma placa de 16 GB, então mantenha a janela de contexto modesta.
Com uma GPU de 24 GB, use o Qwen3-Coder-30B-A3B (19 GB, contexto de 256K, voltado a código) ou o GLM-4.7-Flash (19 GB, licença MIT). Ambos são MoE 30B-A3B com 3–3,3B de parâmetros ativos.
Com uma GPU de 32 GB, use o Qwen3.6-35B-A3B (cerca de 24 GB, contexto de 256K, Apache 2.0); em um Mac, conte com 48 GB de memória unificada, porque o macOS reserva cerca de 8 GB. Em uma GPU de 24 GB fica apertado: parte do modelo vai para a RAM do sistema e a velocidade cai.
Com 64–80 GB, o Qwen3-Coder-Next (80B no total, 3B ativos, 52 GB em Q4_K_M) serve a uma máquina de 64 GB, e o gpt-oss-120b (117B no total, 5,1B ativos, 65 GB) mira uma única GPU de 80 GB, segundo a ficha da OpenAI.
Abaixo de 16 GB, o MoE deixa de ser prático; veja os melhores modelos de 14B para programação como alternativas densas.
Rodar modelos MoE com o Ollama
Cada modelo da tabela é um comando: ollama run gpt-oss:20b, ollama run qwen3-coder:30b, ollama run glm-4.7-flash, ollama run qwen3.6:35b, ollama run qwen3-coder-next e ollama run gpt-oss:120b.
O Ollama divide as camadas entre GPU e RAM do sistema quando o modelo excede a VRAM. No llama.cpp dá para controlar isso em modelos MoE: as opções --cpu-moe e --n-cpu-moe mantêm os pesos dos especialistas na RAM enquanto a atenção fica na GPU, e assim um modelo de 19–24 GB roda em uma placa de 16 GB, mais devagar. A PromptQuorum não mediu a velocidade.
Um erro comum é julgar o tamanho pelos parâmetros ativos: um modelo de “3B ativos” não é um download do tamanho de um 3B. Confira o tamanho do arquivo na página do modelo no Ollama antes de baixar.
Para alternativas densas em cada faixa de VRAM, veja o guia dos melhores LLMs locais para programação.
Guias relacionados
- ▸Melhores modelos de 14B para programação -- modelos densos de programação para 10–16 GB
- ▸Melhores LLMs locais para programação -- modelos de programação por faixa de VRAM
- ▸Continue.dev adquirido pela Cursor: encerramento e alternativas -- coding tool comparison
Fontes
- ▸Ficha do modelo Qwen3.6-35B-A3B — arquitetura, especialistas, licença e pontuação no SWE-bench Verified.
- ▸Ficha do modelo Qwen3-Coder-Next — 80B no total, 3B ativos, pontuação no SWE-bench Verified.
- ▸Ficha do modelo GLM-4.7-Flash — MoE 30B-A3B, licença MIT, pontuação no SWE-bench Verified.
- ▸Ficha do modelo gpt-oss-120b — parâmetros totais e ativos e alvos de memória do gpt-oss-120b e do gpt-oss-20b.
- ▸Biblioteca do Ollama: qwen3-coder — tags e tamanhos de download; veja também gpt-oss, glm-4.7-flash, qwen3.6 e qwen3-coder-next.
Respostas rápidas sobre modelos MoE para programação
O que é um modelo MoE e por que ele importa para programação local?▾
Qual modelo MoE é o melhor para 16 GB de VRAM?▾
Qual é o melhor modelo MoE pequeno?▾
Um modelo MoE precisa de menos VRAM que um modelo denso?▾
Quais modelos MoE de programação existem no Ollama?▾
qwen3.6:35b, qwen3-coder:30b, glm-4.7-flash, gpt-oss:20b, qwen3-coder-next e gpt-oss:120b, com downloads de cerca de 24, 19, 19, 14, 52 e 65 GB.Um modelo MoE é melhor que um denso para programar?▾
qwen3.6:27b (18–19 GB), pode ser mais lento por token; teste os dois nos seus próprios repositórios antes de decidir.